如果你问一个量化研究员”你平时做什么”,大概率会得到一个听起来很学术的回答——“因子研究”。但如果你真正走进他们的办公室(或者说,走进他们的代码仓库),会发现这个职业的日常远比”因子研究”四个字复杂得多,也枯燥得多。今天,我想从一个内部视角来还原这个职业的真实面貌。
因子研究员的日常:不是在挖掘因子,就是在为挖掘因子做准备#
量化研究员的日常工作可以粗略地分为三个阶段:想法生成、因子实现、回测验证。但实际操作中,这三个阶段之间的边界往往非常模糊,而且会不断循环迭代。
想法生成阶段是整个流程中”人”的价值体现最明显的地方。一个优秀的量化研究员需要有广泛的知识面——不仅要懂金融学、计量经济学,还需要对宏观经济、行业动态、行为金融学有持续的关注。他们的想法来源多种多样:可能是读了一篇有趣的学术论文,可能是从日常新闻中捕捉到了某个市场异象,也可能是与同行交流时获得的灵感。在这个阶段,批判性思维是最重要的能力——一个想法是否真的经得起推敲,是否有坚实的经济学逻辑支撑,往往决定了后续工作的价值上限。
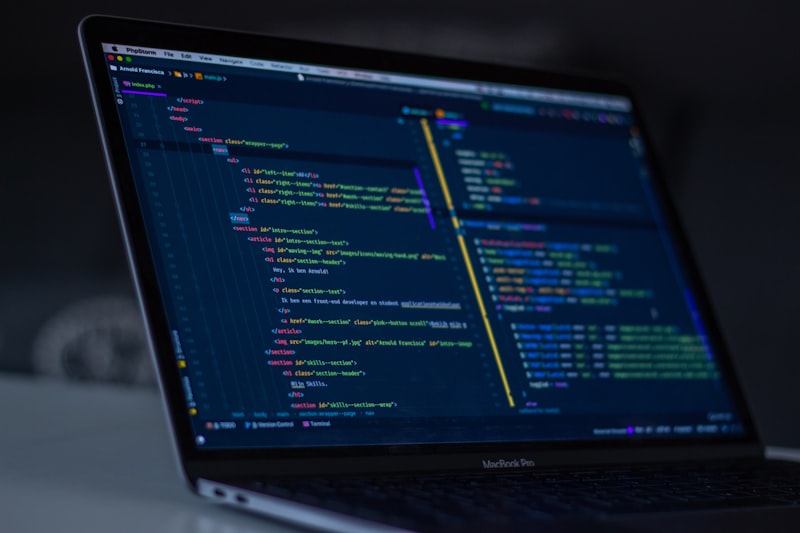
因子实现阶段需要将想法转化为可计算的形式。这个过程听起来简单,但实际执行中充满了细节陷阱。同样是”现金流市值比”这个因子,不同的数据源处理方式(TTM还是滚动年报?坏账如何处理?季节性如何调整?)会直接导致因子值的显著差异。Python的pandas、polars,数据库的SQL查询,数据清洗脚本——这些工具构成了研究员日常工作的大部分语言。代码质量在这个阶段至关重要,因为一个隐藏的bug可能导致整个因子的回测结果无效,而这种无效性往往在实盘后才会暴露。
回测验证是检验因子有效性的终极环节。一个严谨的回测需要考虑前视偏差(look-ahead bias)、幸存者偏差(survivorship bias)、交易成本、滑点、流动性约束等诸多因素。仅仅因为某个因子在回测中表现优异就认为它是有效的,这在量化领域是一个经典的”新手错误”。经验丰富的量化研究员会花大量时间进行各种稳健性检验:改变回测时间窗口、调整参数边界、在不同市场环境下测试、检验因子与其他已知因子的相关性……
研究方向的选择:做一个通才还是专才?#
在量化团队内部,研究员通常会被划分到不同的研究方向。这个选择对职业发展影响深远。
Alpha因子方向是最直接面向收益的研究岗位。这里的”Alpha”指的是能够产生超额收益的信号。因子库管理、因子有效性监控、新因子挖掘——这是最核心也是竞争最激烈的领域。在这个方向上,研究员需要持续产出高质量的Alpha因子,衡量标准简单直接:IC(信息系数)IR(信息比率)。
风险因子方向更偏向风控和组合优化。这类研究员设计的是”不要亏太多”的信号——波动率控制、最大回撤约束、行业/风格暴露管理。这个方向对数理功底要求更高,涉及大量的最优化理论和随机过程知识。
另类数据方向是近年来快速发展的领域。卫星图像、信用卡消费数据、社交媒体情绪、网络搜索趋势……这些非传统数据源需要研究员具备强大的数据工程能力,能够从噪声极大的原始数据中提取出有效的信号。这个方向的挑战在于数据的获取成本高、清洗难度大、且信息优势衰减快。
执行算法方向研究的是如何高效、低成本地执行交易指令。VWAP、D VWAP、TWAP、POV——这些算法背后的数学原理看似简单,但在真实市场中面临订单簿动态变化、流动性碎片化、市场冲击等一系列复杂因素。这个方向需要研究员对市场微观结构有深入理解。
技术栈:从Python到C++的阶梯#
一个量化研究员的工具栈反映了他们工作的复杂度层级。
Python是当之无愧的统治者。pandas、numpy、scipy构成了数据处理的基础设施;statsmodels、arch用于统计分析;scikit-learn用于简单的机器学习模型。在因子实现和快速原型阶段,Python的效率无可挑剔。
但当策略需要高频执行时,C++或Rust就成了必要的选择。延迟在毫秒级以下的场景中,Python的解释性质和GIL锁成了不可逾越的障碍。有趣的是,许多从学术背景进入量化的研究员往往低估了这个技术阶梯的陡峭程度——能在Jupyter notebook里跑通一个因子,和能在20微秒内完成一笔交易,是完全不同的能力。
机器学习在量化中的应用正在深化,但方式与互联网行业有本质区别。金融数据的信噪比极低,且市场本身是非稳态的——这意味着在历史数据上训练出的模型在实盘中往往表现平庸。因此,机器学习在量化中更多是作为非线性因子的构建工具,而非端到端的预测黑箱。
这个职业真正的挑战#
说了这么多技术细节,我想最后聊聊这个职业真正的挑战是什么。
心理压力是外行人最难理解的。量化研究是一个反馈周期极长的职业——一个因子从想法提出到被验证有效(或被证伪),可能需要数周甚至数月。在这个漫长的等待过程中,研究员需要同时处理两种情绪:对想法的自信(坚持自己的研究判断)和对市场的敬畏(承认自己可能错了)。这种张力是持续存在的。
信息劣势感是另一个心理挑战。顶级量化机构拥有远超个人能获取的数据资源和计算资源,一个个人研究者在这个信息生态中如何找到自己的独特价值,是每一个从业者都需要回答的问题。
持续学习的必要性在这个领域体现得淋漓尽致。市场在变、监管在变、技术在变,三到五年不更新自己的知识体系,就可能从行业前沿滑落到中游甚至落后。这种学习不仅仅是技术层面的,更包括对市场本质的持续思考和理解。
量化研究员的日常,本质上是一场在不确定性中寻找秩序的持久战。如果你享受解决复杂问题带来的满足感,能够承受长期没有正反馈的心理压力,并且对”用数学和代码理解市场”这件事有真正的好奇心,这个职业可能是最适合你的选择之一。