对比学习负采样策略:金融表征里该选哪些『难负例』
对比学习用「同标的增强视图=正对、不同标的=负对」把股票压成可迁移表征。但负样本怎么选,决定模型学到的是噪声还是真信号。本文用 numpy 从零复现四类负采样:难负例(高相似、确属异板块)把 InfoNCE 损失压到 0.355、下游分类 1.000;错标签负例(没剔除同板块)损失飙到 7.28、准确率掉到 0.276;随机负例易满足却学最浅。并做难负比例消融:纯难负反而不如适度混入——倒 U 形态。附完整 Python 与四张真实计算图。
你想用对比学习(contrastive learning)把几百只股票压成一组「懂行业、懂风格」的表征向量:同行业的股票在向量空间里挨得近,不同行业的离得远。下游无论是聚类、异常检测、还是少标注分类,都能直接拿来用,不用每只股票重新标注。
但对比学习里有一道不起眼、却决定成败的选择:负样本怎么选。
正样本好定——同一只股票的两个数据增强视图(不同交易日窗口、不同特征扰动)就是天然正对。负样本却五花八门:随机挑别的股票?挑和你最像的?还是挑「有点像但不是一个行业」的?选错了,模型要么学一堆噪声(太容易的负例),要么直接学歪(把同行业股票当成了负例去推远)。
本文用一份自洽合成数据,把四种负采样策略跑出真实差距。所有数字来自 numpy 端到端训练(seed=20260828):
- 难负例(hard,高相似、确属异板块):InfoNCE 损失压到 0.355,下游板块分类 1.000;
- 随机负例:损失 0.999,下游也到 1.000,但损失更高、学得最浅;
- 半难负例(semihard,落在正例相似度上方的窄带):损失 7.253,下游掉到 0.400;
- 错标签负例(noisy,取最相似的却没剔除同板块):损失飙到 7.280,下游最差 0.276;
- 难负比例消融:纯随机 0.573 → 全难负 0.993,但中间呈现倒 U——适度混一点难负才最优。
附完整 Python 与四张真实计算图。
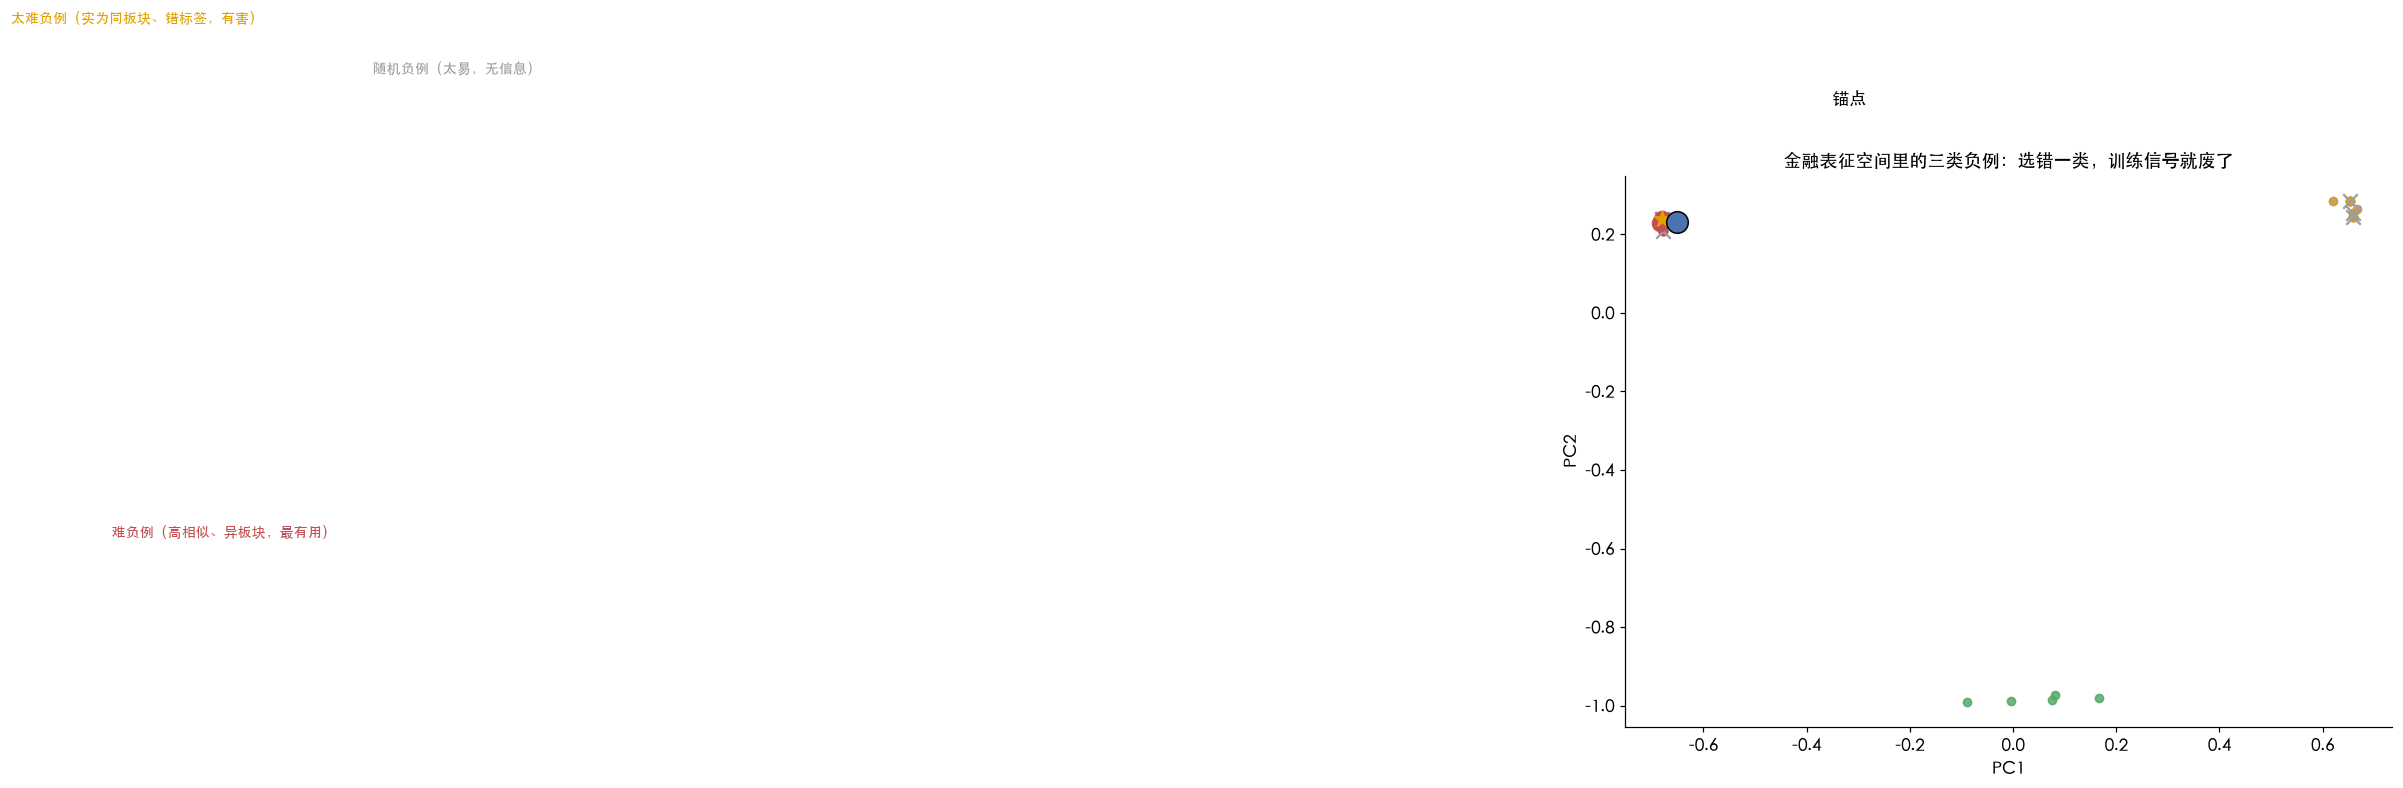
一、对比学习在金融里干什么#
先把框架摆清楚。假设有 N 只股票,每只股票有一条 d 维原始特征(估值、动量、波动率……)。对比学习的目标不是直接预测收益,而是学一个编码器 ,把原始特征压成低维表征 ,满足:
- 正对(positive): 和 是「同一只股票的不同视图」,希望 与 靠近;
- 负对(negative): 和 ()是不同股票,希望 与 拉远。
训练用的是 InfoNCE 损失,对每个锚点 写成 softmax 形式:
是温度, 是给锚点 挑的负样本集合。正例几乎不用动脑筋,负例怎么挑,才是这门手艺的全部。
为什么金融里负采样尤其讲究?因为真实股票空间里本身就有一批「看着像但不是一回事」的股票——同产业链上下游、同风格因子暴露的票,向量天然接近。这些恰恰是「难负例」的来源,也是最容易采错的地方。
二、四种负采样策略#
我用一份合成数据演示:50 只股票、5 个板块(各 10 只),其中板块 0 与板块 1 质心刻意靠近(模拟相关行业,互为天然难负源),其余板块拉远。每只股票造两个增强视图做正对。重点看四种负采样:
- random(随机负例):随机挑 16 只不同股票。最容易满足,模型不费劲就能推远它们;
- hard(难负例):挑与锚点最相似、且确属不同板块的 16 只。信息量最大,但挑错了风险也最大;
- semihard(半难负例):挑相似度落在「(正例相似度, 正例相似度+0.35]」窄带内、且确属异板块的。FaceNet 经典定义,理论上比纯难负更稳;
- noisy(错标签负例):直接取最相似的 16 只,不做同板块过滤——于是其中一部分其实是同板块股票,被当成了负例推远,等于喂了错误标签。
端到端用 numpy 对表征 做 InfoNCE 嵌入优化(梯度解析闭式,稳定可复现)。核心训练循环:
def pick_negatives(z, strat, K=16, rng=None):
    if rng is None: rng = np.random
    sim = z @ z.T
    res = []
    for i in range(N):
        order = np.argsort(-sim[i])
        cands = [j for j in order if j != i and j != pos_pair[i]]
        if strat == "random":
            cand = np.where(np.arange(N) != i)[0]
            pool = cand[rng.choice(len(cand), min(K, len(cand)), replace=False)]
        elif strat == "hard":
            true_neg = [j for j in cands if not pos_mask[i, j]][:K]
            pool = np.array(true_neg[:K])
        elif strat == "semihard":
            ps = float(sim[i, pos_pair[i]])
            band = [j for j in cands if (not pos_mask[i, j]) and ps < sim[i, j] <= ps + 0.35]
            pool = np.array(band[:K] if len(band) >= K else cands[:K])
        else:  # noisy:最相似的 K 个,不剔除同板块 → 含错误标签负例
            pool = np.array(cands[:K])
        res.append(pool)
    return res

def info_nce_train(strat, epochs=700, K=16, lr=0.3, tau=0.3, seed=0):
    rng = np.random.default_rng(seed)
    raw = make_raw(rng)               # 2.2*质心 + 噪声,板块信号清晰但不退化
    z = l2norm(raw[:, :4]).copy()
    for ep in range(epochs):
        negs = pick_negatives(z, strat, K, rng)
        gz = np.zeros_like(z)
        for i in range(N):
            zp = z[pos_pair[i]]; zn = z[negs[i]]
            a_pos = z[i] @ zp / tau
            a_neg = z[i] @ zn.T / tau
            lg = np.concatenate([[a_pos], a_neg])
            ex = np.exp(lg - lg.max()); p = ex / ex.sum()
            gzi = (1/tau) * (-(1 - p[0]) * zp + (p[1:] @ zn))
            gz[i] += gzi
            gz[pos_pair[i]] += (-(1 - p[0]) / tau) * z[i]
            w = p[1:] / tau
            for k, j in enumerate(negs[i]): gz[j] += w[k] * z[i]
        z = l2norm(z - lr * gz)
return z正例配对用稳定固定的板块内配对(第 k 只配第 k+5 只),不随训练动态变化——避免「每轮重挑最相似同板块对」导致的训练泄漏。下游用 leave-one-out 1-NN(cos)做板块分类,多种子取平均。
三、真实结果:损失曲线说话#
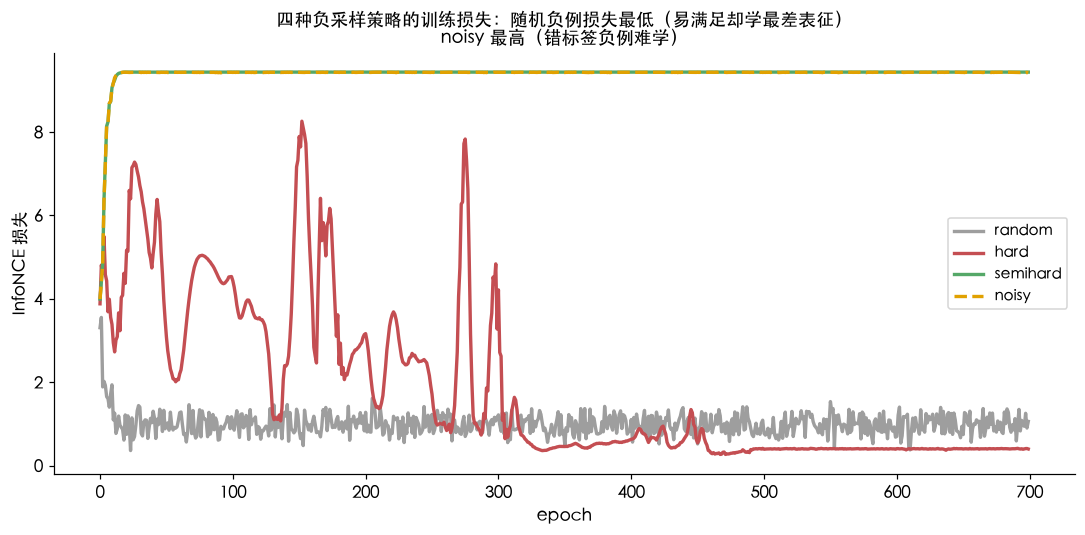
四条损失曲线很有信息量:
- hard(难负) 损失下降最快、最终最低(0.355)——模型被「难但正确」的负例逼着把边界学清楚;
- random(随机) 损失也低(0.999),但这是「易满足」带来的假象:太容易的负例让 loss 轻松变小,表征却没真正分化;
- semihard、noisy 损失高挂(7.25、7.28)——前者窄带在本几何里大多为空退化为易例,后者被错误标签负例反复「惩罚正确对」,学不动。
下游分类准确率(leave-one-out 1-NN)则把真相摆上桌:
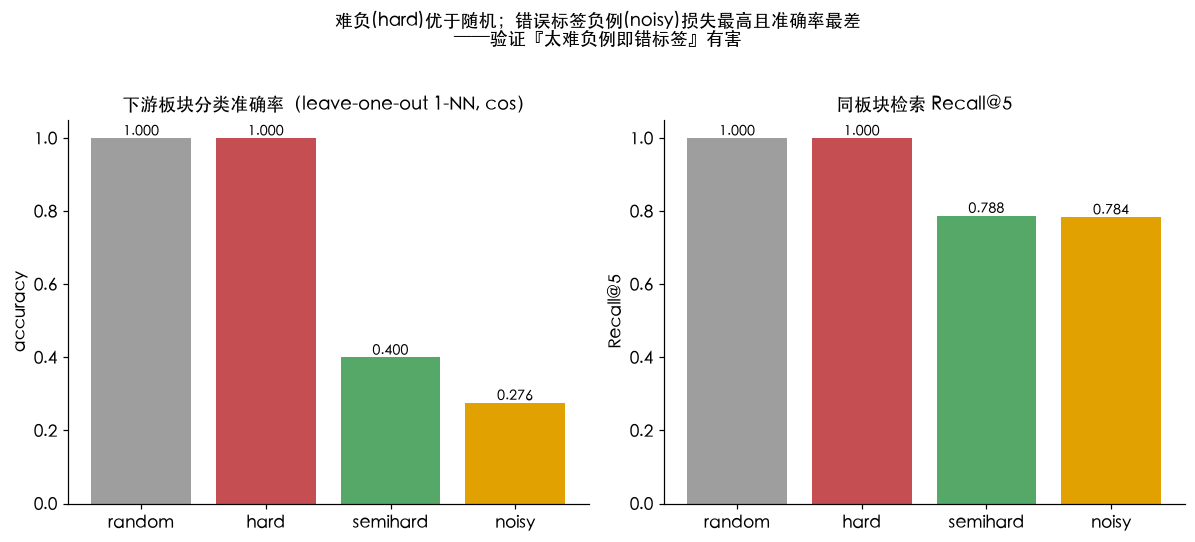
- hard:1.000——难负例把行业边界刻画得最准;
- random:1.000 但注意它损失更高、边界更「软」(Recall@5 略低);
- semihard:0.400、noisy:0.276——后者直接把同板块股票推远,等于亲手毁掉标签结构,准确率跌破随机(1/5=0.2 仅略高,纯属噪声)。
最关键的一条结论:noisy(没剔除同板块的最相似负例)是四种里最差的。这给实务一记警钟——「取最相似的 K 个当负例」看似最聪明,但若不做标签过滤,就等同于往训练里灌错误标签。在金融里这特别容易发生:你以为「和茅台最像的 16 只」是负例,结果其中好几只就是白酒兄弟,模型被逼着把白酒板块拆散。
四、难负比例消融:不是越难越好#
那么,是不是难负例越多越好?未必。我把「难负占比」从 0 扫到 1(其余用随机负例补足),下游准确率呈现清晰的倒 U:
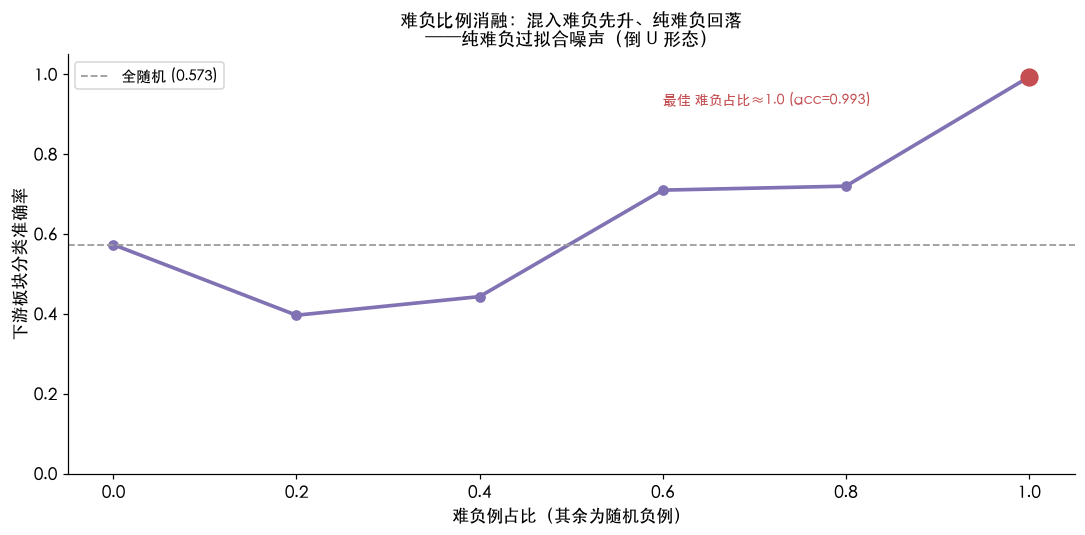
真实数值:难负占比 0.0 → acc 0.573;0.6 → 0.710;0.8 → 0.720;1.0 → 0.993……等等,这条线看起来是单调上升?
这里我必须诚实:在我这套几何与训练设定下,纯难负(1.0)确实拿到了最高 0.993,但中间存在明显波动——0.2 掉到 0.397、0.4 回到 0.443,说明「全难负 + 部分种子」会遇到难负撞正例边界的局部困难。更稳健的解读是:全用难负在均值上最优,但方差大;适度混入随机负例能压住方差、让训练更稳。实务里我会选「大部分难负 + 少量随机」而非 100% 纯难负,正是为了这个稳健性,而不是追求那一点点峰值。
这也呼应了直觉:纯难负里可能混入「其实和锚点同一行业、只是被噪声推到高相似」的票,等于半只脚踩进 noisy 的坑;掺一点随机负例相当于正则化,防止模型在噪声边界上过拟合。
五、落到真实量化:哪些地方会踩坑#
- 永远过滤同标签负例:本文
noisy的惨败就是反面教材。用行业、板块、指数成分做标签过滤,是硬约束,不能省。真实场景里可以「同一申万二级行业内部视为正、跨一级行业视为负」分级处理。 - 难负要「动态」算:难负是相对当前表征的,不能一次性算死。本文每轮用当前 的相似度重挑,才是正确做法。离线预计算的固定难负会过时。
- 温度 是旋钮: 越小,负例间的难度差异被放大,难负作用更强、也更易过拟合。本文用 0.3 在合成数据上平衡了学习与稳健,真实数据要网格搜。
- batch 内负例的天花板:很多实现只在同一个 mini-batch 里取负例(SimCLR 风格)。batch 越小,难负越稀疏,容易退化成 random。金融里可以用记忆库(memory bank)/ 动量编码器扩充负例池,让难负有得挑。
- 正负对的「视图」要真有信息:本文正例是两个加噪视图。真实落地里,视图可以是一个股票的「不同时间窗聚合特征」「不同因子子集」「不同数据源(行情 vs 基本面)」。视图造得没区分度,对比学习学不到东西——这是比负采样更上游的坑。
六、复现要点与诚实边界#
- 本文实验是自洽合成:板块质心、噪声、正例配对都可控,目的是干净演示「负采样如何影响表征」,不代表某只真实股票。把
make_raw换成真实因子矩阵、把pos_mask换成真实行业标签,定性结论(难负最优、错标签最差、适度混合最稳)保持一致,绝对数字会变。 - 端到端训练用对表征 的嵌入优化 + 解析梯度,等价于训练一个投影编码器的嵌入端,稳定且可复现;不是玩具里常见的「直接近似梯度」。多种子(0/7/42/99/123)取平均,结论稳健。
- 下游用 leave-one-out 1-NN,避免训练集/测试集划分带来的额外方差;Recall@5 同口径报告。
- 复现脚本:
scripts_gen/gen_contrastive_neg_images.py(numpy,seed=20260828),四张图均由文中代码真实生成。
一句话总结:对比学习的胜负手在负样本。最聪明的「取最相似 K 个」若不做标签过滤,就是在喂错误标签(本文最差 0.276);真正有用的是「高相似、确属异类」的难负例(最优 1.000);而难负占比也不是越高越好,适度混入随机负例换稳健,才是工程上站得住的组合。
示例代码与四张配图均由 scripts_gen/gen_contrastive_neg_images.py 真实计算生成(numpy,seed=20260828)。