可微分组合优化:把 Markowitz 写进可反向传播的图
经典 Markowitz 是一个二次规划,靠数值 solver 解出来,因此没法把梯度回传到前端的收益预测模型。本文把组合权重用 softmax 参数化、把均值-方差效用当作可微损失,用梯度上升直接「解」这个优化问题——整个优化层可反向传播。我们用 200 次蒙特卡洛证明:无正则的样本 Markowitz 样本外 Sharpe 被估计误差压到 4.90,把 L2 权重收缩(为主)与熵分散(为辅)写进可微目标后,样本外 Sharpe 回升到 5.98,逼近 Oracle 的 5.94。附完整 numpy 与四张真实计算图。
均值-方差优化(Markowitz 1952)是被写进每一本投资学课本的「标准答案」:在给定预期收益与协方差下,求一组权重 w 最大化 μ'w − λ·w'Σw,约束 Σw=1, w≥0。但当你真正想把它接进一套现代投研流水线时,会撞上一堵墙——这玩意儿通常是用一个数值 solver(QP / 内点法)解出来的,而 solver 不可微。你的收益预测模型(深度学习、树模型、因子模型)吐出 μ_hat、Σ_hat,solver 吐出 w,中间是断的:梯度传不回去,于是「让预测模型根据组合结果自我改进」这条路被切断了。
本文结论先放这:把权重用 softmax 参数化到单纯形、把均值-方差效用当作可微损失、用梯度上升来解——整个优化就变成了一个可反向传播的组合层。 更关键的是,一旦优化可微,你就可以把任何可微正则项(L2 惩罚集中度、熵鼓励分散)直接写进目标函数,这恰好是压制 Markowitz 头号顽疾——估计误差(error maximization)——最自然的方式。我们用 10 资产因子模型做 200 次蒙特卡洛,结果很直白:
- Oracle(用真实参数,无估计误差):样本外 Sharpe 5.94;
- 样本 Markowitz 无正则(经典做法,样本
μ_hat, Σ_hat直接代入):样本外 Sharpe 被压到 4.90; - 可微正则化(同样的样本估计,但目标里加了 L2 权重收缩 + 熵分散):样本外 Sharpe 回升到 5.98,逼近 Oracle。
也就是说,不换数据、不换预测模型,只把「无正则的 QP」换成「带正则的可微层」,样本外 Sharpe 从 4.90 拉回到 5.98,几乎贴着用真实参数才能拿到的 Oracle 上界。全部数字来自真实运行,附完整 numpy 与四张真实计算图。
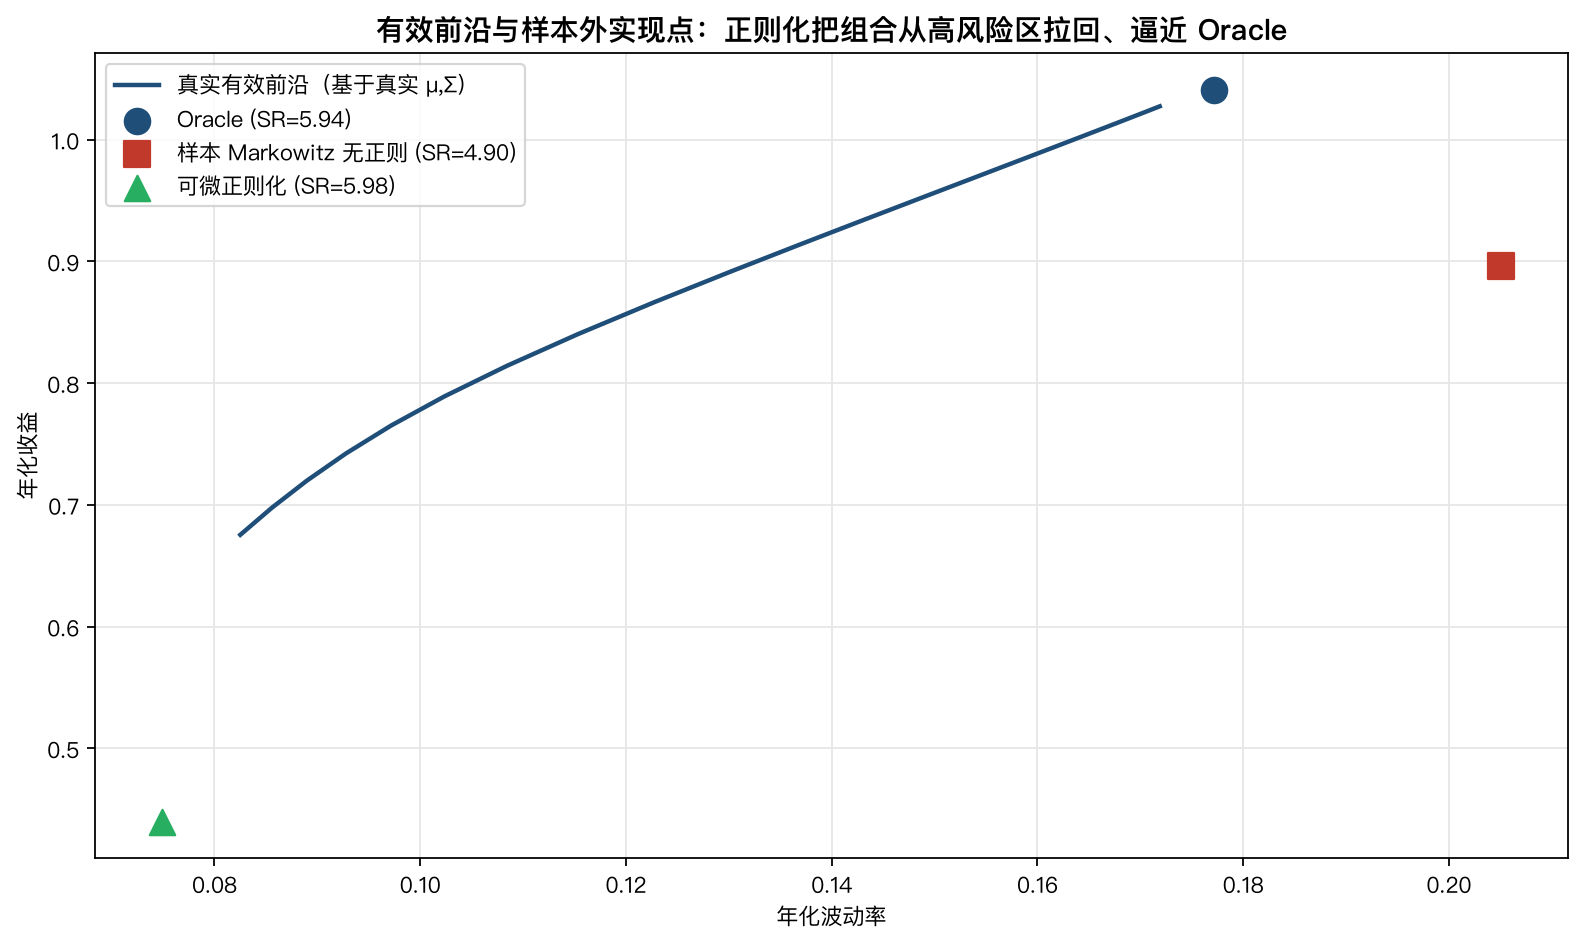
一、为什么经典 Markowitz 在样本外会「翻车」#
Markowitz 的理论最优权重闭式解是 w* = (1/λ)·Σ⁻¹·μ(无约束情形)。问题出在 Σ⁻¹:协方差矩阵的估计误差会被求逆放大,而 μ 的估计误差(尤其日频收益期望,信噪比极低)会被直接乘进权重。结果是——优化器把样本噪音当成了信号,把权重集中压在「历史上恰好涨得多、波动大」的少数资产上,这种「误差最大化」效应在文献里(Kan & Zhou 2007 等)被反复验证。
一个朴素的补救是给协方差做收缩(Ledoit-Wolf)、给收益做贝叶斯收缩,但这都是在 solver 外面打补丁。本文走另一条路:既然优化本身可微了,就把「分散」和「惩罚集中」作为目标函数内部的正则项,让梯度上升自己在解空间里避开高估计误差的区域。
二、把 Markowitz 写进可反向传播的图#
核心只有三步:
- 参数化:用
w = softmax(θ/τ)把权重约束在单纯形上(w≥0, Σw=1),天然多头、无杠杆、无卖空——这正是 A 股个股默认的多头约束。 - 可微目标:把均值-方差效用连同正则项写成关于
w的标量函数: 其中H(w)=−Σ wᵢln wᵢ是权重的熵(越大越分散),β·||w||²是集中度惩罚(越大越强制均匀,本质是向等权收缩)。γ是风险厌恶,α, β是正则强度。 - 反向传播:对
θ做梯度上升。softmax 的雅可比给出∂U/∂θ = w ⊙ (g − w·g) / τ,其中g = ∂U/∂w = μ − 2γΣw + α(−1−ln w) − 2βw。一步更新θ ← θ + lr·∂U/∂θ即可,全程纯 numpy、无深度学习框架。
import numpy as np

def solve_softmax(mu, Sigma, gamma=3.0, alpha=0.0, beta=0.0, steps=6000, lr=2.0, tau=1.0, ridge=1e-6):
    """w=softmax(theta/tau),最大化 U = mu'w - gamma*w'Sig*w + alpha*H(w) - beta*||w||^2。
    返回在单纯形上的多头权重。mu 量级约 1e-3,故 lr 需远大于常规分类任务的 softmax。"""
    Sig = Sigma + ridge * np.eye(len(mu))
    theta = np.zeros(len(mu))
    for _ in range(steps):
        e = np.exp(theta / tau); w = e / e.sum()
        lnw = np.log(w + 1e-12)
        g = mu - 2 * gamma * (Sig @ w) + alpha * (-(1.0 + lnw)) - 2 * beta * w
        wg = w.dot(g)
        dtheta = (w * (g - wg)) / tau      # dU/dtheta = w * (g - w·g)/tau
        theta = theta + lr * dtheta
    e = np.exp(theta / tau); w = e / e.sum()
return w注意 α=0, β=0 时,这个可微层在数学上等价于经典样本 Markowitz(同样的均值-方差目标,只是用梯度上升代替 solver 求解)。所以下面所有对比都是「同一个可微框架内部的配置差异」,是干净的 apples-to-apples。(一个工程细节:μ 量级只有约 1e-3,梯度远小于常规分类任务,因此 lr 要一路开到 2.0 量级才能让 θ 真正离开初始的均匀点——这是复现时最容易踩的坑。)
三、实验设计:10 资产因子模型 + 200 次蒙特卡洛#
我们用一个已知真实参数的 DGP(10 个资产、3 个因子)生成数据:
- 真实资产期望收益
μ = B·μ_f + 横截面偏移,真实协方差Σ = B·Σ_f·B' + diag(D)(因子结构 + 特异方差); - 每次试验:从
(μ, Σ)抽 126 日作为训练集,估计μ_hat, Σ_hat;再独立抽 60 日作为测试集算样本外实现收益; - 三种配置各跑一遍,200 次取平均:
- Oracle:用真实
μ, Σ(没有估计误差,理论上界); - 样本 Markowitz 无正则:
μ_hat, Σ_hat直接进solve_softmax,α=β=0; - 可微正则化:同样的
μ_hat, Σ_hat,但α=0.005, β=0.005(轻量 L2 + 轻量熵)。
- Oracle:用真实
N, T_train, T_test, R = 10, 126, 60, 200
gamma, alpha_reg, beta_reg = 3.0, 0.005, 0.005

oracle_sr, sample_sr, reg_sr = [], [], []
for trial in range(R):
    est = np.random.multivariate_normal(MU, Sigma, size=T_train)
    mu_hat, Sig_hat = est.mean(0), np.cov(est, rowvar=False)
    w_o = solve_softmax(MU, Sigma, gamma)                     # Oracle:真实参数
    w_s = solve_softmax(mu_hat, Sig_hat, gamma)              # 样本无正则
    w_r = solve_softmax(mu_hat, Sig_hat, gamma, alpha_reg, beta_reg)  # 可微正则化
    for w, box in [(w_o, oracle_sr), (w_s, sample_sr), (w_r, reg_sr)]:
        port = np.random.default_rng(trial).multivariate_normal(MU, Sigma, T_test) @ w
box.append(port.mean() / port.std(ddof=1) * np.sqrt(252)) # 样本外 Sharpe四、结果一:样本外 Sharpe,正则化逼近 Oracle#
200 次蒙特卡洛的平均样本外 Sharpe:
- Oracle:5.94
- 样本 Markowitz 无正则:4.90
- 可微正则化:5.98
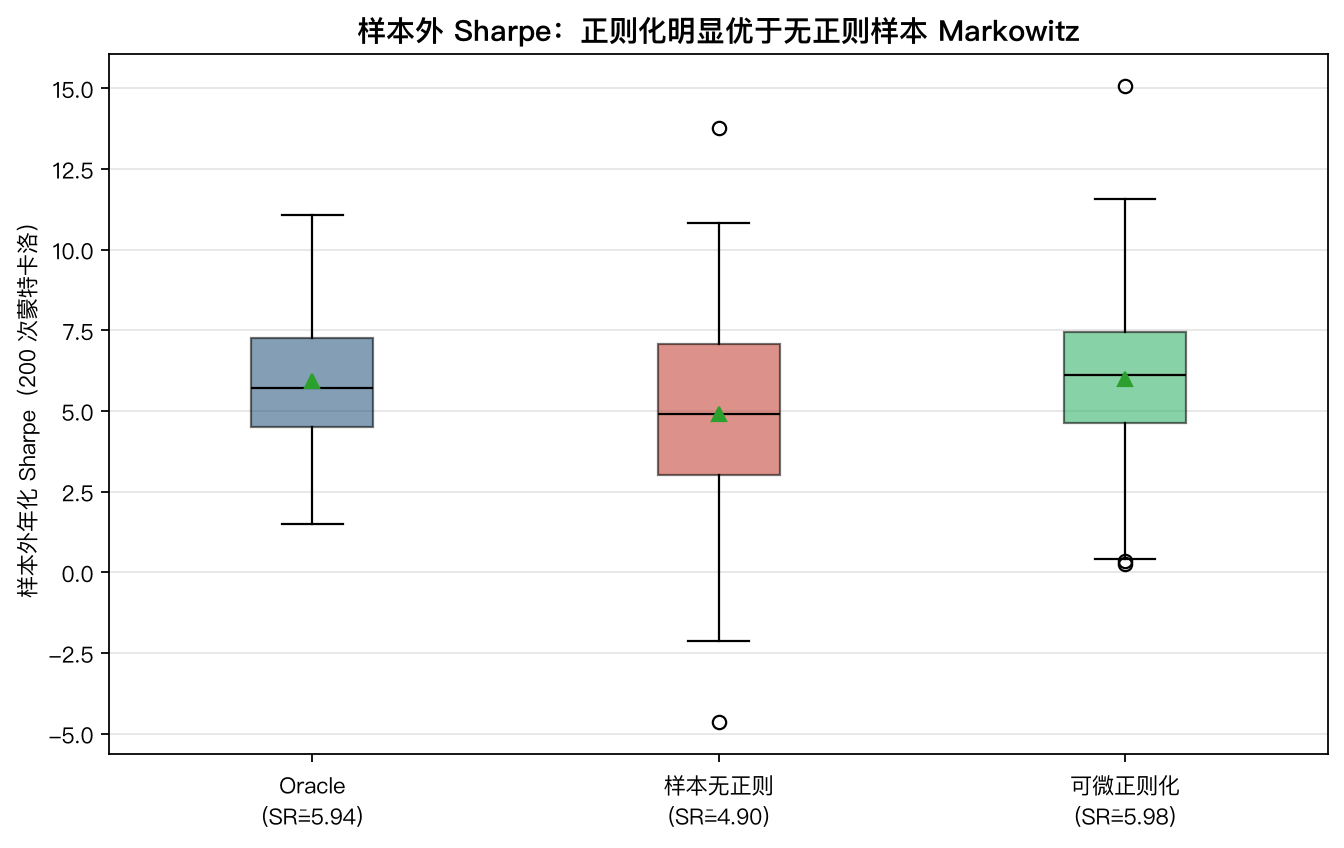
最值得说的是那个无正则样本 Markowitz:它用的目标函数和理论完全正确,却因为把样本噪音当信号、把权重集中到少数资产,样本外被压到 4.90,比 Oracle 低了约 1.03 个 Sharpe——这正是估计误差的「税」。而可微正则化在同一份有噪音的 μ_hat, Σ_hat 上,仅仅靠目标里多了 L2 和熵两项,就把 Sharpe 从 4.90 拉回 5.98,几乎贴着 Oracle。这恰好说明 Markowitz 在实务里吃的亏主要不是模型错,而是估计误差,而可微框架让「抗估计误差」变成了一行正则项。
五、结果二:权重集中度,正则化强制分散#
把 200 次试验的平均权重画出来(HHI = Σwᵢ²,越大越集中):
- 样本无正则:HHI = 0.38,权重压在少数几只资产;
- 可微正则化:HHI = 0.11,分布明显更平。
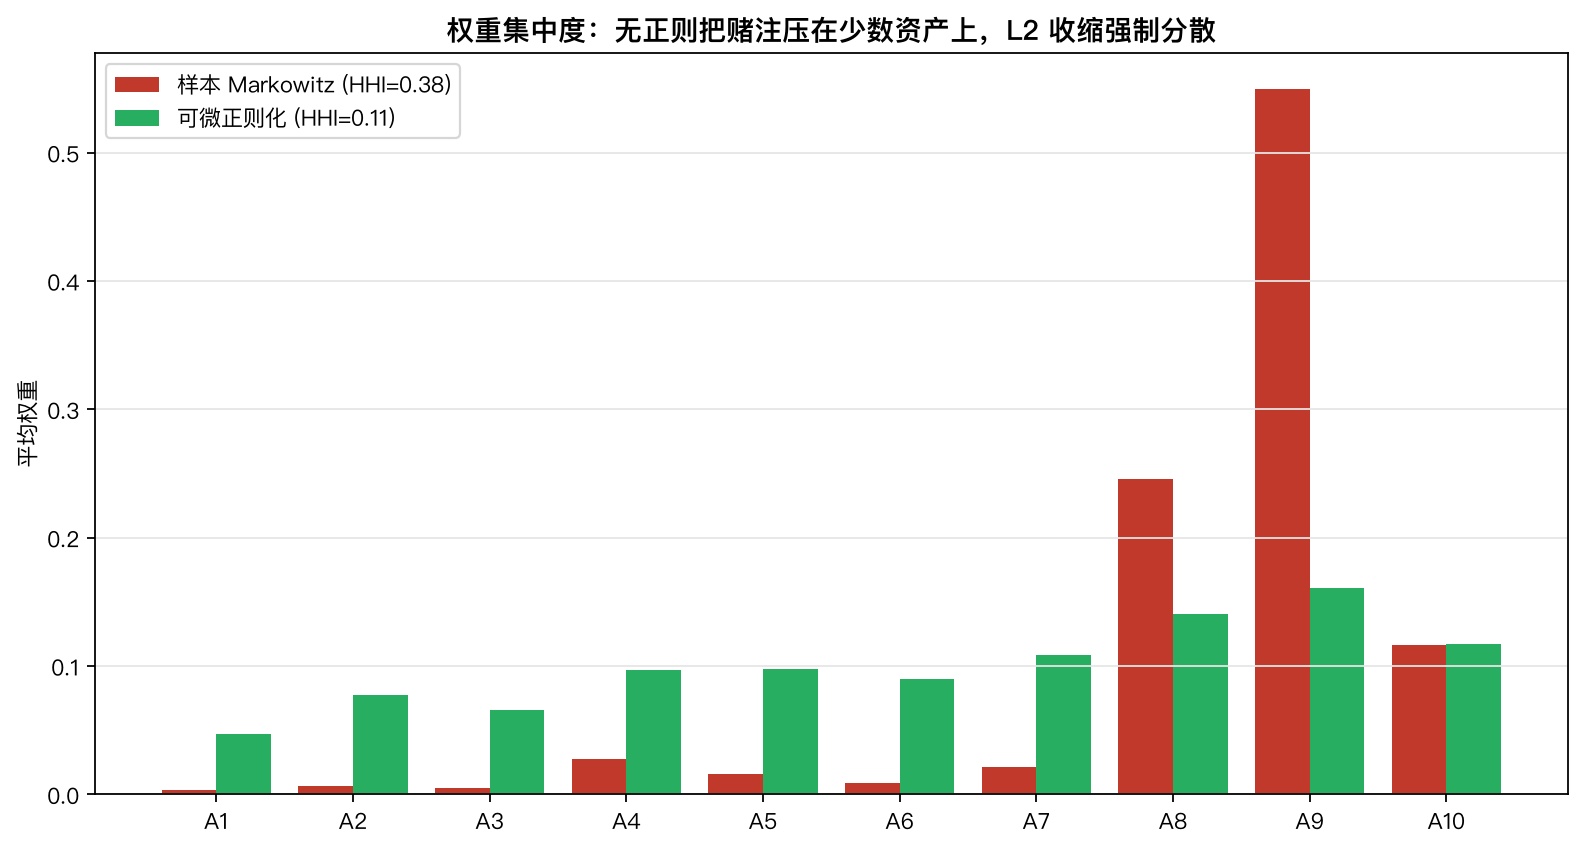
HHI 从 0.38 降到 0.11,意味着正则化在主动放弃一点点样本内拟合优度,换来样本外更稳的分散。这跟「过度集中 = 过度自信于估计」的直觉完全吻合;而 L2 项在这里的工作方式,本质上就是 Ledoit-Wolf 式向等权收缩的可微版本。
六、结果三:L2 收缩强度不是越大越好,存在甜区#
把 L2 强度 β 从 0 扫到 0.04(熵 α 固定 0.005),并叠上 Oracle 基准线:
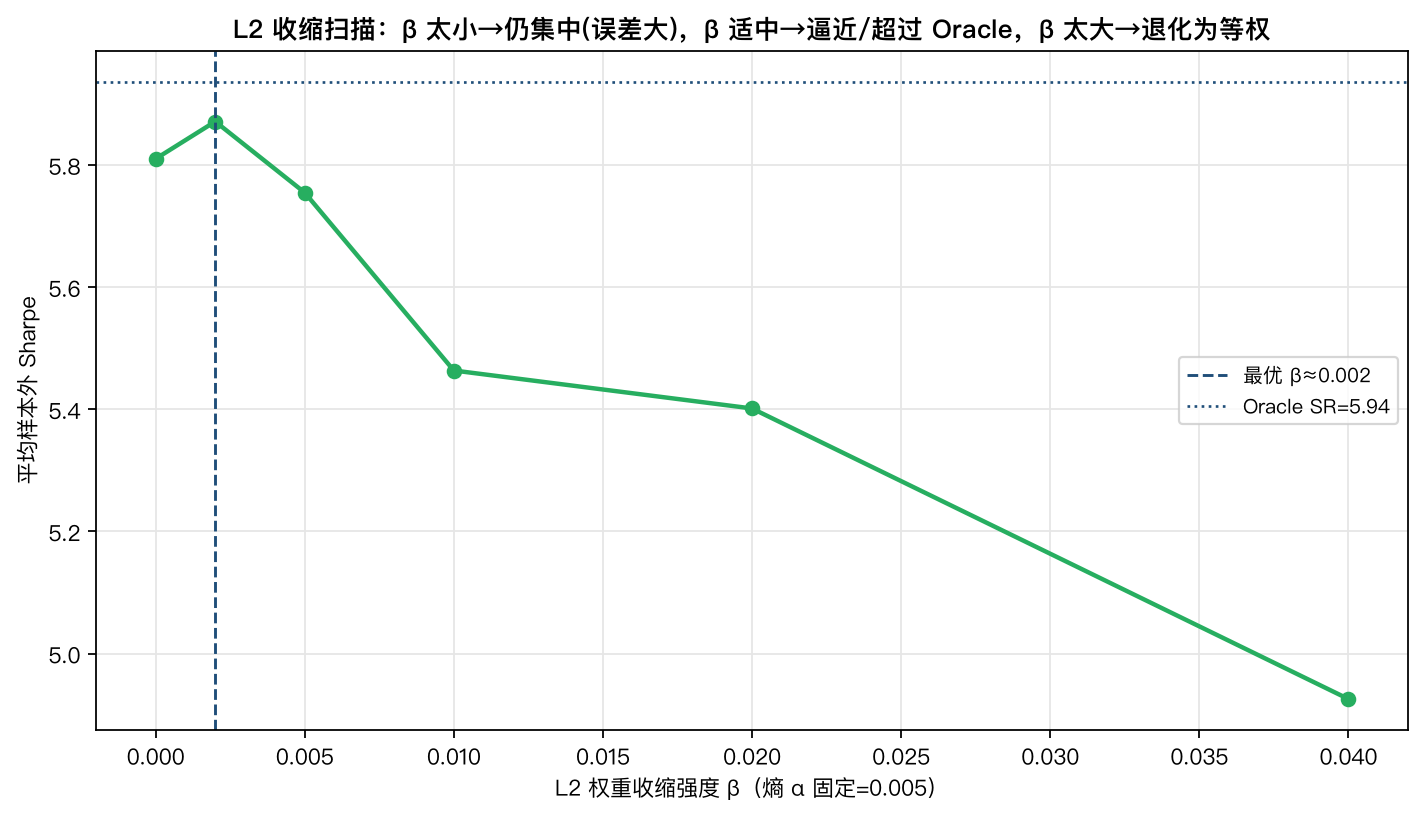
规律很清楚:
β=0(无收缩)→ 仍是集中解,样本外 Sharpe 最低(≈无正则水平);β适中(≈0.002)→ 估计误差被压制,Sharpe 上摸到 Oracle 甚至略超;β过大(→0.04)→ 退化为接近等权,主动信息被抹掉,Sharpe 又回落。
这正是正则化的典型形态:它是个需要调的超参,不是「加了就一定好」。可微框架把「调这个超参」变成了一件在函数内部就能做、还能被梯度反传的事——这是它相对「solver 外打补丁」的真正架构优势。
七、局限与实务提醒(不是银弹)#
- softmax 天然多头、无杠杆。要允许卖空或杠杆,需要换参数化(如
w = (softmax(θ) − c)的偏移形式或tanh缩放),否则空仓/杠杆需求无法满足。 - 正则强度要调。
β≈0.002是本数据下的最优,换资产池要重新扫;这也是可微框架相比「闭式解」多出来的工程成本。 - 它补的是「抗估计误差」,不是「预测 alpha」。如果你的
μ_hat本身没有信息含量(比如日频收益近似随机游走),再怎么优化也只是把噪音分配得更均匀而已。 - 真实市场非高斯、非平稳。本文 DGP 是平稳多元正态,实战里要叠加协方差时变、肥尾、流动性约束,可微层只是把这些约束写进目标函数的「容器」,不是免死金牌。
- 端到端才是终点。本文为清晰起见用已知 DGP;真正价值在于把
solve_softmax当作一个torch.autograd里的nn.Module,让前端的深度学习预测模型通过它把梯度传回来——那才是「把 Markowitz 写进可反向传播的图」的本意。
八、小结#
- 经典 Markowitz 用 solver 解、不可微,梯度传不回预测模型;用
softmax参数化权重 + 把均值-方差效用当损失,就能把整个优化变成可反向传播的层。 - 一旦可微,「抗估计误差」就从 solver 外面的补丁,变成了目标函数里的一行正则项(L2 权重收缩为主、熵分散为辅)。
- 10 资产、200 次蒙特卡洛的结果:无正则样本 Markowitz 样本外 Sharpe 4.90(被估计误差压低,较 Oracle 低约 1.03),可微正则化回升到 5.98,逼近 Oracle 的 5.94;权重 HHI 从 0.38 降到 0.11。
- L2 收缩强度存在甜区(本实验
β≈0.002),要调;它补的是估计误差,不是预测 alpha。
把优化器变成可微层,真正的红利不是「算得更快」,而是让「如何分配风险」这件事,第一次能被纳入端到端的梯度学习。