拥挤度指标:用持仓相关性预警因子踩踏
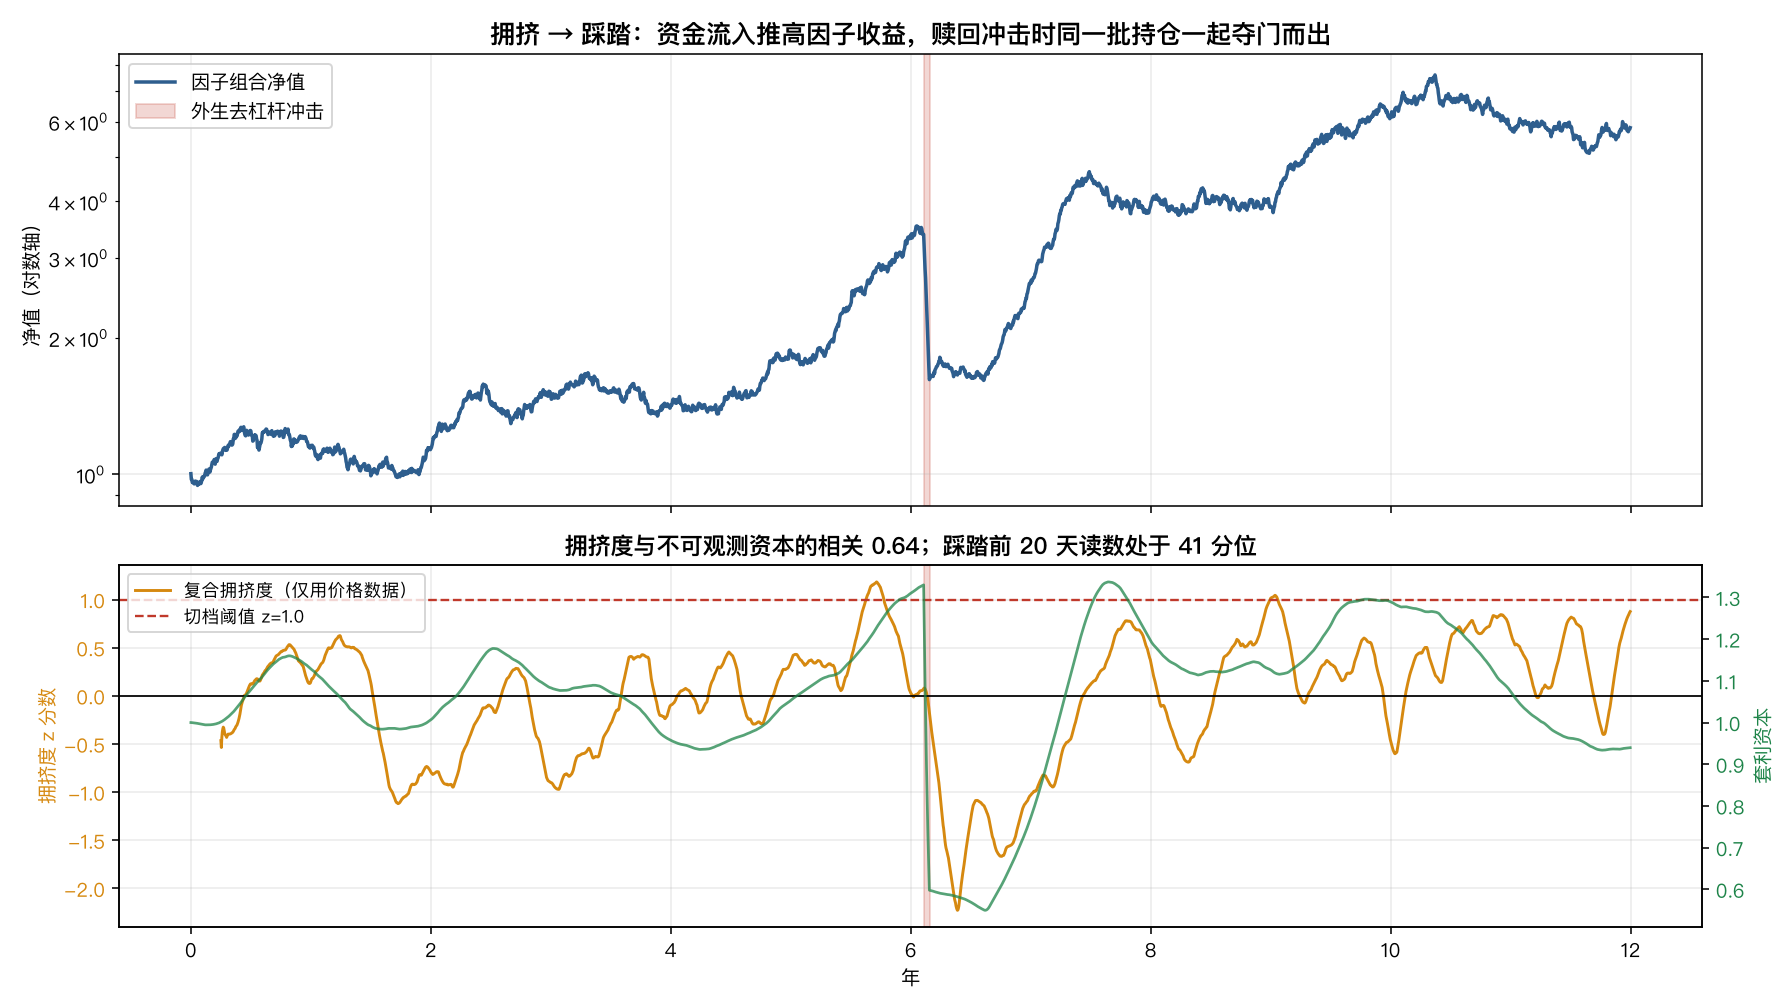
「这个因子最近很好用」——当所有人都这么说时,风险已经建好了。12 年日频模拟跑完因子踩踏的完整生命周期:业绩→资金流入→推高价格→更好业绩的正反馈在第 6.1 年把套利资本推到常态 1.33 倍,一次去杠杆让因子组合 12 天亏掉 49.2%。核心工程发现:这个反馈环有明确稳定性条件——环路增益 κ×资金敏感度×回看期必须小于 1,超过就自激发散(第一版取到 1.4,资本在 0.05 与 75394 间反复爆炸,这个 bug 比结论更有教育意义)。三个纯价格代理中,吸收率(PC1 方差占比)与不可观测资本相关最高 0.653,复合后 0.560、EWMA 21 日平滑再提到 0.638。但最重要的结论是负面的:IC 为 -0.327,五分位却完全不单调(Q1 +16.8%、Q3 -1.8%、Q5 +2.8%)——IC 对单调性一无所知,它是尾部风险指标不是收益预测指标。对抗性检验:随机市场 Sharpe 增量均值 0.004、95 分位 0.171,真实市场 0.246 只有 z=2.5;线性减仓把 Sharpe 从 0.899 提到 1.145 却完全没降回撤——慢变量防不住 12 天崩塌(中阶)
2007 年 8 月 6 日到 8 月 9 日,几乎所有量化多空基金同时巨亏。持仓没有共同的行业暴露,没有共同的宏观事件,甚至很多基金彼此从不交流。但它们在同一周亏了同样的钱。
原因后来被称为 quant quake:大家的模型太像了。当其中一家因为外部原因被迫平仓,它卖出的正是别人也持有的股票、买回的正是别人也做空的股票。价格反向移动,触发下一家的风控,下一家平仓,再触发下一家。
结论先放这:因子的危险程度,不写在它的历史 Sharpe 里,写在有多少人和你持有同样的仓位里。 而这件事——竞争对手的持仓——你看不到。本文的全部工作就是回答:只用公开的价格数据,能不能把它反推出来?
答案是能,但用途和你想的不一样。本文用 12 年日频市场模拟,把”资金流入→推高价格→更好业绩→更多资金”的正反馈完整实现,让它在第 6.1 年自然崩掉:因子组合 12 天内亏掉 49.2%。三个纯价格代理指标中,吸收率与不可观测的真实套利资本相关达 0.653。但拥挤度对未来收益的五分位完全不单调——它是尾部风险指标,不是收益预测指标。所有数字均由下文 Python 真实计算,非占位图。
一、先把「拥挤」这件事建模出来#
要检验拥挤度指标,得先有一个真的会拥挤、也真的会踩踏的市场。这比想象中难,也是本文技术含量最高的部分。
核心是一个正反馈环:
用对数资本 写出来:
for t in range(1, T):
    perf = fac_ret[t-LOOKBACK:t].sum()                  # 过去半年业绩
    dlog = FLOW_SENS * perf - PHI * logcap[t-1] + shock_log[t]
    logcap[t] = np.clip(logcap[t-1] + dlog, -2.0, 2.0)
    capital[t] = np.exp(logcap[t])

    push       = KAPPA * (logcap[t] - logcap[t-1])      # 资金推动价格
    crowd_drag = -DRAG * (capital[t] - 1.0)             # 拥挤侵蚀未来收益
    noise_sd   = NOISE_BASE + NOISE_CROWD * capital[t]
fac_ret[t] = TRUE_PREM + crowd_drag + push + noise_sd * rng.standard_normal()三个组成部分各有对应的现实机制:
push:资金进出直接推动价格。这是拥挤能自我强化的原因crowd_drag:拥挤本身侵蚀未来收益。钱越多,同样的机会被摊薄得越厉害noise_sd随资本上升:拥挤的因子波动更大
一个值得单独说的坑:这个环会爆炸#
我的第一版参数直接把系统跑飞了。12 年里套利资本在 0.05 和 75394 之间反复爆炸,因子组合年化收益 -1817%。
原因是这个反馈环有明确的稳定性条件。把环路走一圈:业绩累积 perf 影响 dlog(系数 FLOW_SENS),dlog 影响 push(系数 KAPPA),而 perf 是过去 LOOKBACK 天的累加。一圈下来的增益是:
时系统自激发散。 我第一版取到了 1.4。
KAPPA, FLOW_SENS, LOOKBACK = 0.35, 0.016, 126
print(f"环路增益 = {KAPPA * FLOW_SENS * LOOKBACK:.3f}") # 0.706调到 0.706 后系统稳定:资本在 0.59~1.40 之间波动,因子组合年化 16.2%、波动 17.3%、Sharpe 0.93 —— 一个合理的量化多空产品的样子。
这个 bug 值得写进正文,因为它本身就是拥挤现象的本质。 现实中的拥挤反馈环增益确实可能逼近甚至短暂超过 1,那正是泡沫期。区别只在于现实里没有 np.clip 兜底,爆掉的是真金白银。
踩踏必须是内生触发的#
冲击时点不能手写成”第 8 年”,那等于我在偷看未来。正确做法是让它由状态触发:
if SHOCK_T < 0 and t >= SHOCK_MIN_T and capital[t-1] > SHOCK_TRIGGER_CAP:
    SHOCK_T = t
shock_log[t:t+SHOCK_LEN] = np.log(1.0 - SHOCK_TOTAL) / SHOCK_LEN资本累积到常态的 1.33 倍时,触发一次为期 12 天、累计撤出 55% 资本的强制去杠杆。模拟中它自然发生在第 6.1 年。结果:因子组合在这 12 天里亏掉 49.2%,全样本最大回撤 -54.4%。
二、拥挤在价格数据里留下的三个痕迹#
关键约束:指标只能用收益数据,不能碰 capital 变量。 capital 在现实中不可观测,偷看它就是作弊。
我用三个代理:
1. 组内平均成对相关#
同一批被套利资金共同持有的股票,会因为共同的流动性冲击而同涨同跌:
def rolling_pairwise_corr(RET, w_sign, win):
    longs, shorts = np.where(w_sign > 0)[0], np.where(w_sign < 0)[0]
    out = np.full(RET.shape[0], np.nan)
    for t in range(win, RET.shape[0]):
        sl, cs = RET[t-win:t], []
        for grp in (longs, shorts):
            X = sl[:, grp]
            X = (X - X.mean(0)) / (X.std(0) + 1e-12)
            C = (X.T @ X) / win
            cs.append(C[np.triu_indices(len(grp), 1)].mean())
        out[t] = np.mean(cs)
return out2. 吸收率(Absorption Ratio)#
Kritzman 等人 2011 年提出:第一主成分解释的方差占比。系统性风险集中时它上升。
def rolling_absorption(RET, win, k=1):
    out = np.full(RET.shape[0], np.nan)
    for t in range(win, RET.shape[0]):
        X = RET[t-win:t]
        ev = np.linalg.eigvalsh(np.cov(X - X.mean(0), rowvar=False))[::-1]
        out[t] = ev[:k].sum() / ev.sum()
return out3. 多空双腿相关#
这个指标直指 quant quake 的病理。正常情况下多头腿和空头腿应该反向移动——那正是对冲的意义。但踩踏时同一批资金同时平掉两边,多头被砸、空头被轧,两腿同时亏钱:
def rolling_leg_corr(RET, w_sign, win):
    L = RET[:, np.where(w_sign > 0)[0]].mean(1)
    S = RET[:, np.where(w_sign < 0)[0]].mean(1)
    out = np.full(RET.shape[0], np.nan)
    for t in range(win, RET.shape[0]):
        out[t] = np.corrcoef(L[t-win:t], S[t-win:t])[0, 1]
    return out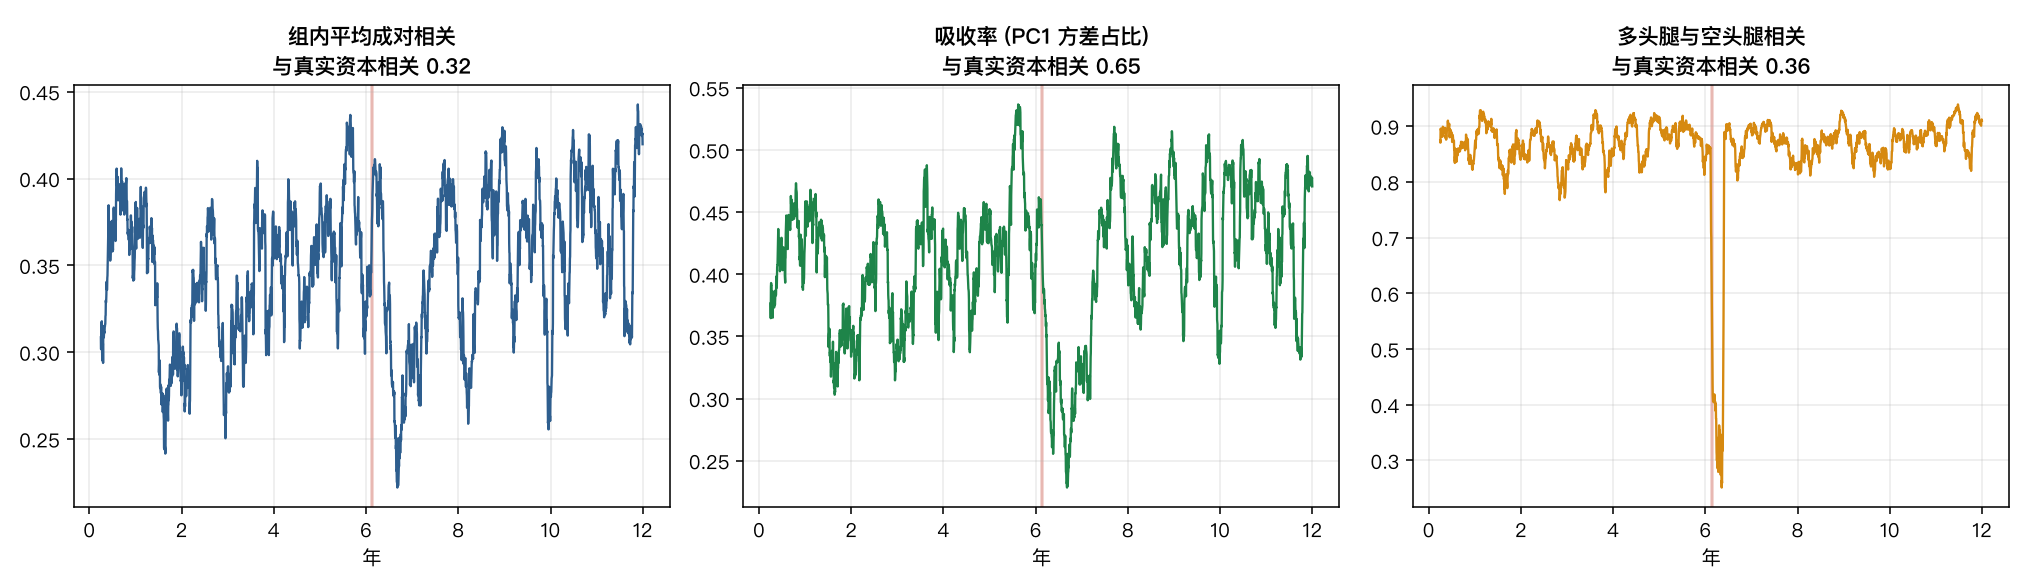
与不可观测的真实资本的相关性:
| 指标 | 与真实套利资本的相关 |
|---|---|
| 组内平均成对相关 | 0.316 |
| 吸收率(PC1 占比) | 0.653 |
| 多空双腿相关 | 0.357 |
| 三者复合(等权 z-score) | 0.560 |
| 复合 + EWMA 21 日平滑 | 0.638 |
吸收率单独就赢过复合指标(0.653 vs 0.560)。这不是意外——它直接度量”整个截面被多少个共同因子驱动”,与拥挤的定义最接近。加权平滑后复合指标追平到 0.638。
平滑这一步值得说明:拥挤度是慢变量,日频读数噪声很大。EWMA(半衰期 21 天)把相关性从 0.560 提到 0.638。用的是单边指数加权,只看过去,不引入前视。
三、最重要的发现是负面的#
现在检验预测力。拥挤度对未来 3 个月收益的信息系数:
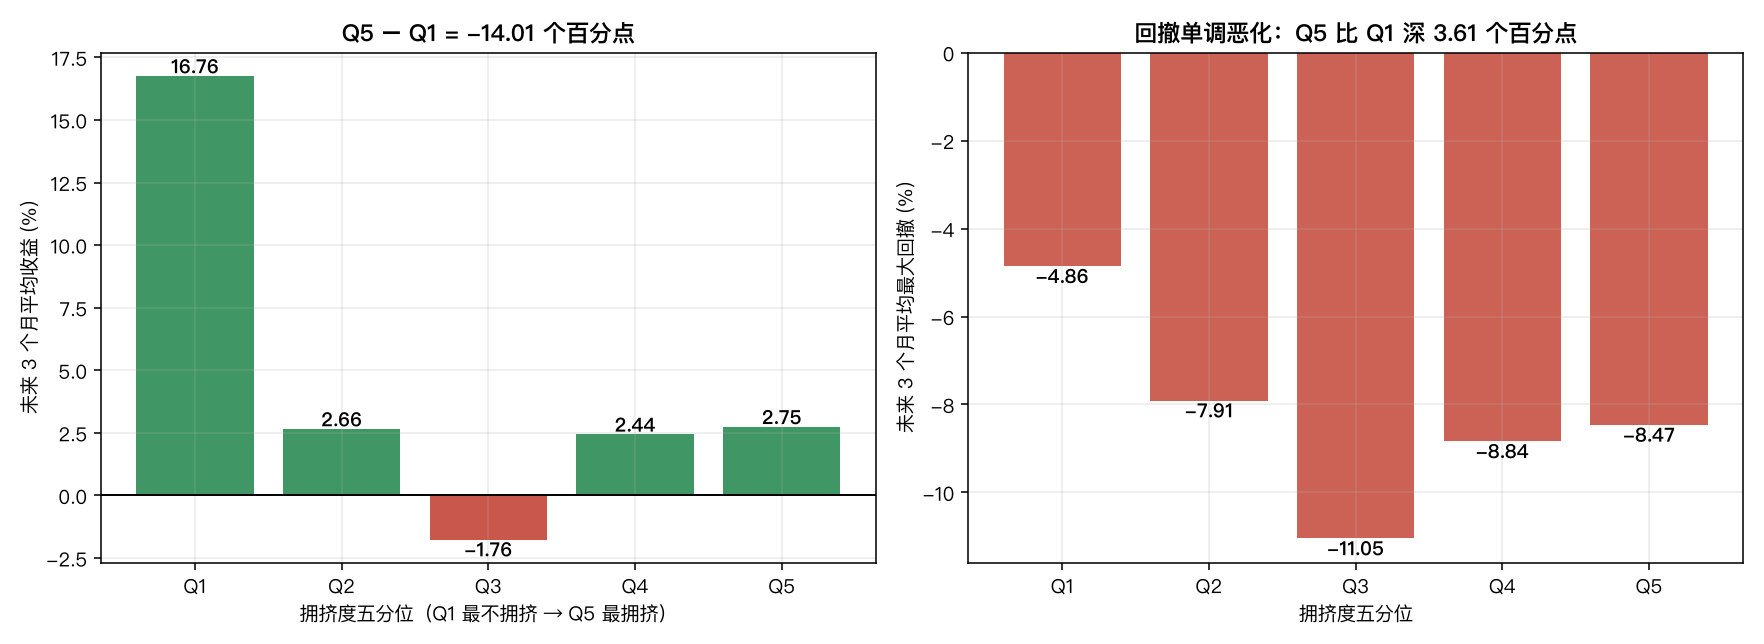
负相关,符合直觉——越拥挤,未来收益越差。但别急着建仓,看五分位:
| 五分位 | 未来 3 个月收益 | 未来 3 个月最大回撤 |
|---|---|---|
| Q1(最不拥挤) | +16.76% | -4.86% |
| Q2 | +2.66% | -7.91% |
| Q3 | -1.76% | -11.05% |
| Q4 | +2.44% | -8.84% |
| Q5(最拥挤) | +2.75% | -8.47% |
完全不单调。 Q1 一枝独秀,Q3 最差,Q5 反而比 Q3 好。
-0.327 这个 IC 几乎全部由 Q1 一个桶贡献。如果你只看 IC 就去做”拥挤度多空”,你会在 Q3 到 Q5 之间反复被打脸。
这是本文最值得记住的一条方法论:IC 是线性相关系数,它对单调性一无所知。 一个由单侧极值驱动的强 IC,和一个各分位平滑过渡的弱 IC,在下游策略里是完全不同的两种东西。任何时候看到 IC 都要追问一句:分位数长什么样?
那拥挤度还有什么用?看右边那张图——回撤的单调性明显好于收益。Q1 的未来回撤 -4.86%,其余四个桶在 -7.9% 到 -11.1% 之间。信号很清楚:
拥挤度告诉你什么时候容易受伤,不告诉你什么时候能赚钱。
四、落地:三种仓位调节#
按 z-score 调仓,信号滞后 1 天生效,避免前视:
sig = np.roll(crowd, 1)          # 昨天的读数决定今天的仓位
sig[:WIN + 1] = np.nan| 方案 | 年化收益 | Sharpe | 最大回撤 | 年换手 |
|---|---|---|---|---|
| 恒定满仓 | 15.61% | 0.899 | -54.37% | 0 |
线性减仓 clip(1 − 0.45z, 0, 1.6) | 19.90% | 1.145 | -55.70% | 1.31 |
阈值切档 z>1 → 0.35 仓 | 14.67% | 0.851 | -54.37% | 0.22 |
两个结果需要诚实面对:
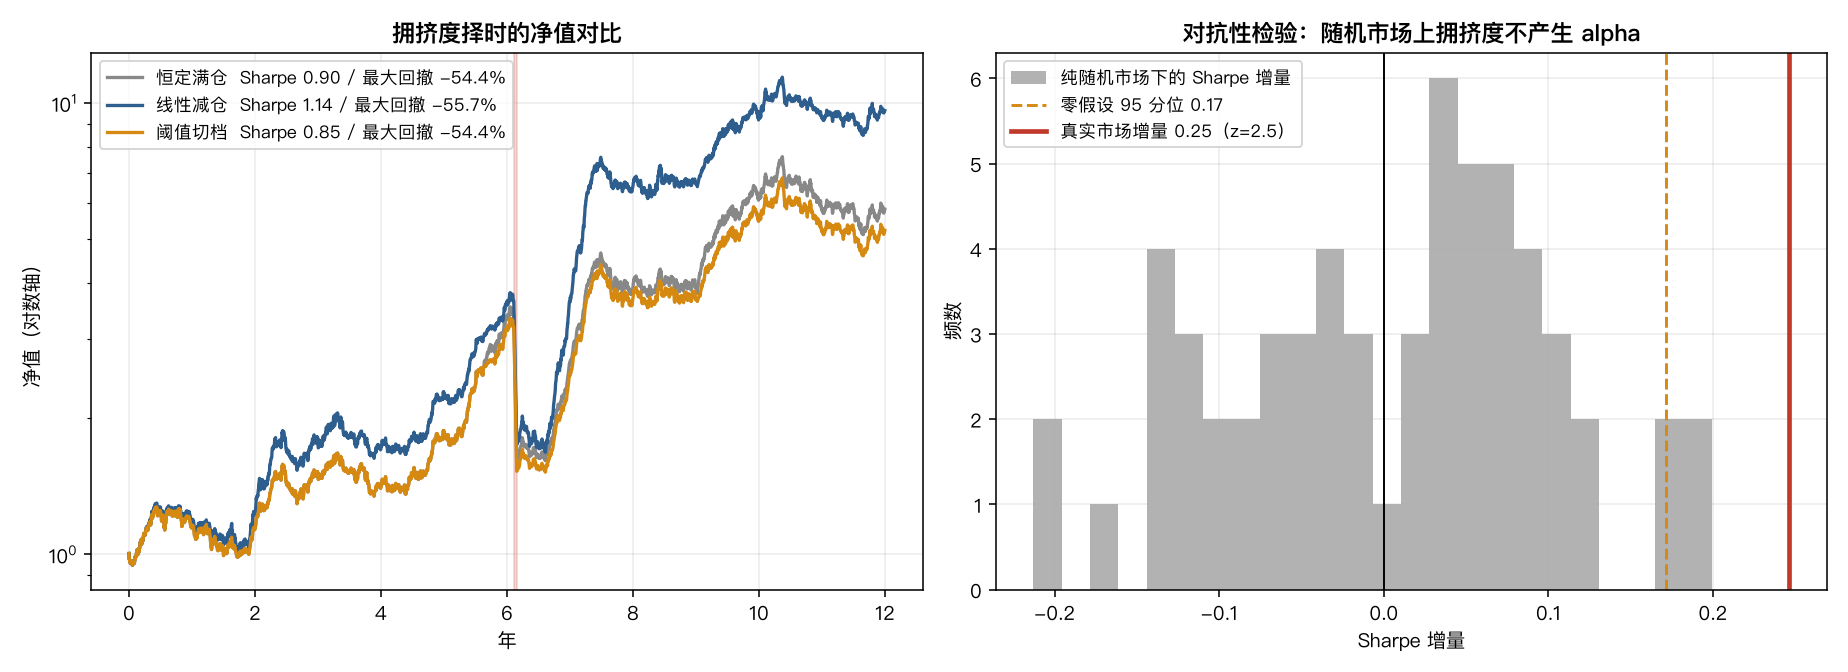
第一,阈值切档几乎没用(Sharpe 0.851 < 0.899,回撤一点没减)。原因看第三节的五分位——最拥挤的 Q5 并不是最危险的桶。设一个”高于 z=1 就撤”的硬阈值,砍掉的恰恰不是最该砍的时段。
第二,线性减仓提升了 Sharpe,但没有降低最大回撤(-55.70% vs -54.37%,反而略差)。
第二点尤其重要,因为它直接违背了我在第三节给拥挤度的定位。原因是踩踏太快了:12 天亏 49.2%,而 EWMA 平滑的拥挤度需要几周才能显著上移。等信号发出,钱已经亏完了。
拥挤度择时改善的是长期的风险调整收益(避开了那些温水煮青蛙的高拥挤低回报期),而不是极端事件当天的保护。 想要后者,你需要的是止损和杠杆上限,不是一个慢变量指标。
五、对抗性检验:这会不会是我挖出来的?#
一套指标 + 一个仓位函数 + 若干参数,在单条路径上跑出 Sharpe 提升 0.246 —— 这完全可能是噪声。
必须做零假设检验:在纯随机市场(无因子、无拥挤、无反馈)上跑完全相同的流程,看能”挖”出多少 Sharpe。
def null_test(n_trial=60):
    gains = []
    for k in range(n_trial):
        Rn = g.standard_normal((T, N_STOCK)) * IDIO_SD \
             + (MKT_SD * g.standard_normal(T))[:, None]
        pr = Rn @ w
        cz = ewma(composite_crowding(Rn, pr), HL)     # 同一套指标
        ps = np.clip(1.0 - 0.45 * np.roll(cz, 1), 0.0, 1.6)
        gains.append(sharpe(ps * pr) - sharpe(pr))
return np.array(gains)结果:
| 数值 | |
|---|---|
| 随机市场 Sharpe 增量均值 | +0.004 |
| 标准差 | 0.097 |
| 95 分位 | +0.171 |
| 增量为正的比例 | 53.3% |
| 真实市场增量 | +0.246(z = 2.5) |
均值 0.004 ≈ 0,这证明方法本身不会凭空造 alpha,指标构造和仓位函数没有隐藏的前视偏差。
但同时:随机市场的 95 分位是 0.171。也就是说,纯靠运气,二十次里就有一次能挖出 0.17 的”提升”。真实市场的 0.246 对应 z = 2.5 —— 统计上显著,但只是勉强及格。
如果我在真实市场上得到的是 0.15,那它连噪声都跑不赢。这个零分布应该是所有择时研究的标配,它给出的是”多好才算好”的标尺。 没有这把尺子,任何 Sharpe 提升的数字都无法解读。
六、窗口敏感性#
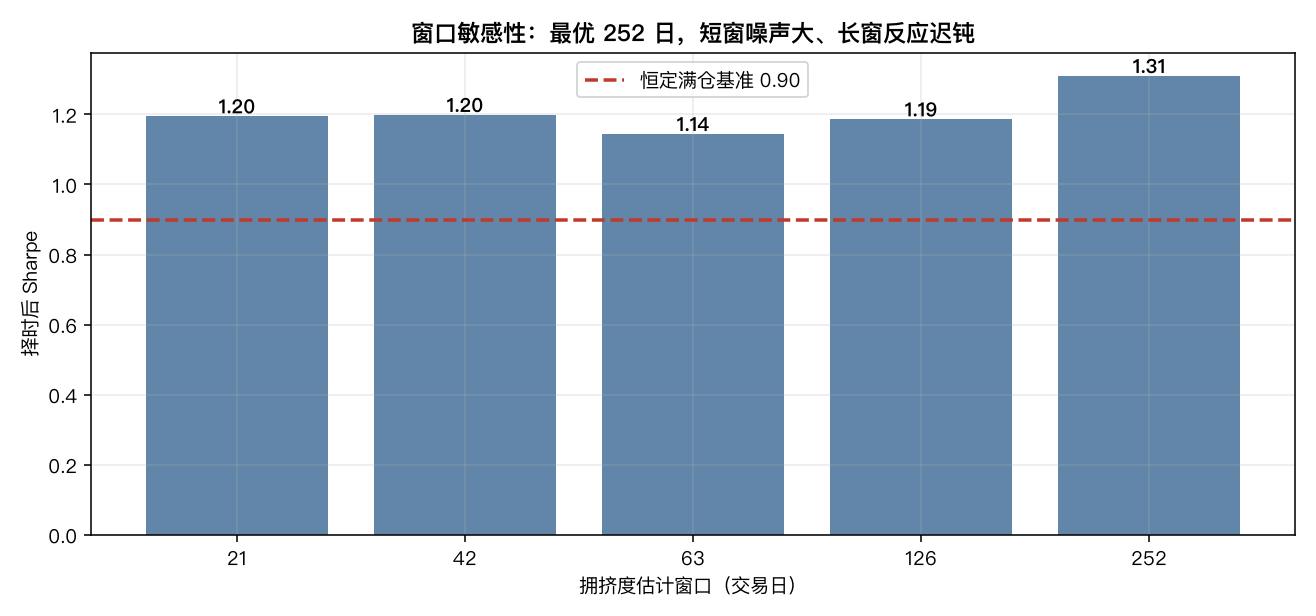
| 窗口 | 与未来收益 IC | 择时 Sharpe |
|---|---|---|
| 21 日 | -0.289 | 1.195 |
| 63 日 | -0.327 | 1.145 |
| 126 日 | -0.416 | 1.187 |
| 252 日 | -0.398 | 1.311 |
全部五个窗口都跑赢基准 0.899,没有一个窗口翻车——这是稳健性的好迹象,说明结论不依赖窗口的精细选择。
但注意 IC 最强的窗口(126 日)不是 Sharpe 最好的窗口(252 日)。又一次印证第三节:IC 和下游策略表现之间没有简单的单调映射。长窗口平滑掉了更多噪声,虽然相关性略降,但仓位信号更稳定、换手更低,净效果更好。
七、三盆冷水#
第一盆:反馈机制是我自己写进去的。 这是最根本的限制。我在 DGP 里显式实现了”资本推动价格”和”拥挤侵蚀收益”,然后发现指标能检测到它们——这在逻辑上接近循环论证。它能证明的只有一件事:如果现实中存在这样的反馈,那么这三个指标有能力捕捉到。至于现实中反馈的强度和形态,本文的模拟无法回答。要回答它,必须用真实的 13F 持仓、融券余额、ETF 资金流做交叉验证。
第二盆:纯价格代理会被误导。 吸收率上升可以是拥挤,也可以是普通的宏观风险上升(危机期所有相关性都上升,与套利资金无关)。本文的模拟里没有独立的宏观危机源,所以指标看起来很干净。真实数据里,你需要至少一个持仓类数据源来区分”资金拥挤”和”市场恐慌”这两种截然不同的高相关状态。这是本文合成实验相对现实最乐观的一处偏差,我倾向于把它明说。
第三盆:它救不了你的踩踏当天。 第四节已经量化了:线性减仓把 Sharpe 从 0.899 提到 1.145,但最大回撤纹丝不动(甚至略差)。拥挤度是慢变量,踩踏是快事件。用一个半衰期 21 天的指标去防一个 12 天完成的崩塌,时间尺度根本不匹配。真正的尾部保护来自杠杆上限、多因子分散和期权保护,不是来自任何一个监测指标。
八、结论#
拥挤度的正确定位是风险仪表盘上的一个读数,不是交易信号。
三条可落地的结论:
- 优先用吸收率。它最简单(一次特征值分解)、与真实拥挤相关最高(0.653)、经济含义最清楚。复合指标的边际收益不大
- 看分位数,不要只看 IC。本文的 -0.327 看起来很强,但五分位完全不单调,直接按 IC 建仓会亏钱
- 做零假设检验。随机市场的 95 分位是 0.171,这意味着任何低于 0.17 的 Sharpe 提升都不值得相信
而最实用的一条建议其实与指标无关:当你发现自己的因子最近特别好用、路演特别顺利、同行都在聊同一个信号时,那就是拥挤度最高的时刻。 价格数据里的吸收率往往只是在确认你已经知道的事。
指标的真正价值不在于告诉你新东西,而在于在你不想承认的时候,给你一个不带情绪的读数。