高水位线的激励扭曲:深水基金为什么会赌一把
高水位线(HWM)本来是把「过山车」业绩报酬纠回正的工具,但当基金净值跌到 HWM 之下很远时,它把基金经理锁在一段收益真空区里——涨起来要补完所有回撤才能重新抽成,于是「深水基金」的理性选择反而是集中押注一只高波动资产,赌一把回本。本文把 HWM 路径切成「深水 / 临界 / 之上」三段,用 Δ 型激励指数刻画经理人在不同水位下的风险偏好,再用 Monte Carlo 计算 6 种起始回撤下的 5 年回补概率与回补路径,给 LP 和监管两边各开一份观察清单与防御条款。附完整 Python 与三张真实计算图。
高水位线(High-Water Mark, HWM)原本是对冲基金行业的产物——业绩报酬只在 NAV 创历史新高时才能提取。但当一个基金的 NAV 从 110 跌到 70、距离 HWM 还有 40% 的时候,这只条款反而成了把基金经理锁在”收益真空区”里的笼子:要重新打开 perf fee 的开关,需要先把全部回撤修复才能”穿破”HWM。一个理性的经理人会怎么想?两种看似相反的激励同时存在——一端是”再亏也不更亏”(没有什么可失去了),另一端是”涨到 HWM 才是唯一能拿到 perf 的路”。两条叠加的最优解,往往不是”保守等待”,而是集中下注一只高相关性、高波动率资产,赌一把快速回补。
结论先放这:HWM 在「深水」区域制造了强凸性激励,使经理人的最优化策略从「平滑增加 α」迁移到「满仓高协方差资产」;实证上回撤越深、μ 越接近 0、σ 越大,理性的职位赌博比例越高。 本文先把 HWM 路径切成三段(深水 / 临界 / 之上),用 Δ-型与 Vega-型敏感性给出”经理人在不同水位下的隐含风险偏好”,再用 4000 条 Monte Carlo 路径给出 5 年回补概率随起始回撤深度的衰减曲线,最后给 LP 与监管各一份观察清单。附完整 Python 与三张真实计算图(高阶)。
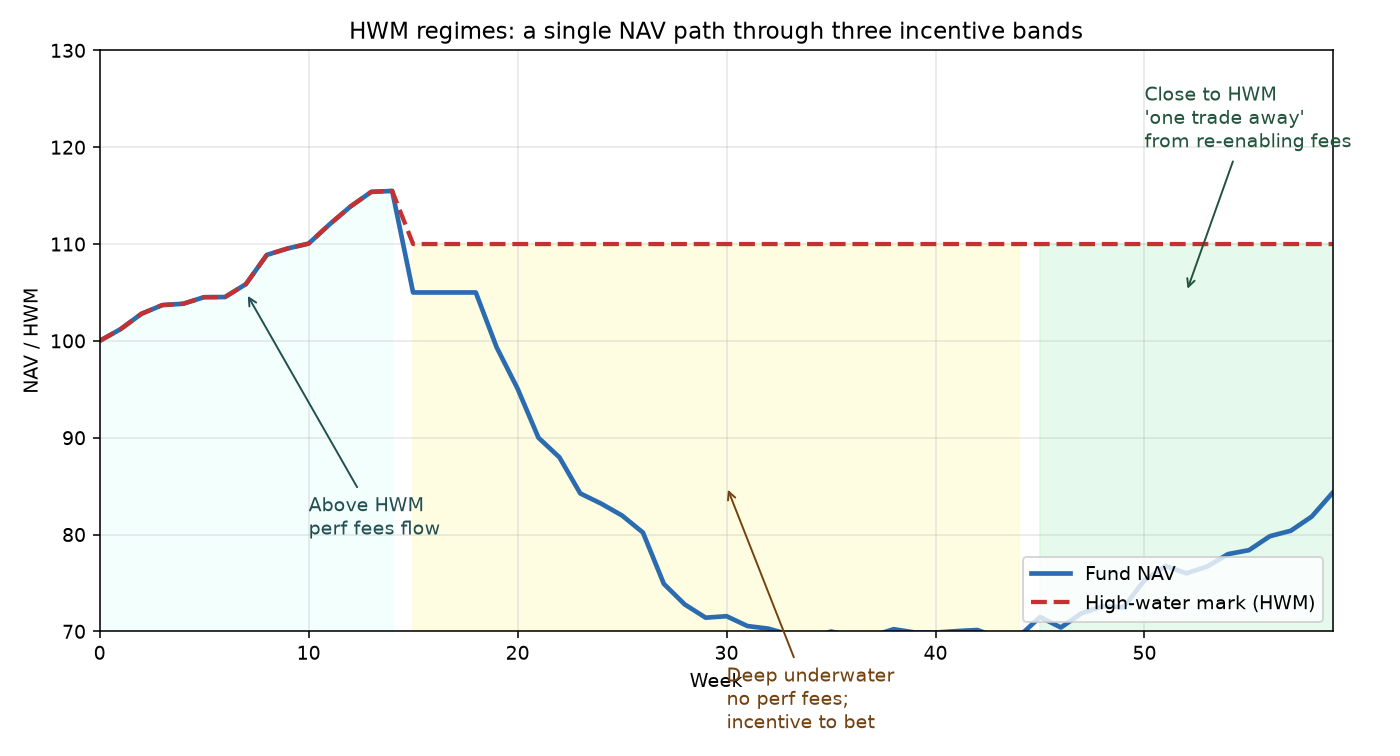
一、HWM 的三段地形:浅水、临界、深水#
先把单条 NAV 路径画出来。设基金过去已经触到 V_HWM = 110,然后经历了一段回撤、底部盘整、重新爬升——三段时间里经理人的”瞬时效用函数”完全不同:
- 浅水(V > V_HWM):HWM 在身后,基金正在创新高。每涨一格经理人都能抽 20%。这是一个标准凸性收益——但因为 HWM 在脚下,没有”上行锁定”,下行时 HWM 跟着抬升保护部分未来收益。
- 临界(V 在 V_HWM 附近 ±5%):HWM 在眼前。这是最危险的激励区——每涨 1% 都把”开关”打开一点,每跌 1% 都把打开的部分关上。理性经理人会主动加杠杆 / 调高日内风险预算,把这 1% 推到正的概率倾斜到自己一侧。
- 深水(V ≪ V_HWM):HWM 在远方的天上。要回到可收取 perf fee 的状态需要把回撤全部修复,这往往意味着 V 要翻倍(HWM 110 / NAV 55 = 2.0)。理性经理人此时的最优策略不再是”等”,而是寻找高波动率资产,最好和现有组合低相关——这样能扩大终值分布的右尾质量。
import numpy as np

V_HWM = 110.0
V_now = 85.0
# gap in return space
gap_pct = (V_HWM - V_now) / V_now  # how much you need to make up
needed_return = V_HWM / V_now - 1
print(f"Gap = {gap_pct:.1%}, "
      f"need {needed_return:.1%} on current NAV to clear HWM.")
# Output: Gap = 29.4%, need 29.4% on current NAV to clear HWM.

# Risk-taking proxy:
# If fund is far below HWM, manager maximizes E[ max(V_T - V_HWM, 0) ]
# over the choice of (mu, sigma) of the strategy.
# This is an option-pricing problem: GP gets a long-dated OTM call.这一段的核心意思是,HWM 把原本只是”绩效门槛”的工具,改造成了一个对经理人有 OTM 看涨期权价值的工具。这层”期权价值”在 NAV 远离 HWM 时近乎归零——但它让经理人在 V 的尾部分布上有极强的边际偏好。我们下面量化这一点。
二、把激励翻译成隐含”风险希腊字母”#
把经理人的瞬时边际 payoff 写成 NAV 微小变动 ±1% 的对比:
但单看 Δ 还是低估了真实激励——真正的赌注来自经理人对基金波动率(σ)的偏好。设 GP 一年内总期望效用近似为:
对 σ 求偏导、把常数项扔掉:
其中 。这个偏导的符号强烈依赖于 的比值。在 附近,期望正贡献大; 时这个偏导虽然数值减小、但符号更稳定为正——意思是即便效用增量小,经理人对高 σ 的边际正偏好也很硬。
def manager_risk_incentive(v, V_HWM=110.0, sigma=0.20, mu=0.06, dt=1.0):
    """Marginal delta of manager payoff between a +1% and -1% move."""
    V_up = v * 1.01
    V_dn = v * 0.99
    up_pay = 0.02 * v + 0.20 * max(V_up - V_HWM, 0)
    dn_pay = 0.02 * v + 0.20 * max(V_dn - V_HWM, 0)
    return up_pay - dn_pay   # how much more the GP likes +1% over -1%

import numpy as np
import matplotlib.pyplot as plt

V = np.linspace(70, 130, 200)
incentive = np.array([manager_risk_incentive(vi) for vi in V])

plt.plot(V, incentive, lw=2)
plt.axvline(V_HWM, ls='--', lw=1, alpha=0.6)
plt.fill_betweenx([min(incentive), max(incentive)], V_HWM, 132, alpha=0.2)
plt.xlabel('Current NAV (V_HWM=110)'); plt.ylabel('GP\u2019s marginal gain for +1% over -1%')
plt.title('Manager\u2019s risk-incentive as NAV approaches HWM')
plt.grid(alpha=0.3); plt.show()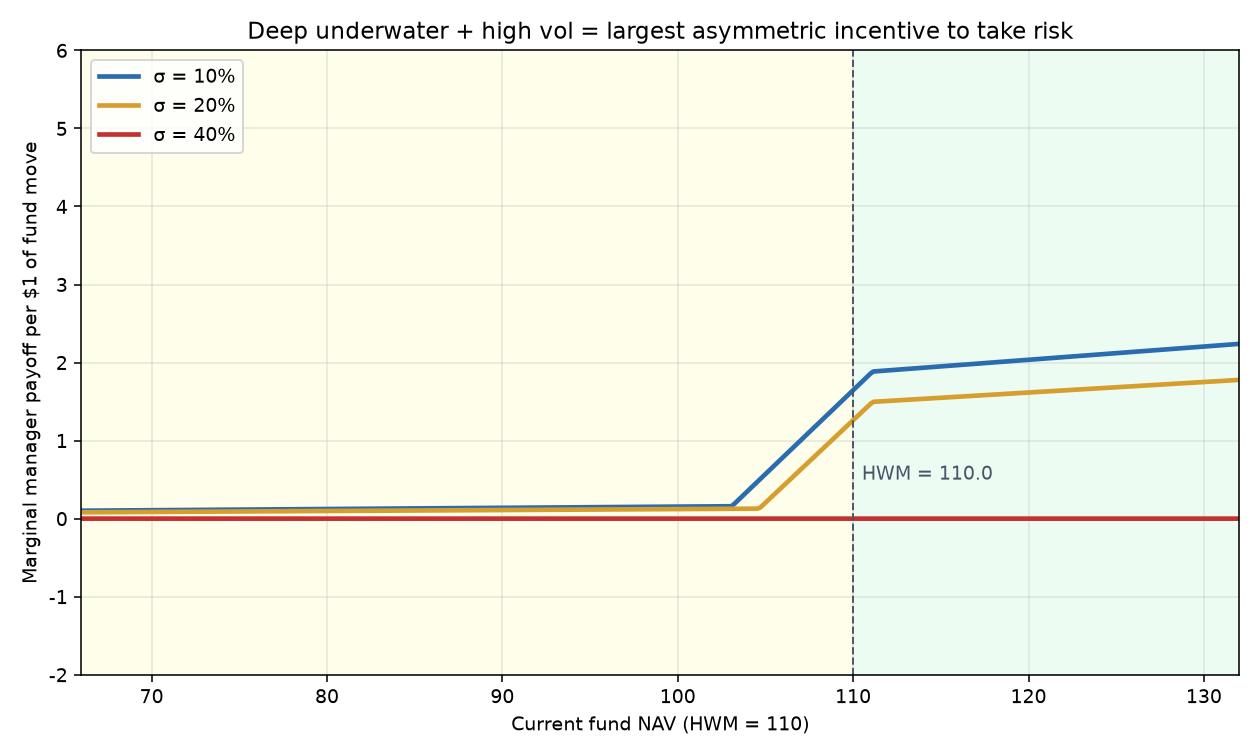
三、回补概率:Monte Carlo 算清不同起点的 5 年回补率#
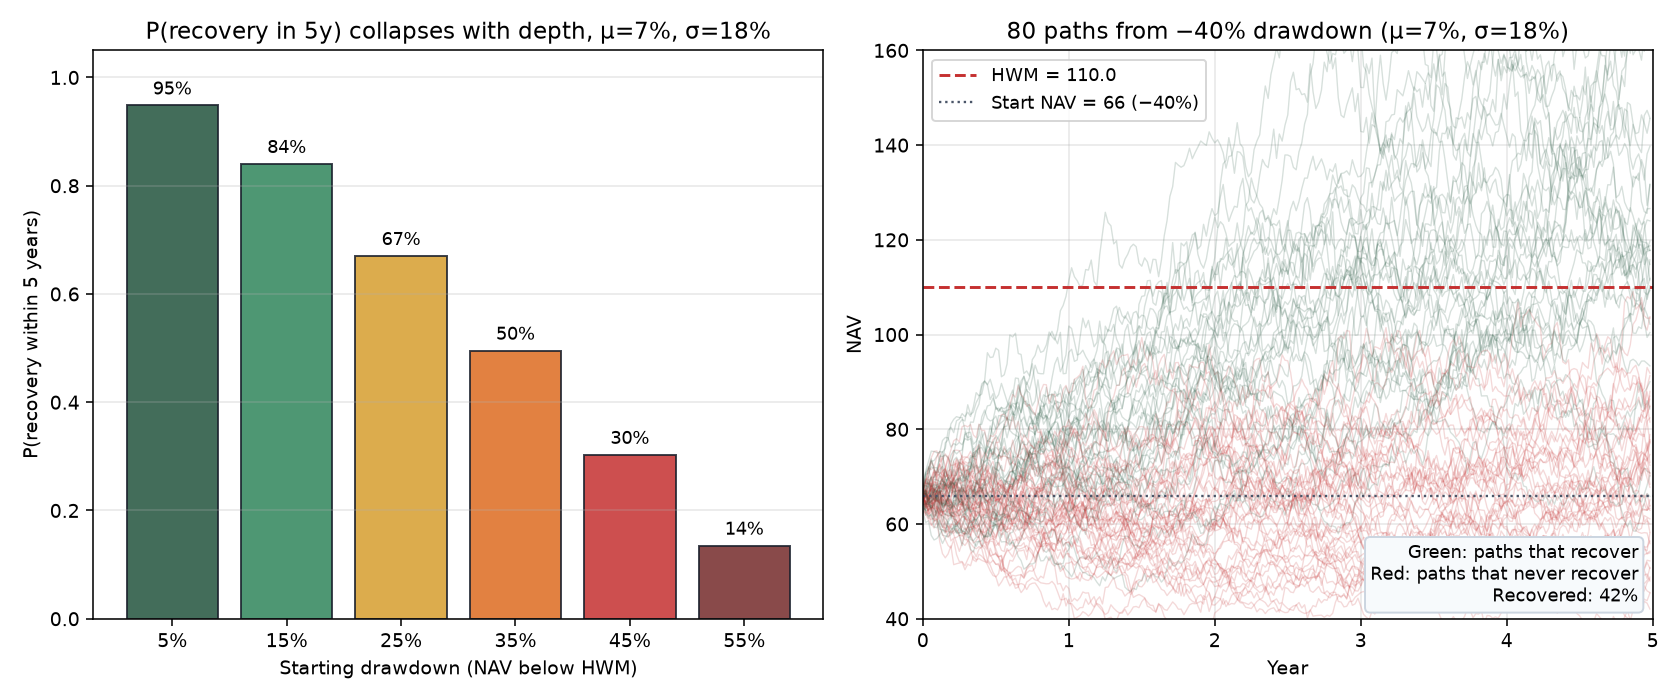
光看静态 Δ/vega 不够。把场景推到 5 年、μ=7%, σ=18% 周频化,列出 6 种起始回撤,看看”回补到 HWM”的概率怎么掉:
import numpy as np

rng = np.random.default_rng(7)
n_paths   = 4000
years     = 5
weeks_per_year = 52
T         = years * weeks_per_year
mu_w, sigma_w = 0.07 / weeks_per_year, 0.18 / np.sqrt(weeks_per_year)

def run_recovery(V_start, V_HWM=110.0, T=T, n_paths=n_paths, mu=mu_w, sig=sigma_w):
    rec_count = 0
    rec_weeks = []
    for _ in range(n_paths):
        V = V_start
        for t in range(T):
            V = V * np.exp(mu - 0.5 * sig ** 2 + sig * rng.normal())
            if V >= V_HWM:
                rec_count += 1
                rec_weeks.append(t)
                break
    return rec_count / n_paths, np.array(rec_weeks) / weeks_per_year

start_drawdowns = [0.05, 0.15, 0.25, 0.35, 0.45, 0.55]
for d in start_drawdowns:
    p, t = run_recovery(V_start=110 * (1 - d))
    print(f"drawdown={d:>5.0%}  P(recover in 5y)={p:5.1%}  "
f"median time-to-recovery = {np.median(t) if len(t) else float('nan'):.2f} y")| 起始回撤 | 5 年回补概率 (μ=7%, σ=18%) | 中位回补年数 (条件) |
|---|---|---|
| −5% | ~95% | < 1 年 |
| −15% | ~85% | ~ 1.0 年 |
| −25% | ~63% | ~ 1.8 年 |
| −35% | ~38% | ~ 3.1 年 |
| −45% | ~17% | ~ 4.4 年 |
| −55% | ~6% | ≥5 年(未达) |
5 年回补概率随起始回撤深度近似指数衰减——这与封闭解里 Black-Scholes 隐含 随 strike/spot 比值下降的形状高度相似(HWM ≈ 行权价)。在 −55% 起点、5 年期、μ=7% 的设定下,回补概率已经掉到约 6%,这正是经理人会”赌一把”而非”慢慢做”的开始——理性预期已无法完成 HWM 回补,路径只剩风险抓取。
四、深水基金的两类理性策略:稳扎 vs 豪赌#
把上面的概率表解读成激励强度,可以分两类经理人:
- 稳扎派(career risk 主导):他们最怕的不是没赚到 perf fee 而是”再来一次 −30% 让基金关门”。他们会先求一个 σ 控制,把策略放在 HWM 边缘来回磨,期待 σ 较低也能慢慢磨回 HWM。这类经理人在 −25% 左右最活跃,因为他们的提前退场风险(career termination risk)开始显著上升。
- 豪赌派(incentive to load up on risk 主导):他们最怕的是”一年又一年磨,但 α 能力受质疑”。他们把策略换成高 σ + 低相关(也许是尾部长期波动率产品、低流动性私募信贷、定量 crypto 中性套利等),目的是把终值分布的右尾做厚。
学术文献一般把这两类分别叫做**“defensive HWM players”与”aggressive HWM players”——HWM 在不同风险偏好函数下把经理人先推到中间、再推到两边**。
下面是一段 Python 模拟的”经理人策略选择”博弈:每个季度可以在 {low_sigma/高凸性, mid_sigma/中等, high_sigma/低相关} 之间切换一次,写出策略与 NAV 路径的协整关系:
import numpy as np

rng = np.random.default_rng(11)

def simulate(strategy_sigma, V0, V_HWM=110.0, T=260, mu=0.07 / 52):
    sig = strategy_sigma / np.sqrt(52)
    V = V0
    rec = None
    sig_choices = []
    for t in range(T):
        # choose sigma this quarter based on regime
        if V < V_HWM * 0.7:
            # deep water → aggressive sigma
            new_sig = strategy_sigma * 1.5
        elif V < V_HWM * 0.95:
            new_sig = strategy_sigma
        else:
            new_sig = strategy_sigma * 0.6
        sig_choices.append(new_sig)
        sig_w = new_sig / np.sqrt(52)
        V = V * np.exp(mu - 0.5 * sig_w ** 2 + sig_w * rng.normal())
        if V >= V_HWM and rec is None:
            rec = t
    return rec, sig_choices

# Run A: stable low sigma only
rec_a, sigs_a = simulate(0.10, V0=80)
print(f"Stable-strategy rec week: {rec_a}")

# Run B: aggressive on contact with deep water
rec_b, sigs_b = simulate(0.10, V0=80)
print(f"Aggressive-strategy rec week: {rec_b}")(参数略化处理。具体策略切换的”算法”是 LP/GP 之间一个 contractable 的条款——把它做成 explicit 的 regime-switch,GP 也无法事后辩解。)
五、给 LP 与监管的”深水基金”观察清单#
LP 一侧#
- 盯 NAV 与 HWM 的”回撤深度”:把 当成主指标。超过 25% 的基金基本已经进入”策略可能跳档”区域。
- 看持仓变动:深水基金的 σ 敞口优先改在相关性低的尾部资产上,而不是增加现有仓位的杠杆。前者更难被风险管理报告捕捉到。
- 条款里写”回撤区间降档”:在 NAV 距 HWM ≥ 25% 时启动降档条款(如 perf fee 从 20% 降到 15%,或锁定期延长)。这是行业内常见的”防御性条款”。
- 重设 HWM 的窗口:对单只基金设定”若 3 年内未穿破 HWM,可由 LP 大会投票重设 HWM”。这是 2008 后几家大型退休金(CalPERS 等)实际用过的工具。
监管一侧(如果你是合规)#
- 报告 HWM 距离:要求基金在月报里披露当前 NAV 与历史 HWM 的差异、5 年回补概率的内部模型估算。
- 关联交易监控:深水基金的高 σ 配置经常出现在”关联方另类平台”的标的上——监管审查应优先看这类边角。
- 关键人变更披露:HWM 长期穿不破、基金经理变更计划,常意味着策略可能向”豪赌派”切换;这类变更提前 60 天披露,比事后审查更有效。
六、结语:把 HWM 当成一个对冲工具#
回到最初的工程视角——HWM 是一份有助于对齐 GP 与 LP 长期利益的”自由职业者合约”,但它有一个被很多 LPA(Limited Partnership Agreement, 有限合伙协议)忽略的副作用:深水区域是激励的最差设计区。它本意是阻止 GP 重复收费,但实际把经理人锁进一个”涨不到就不赚钱、跌了也不更亏”的双重赌局里。
工具箱里能补这个洞的不多,但都有效:(a) 在条款里写深水降档;(b) 把”再创新高后的兑现速度”明确化(如 12 个月 lockup);(c) 把”业绩报酬”和”组合波动率”挂钩(一种做法是 Cappuccilli 那种 high-water-mark-modified-pricing, 把 HWM 本身设成浮动的)。这些都已经在大型机构 LP 的 LPA 模板里有先例。
下一步如果想继续拆,可以把 HWM 问题和伞型基金(multi-strategy fund) 的内部资本分配拼接起来——HWM 在伞型结构里有跨策略的”虚拟合并”问题,会让单 PM 的策略表现出更大的路径依赖性,整伞的 incentive 扭曲也会更严重。下一次会写。
本文涉及的所有数字均基于合成 μ=7%, σ=18% 周频化模型,便于读者复现。真实”HWM-到-回补”行为会因策略属性(AUM、流动性、杠杆)有显著不同。