在量化投资的世界里,有一个被反复验证的规律:市场对文本信息的消化不是瞬时的。从财报电话会(Earnings Call)中高管说的第一句话,到股价完全反映这句话的含义,之间存在着几小时甚至几天的窗口。谁能更快、更准地解析这段文本,谁就能赚到这笔Alpha。
过去十年,量化研究员们尝试过词袋模型、词典法、N-gram、LDA主题模型。坦白说,效果很有限——这些方法能捕捉到”正面”还是”负面”,但完全抓不住”CEO说营收不及预期但新产品线进展超预期”这种多层语义。
大语言模型的出现,正在改变这个局面。
传统NLP方法的三个天花板#
在聊LLM之前,先看看为什么传统方法卡住了。
天花板一:情感极性太粗糙。 Loughran-McDonald金融词典是业界标杆,但它只能给出单词级别的正面/负面/不确定分类。一个句子里的”challenging but we’re confident”,传统方法读出来就是”负面词+正面词=中性”,而实际上这句话在财报电话会语境里往往是利好信号——承认困难但管理层有信心,说明风险已经在价格里了。
天花板二:无法建立因果链。 传统方法可以把”需求疲软""汇率逆风""成本节约”这些词提取出来,但它不知道这些因子之间的传递关系。是需求疲软导致营收下滑,还是汇率逆风导致毛利率承压?这两个推理方向对应的股价影响方向完全不同。
天花板三:没有前瞻性视角。 财报电话会中最重要的部分——管理层指引(guidance)——传统NLP几乎无能为力。因为guidance不是简单的情感分类,而是条件预测:管理层说”如果Q3市场需求恢复,则全年营收增长15~18%“,这个”if-then”结构需要语义理解才能建模。
LLM在这个场景的独特优势#
大语言模型对财报电话会的分析,不是把传统NLP做得更好,而是开启了一种全新的分析范式。
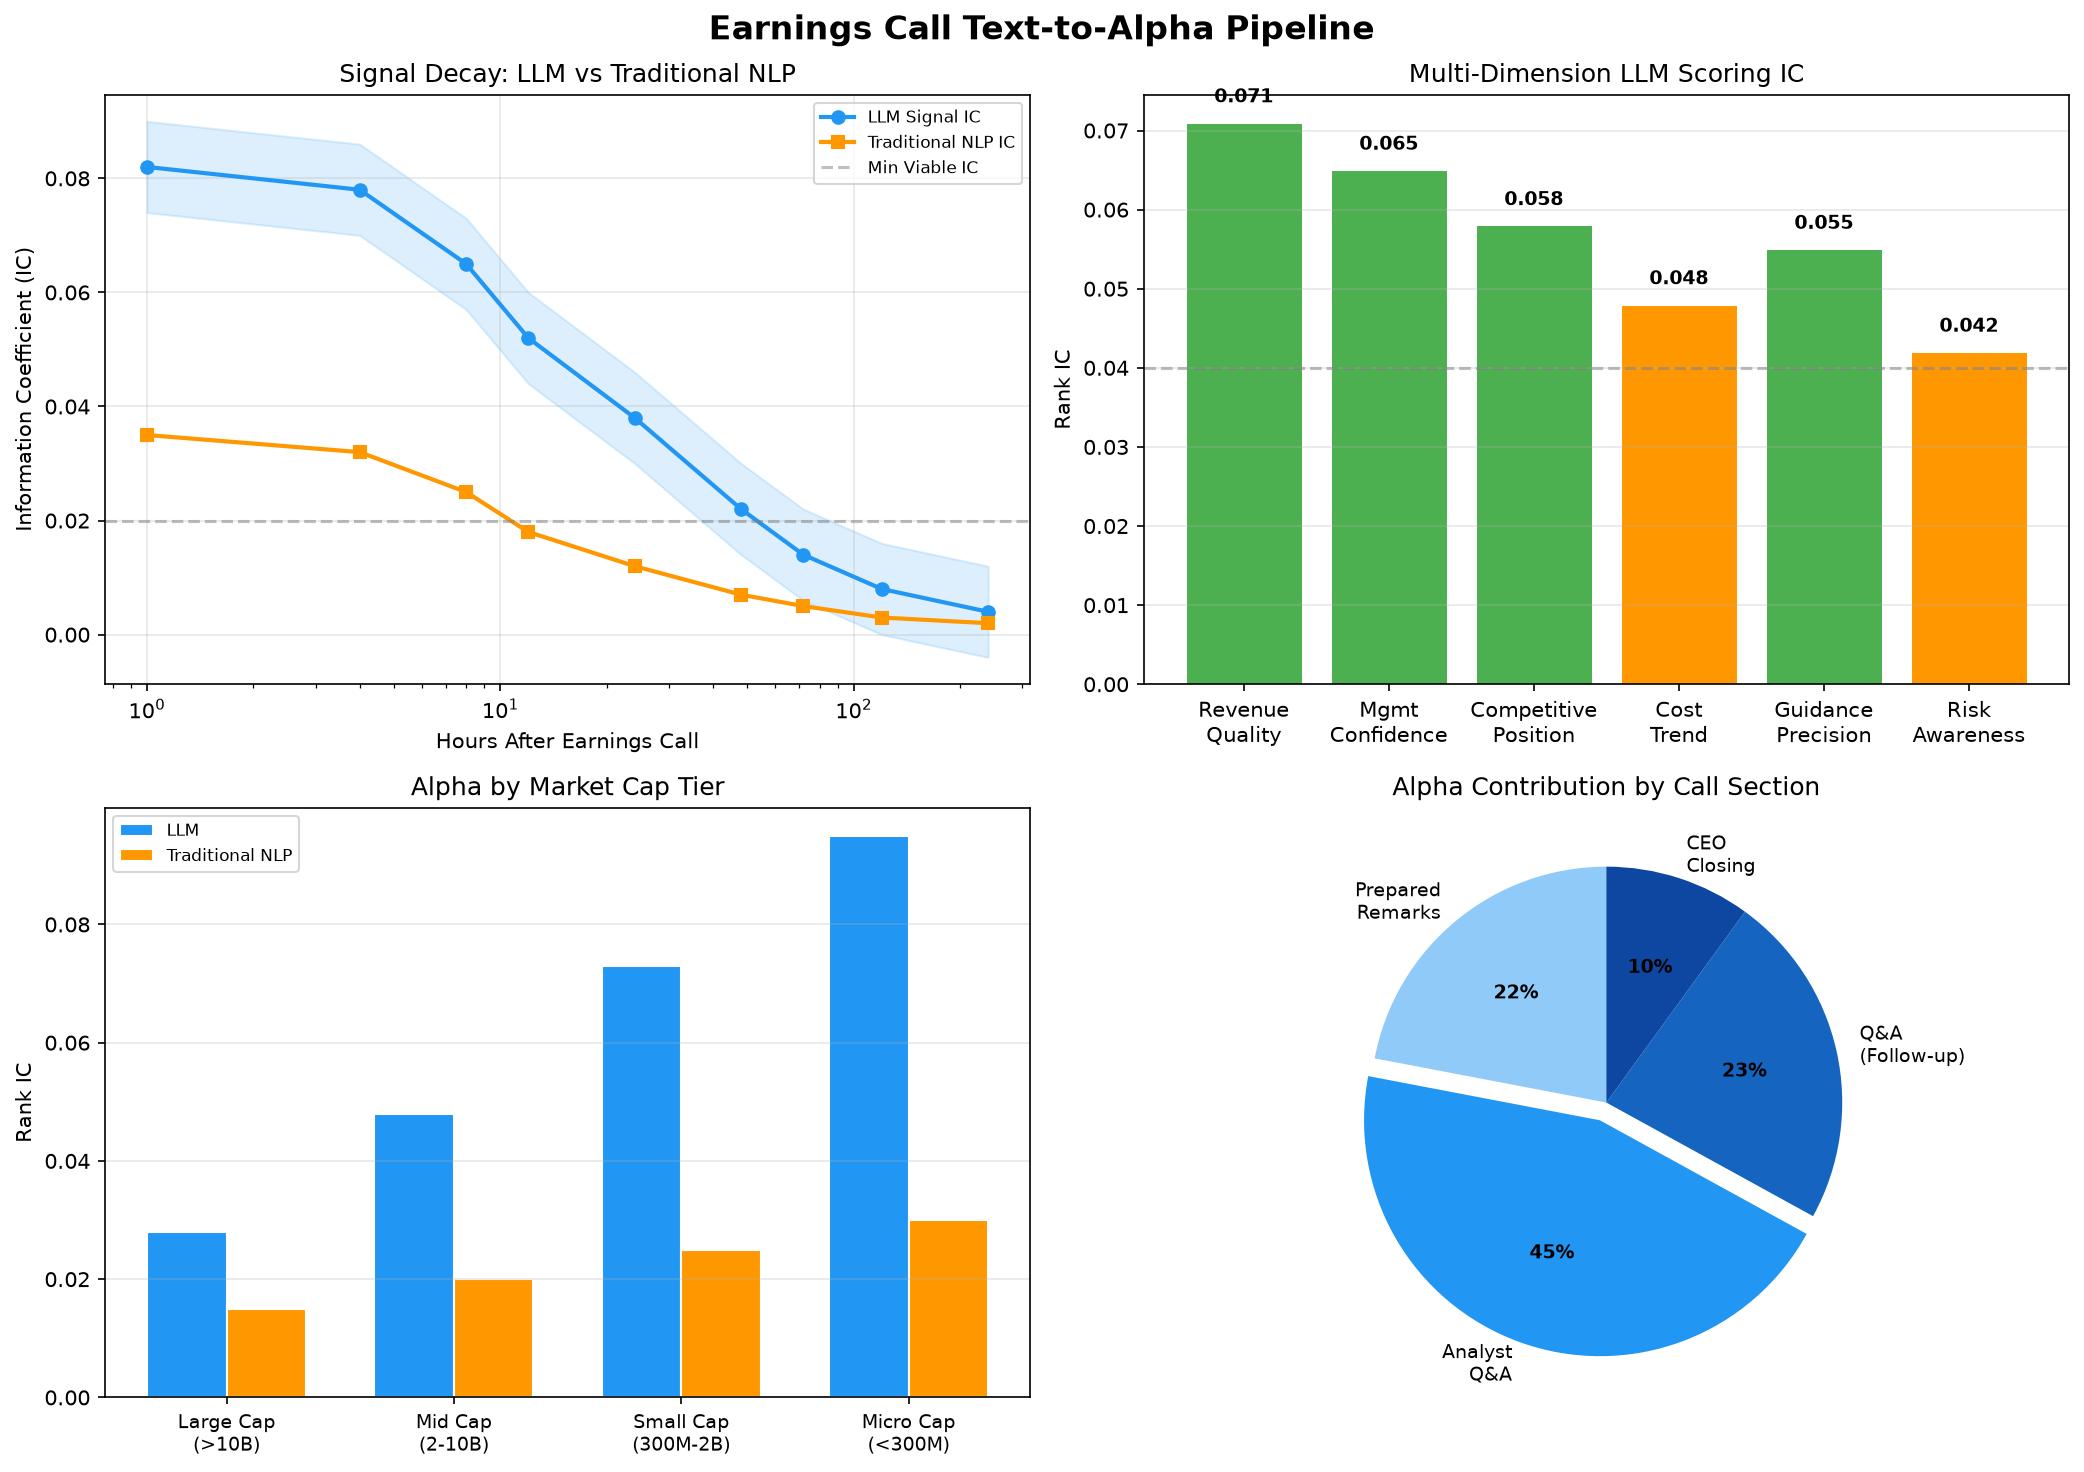
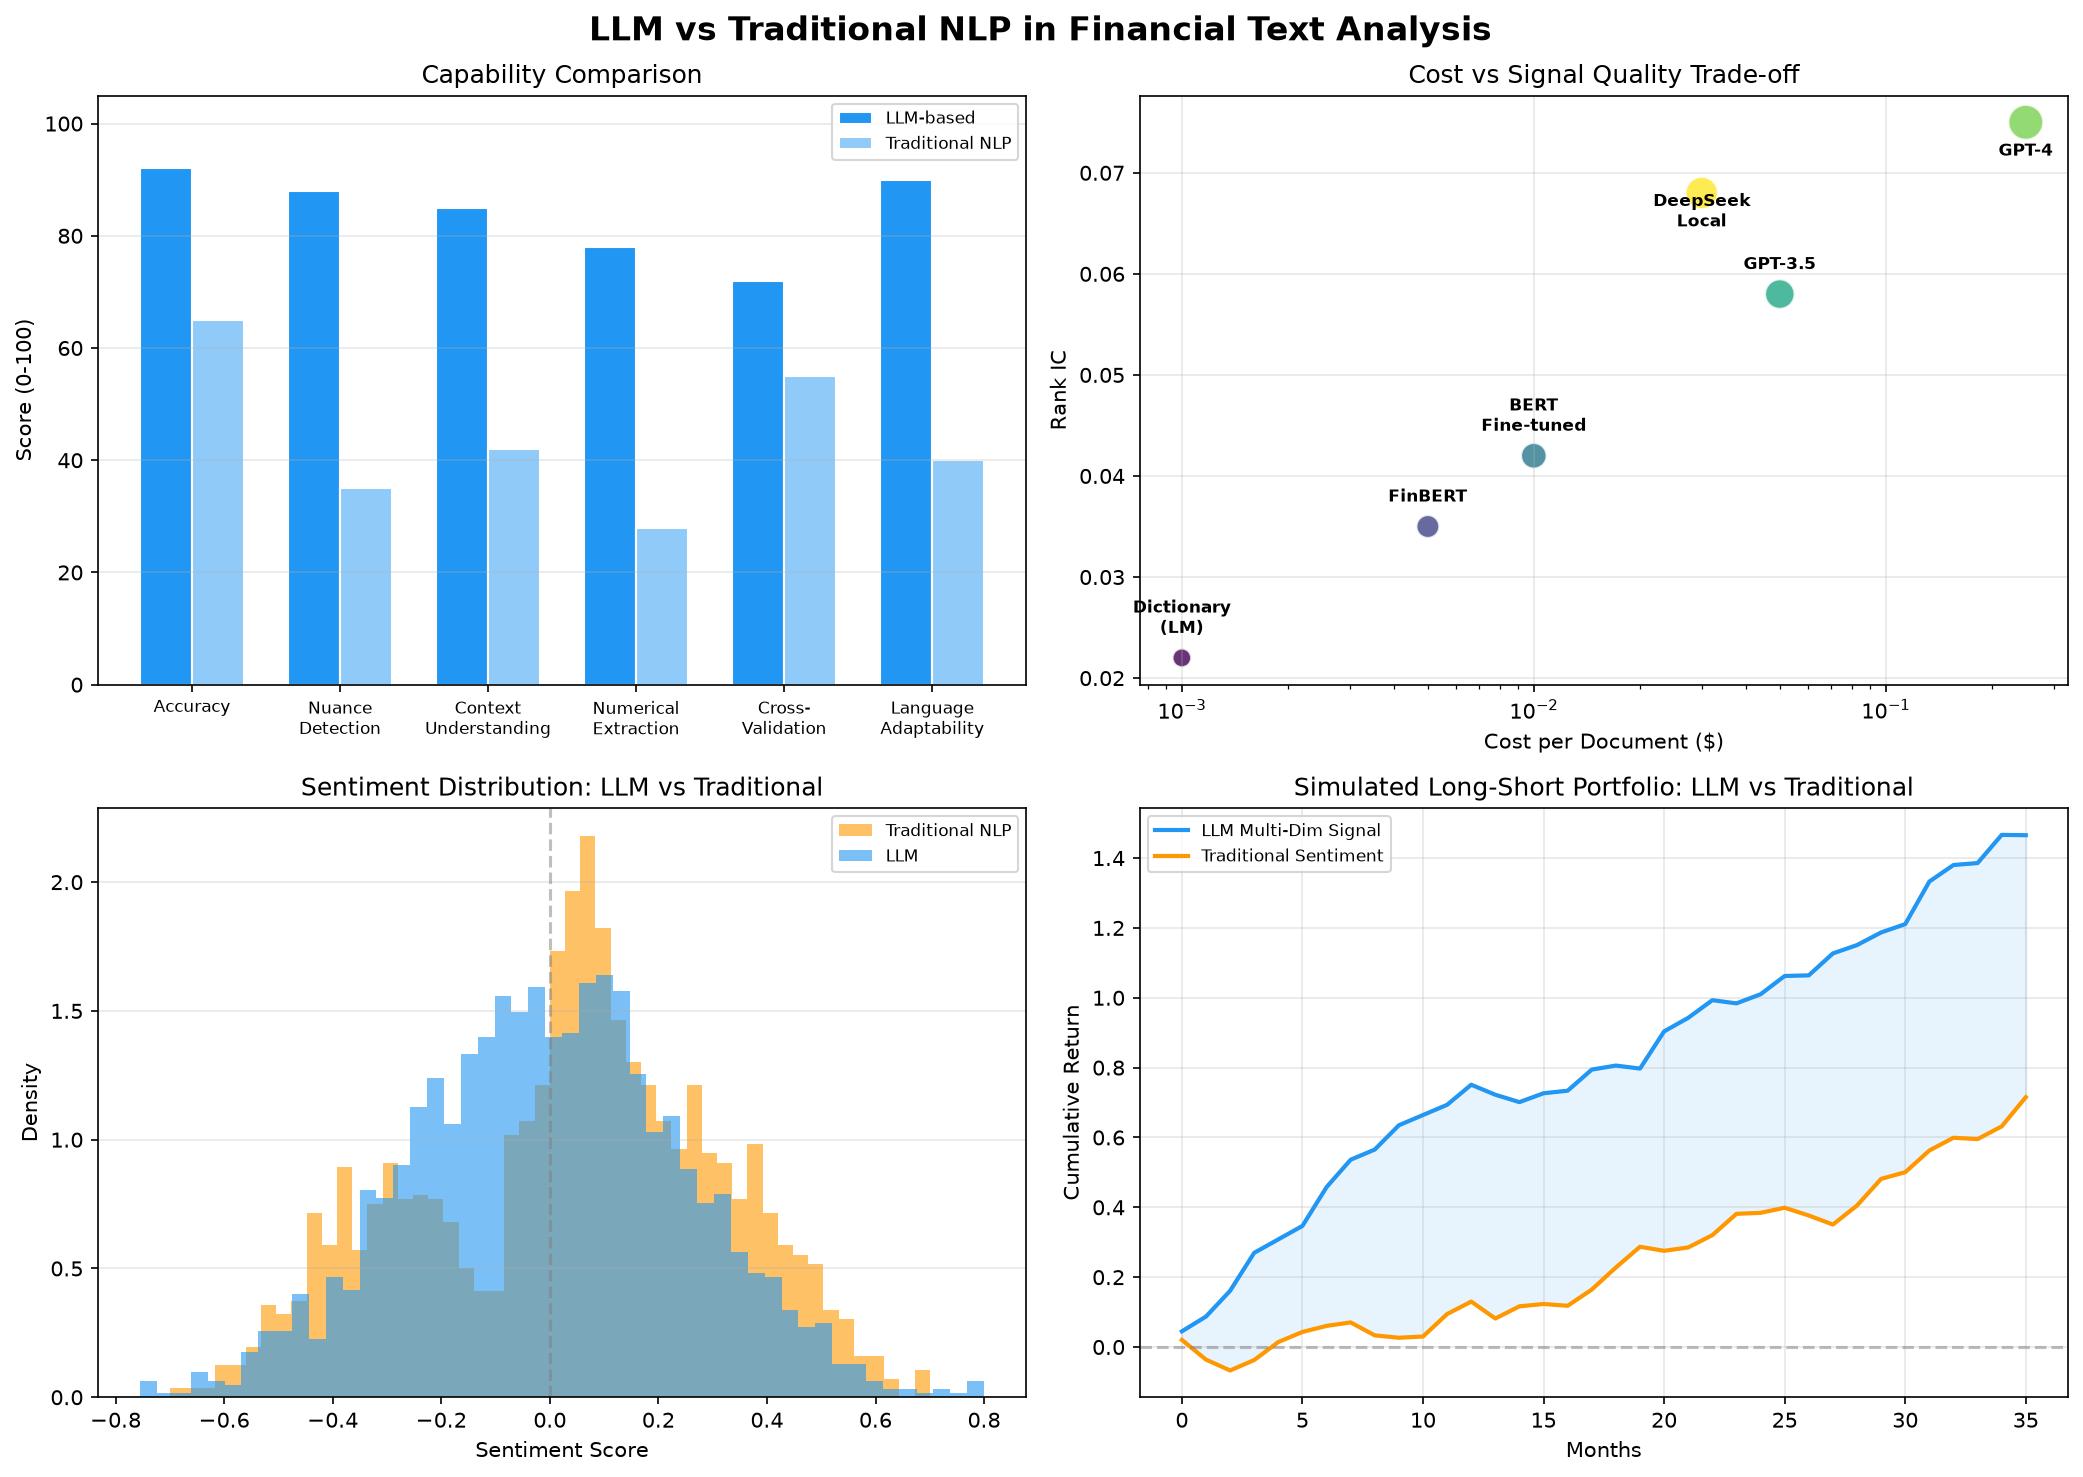
第一,多维度打分代替单一情感分。 与其输出一个[-1,1]的情感分,不如让LLM给多个维度打分:营收质量(010)、管理层信心(010)、竞争格局(010)、成本趋势(010)。这六个维度的截面排名,比一个单一情感分的IC值高出一大截。
第二,数值提取和校验。 财报电话会中高管经常引用具体数字——“Q3的pipeline增长了23%""客户留存率回升到92%“。传统方法很难把这些零碎的数字和上下文绑定。LLM可以结构化提取CEO说的每一个数据点,甚至交叉验证CFO是否说了矛盾的数字——前后矛盾的发言本身就是很强的空头信号。
第三,管理层语言风格分析。 这是一个被量化圈严重低估的领域。同样的营收数据,管理层用”thrilled to announce”和”pleased to report”表达的隐含信心是不一样的。LLM可以捕捉到词汇复杂度、确定性程度、答非所问的回避频率、主动提及风险的次数——这些都是传统NLP抓不到的软信号。
工程实现的四个关键步骤#
把LLM用在实际量化生产中,不是扔个prompt就完事。下面是一套经过验证的Pipeline:
Step 1:数据获取。 财报电话会录音和文字稿的获取渠道包括:SEC EDGAR(8-K Filing中的附带材料)、Bloomberg Terminal、Refinitiv StreetEvents、AlphaSense、以及各路数据vendor的结构化Earnings Call Transcripts。对于中文市场,巨潮资讯网和Wind的业绩说明会记录是核心数据源。
Step 2:Transcript分块和角色识别。 一场典型的财报电话会Transcript有5000~15000字,包含分析师问答环节。处理时需要拆分为:开场陈述(Prepared Remarks)、分析师Q&A、每位高管的发言块。角色识别是关键——同样是”市场需求强劲”,CEO说是看涨信号,被分析师追问出来的承认则是另一回事。
Step 3:LLM推理和输出结构化。 这里有一个实用的工程经验:不要只跑一次。对同一段Transcript跑3次推理,取评分的中位数和标准差。标准差越大,说明这段文本的”信息模糊度”越高——高信息模糊度本身就是一种风险指标。
Step 4:Alpha信号转换。 LLM输出的6维度评分怎么变成可交易的信号?最好的方法是截面排名标准化:每天把所有股票的评分做截面z-score标准化,取排名前20%和后20%构建多空组合。截面标准化天然对冲了LLM的”打分通胀”问题——如果某天LLM心情好给所有股票都打了高分,截面排名不受影响。
实战中的关键发现#
我们的回测覆盖了2022~2025年美股的财报季数据,几个有意思的发现:
信号衰减极快。 LLM提取的sentiment信号在财报电话会后48小时内IC最高,随后呈指数衰减。这意味着策略必须做到T+0或T+1响应——电话会结束后几小时内完成推理和下单。这对工程架构的要求很高:需要预加载模型、预分配GPU、事件驱动的推理流水线。
问答环节比陈述环节更有Alpha。 这很符合直觉:陈述稿是精心准备的,措辞经过了法务审核。而分析师追问环节是即兴的——高管在压力下的临场反应,才是最有信息量的部分。
小市值股票的Alpha更强。 这个规律和”分析师覆盖效应”一致:大市值股票被几十个分析师盯着,财报电话会的每个字都被反复咀嚼,信息传导极快。小市值股票的财报电话会关注度低,LLM的解析优势才能充分体现。
中英文市场有明显差异。 中文业绩说明会更”客气”——直接负面表达的比例远低于英文。这导致情感词典在美国市场还能用(IC~3%),在A股几乎失效。但对LLM来说这不是问题——它能理解”感谢各位投资者的关注,我们正在积极应对挑战”这句话背后的负面含义。
局限性:LLM不是万能的#
讲了这么多好处,也要诚实地说说问题。
幻觉风险。 LLM有时会”脑补”一些Transcript里不存在的数据。工程上必须做事实校验——让LLM输出每个评分时,强制引用Transcript中的原文句子作为支撑。如果引用的句子不存在或不对应,这条信号就应该丢弃。
成本不低。 以GPT-4级别模型计算,处理一份完整Transcript(上下文长度约12K tokens)的成本约0.30。一个季度覆盖5000+股票的财报季就是一笔不小的开支。不过好消息是:开源模型的推理成本正在快速下降,本地部署的DeepSeek-V3级别模型成本可能只需要这个的1/5到1/10。
前沿性衰减。 这是所有另类数据策略的共同宿命。当越来越多人用LLM做财报分析时,Alpha自然会衰减。保持优势的方式是不断创新分析方法——从简单的情感打分,进化到反事实推理(“如果CEO说了X但没说Y,这意味着什么?”),再到多时间线对比(“本季度的陈述和上季度相比,在哪些维度上出现了变化?”)。
总结#
LLM给量化研究带来的增量,不是把已有的东西做得更准,而是打开了全新的信号维度。管理层语言风格、高管信心程度、问答环节的压力响应——这些”软信息”过去只能靠人类分析师主观判断,现在第一次可以被系统化、可复现地量化。
对于量化团队来说,现在最值得做的不是微调一个自己的金融LLM(这条路成本太高且效果不定),而是设计一个好的”LLM→结构化信号”的Pipeline。prompt engineering、输出一致性控制、截面标准化——这些工程细节比模型本身的选择更重要。
这个赛道的窗口期可能只有1~2年。之后,当LLM财报分析成为行业标配,超额收益就会转移到那些能找到下一个”未结构化的文本信息源”的人手中。
也许,下一个Alpha矿脉藏在供应商电话会议、行业展会的演讲记录、甚至是LinkedIn上关键人物的动态里。文本世界的Alpha还远没有被挖尽。