Ornstein-Uhlenbeck 配对交易:给价差一个可交易的回归速度
用固定随机种子(20260801)的受控模拟把配对交易价差建成 Ornstein-Uhlenbeck 过程。核心发现:OU 唯一关键参数 θ(回归速度)通过半衰期 ln2/θ 决定策略能不能做——θ=0.15 半衰期 4.6 天是印钞机、θ=0.02 半衰期 34.7 天是资金坟墓。但 θ 极难估准:AR(1) 在 N=60 短样本把真实 θ=0.05 估成 0.145(半衰期 13.9 天缩成 5.6 天,高估近 3 倍),N=1000 才收敛——短历史选出的『快速回归配对』大概率是估计偏差。入场阈值扫描:最优 z*≈0.75、Sharpe 约 2.0,阈值越高交易越少(z*=0.5 时 250 笔、z*=3.0 仅 2.2 笔)。三个鲁棒性结论最硬:θ 降到 0(退化成随机游走)Sharpe 从 2.04 崩到 0.04,不回归就没 alpha;全样本均值算 z 是隐蔽 look-ahead,纯随机游走价差上照样刷出 Sharpe 0.47 假利润,换滚动窗口掉到 0.02;置换 300 次真实 OU 的 2.19 超过全部上限 0.51。四项对抗式检验全过。
问题:两只股票的价差,凭什么会回来?#
配对交易的直觉人人都懂:找两只走势高度相关的股票(比如可乐和百事、两家银行),它们的价差偏离历史正常范围时,做多便宜的、做空贵的,赌价差会收敛回来。
但这个直觉里藏着一个致命的模糊:“价差会回来”到底是什么意思? 多久回来?回到哪里?如果不回来怎么办?
上一篇讲 Hurst 指数时我们说过:判断一段序列是均值回归还是随机游走, 是均值回归。但 只告诉你”有没有回归倾向”,不告诉你回归有多快——而”多快”恰恰是配对交易能不能赚钱的全部。一个半衰期 5 天的价差和一个半衰期 50 天的价差,都是 ,但前者是印钞机,后者是资金效率的坟墓。
要把”多快”量化,需要一个带回归速度参数的模型。Ornstein-Uhlenbeck(OU)过程就是配对交易价差最经典的连续时间模型:
三个参数各司其职: 是价差的长期均值(回到哪里), 是瞬时波动(噪声多大), 是均值回归速度(回得多快)。这个 就是整篇文章的主角。
本文用固定随机种子(20260801)把价差生成成 OU 过程,回答四个层层递进的问题:
- 到底如何通过”半衰期”决定策略的可交易性?
- 用真实数据估 ,能估准吗?
- 入场阈值应该设在几倍标准差?怎么权衡收益、频率、持仓期?
- 当价差不再回归、或用了偷看未来的标准化,会发生什么?
理论:θ 如何变成半衰期#
OU 过程的美妙之处在于它有解析解。从 出发,期望路径是:
价差偏离均值的部分以 指数衰减。定义半衰期为偏离衰减到一半所需的时间:
这是配对交易最该记住的公式。 越大,半衰期越短,价差回归越快。它同时决定了自相关的衰减——滞后 天的自相关正好是 ,半衰期就是自相关衰到 0.5 的时间。
OU 还有一个平稳分布:长期来看价差服从均值 、标准差 的正态分布。注意这个平稳标准差里也有 ——回归越慢( 小),价差能漂得越远(标准差越大)。
我用精确离散化来模拟(避免欧拉法的离散误差):
def simulate_ou(theta, mu, sigma, n, x0=None, rng=None):
    """精确离散:X_{t+1} = mu + (X_t-mu)e^{-θ} + η,
       η ~ N(0, σ²(1-e^{-2θ})/(2θ))"""
    x = np.zeros(n)
    x[0] = mu if x0 is None else x0
    a = np.exp(-theta)
    eta_sd = sigma * np.sqrt((1 - np.exp(-2*theta)) / (2*theta))
    for t in range(1, n):
        x[t] = mu + (x[t-1] - mu) * a + eta_sd * rng.standard_normal()
return x先看 如何塑造价差的形状:
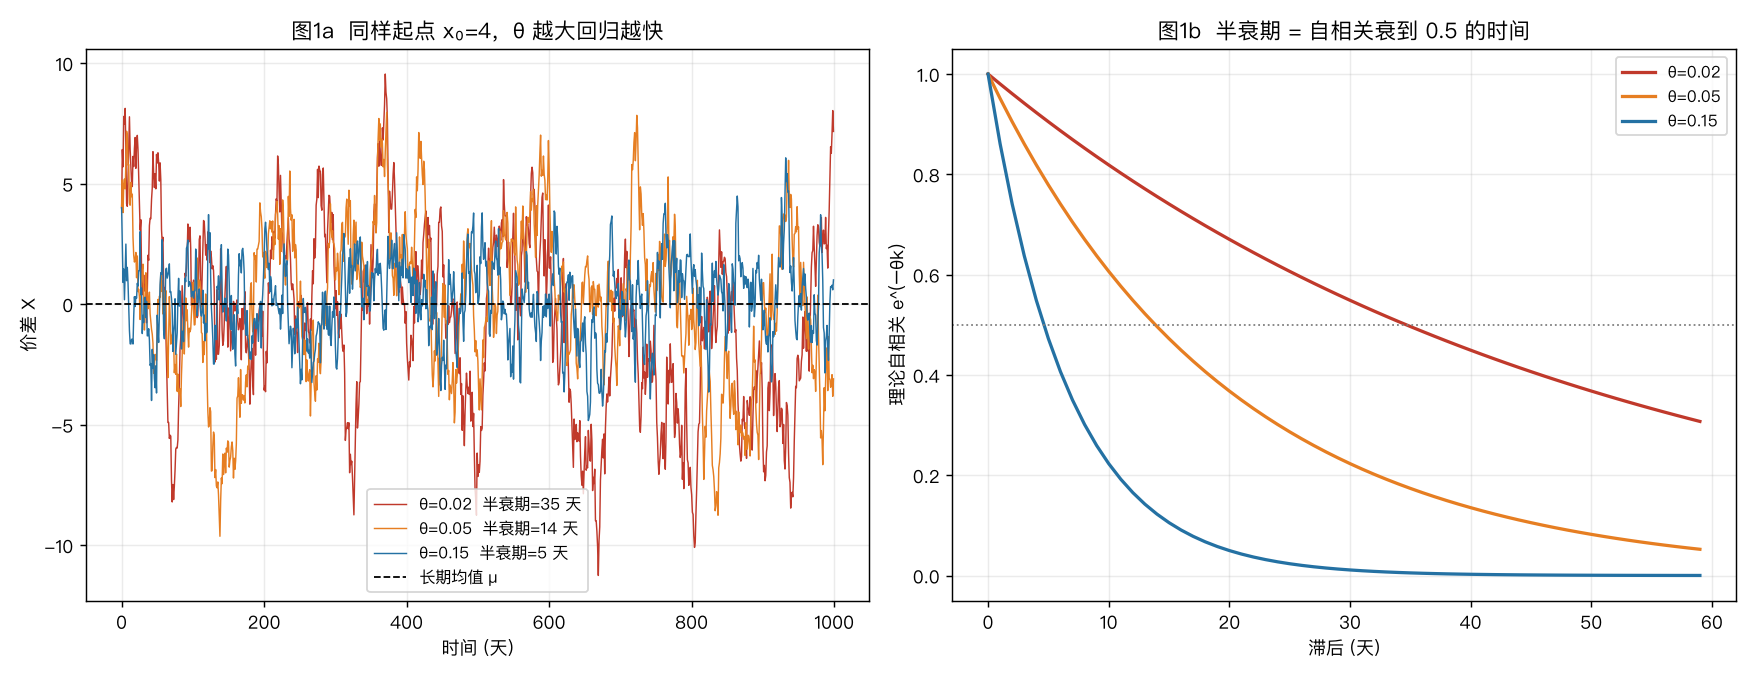
左图:三条价差从同样的起点 出发。(蓝,半衰期 4.6 天)几天就拉回中枢附近;(橙,半衰期 13.9 天)慢悠悠回归;(红,半衰期 34.7 天)晃了几百天还在大幅偏离。右图是理论自相关 :半衰期就是曲线穿过 0.5 那条虚线的横坐标。
对交易的含义直接而残酷:你做多一个偏离 4σ 的价差, 时一周就能兑现,资金一年能翻很多轮; 时你要占用资金一个多月等它回来,中途还可能先偏离到 6σ 让你怀疑人生。同样是”均值回归”,θ 决定了它是不是一门生意。
验证一:θ 估得准吗?短样本的系统性谎言#
这么重要,那用真实价差数据能估准吗?标准做法是把 OU 离散成 AR(1) 回归:
def estimate_theta_ar1(x):
    dx = np.diff(x); xl = x[:-1]
    A = np.vstack([np.ones_like(xl), xl]).T
    coef, *_ = np.linalg.lstsq(A, dx, rcond=None)
    a, b = coef
    theta_hat = -np.log(1 + b)   # b 应落在 (-1, 0)
return theta_hat, -a / b我用真实 (半衰期 13.9 天)生成价差,把样本长度从 60 扫到 2000,每个长度重复 400 次,看估计的偏差:
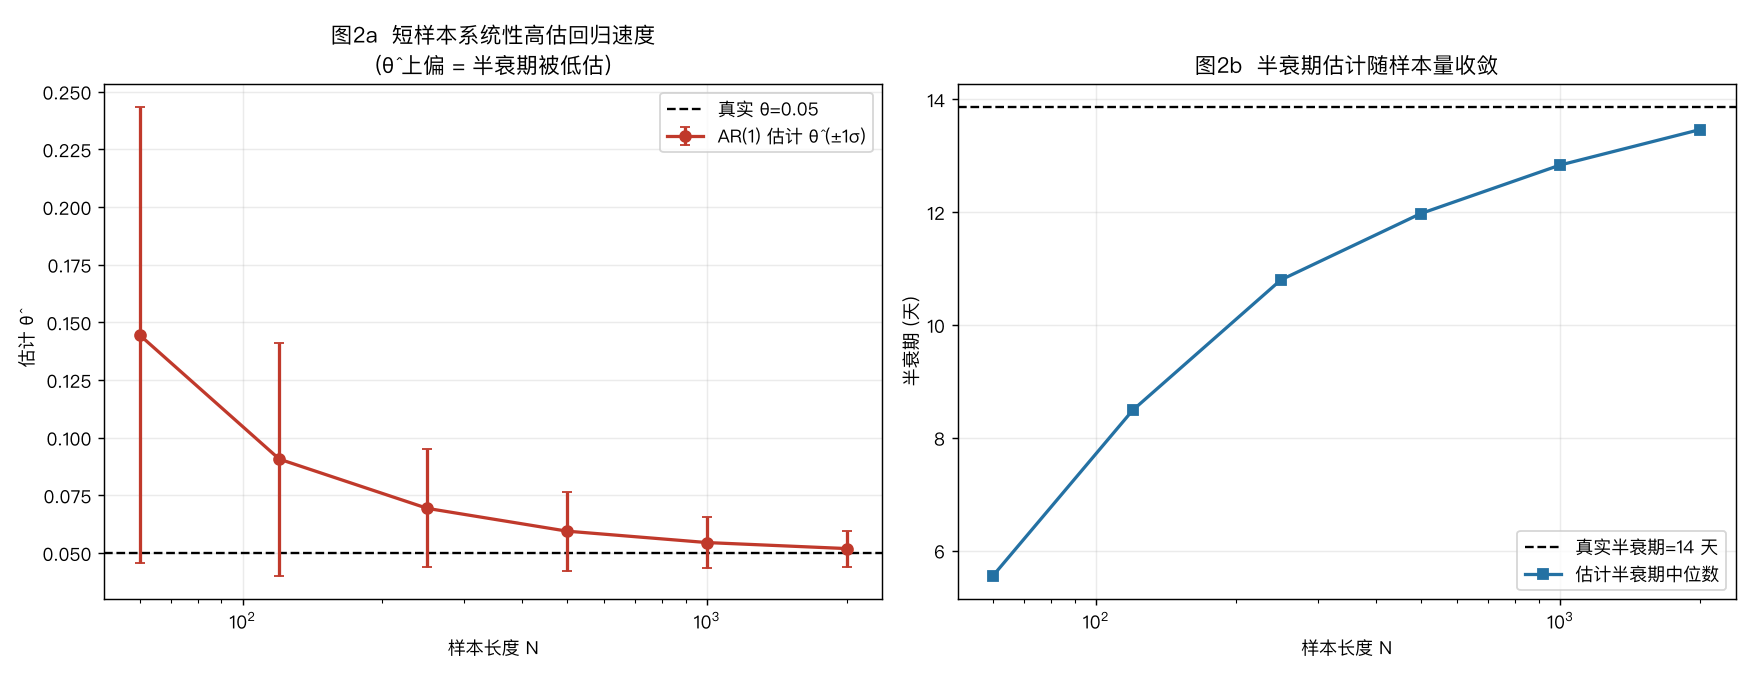
左图是这篇最该警惕的一张图:AR(1) 估计 在短样本上系统性高估回归速度。
- :,是真值 0.05 的近 3 倍
- :,仍高估 80%
- :
- :,才基本收敛
- :
翻译成半衰期(右图):真实 13.9 天, 时估成 5.6 天, 估成 10.8 天,要到 才收敛到 12.8 天。
这个偏差不是随机噪声,是方向恒定的系统性偏误——这是 AR(1) 系数在有限样本下的经典向下偏(Dickey-Fuller 类统计量的老问题), 被低估、 被高估。
对配对交易的杀伤力是致命的:你用两年的历史数据(约 500 天)估出”这对股票半衰期 8 天,回归很快,值得做”,真相可能是半衰期 14 天。 你按 8 天的预期设了止损和持仓上限,实盘却发现价差回归比你想的慢一倍——不是市场变了,是你的 从一开始就估高了。历史越短,你越会高估自己的策略。
验证二:入场阈值设在几倍标准差?#
假设 、 都估对了,下一个决策是:价差偏离多少才入场?把价差标准化成 , 超过某个阈值 就反向下注,回到均值附近()平仓。
设多高是个经典权衡:太低则频繁进出、每笔利润薄、被噪声反复打脸;太高则机会稀少、资金大量空置。我在 的价差上(40 条独立路径)把 从 0.5 扫到 3.0:
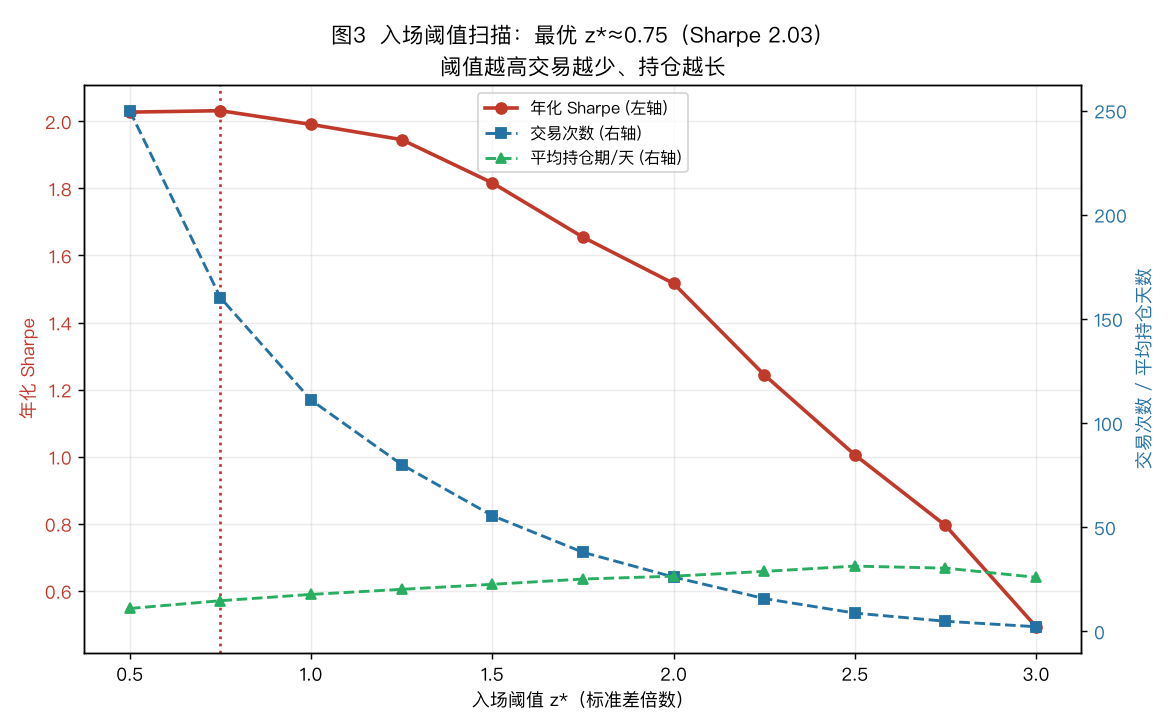
三条线讲了一个完整的权衡故事:
- Sharpe(红,左轴):在 见顶(约 2.03),然后随阈值升高单调下降。 时只剩 0.49。
- 交易次数(蓝,右轴):从 的 250 笔陡降到 的 2.2 笔。
- 平均持仓期(绿,右轴):从 11 天升到 30 天左右——阈值越高,你等的偏离越极端,回归到均值花的时间也越长。
反直觉的结论是最优阈值相当低(0.75σ 而非教科书常说的 2σ)。原因在于 OU 的强回归性:只要 够大,即使小偏离也有可靠的回归动力,低阈值捕捉的机会多、每笔虽薄但胜在频繁、且持仓期短、资金周转快。经典的”2σ 开、0σ 平”是把配对交易当稀有事件来做,在强回归的价差上反而牺牲了大量 Sharpe。
但要注意:这是零成本口径。一旦加上买卖价差和冲击成本,低阈值的高换手( 时 250 笔)会被交易成本严重侵蚀,最优阈值会向右移。真实的最优 是”回归速度 vs 交易成本”的交点—— 越大、成本越低,阈值越该往下压。
验证三:不回归会怎样?三个鲁棒性拷问#
前面都假设价差真的是 OU。但真实配对最大的风险是:协整关系破裂,价差不再回归(一家公司基本面永久变化、被并购、行业格局重构)。这时 OU 策略会发生什么?还有两个隐蔽的回测陷阱一并检验:
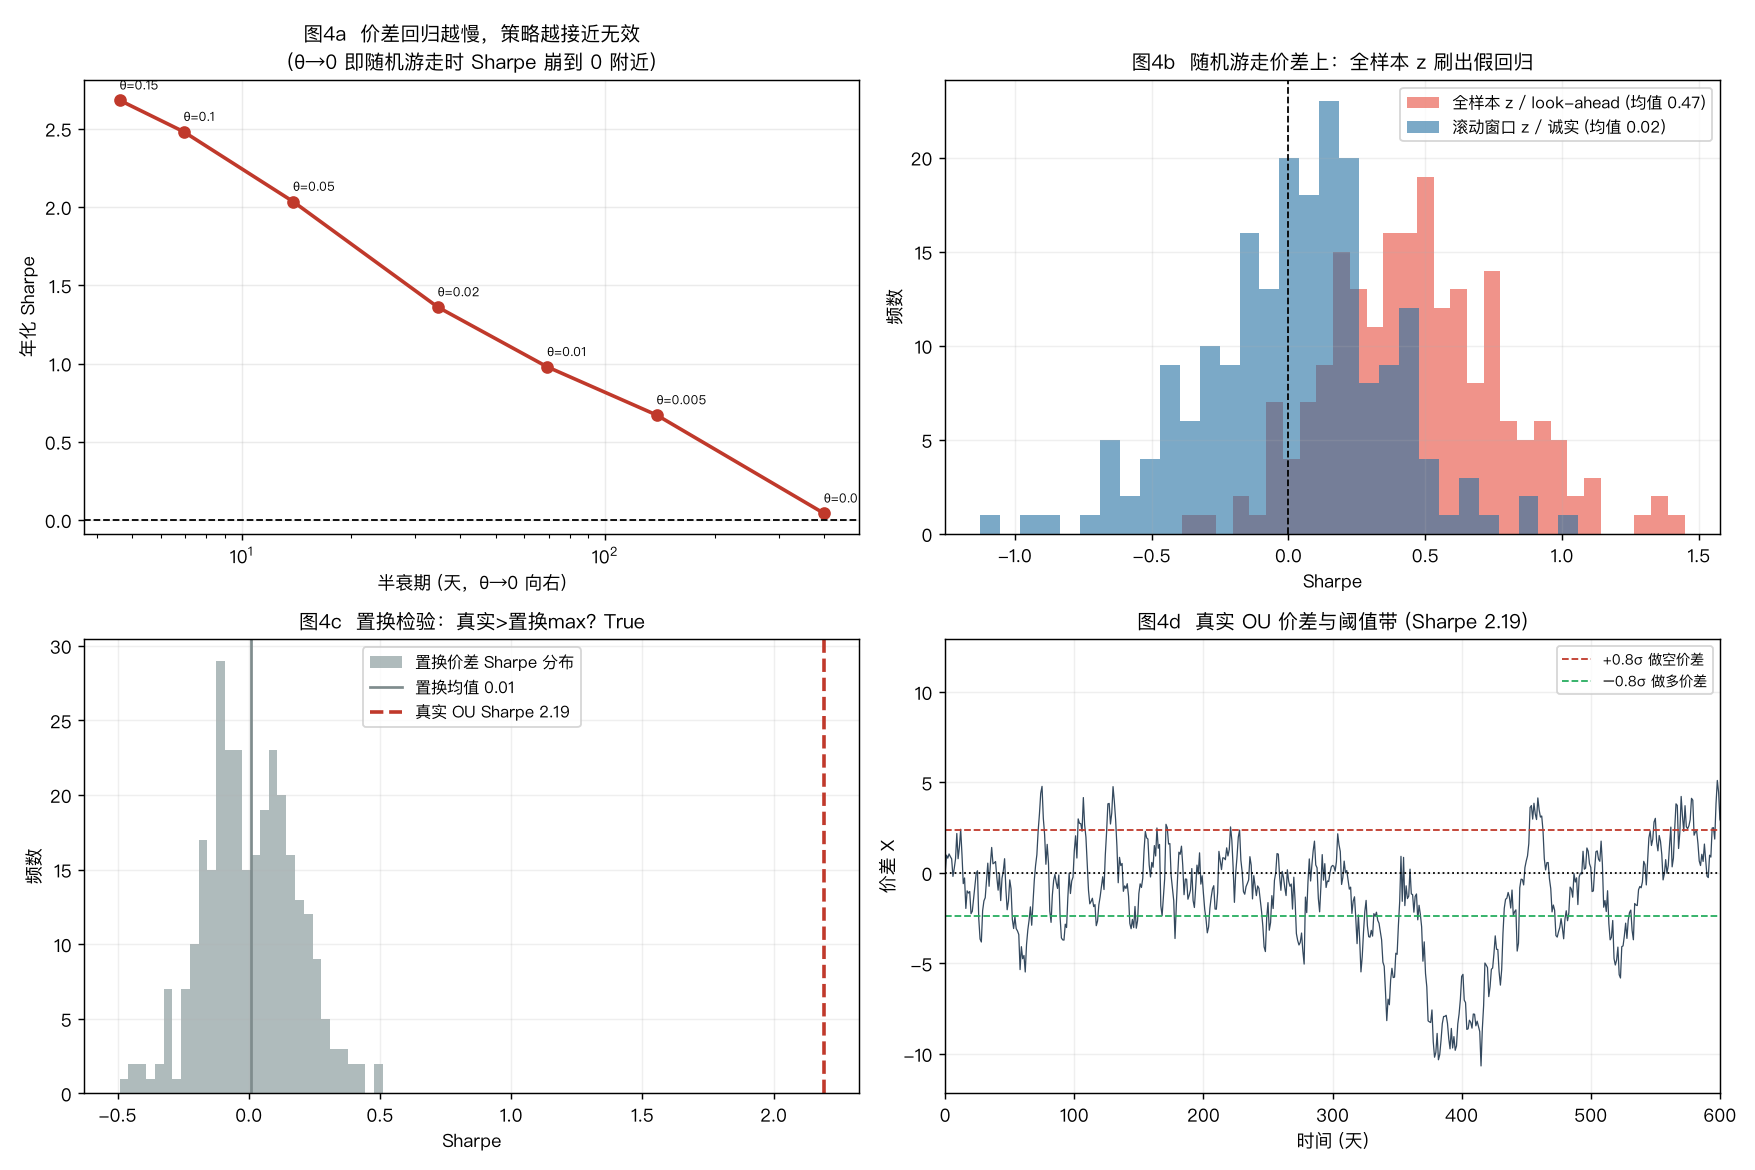
图4a:θ→0,Sharpe 崩塌。 我把 从 0.15 逐步降到 0(价差从强回归退化成纯随机游走),用同一套最优策略跑:
| θ | 半衰期(天) | Sharpe |
|---|---|---|
| 0.15 | 4.6 | 2.68 |
| 0.10 | 6.9 | 2.48 |
| 0.05 | 13.9 | 2.04 |
| 0.02 | 34.7 | 1.36 |
| 0.01 | 69 | 0.98 |
| 0.005 | 139 | 0.67 |
| 0.00 | ∞ | 0.04 |
结论无可辩驳:策略的全部 alpha 来自 θ。当价差退化成随机游走(),Sharpe 崩到 0.04——统计意义上等于零。配对交易不是在赚”价差大就会小”的钱,是在赚”价差有回归动力”的钱;一旦回归动力消失,策略立刻变成随机下注。这也是为什么实盘配对交易必须持续监控协整关系、并设”价差回归失败”的硬止损。
图4b:look-ahead 标准化陷阱。 一个极其隐蔽的 bug:算 分数时用全样本的均值和标准差。这看起来无害,实则是 look-ahead——你用了未来才知道的全局均值。在纯随机游走价差(,本该无 alpha)上:
- 全样本 z(look-ahead):Sharpe 均值 0.47——凭空刷出假回归利润!因为全局均值把随机游走”钉”在了它事后才知道的中心,价格看起来总在”回归”这个中心。
- 滚动窗口 z(诚实):Sharpe 均值 0.02——正确地回到零。
这个陷阱的可怕之处在于它不报错、不违反任何常识检查,还恰好让回测变好看。任何在纯随机游走上能刷出正 Sharpe 的回测,一定藏着 look-ahead。 检验方法就是这个:把策略搬到一个你确定没有 alpha 的世界(随机游走价差),如果它还赚钱,回去找 bug。
图4c:置换检验。 把真实 OU 价差的顺序打乱 300 次(破坏时序自相关,但保留边际分布),真实 OU 的 Sharpe 2.19 超过了全部 300 次置换的最大值 0.51(置换均值锚在 0.007)。这证明策略赚的是价差的时间结构(回归动力),而非分布形状的偶然。图4d 展示一条真实 OU 价差与 ±0.75σ 阈值带——价差反复穿越阈值又被拉回,正是策略的盈利来源。
三段式总结#
A. 实现细节#
- 价差模型:Ornstein-Uhlenbeck 过程 ,精确离散化采样(非欧拉近似),固定种子
20260801。本文直接对价差建模,隐含假设两腿的对冲比率已由协整回归确定、价差已是平稳序列。 - θ 估计:AR(1) 回归 ,,。有限样本偏差用 400 次重复、6 个样本长度量化。
- 交易规则:价差标准化 (), 做空价差、 做多价差、 平仓。信号在 观察、 结算(无 look-ahead),阈值扫描用 40 条独立路径取均值。
- 对抗式检验:(1) θ 从 0.15 降到 0 看 Sharpe 崩塌;(2) 纯随机游走价差上比较全样本 z(look-ahead)与滚动窗口 z(诚实);(3) 300 次价差顺序置换检验;(4) 真实 OU vs 置换分布上限。
B. 已知偏差#
- 单价差建模,跳过了协整这一步:本文假设价差已经是干净的平稳序列,但真实配对交易最难的恰恰是找到并维持协整关系、确定对冲比率。协整可能是伪回归的产物,对冲比率本身会漂移——这些误差都不在本文模拟里。真实策略的第一大风险源被我用”假设价差是 OU”绕过了。
- θ 假设恒定:真实价差的回归速度会随市场环境变化(流动性枯竭时回归变慢),本文的 是常数。用固定 估出的半衰期只是长期平均,不代表任意时点的回归速度。
- 零成本口径:入场阈值扫描没建模买卖价差、冲击成本、融券费。加上成本后,低阈值(0.75σ)的高换手优势会被大幅侵蚀,真实最优阈值更靠右,Sharpe 也会显著下降。
- 对称双腿假设:模拟隐含两腿可自由做多做空。A 股配对的空头腿受融券约束(券源、费率、强平),可实施版本的收益会明显低于理论值——这一点在真实统计套利里往往是成败关键。
C. 结果解读#
-
θ 是唯一决定生死的参数:半衰期 直接翻译成资金周转速度。(半衰期 4.6 天)是印钞机,(34.7 天)资金效率极低。选配对的第一标准不是相关性高,而是价差回归够快。
-
短样本会系统性骗你说”回归很快”:AR(1) 在 上把真实 估成 0.145(半衰期 13.9 天→5.6 天,高估近 3 倍), 才收敛。用短历史选出的”快速回归配对”,大概率是估计偏差制造的幻觉。 判断一对能不能做,需要足够长的历史,且要对短样本 打折。
-
最优入场阈值比教科书低:强回归价差上 (Sharpe 2.03)优于经典的 2σ。低阈值多机会、短持仓、高周转。但这是零成本结论——加成本后阈值右移,真实最优是”回归速度 vs 交易成本”的交点。
-
不回归 = 没有 alpha: 时 Sharpe 从 2.04 崩到 0.04。配对交易赚的是回归动力的钱,协整关系一旦破裂,策略立刻变成随机下注。实盘必须持续监控协整、设”回归失败”硬止损——这是配对交易爆仓的头号原因(价差单边发散、越亏越加)。
-
两个必查的回测陷阱:其一,全样本均值/标准差算 z 是隐蔽 look-ahead,在纯随机游走上都能刷出 Sharpe 0.47 的假利润,务必用滚动窗口。其二,任何在”确定无 alpha 的世界”(随机游走价差)上还赚钱的回测,一定藏着未来信息——这个”随机世界对照”比任何统计检验都更能抓住偷看未来的 bug。真实 OU 策略 Sharpe 2.19 超过置换上限 0.51,才算通过了”赚的是时间结构而非运气”的最终质检。