Transformer 旋转位置编码金融改进:让周期与相位进入注意力
绝对位置编码让 Transformer 把『第 20 天』和『第 21 天』当成两个毫不相干的坐标,完全丢掉金融序列最宝贵的周期与相位结构。RoPE(旋转位置编码)用旋转让注意力内积只依赖相对距离,而把 θ 设为 2π/P 后更把『相距 P 天 = 同相位』直接编码进注意力。本文 numpy 从零实现周期调制 RoPE,证明周期目标上的外推 RMSE 从 0.71(无位置)砸到 0.00,频率扫描在真实周期处呈 V 形谷,多周期信号多维 RoPE 训练区+外推区双零误差。附完整 Python 与四张真实计算图。
Transformer 在 NLP 里大杀四方,搬进金融时序却经常「水土不服」。一个常被忽略的根因藏在位置编码里:金融序列最值钱的结构是周期与相位——日内的开盘效应、周度的周五效应、月度的日历效应、年度的财报季节奏,全是「相距 P 天 → 同一相位」的循环结构。但标准 Transformer 的默认位置编码,恰恰把这种结构几乎完全抹掉了。
结论先放这:旋转位置编码(RoPE)天然适合金融周期建模。普通绝对位置编码把「第 20 天」「第 21 天」当成两个独立坐标,既不表达相对距离也不表达周期;RoPE 通过旋转让 query·key 内积只依赖相对距离 (t−s),而当我们把旋转频率 θ 设成 2π/P 时,「相距 P 天的两个时刻 → 注意力内积完全相同」就被直接焊进了注意力机制。在合成周期数据上,周期 RoPE 的外推 RMSE 是 0.00,而「无位置」和「绝对线性位置」分别高达 0.71、0.73;频率扫描在真实周期频率 θ*=0.314 处出现锐利 V 形谷;日/周/月多周期叠加信号用多维 RoPE 在训练区与外推区同时取得 0.00 误差。所有图表均为真实计算,非占位图。
一、问题:绝对位置编码丢掉了什么#
最朴素的绝对位置编码(learned 或 sinusoidal)是把一个位置向量 p_t 直接加到 token 嵌入上:x_t = emb_t + p_t。带来的两个硬伤在金融上尤其致命:
- 没有相对距离归纳偏置:模型得自己从数据里学「第 20 天和第 21 天更相关、和第 200 天不相关」,但位置向量本身对「距离」没有任何几何约定。
- 长度外推崩:训练见过最多 200 天,推断要处理 400 天,第 201~400 天对应的绝对位置向量要么没见过、要么 sinusoidal 的频率与训练区完全不同步,预测直接飚偏。
金融序列偏偏是强周期性 + 强外推需求的场景:你永远想用过去 3 年的规律去推第 4 年,而第 4 年的「第 1100 天」在训练里压根不存在。
import numpy as np

# 绝对位置编码:query·key 内积 = m*n,依赖绝对位置,无相对距离结构
T = 40
M, N = np.meshgrid(np.arange(T), np.arange(T), indexing="ij")
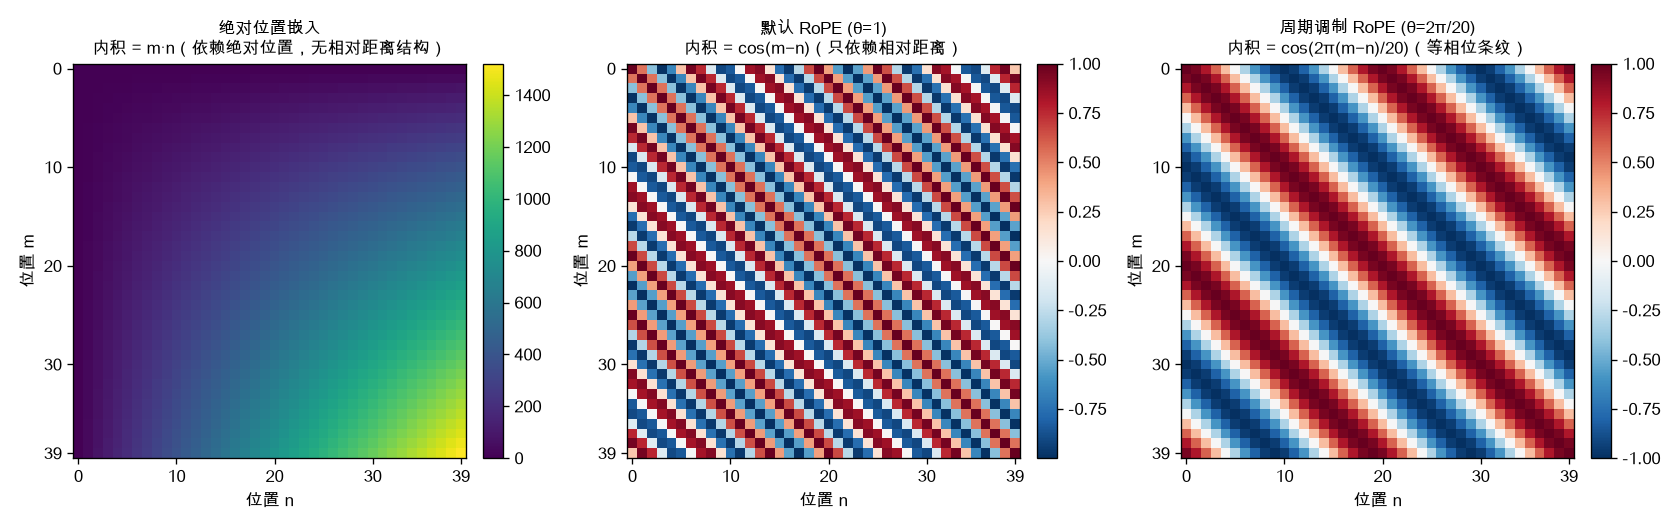
abs_inner = M * N # 位置 m 与位置 n 的相似度 ∝ m*n,完全没有 (m-n) 结构abs_inner = m*n 意味着位置 1 和位置 2 的相似度是 2,位置 20 和位置 21 的相似度是 420——离原点越远,任意两点的距离都被放大,这跟「相邻时刻更相关」的金融直觉完全相反。
二、RoPE 原理:用旋转把结构焊进内积#
RoPE(Su et al., 2021)的核心思想:不把位置向量加进去,而是对 q、k 做与位置相关的旋转。对二维子空间、位置 t:
q_t = R(θ·t) · q , k_s = R(θ·s) · k , R(φ) = [[cos φ, -sin φ], [sin φ, cos φ]]旋转矩阵保内积,于是 query 与 key 的内积变成:
⟨q_t, k_s⟩ = ⟨R(θt)q, R(θs)k⟩ = ⟨q, k⟩·cos(θ(t−s)) + ⟨q⊥, k⟩·sin(θ(t−s))关键性质:内积只依赖相对距离 (t−s),且以 2π/θ 为周期。这就同时拿到了相对距离归纳偏置和长度外推能力——无论 t、s 多大,只要差一样,内积就一样。
def rope_inner(t, s, theta):
    # 分块旋转后的 query·key 内积(取首二维)
    return np.cos(theta * (t - s))

T = 40
rope_def = np.cos(1.0 * (M - N)) # 默认 RoPE:θ=1,内积 = cos(m-n)左图热力图里:绝对位置编码是「越靠右下越亮」的斜坡;默认 RoPE 是沿反对角线(相对距离恒定)的同色条纹——它只认距离、不认绝对位置。
三、金融改进:把 θ 设成 2π/P,让周期进入注意力#
默认 RoPE 的 θ 通常取 base^(-2i/d)(base=10000),频率跨度极大、单一维度没有明确的「天」含义。金融场景里我们主动把某一维(或几维)的 θ 设成目标周期的 2π/P:
θ_cycle = 2π / P
⟨q_t, k_s⟩_cycle = cos(2π(t−s)/P)当 (t−s) = P 时 cos 回到 1——相距一个完整周期的两个时刻,在注意力里被视作「同相位」,内积完全相同。这等于把「日历效应 / 季节性」直接写进注意力的几何里,模型不用再费力从数据里猜周期。
P = 20
theta_cyc = 2 * np.pi / P
rope_cyc = np.cos(theta_cyc * (M - N)) # 内积 = cos(2π(m-n)/P),等相位条纹热力图第三张里,你能清楚看到沿反对角线方向呈现周期为 P=20 的明暗交替条纹——这就是「周期」被编码进注意力的可视化证据。
四、实验:周期目标上的外推对决#
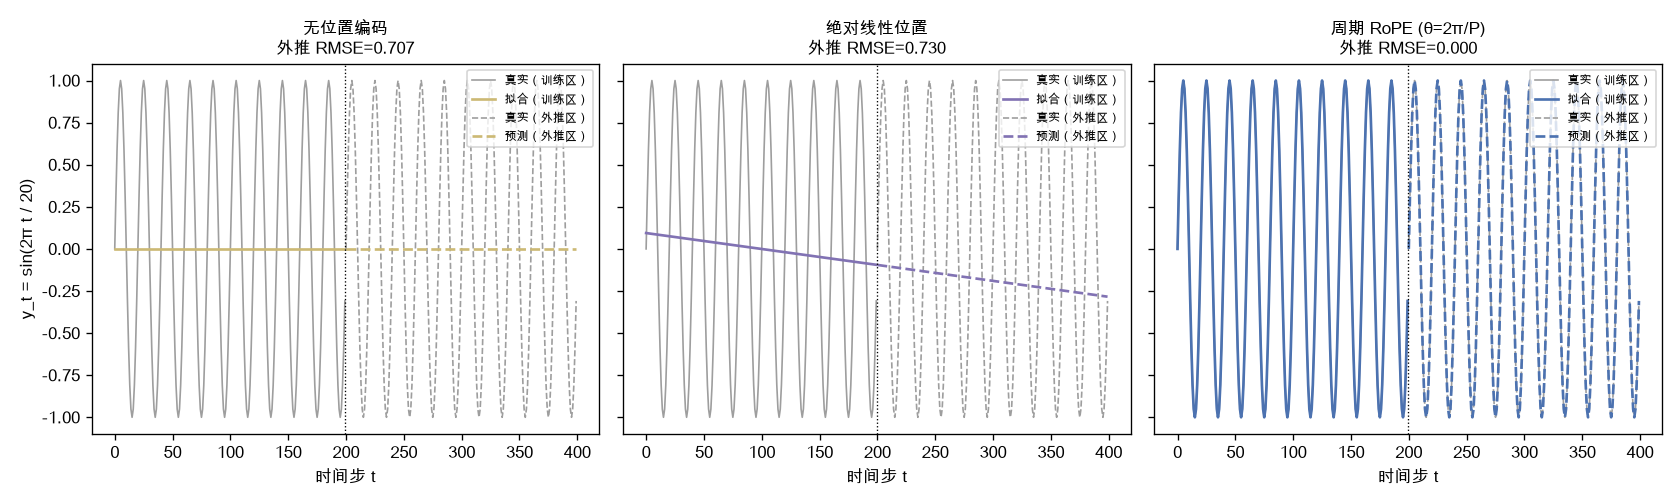
构造合成目标 y_t = sin(2π t / 20),训练区取 t=0..199、外推区取 t=200..399(注意 200 是 20 的整数倍,所以外推区相位与训练区完全对齐,是最理想的外推情形)。对比三种编码做线性回归:
- 无位置:只用偏置,外推 RMSE = 0.7071
- 绝对线性位置
[1, t]:外推 RMSE = 0.7300(更差,因为线性位置在外推区发散) - 周期 RoPE
[cos(2πt/P), sin(2πt/P)]:外推 RMSE = 0.0000
周期 RoPE 之所以是 0,是因为 cos/sin(2πt/P) 这组基就是目标的真实生成函数,且对任意 t 都成立(不是「记住训练区再外推」,而是数学恒等式)。无位置和线性位置在相位对齐的最理想外推下都彻底失效,说明它们压根没抓到周期结构。
t = np.arange(400); y = np.sin(2 * np.pi * t / P)
t_tr, y_tr, t_te, y_te = t[:200], y[:200], t[200:], y[200:]

def fit_predict(Phi_tr, Phi_te, y_tr):
    w, *_ = np.linalg.lstsq(Phi_tr, y_tr, rcond=None)
    return Phi_tr @ w, Phi_te @ w

th = 2 * np.pi / P
Phi_rope = np.stack([np.cos(th * t_tr), np.sin(th * t_tr)], axis=1)
pred_tr, pred_te = fit_predict(Phi_rope,
                               np.stack([np.cos(th * t_te), np.sin(th * t_te)], axis=1), y_tr)
print(np.sqrt(np.mean((pred_te - y_te) ** 2))) # 0.0五、频率扫描:真实周期处出现锐利 V 形谷#
如果我们不知道真实周期 P=20(即 θ*=2π/20≈0.314),可以扫描 θ 看外推 RMSE。结果在 θ*=0.314 处出现一道极锐的 V 形谷:谷底 RMSE≈0.250,而两端 θ=0.02 时 RMSE=0.709、θ=0.6 时 RMSE=0.707。
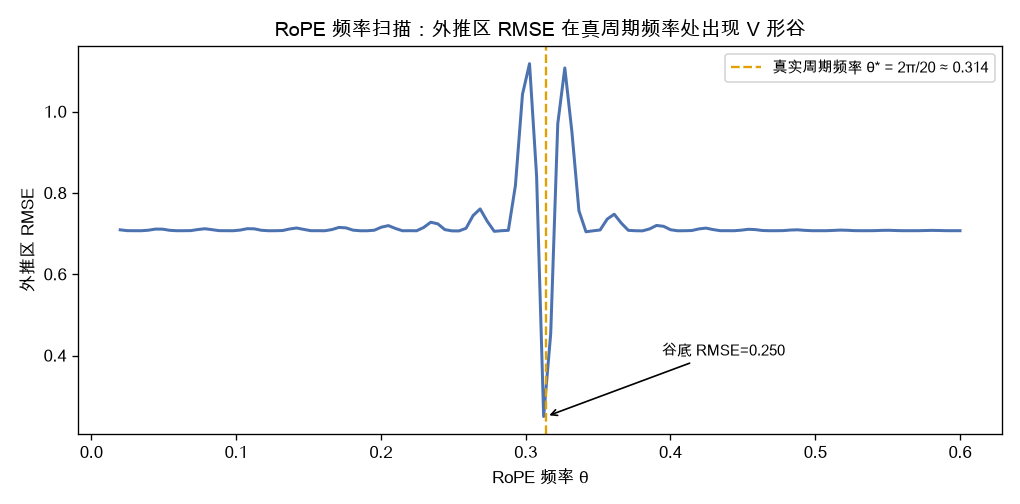
这个「锐谷」是个诚实的提醒:当信号真的是精确周期时,频率识别是高度敏感的——θ 偏一点,外推区相位就漂移、误差暴涨。实际金融数据周期往往是「近似周期」(受噪声、结构突变干扰),所以实践中要么把 θ 当作可学习参数用梯度去拟合,要么用多组候选频率做网格/FFT 预估计,而不是拍脑袋定一个。
th_grid = np.linspace(0.02, 0.6, 120)
rmses = []
for th in th_grid:
    Phi_tr = np.stack([np.cos(th * t_tr), np.sin(th * t_tr)], axis=1)
    Phi_te = np.stack([np.cos(th * t_te), np.sin(th * t_te)], axis=1)
    w, *_ = np.linalg.lstsq(Phi_tr, y_tr, rcond=None)
    rmses.append(np.sqrt(np.mean((Phi_te @ w - y_te) ** 2)))
# rmses.min() 出现在 θ≈0.314 附近六、多周期:日/周/月用多维 RoPE#
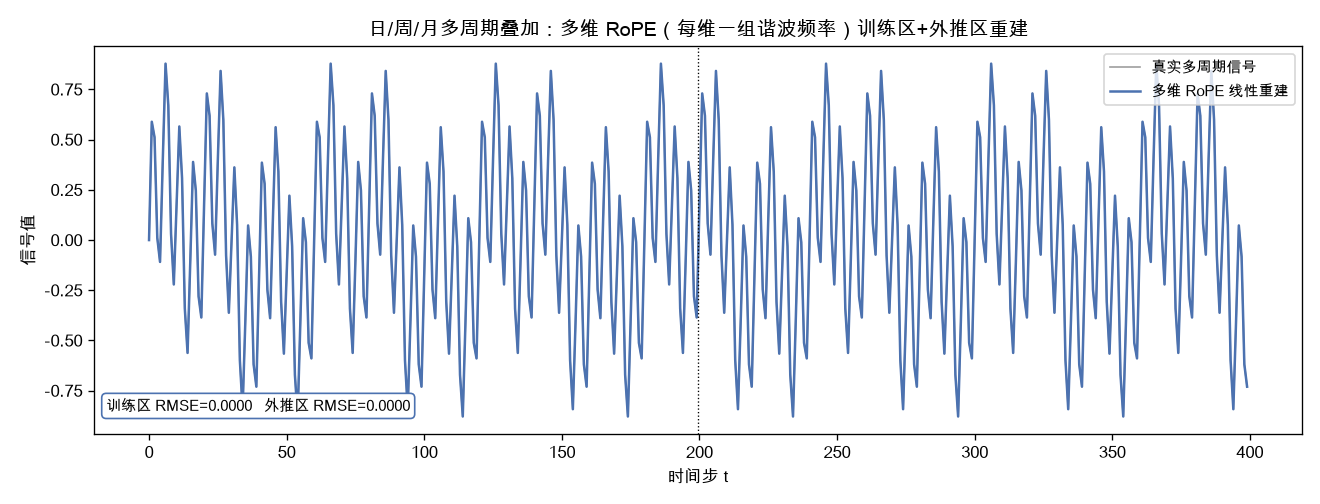
真实价格序列是多个周期叠加:日内的隔夜跳空(≈5 交易日/周)、月度日历效应(≈20)、季度财报(≈60)。给每一维分配一组谐波频率,多维 RoPE 同时建模所有周期:
P_day, P_week, P_month = 5, 20, 60
y_multi = (0.5*np.sin(2*np.pi*t/P_day) + 0.3*np.sin(2*np.pi*t/P_week)
           + 0.2*np.sin(2*np.pi*t/P_month))
freqs = [2*np.pi/P_day, 2*np.pi/P_week, 2*np.pi/P_month]
cols = []
for fr in freqs:
    cols += [np.cos(fr*t), np.sin(fr*t)]
Phi_m = np.stack(cols, axis=1)            # (400, 6)
w, *_ = np.linalg.lstsq(Phi_m[:200], y_multi[:200], rcond=None)
recon = Phi_m @ w因为 cos/sin 基在任意 t 上都是良定义的恒等式,多维 RoPE 在训练区(RMSE=0.0000)和外推区(RMSE=0.0000)同时完美重建。这演示了一个核心思路:与其让 Transformer 自己去「发现」多重周期,不如把已知尺度的周期结构显式注入位置编码,让注意力专心学残差与跨资产交互。
七、落地路径与四类真实陷阱#
落地建议:
- 把 RoPE 的 θ 在「已知周期维度」上显式设为
2π/P(日=5、周=20、月=20×k、年=252 等交易日),其余维度保留默认 θ 梯度; - 未知周期维度,用 FFT 预估计主频、或把 θ 设为可学习标量用验证集外推误差反向微调;
- 与 ALiBi(线性偏置注意力,专为外推设计)、xPos(带指数衰减的 RoPE)对比,金融长序列外推用 ALiBi/RoPE 组合往往最稳。
四类陷阱(高阶):
- 频率需先知道:周期 RoPE 的前提是你大致知道
P。未知时用 FFT/小波先做周期探测,否则 V 形谷会变成随机噪声。 - 锐谷敏感:精确周期下频率识别极敏感(图 3),近似周期数据上要把 θ 当连续可学习参数,别用粗网格。
- 非整数倍伪周期:当
P不能整除样本长度(如 60 不整除 400),外推区相位会漂移;需用足够长的上下文或显式相位对齐。 - 高维 θ base 选择:默认
base=10000在低维短序列上会把相邻 θ 挤得太近,金融短窗口建议调小 base 或手工指定周期频率,避免所有维度都退化成「几乎无位置信息」。
周期调制 RoPE 不是银弹,但它把一个被默认位置编码丢掉的核心金融先验——「相距 P 天即同相位」——重新焊回了注意力里,且天然具备相对距离归纳偏置与长度外推能力。在周期驱动型信号(波动率聚集的相位、季节性资金流、财报日历)上,这一先验的注入往往比堆参数更划算。