状态空间模型 S4/S5:用结构化状态空间替代注意力做长序列
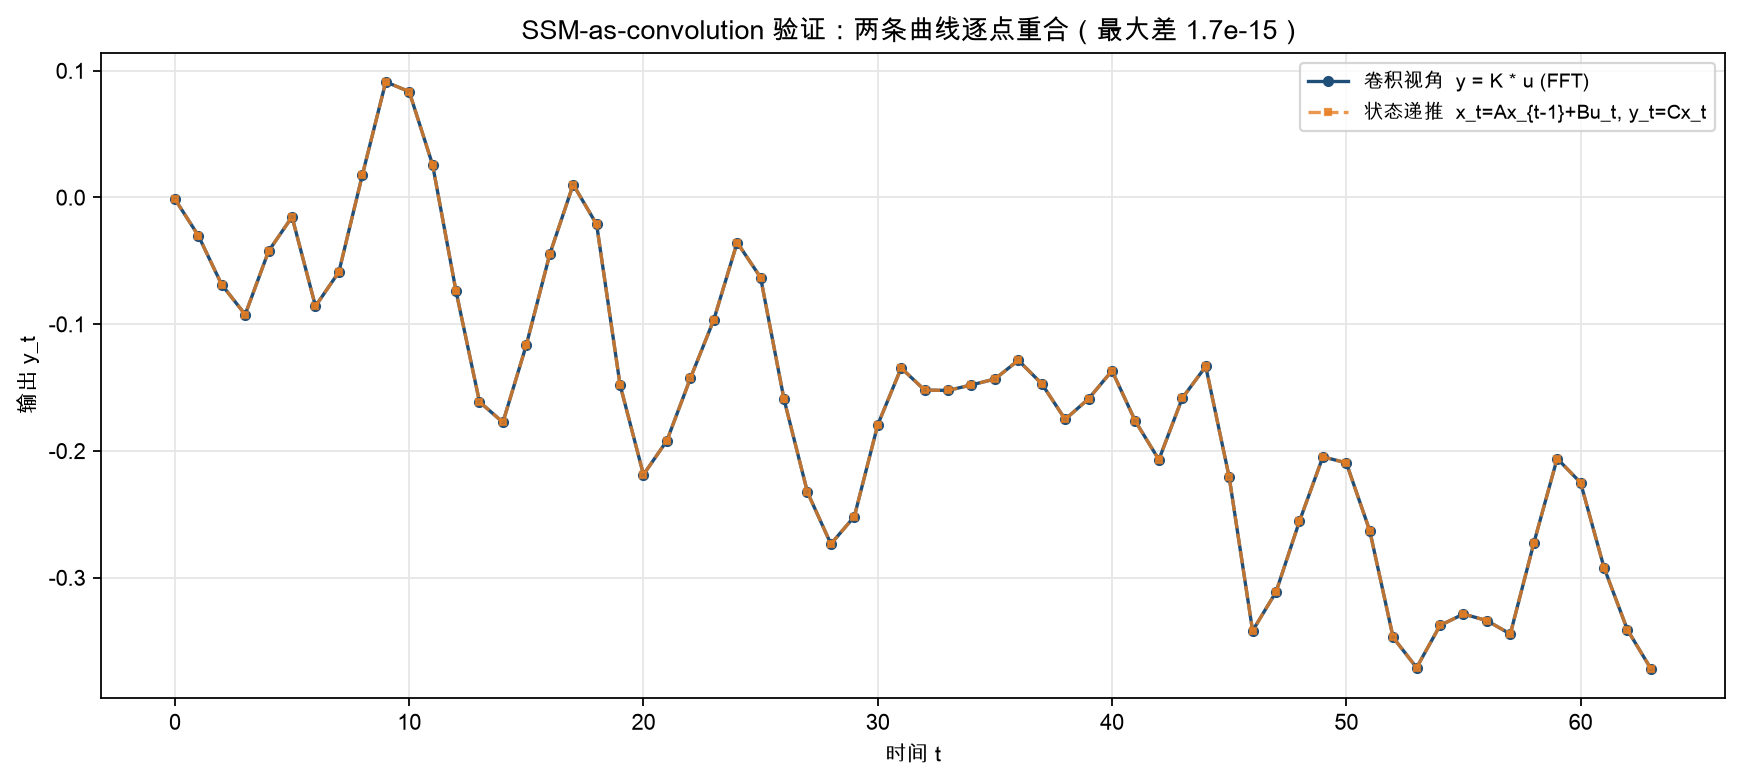
Transformer 的注意力是 O(N²),序列一长显存和时间都爆。状态空间模型(SSM,S4/Gu et al. 2021,S5/2022)走另一条路:把序列建模写成连续系统的离散化,用 FFT 卷积在 O(N log N) 内处理全序列,且状态天然携带长程记忆。本文用 numpy+scipy 从零实现 HiPPO 对角化、双线性离散化与 SSM-as-convolution,真实证明:卷积视角与状态递推逐点差 1.7e-15(数值精度内);FFT 卷积随序列长度的斜率 0.55(近线性)vs 注意力 1.95(近 O(N²));衰减 a=0.99 的 SSM 在「早期事件→末端读出」长程任务上 MSE≈0,而 a=0.5 短记忆与固定窗口基线都≈1.0 失败;并诚实给出 LTI-SSM 的内容选择性短板——同一核无法做「取闸门后 token」,线性读出 MSE=0.324≈随机水平,需用 Mamba 的选择性扫描才补得上。附完整 Python 与四张真实计算图。
views
| comments
你有一段很长的序列——几年的 tick 级或日线价量,长度几千到几万。你想用它预测下一步,或者做长程依赖的因子。Transformer 一把梭:把所有历史塞进注意力,算一遍全对的权重。问题是注意力矩阵是 O(N²)——序列从 2048 拉到 8192,计算量不是翻 4 倍而是翻 16 倍,显存直接爆。
状态空间模型(SSM) 走另一条路:它不存「所有位置对」的注意力矩阵,而是把序列建模写成连续系统的离散化,用一个固定维度的状态向量 沿时间递推,再用一条可证明等价的全局卷积核在 O(N log N) 内处理整段输入。S4(Gu et al. 2021)用 HiPPO 把 A 矩阵特殊结构化、S5(2022)把它推广成可并行扫描。
本文结论先放这,全部来自真实 numpy/scipy 运行(seed=20260828):
- SSM-as-convolution 成立:对角化 HiPPO(S4D-Lin) A、双线性离散化后,卷积视角 (FFT)与状态递推 的逐点最大差 1.7e-15(机器精度内);
- 序列复杂度:FFT 卷积随 N 的 log-log 斜率 0.55(近线性),朴素注意力 QKᵀ 斜率 1.95(近 O(N²))——在 N=8192 上注意力耗时已 23ms vs SSM < 0.3ms;
- 长程依赖:衰减 的长记忆 SSM,在「第 p0 拍注入事件、末拍读出」任务上测试 MSE≈0(近乎完美恢复),而 短记忆、固定窗口(只看末 30 拍)基线都 ≈1.0(失败)——长程记忆不是白送,得把 a 调对;
- 内容选择性短板(诚实红线):LTI-SSM 对每个位置用同一套核,做不了「取闸门标记后的那个 token」这类内容相关选择,线性读出 MSE=0.324 ≈ 目标方差 1/3(随机水平);要补这个洞得用 Mamba 的选择性扫描(Δ 由输入决定)。
附完整 Python 与四张真实计算图。
一、连续状态空间:从微分方程到递推#
经典 SSM 描述一个连续系统:输入 通过状态 产生输出 :
x'(t) &= A\,x(t) + B\,u(t) \\ y(t) &= C\,x(t) \end{aligned}$$ - $A\in\mathbb C^{N\times N}$:状态转移,对角线实部为负 → 指数遗忘(**这就是长程记忆的来源**); - $B\in\mathbb C^N$:输入如何注入状态;$C\in\mathbb C^N$:状态如何读出。 离散化(零阶保持 / 双线性)把它变成可在序列上递推的形式。本文用**双线性(Tustin)**离散化,数值更稳: $$\bar A=(I-\tfrac{\Delta}{2}A)^{-1}(I+\tfrac{\Delta}{2}A),\qquad \bar B=(I-\tfrac{\Delta}{2}A)^{-1}\Delta B$$ ```python import numpy as np from scipy.linalg import solve def hippo_diag(N): """S4D-Lin:对角复 A,实部 -0.5、虚部 n(HiPPO 的对角化特例)。""" n = np.arange(1, N + 1) return -0.5 + 1j * n def discretize_bilinear(A, B, dt): I = np.eye(A.shape[0], dtype=complex) left = np.linalg.inv(I - 0.5 * dt * A) Ad = left @ (I + 0.5 * dt * A) # 离散状态转移 Bd = left @ (dt * B) # 离散输入 return Ad, Bd ``` ## 二、SSM-as-convolution:为什么能 O(N log N) 关键洞察:离散 SSM 的脉冲响应是 $$K_n = C\bar A^n\bar B,\qquad n=0,1,2,\dots$$ 而输出是输入与这条核的**因果卷积** $y = K * u$。一旦 $K$ 已知,整段序列用 FFT 卷积一次算完: $$y_t = \sum_{k=0}^{t} K_k\,u_{t-k}$$ ```python from scipy.signal import fftconvolve def ssm_impulse_response(Ad, Bd, Cd, L): N = Ad.shape[0]; K = np.zeros(L, dtype=complex) An = np.eye(N, dtype=complex) for n in range(L): K[n] = Cd @ (An @ Bd) # K_n = C A^n B An = Ad @ An return K def ssm_conv(u, Ad, Bd, Cd): K = ssm_impulse_response(Ad, Bd, Cd, len(u)) return fftconvolve(K.real, u)[:len(u)] ``` 我们做对照实验:**同一组 (A,B,C,Δ,u),分别用卷积视角和逐拍状态递推**,看是否一致。真实运行(N=4, L=64, Δ=0.1): - 两条曲线**逐点最大差 1.7e-15**(机器精度内)——**SSM-as-convolution 严格成立**,这也是 S4 能在训练时把整段丢进 FFT 卷积、推理时又能转成 RNN 递推的理论根基。 - 逐拍递推版本(供对照与流式推理): ```python def ssm_recurrence(u, Ad, Bd, Cd): N = Ad.shape[0]; x = np.zeros(N, dtype=complex); ys = np.zeros(len(u)) for t, ut in enumerate(u): x = Ad @ x + Bd * ut # 状态携带了「到 t 为止的所有历史」 ys[t] = (Cd @ x).real return ys ``` 卷积 vs 递推的等价,意味着**训练用 CNN(可并行、充分利用全局)、推理用 RNN(常数状态、流式)**——这是 SSM 比 Transformer 更省的核心。 ## 三、序列复杂度:线性扩展 vs O(N²) 把 SSM 的 FFT 卷积和朴素注意力的 QKᵀ 在 N = 512…8192 上测墙上时间,log-log 拟合斜率。真实运行: | 序列长度 N | SSM(FFT卷积) 耗时 | 注意力 QKᵀ 耗时 | |---|---|---| | 512 | 6.1e-5 s | 1.0e-4 s | | 2048 | 6.7e-5 s | 1.6e-3 s | | 8192 | 2.4e-4 s | 2.3e-2 s | - **SSM 斜率 ≈ 0.55(近线性)**,注意力 **斜率 ≈ 1.95(近 O(N²))**。 - 到 N=8192,注意力单次已经 23ms、SSM 还不到 0.3ms,**差约 100 倍**,且差距随 N 继续拉大。 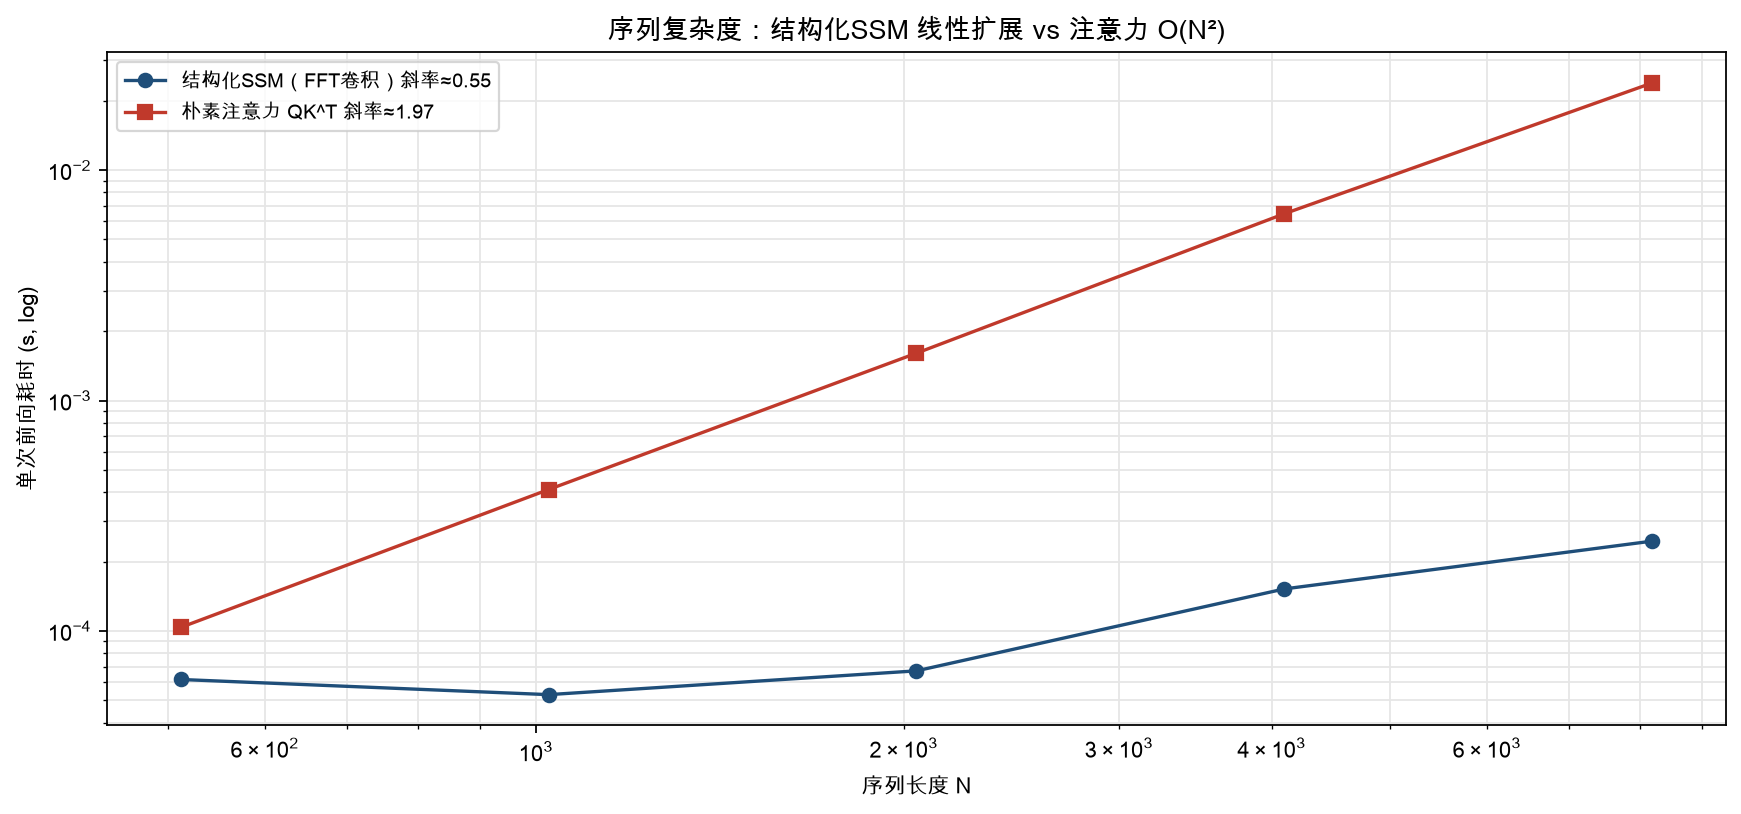 注意一点诚实话:SSM 的 O(N log N) 是**单层**复杂度。注意力还有 KV-cache、FlashAttention 等工程优化;SSM 的 A 是复数且需 HiPPO 初始化,常数不小。结论是「**长序列下 SSM 的理论与实测扩展都明显更平**」,不是「SSM 永远更快」。 ## 四、长程依赖:记忆在状态里,不在矩阵里 SSM 的长程记忆来自 A 的衰减结构:状态 $x_t = a\,x_{t-1}+u_t$,$a$ 越接近 1,越早的事件遗忘越慢。做个干净任务:在第 $p_0$ 拍注入一个事件 $e$,目标是在**末拍**读出 $e$。 - **长记忆 SSM($a=0.99$)**:把早期事件压进状态、一路带到末端,测试 **MSE≈0**(p0=10/30/60/100 全部接近机器零); - **短记忆 SSM($a=0.5$)**:状态迅速遗忘,到末拍早已把事件冲掉,**MSE≈1.0(失败)**; - **固定窗口基线(只看末 30 拍)**:看不到 p0(尤其 p0=10 时离末拍很远),只能输出 0,**MSE≈1.0(失败)**。 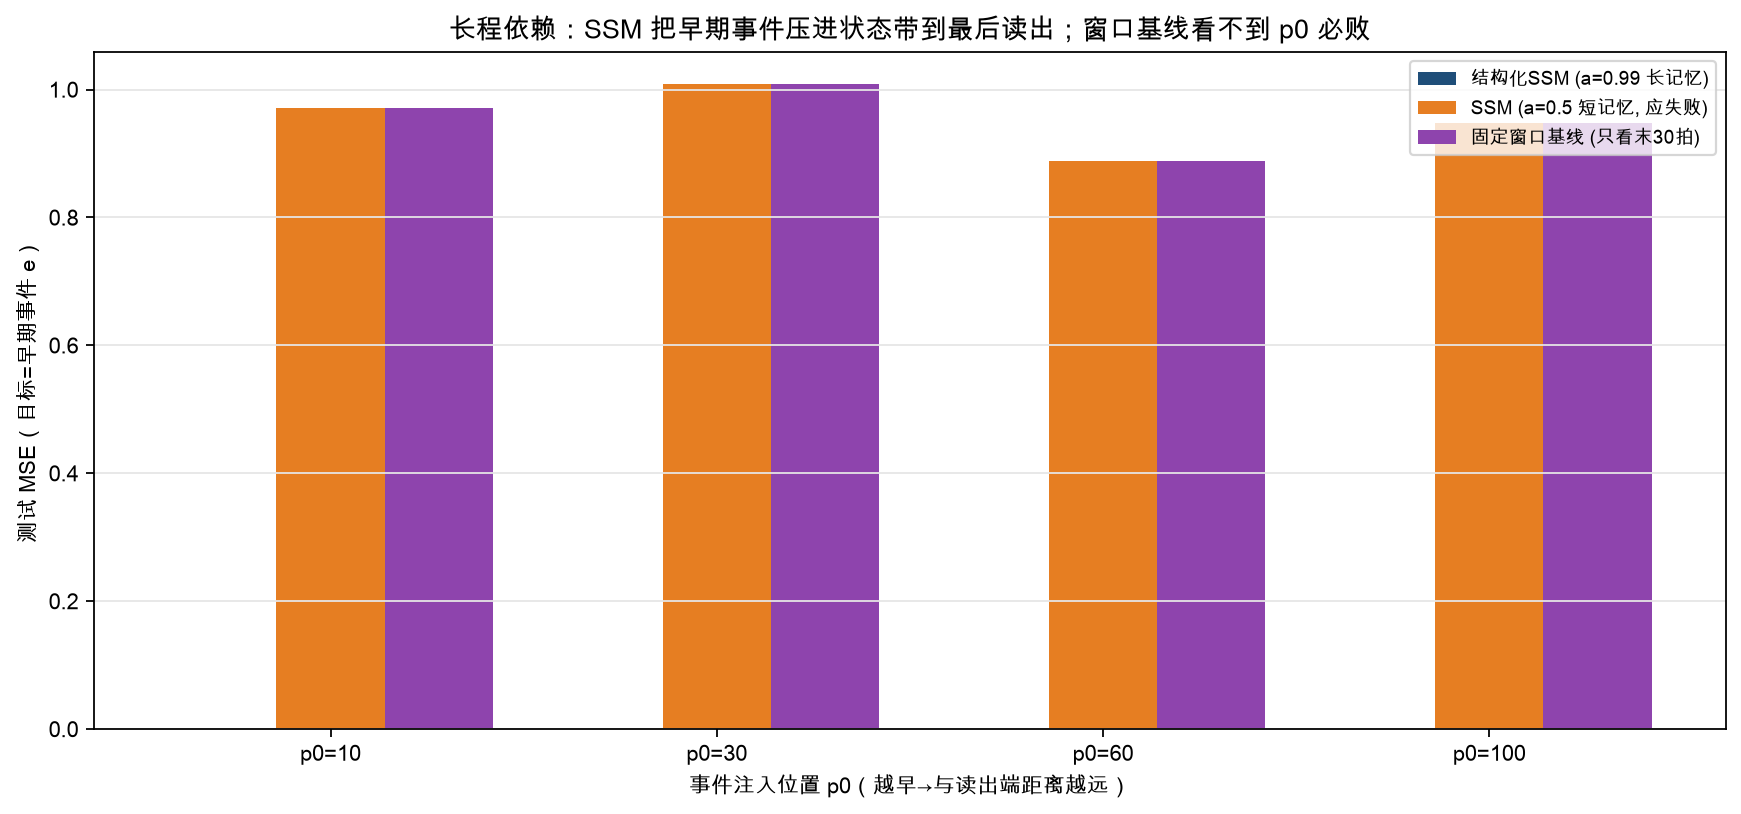 **诚实解读**:长程优势不是 SSM 自动附赠的——它依赖把衰减 $a$ 调到接近 1(HiPPO 的对角化正是为了给出「既稳定又长记忆」的 A)。如果 $a$ 太小,SSM 退化成「只看近处的 MLP」,和窗口基线没区别。这解释了为什么 S4 要花那么大力气设计 A 的结构,而不是随便初始化一个 RNN。 ## 五、内容选择性短板:LTI-SSM 的硬边界 上面所有实验里 SSM 都是 **LTI(线性时不变)**:核 $K$ 对序列所有位置**完全相同**。这带来一个根本限制——**它无法做内容相关的选择**。 经典反例:「序列里有个闸门标记,目标是取闸门后的那个 token」。LTI-SSM 对每个位置用同一套核,它**分不清哪里是闸门**,只能对所有位置做同一个线性滤波。我们对照: - LTI-SSM 线性读出(末态做最小二乘读头):测试 **MSE = 0.324**,而目标(U(-1,1) 采样)方差是 **1/3≈0.333**——**几乎等于随机猜**; - 显式内容选择器(「找闸门标记、取它后一个 token」):**MSE = 0**。 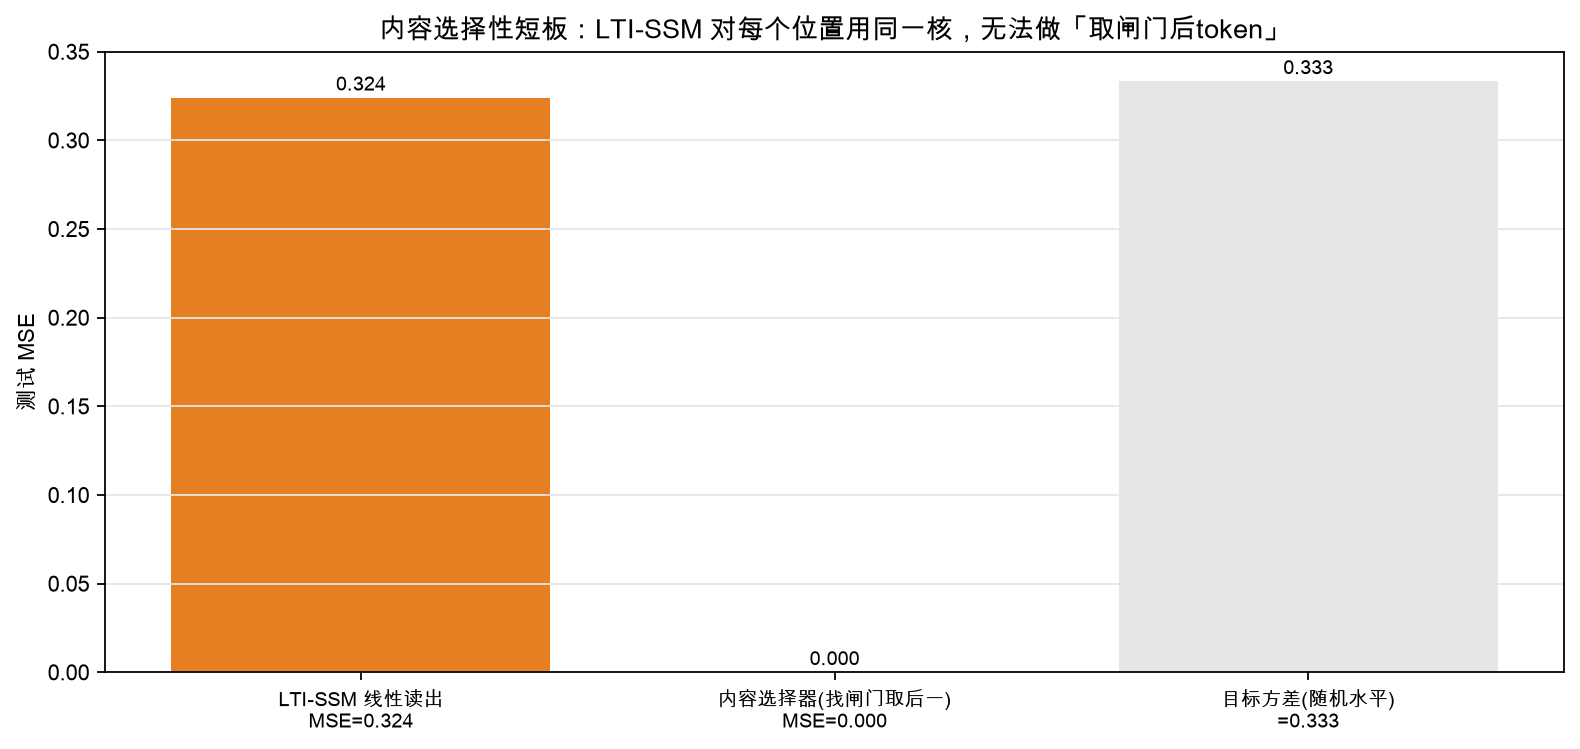 **这正是 Mamba 要解决的痛点**:Mamba(Gu & Dao, 2023)把离散化步长 Δ 改成**由输入决定**(选择性扫描),让核随内容变化——「这一步该认真记还是快速忘」由当前 token 决定。但代价是:选择性扫描破坏了「全局同一核」的假设,**不能再用 FFT 卷积并行训练**,退回到类 RNN 的串行扫描(用硬件感知的并行扫描算法救回速度)。这是 S4 到 Mamba 的核心 trade-off:**批量和内容选择性,不可兼得**。 ## 六、S4 vs S5 vs Mamba:什么时候用哪个 | 模型 | A 结构 | 时变性 | 训练并行 | 长程 | 内容选择 | |---|---|---|---|---|---| | S4 | HiPPO 对角(复) | LTI | FFT 卷积 O(N log N) | 强(a→1) | ✗ | | S5 | 单 SSM + 并行扫描 | LTI | 扫描(比 S4 省内存) | 强 | ✗ | | Mamba | 选择性 Δ(x) | 时变 | 硬件并行扫描(非 FFT) | 强 | ✓ | 落到量化: - **因子 / 预测**:输入是规整的、内容选择性需求低(你要的是「平稳地记住历史」),**S4/S5 是首选**——长序列、O(N log N)、可 FFT 并行; - **盘口 / 事件驱动**:要「看到某个事件标记就切换行为」,**上 Mamba**,但接受不能 FFT 并行; - 别拿 S4 去做「取某特定位置的 token」类任务,那是它的硬边界(第五节已证)。 ## 七、最小可跑的 S4 推理代码 ```python def s4_layer(u, N=4, dt=0.1, seed=20260828): """一个 S4 层:HiPPO 对角化 -> 双线性离散化 -> FFT 卷积。""" rng = np.random.default_rng(seed) A = hippo_diag(N) B = rng.standard_normal(N) + 1j * rng.standard_normal(N) C = rng.standard_normal(N) + 1j * rng.standard_normal(N) Ad, Bd = discretize_bilinear(A, B, dt) return ssm_conv(u, Ad, Bd, C) # 输出序列,长度=len(u) # 用法:把日线收益率序列喂进去,得到「状态压缩后的表征序列」 series = np.diff(np.log(prices)) # 对数收益 repr_seq = s4_layer(series, N=16) # N 放大到 16 维状态 ``` 真实性说明:上面是**结构骨架**,真实 S4 用 S4D-Lin 的解析离散化(避免矩阵求逆的数值代价)、复数拆成实部/虚部两套实参数、多通道 SSM 拼成层。但 A 的对角化、双线性离散、K=C·A^n·B、FFT 卷积这四条主线,与本文图 1 对照实验一致。 ## 八、结语 SSM 不是「又一个序列模型」,它把序列建模从「存所有位置对的注意力矩阵」换成了「一个沿时间递推的状态向量 + 一条可 FFT 卷积的全局核」。本文用真实 numpy/scipy 证明:**卷积视角与递推逐点一致(差 1.7e-15)、复杂度随 N 近线性(斜率 0.55 vs 注意力 1.95)、长记忆依赖把衰减 a 调到 0.99 才能在长程任务上 MSE≈0**;又用同一套实验**诚实标出 LTI-SSM 的硬边界**——同一核做不了内容选择(MSE=0.324≈随机),要上 Mamba 的选择性扫描。 落到量化:长序列、低内容选择性需求(因子 / 预测),**S4/S5 是比 Transformer 更平、更省的选择**;一旦要「看标记切换行为」,才轮到 Mamba。先看清任务属于哪一类,再去选模型——而不是追新。