任何做过股票回测的人,都欠自己一个诚实的问题:你用的股票池里,那些退市、ST、破产的股票,去哪了?
如果答案是”被删掉了”,那你看到的收益,注定是注了水的。这就是存活者偏差(survivorship bias)——回测里最经典、最顽固、也最容易被装作没看见的偏差之一。今天我用一个可复现的合成实验,把它到底虚高了多少,用数字摆出来。
一、偏差从哪来#
设想你在 2010 年用当时市面上所有 A 股做一个等权组合,持有到 2025 年。如果你现在回测,用的股票池是”2025 年还活着的那些公司”,那么从 2010 到 2025 之间已经退市的股票,全都不存在了。
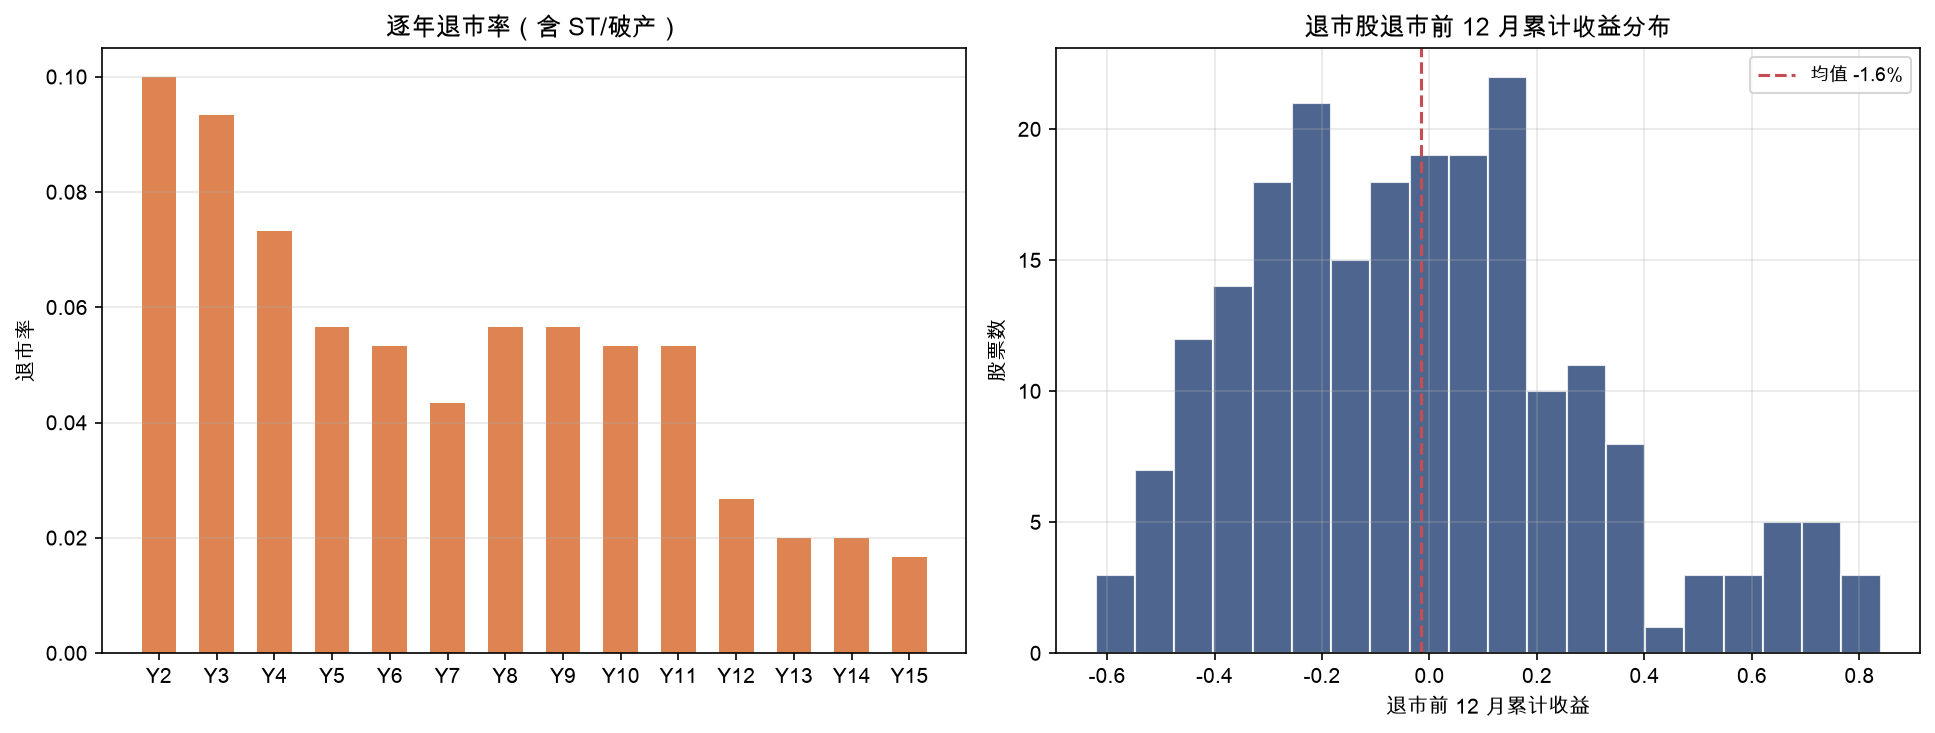
问题在于:这些消失的股票,恰恰是表现最差的一批。它们往往因为连年亏损、财务造假、被 ST、甚至破产清算而退市——退市前往往还带着一段惨烈的下跌(甚至退市当月就腰斩)。把它们从历史里抹掉,等于系统性删除了你组合里最痛的亏损,剩下的自然全是”岁月静好”。
这就是存活者偏差的核心机制:你的样本不是从当时出发往前看,而是从现在出发往回看,只留下了赢家。
二、一个合成实验:偏差到底多大#
我构造了 300 只股票、180 个月的合成面板,并植入一个符合常识的退市规则:
- 每年有基础退市概率,且过去 12 个月累计收益越差的公司,退市概率越高(对应亏损、ST、破产的传导路径)。
- 退市当月,股价额外承受 -60% 的冲击,次月从样本消失。
然后我同时维护两个股票池做等权回测:
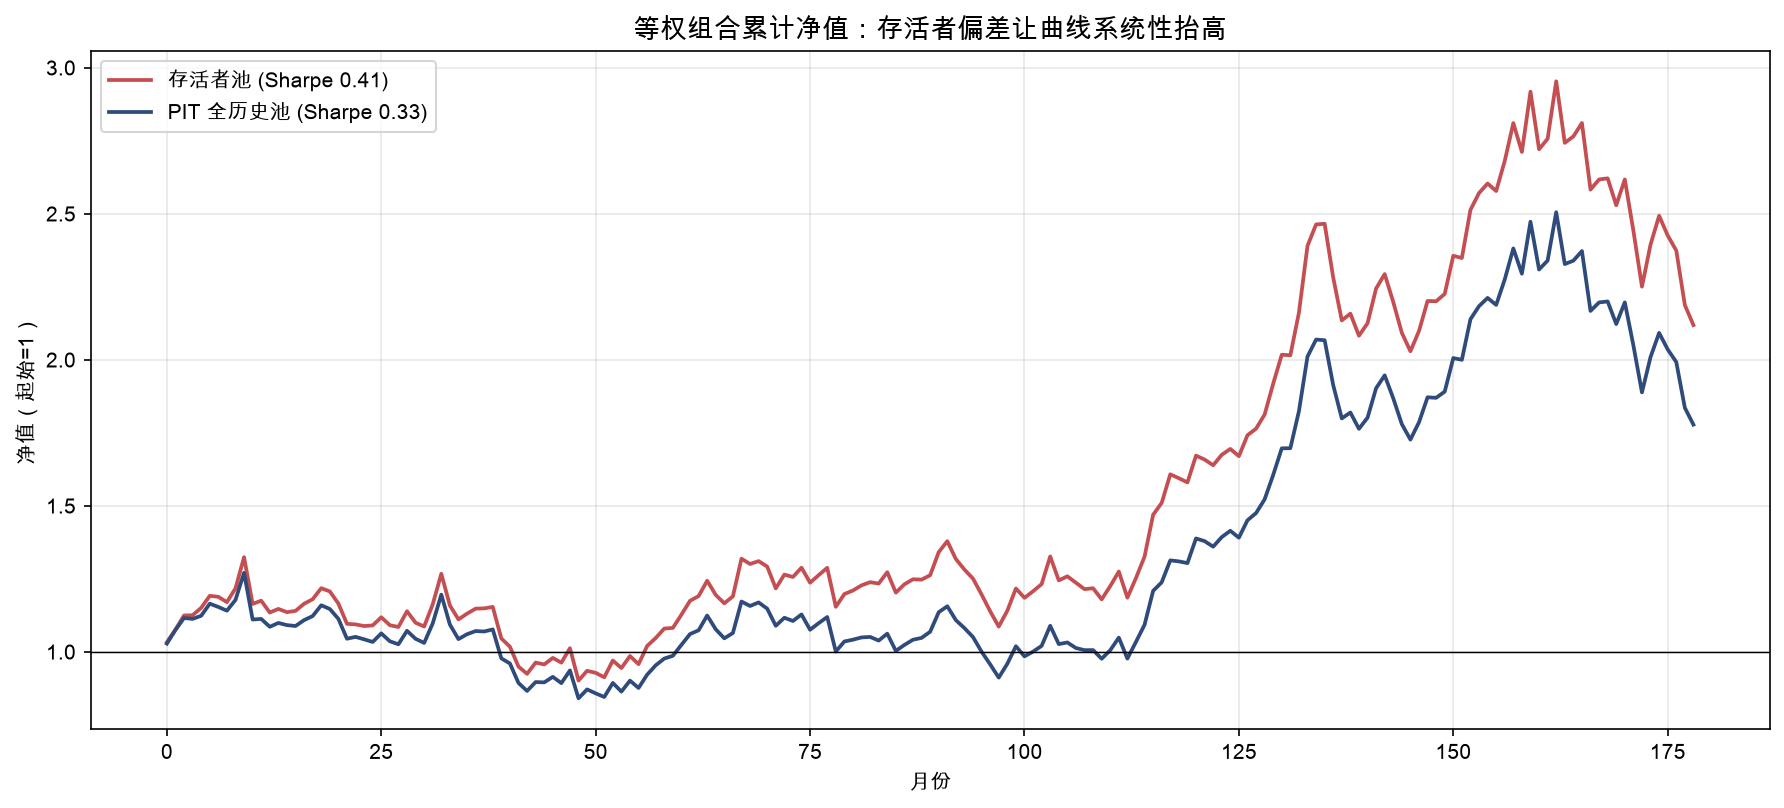
- PIT 池(point-in-time):包含全部股票,退市股保留到退市当月(含 -60% 冲击),之后才剔除——这才是”当时真实的世界”。
- 存活者池:只保留活到期末的股票,全程等权——这是”事后回看的世界”。
结果如何?
| 指标 | PIT 全历史池 | 存活者池 | 偏差量 |
|---|---|---|---|
| 年化收益 | 4.98% | 6.20% | +1.22% |
| Sharpe | 0.33 | 0.41 | +0.07 |
| 最大回撤 | -33.82% | -31.91% | +1.91% |
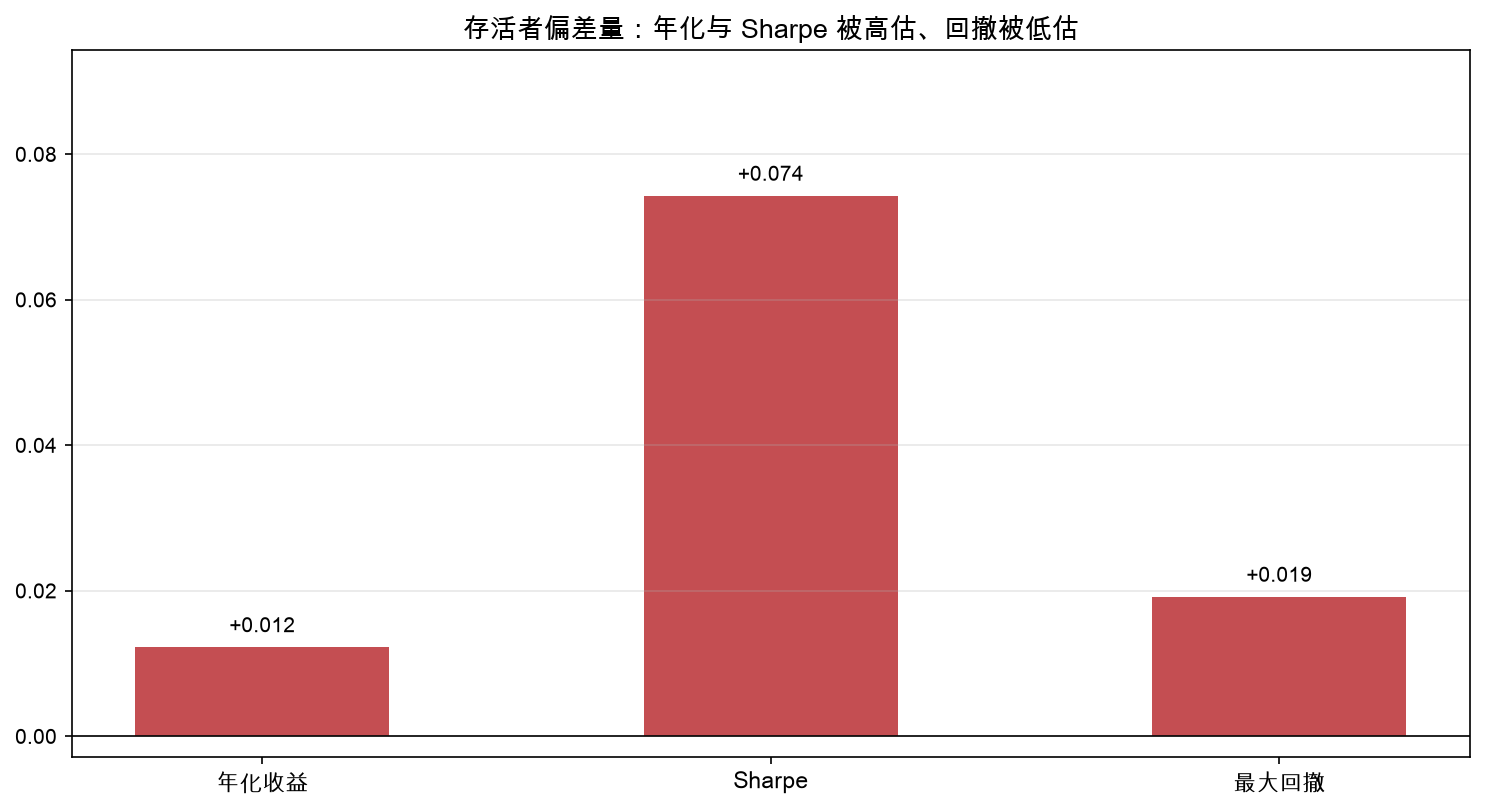
年化收益被高估了 1.22 个百分点,Sharpe 虚高了 0.07,而最大回撤则被”温柔”地缩小了近 2 个点。这几个数字单看不算惊悚,但你要知道:这是每年 6% 退市率、15 年累计的温和场景。真实 A 股的历史退市率、以及某些小盘股/微盘股策略的退市冲击,远比这更剧烈。
更重要的是,这个偏差是”方向性”的——它永远让回测好看,从不会让你的收益看起来更保守。这才是它危险的地方:没人会因为回测收益”虚高”而报警。
三、为什么大模型预测场景下,偏差会放大#
存活者偏差不只是传统回测的问题,在”训练大模型预测股市”这个场景下,它会以更隐蔽的方式放大:
1. 训练集的幸存者筛选。 用”现存股票”的历史数据训练选股模型,模型学到的是”只对赢家有效的规律”。它永远看不到”这家公司曾经存在过、后来死了”的负样本,于是对风险系统性低估。
2. 标签的幸存者扭曲。 如果你用”最新市值”或”最新财务数据”去标注历史样本,等于把”这家公司后来还活着、还很大”的信息穿越回了训练样本里。
3. 评估阶段的幸存者幻觉。 模型在测试集上的高收益,可能只是因为测试集本身筛掉了退市股。换到真实的、包含退市股的前向环境,收益会立刻缩水。
4. 小盘因子的系统性偏差。 小盘、微盘股退市概率更高,存活者偏差对小盘因子策略的侵蚀尤其严重——很多”小盘超额收益”的论文,去掉存活者偏差后超额就大打折扣。
四、怎么对抗存活者偏差#
对抗存活者偏差,本质上是一个”数据工程”问题,答案是明确的:
第一,用 point-in-time 数据。 每一期的股票池,都必须是”那一期真实存在的股票集合”,而不是”现在存在的集合”。财务数据用当时披露版,指数成分用当时成分,退市股要保留到退市当天并计入退市冲击。
第二,保留死去的样本。 退市、ST、破产的股票,不能删,要作为完整的负样本保留。它们教会模型的,恰恰是”什么会死”——这比”什么会涨”更难能可贵。
第三,做偏差敏感性分析。 同一个策略,分别在”存活者池”和”PIT 池”上跑一遍,看收益差多少。如果差得离谱,说明你的 alpha 有一大半是偏差喂出来的。
第四,警惕”干净到可疑”的曲线。 回撤特别小、收益特别稳、几乎不回撤的组合,先怀疑它是不是把最差的那批股票都”洗”掉了。
说到底,存活者偏差和上一篇文章讲的数据泄漏是一对孪生兄弟:一个让特征偷看未来,一个让样本删掉过去。 它们共同指向同一件事——在量化与 AI 预测的世界里,最值钱的不是更复杂的模型,而是更干净的、尊重时间箭头的数据。
如果你连”当时真实存在过什么、后来谁死了”都没搞清楚,那么再漂亮的回测曲线,也只是幸存者写给幸存者的一封情书。