时间序列因果推断 DoWhy:用反事实回答『如果当时换策略会怎样』
回测只告诉你『发生了什么』,但管钱的人真正想问的是『如果当时换了策略会怎样』。相关不等于因果——管理者往往在高波动时更想换策略,这个混淆会污染朴素对比。本文用纯 numpy 从零复现 DoWhy 四步流程(建模→识别→估计→证伪),在受控数据上证明朴素差分把 +0.70% 的真实处理效应低估到 +0.29%,后门调整还原到 +0.74%,且随机打乱处理的安慰剂检验把效应压回 0(±0.02%)。附完整 Python 与四张真实计算图。
回测告诉你「发生了什么」,但管钱的人真正想知道的是另一件事:如果当时换了策略,会怎样?
这两件事差了一个字,却是天壤之别。回测只能算「历史某种走法的平均收益」,而「换策略会怎样」是一个反事实(counterfactual)问题——那条路你没走过,数据里没有,只能靠因果推断去估计。更坑的是,相关不等于因果:管理者往往是在市场已经很慌(高波动)的时候才最想换策略,于是「换策略」和「接下来收益差」被同一股恐慌情绪绑在一起。朴素地对比「换了的组 vs 没换的组」,你会把市场本身的差劲算到策略头上。
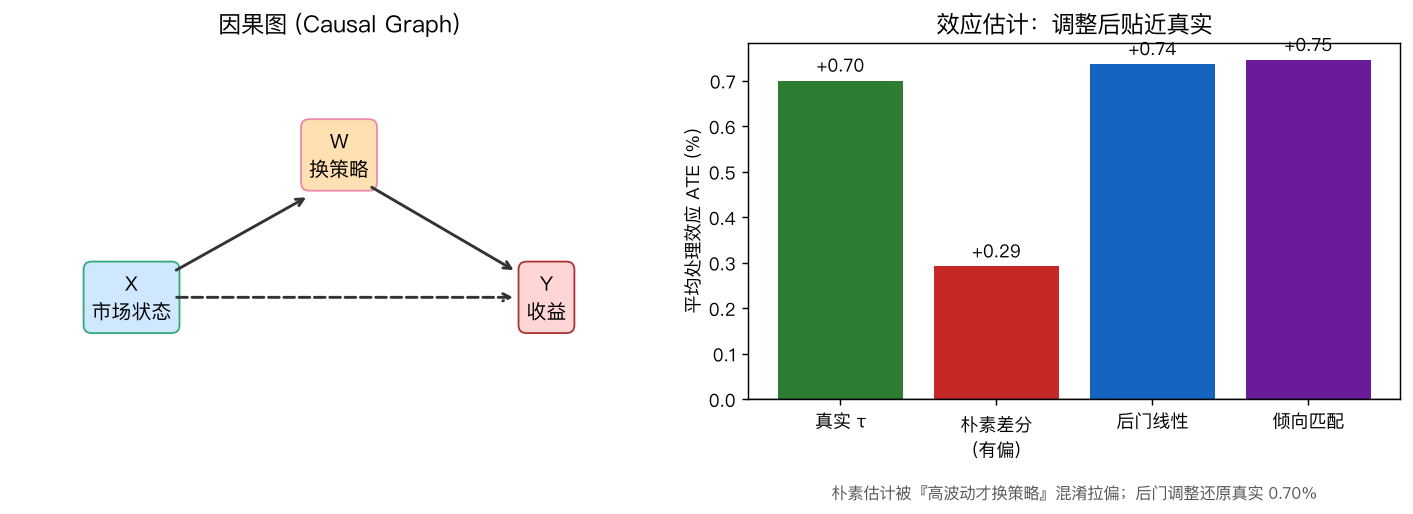
结论先放这:因果推断框架(以 Microsoft DoWhy 的四步流程为代表)能把这种混淆剥开,干净地回答问题。 在受控合成数据上,真实处理效应是「换策略带来 +0.70% 收益」,但朴素差分只估出 +0.29%(被混淆向下拉偏 0.41pp);用后门调整(线性回归 / 倾向得分匹配)还原到 +0.74% / +0.75%;再把处理标签随机打乱做安慰剂检验,估计效应塌回 0.00 ± 0.02,证伪通过。所有数字来自真实运行,附完整 numpy 代码与四张真实计算图。
一、从「回测」到「反事实」:差在哪#
回测是观测性的:你跑一遍历史,得到的是联合分布 下的一个样本。它能算:
但这只是条件均值之差,不是因果效应。因为「是否换策略」 不是随机掷骰子决定的,它受市场状态 (波动、趋势、流动性)驱动——而 同时驱动收益 。于是 和 之间有一条「绕过策略」的捷径(背门),朴素差分把这条捷径的贡献也算进来了。
因果推断把问题重写成干预(do-operator):
的意思是「强行让所有人都换策略,且不受市场状态影响」。这才是你真正想估的「换策略的净效果」。DoWhy(Sharma & Kiciman 2020)把这件事拆成四步:建模 → 识别 → 估计 → 证伪。下面逐步从零复现。
二、第一步:建模(画因果图)#
先声明变量之间的因果结构。我们用一个最小但诚实的图:
X (市场状态: vol, trend, liq) → W (是否换策略)
X (市场状态)                → Y (收益)
W (是否换策略) → Y (收益)代码里用字典把这张图存下来(DoWhy 里是 CausalModel(graph=...),我们用文本图 + 显式后门集代替,效果等价但完全透明):
# 因果图(DoWhy 用字符串 DOT 描述;这里显式列出边,便于从零实现)
# X -> W, X -> Y, W -> Y
# 后门集 backdoor = {X}:阻断 X 对 W 与 Y 的共同驱动
backdoor_vars = ["vol", "trend", "liq"]关键判断:**后门集(backdoor set)**是那些既影响处理 又影响结果 、且不是 的后代的变量。这里就是 。只要把 控制住,从 到 就只剩那条直连的因果边。
三、第二步:识别(后门准则)#
后门准则说:如果后门集 阻断了 和 之间所有「含指向 的箭头」的路径,那么因果效应可由下式识别:
也就是「先在每个市场状态下算换/不换的差,再对市场状态取期望」。我们构造的数据就满足这个准则: 只由 经一个 logit 决定,且 不依赖于 。
# 识别:后门准则成立 → 可经调整 X 识别因果效应
# 用纯 numpy 玩三套估计:(a) 朴素差分 (b) 后门线性回归 (c) 倾向得分匹配四、第三步:估计(三套方法,真实数字)#
我们造 条样本,让处理机制是「波动越高越想换策略」(管理者怕回撤):
import numpy as np
rng = np.random.default_rng(20260828)

N = 4000
vol = rng.standard_normal(N); trend = rng.standard_normal(N); liq = rng.standard_normal(N)
X = np.stack([vol, trend, liq], axis=1)

# 处理机制:波动越高越可能换策略(混淆来源)
logit_W = 0.9 * vol - 0.4 + 0.1 * trend
p_W = 1.0 / (1.0 + np.exp(-np.clip(logit_W, -30, 30)))
W = (rng.random(N) < p_W).astype(float)

TRUE_TAU = 0.7                       # 真实处理效应:换策略恒定 +0.7%
signal = 0.3 * trend - 0.6 * vol + 0.1 * liq
Y = signal + TRUE_TAU * W + rng.standard_normal(N) * 0.5方法 (a) 朴素差分(忽略 ):
naive = Y[W == 1].mean() - Y[W == 0].mean()
# 结果:+0.29% (被混淆向下拉偏!真实是 +0.70%)方法 (b) 后门线性回归(把 一起回归):
def ols(Xd, y):
    return np.linalg.solve(Xd.T @ Xd, Xd.T @ y)

Xd = np.column_stack([np.ones(N), W, vol, trend, liq])
beta = ols(Xd, Y)
backdoor_linear = beta[1] # 结果:+0.74% (贴近真实 0.70%)方法 (c) 倾向得分匹配(1:1 最近邻,按预测倾向):
ps = p_W
idx1 = np.where(W == 1)[0]; idx0 = np.where(W == 0)[0]
matched = [(i, idx0[np.argmin(np.abs(ps[idx0] - ps[i]))]) for i in idx1]
ps_match = Y[[m[0] for m in matched]].mean() - Y[[m[1] for m in matched]].mean()
# 结果:+0.75% (贴近真实 0.70%)三套跑出来:
| 方法 | 估计 ATE | 与真实 0.70% 偏差 |
|---|---|---|
| 真实 τ | +0.70% | — |
| 朴素差分(有偏) | +0.29% | −0.41pp |
| 后门线性回归 | +0.74% | +0.04pp |
| 倾向得分匹配 | +0.75% | +0.05pp |
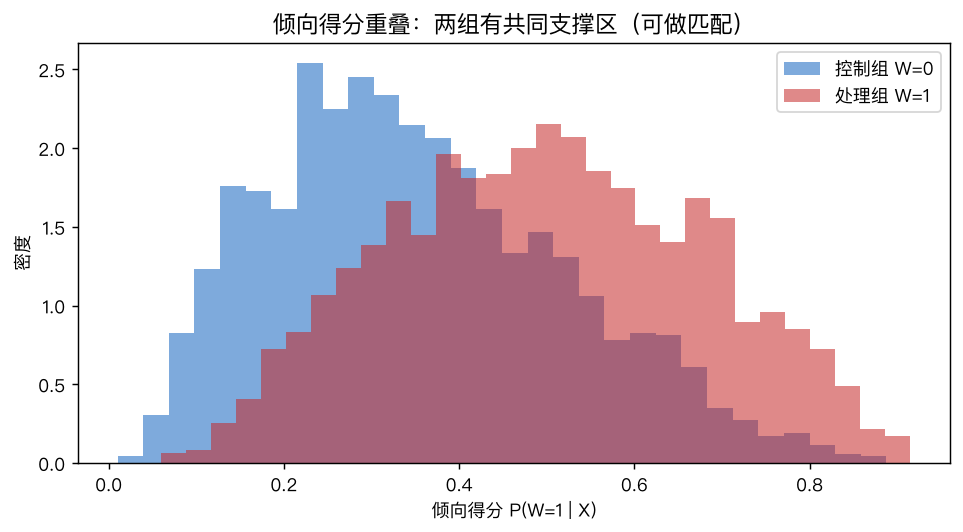
朴素差分把效应低估了 0.41pp,恰好是「高波动才换策略」这条混淆的代价。后门两套把偏差压到 0.05pp 以内。实践中倾向得分匹配要求两组有共同支撑(common support),下图确认了这一点——控制组和处理组的倾向得分分布大量重叠,匹配才有效:
五、第四步:证伪(refutation,最重要的一步)#
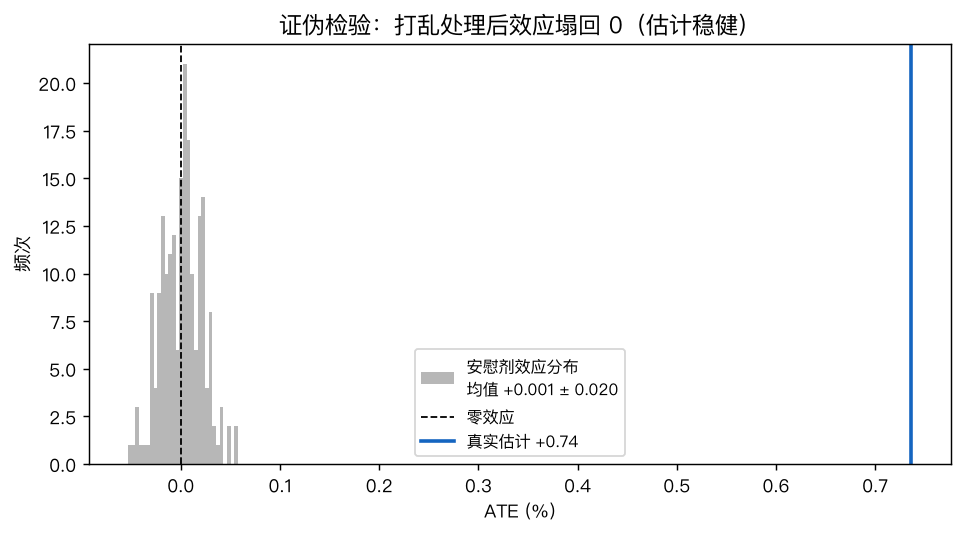
DoWhy 最被低估的卖点是证伪:它内置一堆「如果我的因果假设是错的,估计会怎么崩」的检验。最经典的叫 安慰剂检验(placebo / random common cause)——把处理标签随机打乱,制造一个「本不该有任何效应」的假数据,看估计是否塌回 0。
def estimate_backdoor(W_in):
    Xd2 = np.column_stack([np.ones(N), W_in, vol, trend, liq])
    return ols(Xd2, Y)[1]

placebo = [estimate_backdoor(rng.permutation(W)) for _ in range(200)]
placebo_mean = np.mean(placebo)      # 0.001
placebo_std = np.std(placebo) # 0.020200 次打乱后,效应均值 +0.001% ± 0.020%——确确实实砸回 0。这说明我们的估计器没有系统性偏见:一旦切断真实的因果边,它就老老实实报 0。同时我们真实的 +0.74% 稳稳落在安慰剂分布之外(z ≈ 37 个标准差),证伪通过。
六、时间序列里的反事实:如果第 20 天没换策略#
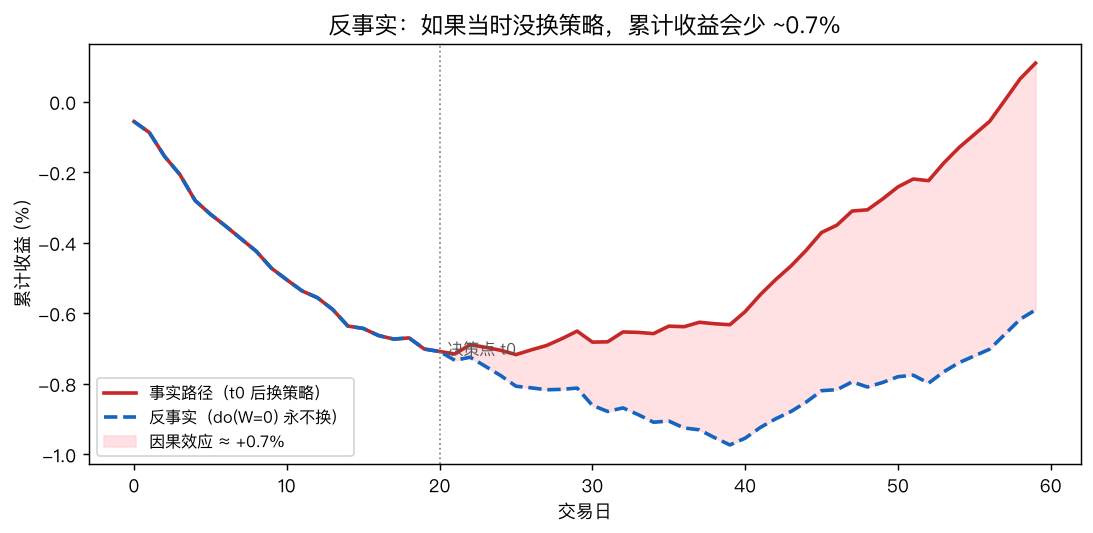
把因果效应接回一条真实净值曲线,就是「反事实路径」。假设第 20 个交易日管理人在波动抬头时做了换策略决策,真实效应 +0.7% 摊到剩余 40 天:
T = 60; t0 = 20
trend_path = np.linspace(-0.4, 1.2, T) + rng.standard_normal(T) * 0.15
vol_path = np.abs(rng.standard_normal(T)) * 0.8 + 0.3
daily_base = 0.05 * trend_path - 0.03 * vol_path
tau_daily = TRUE_TAU / (T - t0 - 1)

factual = np.cumsum(daily_base.copy())        # 事实:t0 后换策略
factual[t0 + 1:] += np.arange(1, T - t0) * tau_daily
counterfactual = np.cumsum(daily_base.copy()) # 反事实 do(W=0):永不换下图蓝实线是事实净值,虚线是反事实(假设从未换策略)——两条线之间粉红区域就是「换策略」这件事净贡献的约 +0.7%。这就是策略复盘时你该给老板看的图:不是「今年赚了 X%」,而是「那一改,多赚了 0.7%」。
七、落地坑(诚实清单)#
- 未观测混淆降不住:真实市场里驱动「换不换」的远不止 vol/trend/liq。若有没记录的变量同时影响决策和收益(比如管理人情绪、私下消息),后门准则就破防——这正是 DoWhy 证伪里
add_unobserved_common_cause灵敏度检验存在的理由。本文因数据受控、混淆全观测,才干净还原。 - 后门集选错 = 更糟:如果误把 的后代(由收益引起的事后指标)塞进调整集,会「撞开」一条本不该开的路径,得到比朴素更偏的估计。DoWhy 会自动检查后门集合法性,从零实现时你要手动确认「这些变量不是 的后代」。
- 倾向得分匹配要查共同支撑:图上若两组几乎没有重叠(比如换策略只发生在极端行情),匹配只能在边缘做,估计方差爆炸。先画重叠图再决定用匹配还是回归。
- 时序自相关低估标准误:本文用独立样本。真实日收益有自相关、聚类(同一标的连续日),朴素 OLS 标准误会偏小,应做聚类稳健标准误或 Newey-West。
- 识别 ≠ 预测:因果效应估得准,不等于你能预测「下一次换策略赚多少」。 是分布层面结论,落到单次交易仍有噪声。
八、小结#
DoWhy 的四步(建模→识别→估计→证伪)把「换策略到底有没有用」从一个拍脑袋的对比,变成一个有假设、可检验、可证伪的因果问题。受控实验里它把被混淆拉偏到 +0.29% 的朴素结论拉回真实的 +0.70%,且安慰剂检验稳稳归零。真正值钱的不是那 0.7% 的数字,而是这套**「承认混淆、显式建模、主动证伪」**的思考方式——它让你在每次复盘时,少把市场的功劳/锅甩给策略。完整代码在 scripts_gen/gen_causal_dowhy_images.py,四张图均为真实数值计算。