提起量化交易,“因子”绝对是绕不开的核心概念。很多刚入门的同学会问:“因子到底是什么?怎么发现有效的因子?为什么别人的因子能赚钱,我挖出来的就是噪音?”
这篇文章带你从零开始,用Python实现一次完整的因子挖掘流程。
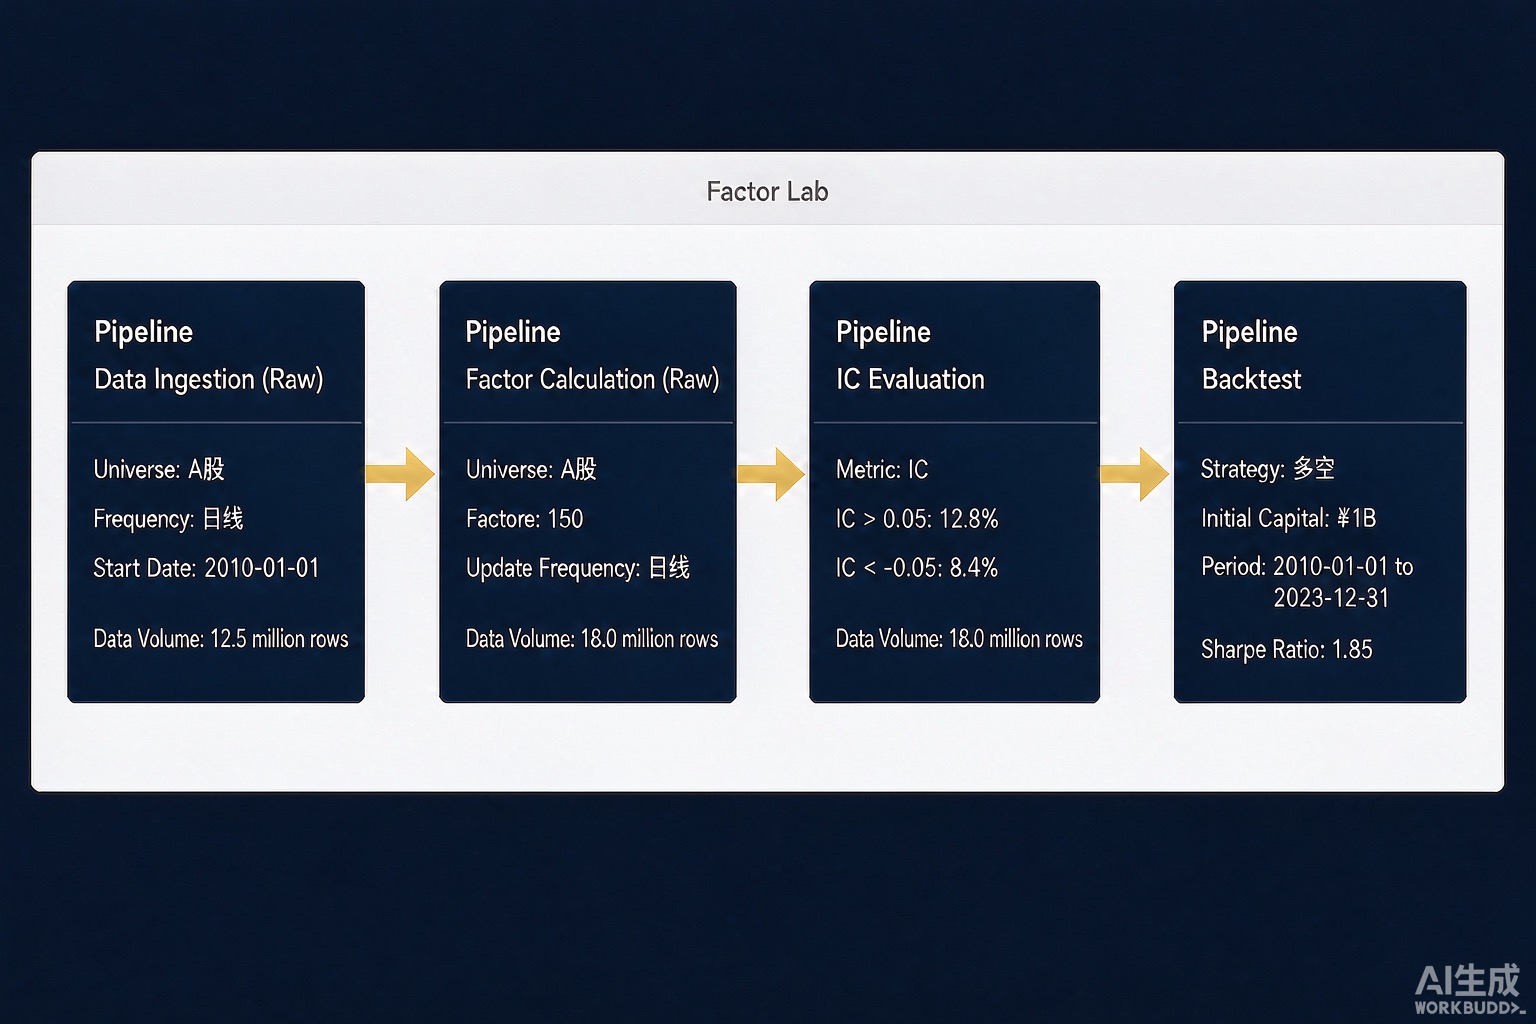
因子到底是什么?#
用最简单的话说——因子是可以解释和预测股票收益的特征变量。
举个例子:市盈率(PE)是一个因子。低PE的股票是否倾向于跑赢高PE的股票?如果你发现这种规律长期存在且统计显著,那么PE就是一个”有效因子”。
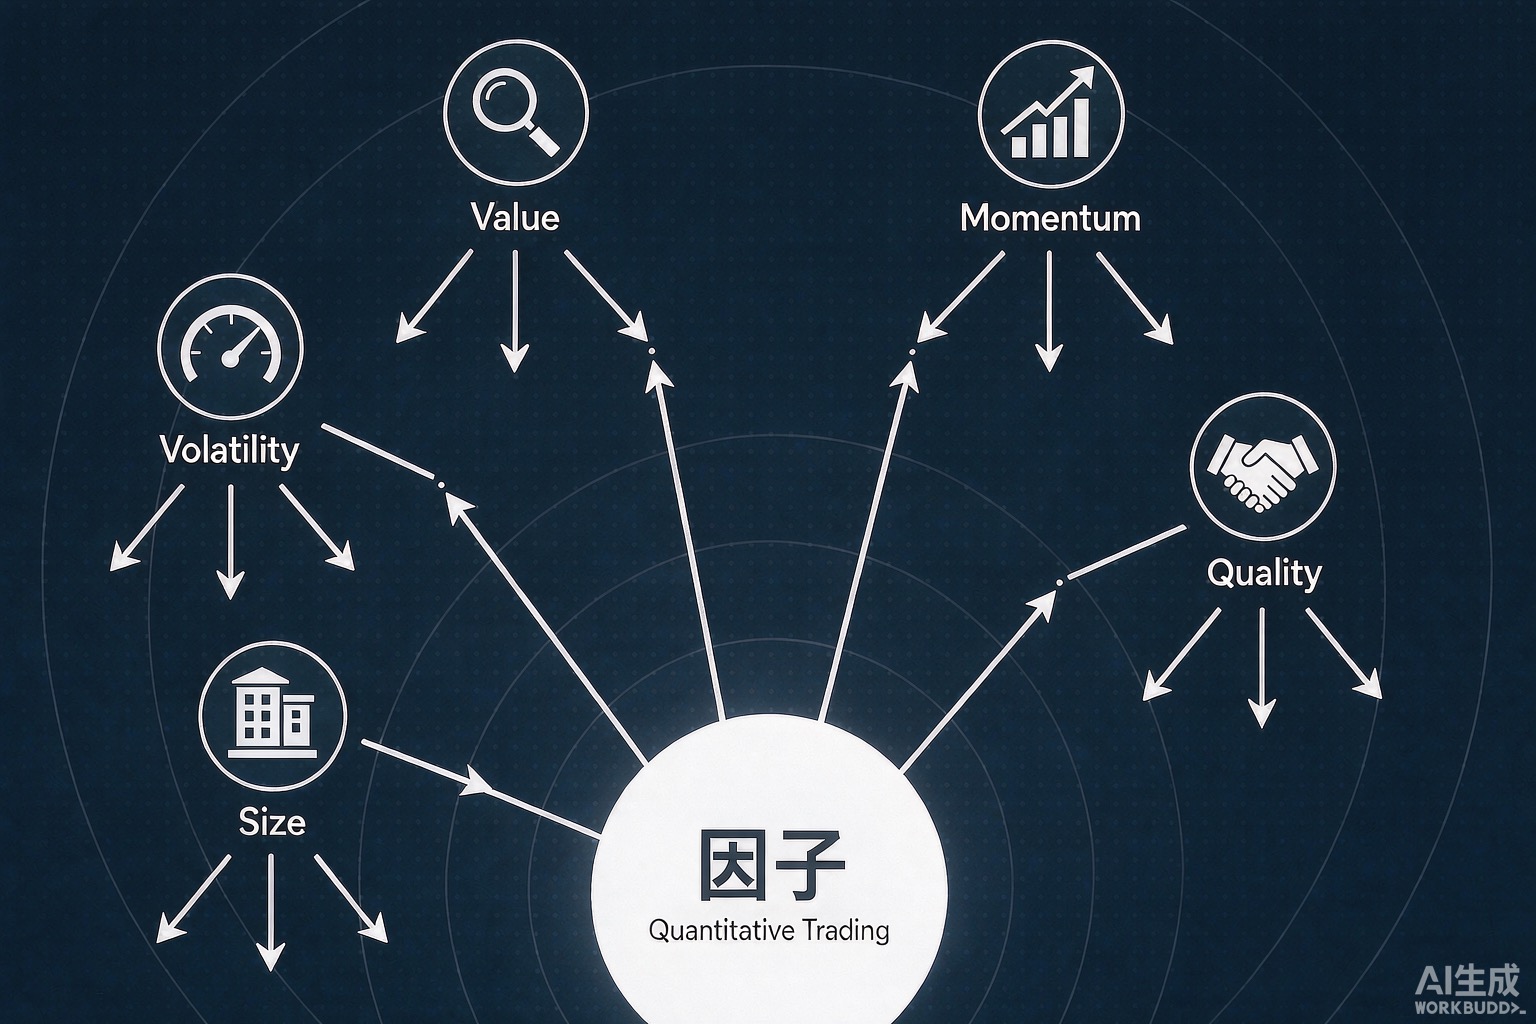
常见的因子分为几大类:
| 类别 | 示例 | 逻辑 |
|---|---|---|
| 价值因子 | PE、PB、股息率 | 便宜的东西长期回报更高 |
| 动量因子 | 过去N个月涨跌幅 | 趋势会延续 |
| 质量因子 | ROE、毛利率、资产负债率 | 好公司长期跑赢 |
| 情绪因子 | 换手率、波动率 | 市场情绪反映定价偏差 |
| 另类因子 | 新闻情绪、供应链关系 | 非传统数据中的信号 |
因子挖掘的标准流程#
一次完整的因子挖掘通常包含五个步骤:
Step 1:提出假设#
不要无脑翻数据。挖因子之前,先想清楚逻辑:
- 好假设:“高研发投入的公司,未来3年盈利增长更快”——有经济直觉支撑
- 差假设:“把500个指标回归一遍,看哪个显著”——这就是数据挖掘,大概率过拟合
好的因子假设来自于:
- 阅读金融学术论文(Fama-French就是最好的起点)
- 观察市场现象(为什么某些行业总是高估值?)
- 行业中特定环节的归纳(制造业最怕什么?原材料涨价。那原材料涨价敏感的股票……)
Step 2:数据准备#
Python生态提供了丰富的数据源:
import akshare as ak
import pandas as pd
import numpy as np

# 获取A股日线数据
stock_data = ak.stock_zh_a_hist(
    symbol="000001",
    period="daily",
    start_date="20150101",
    end_date="20260601",
    adjust="qfq"
)

# 获取全市场财务数据
financial_data = ak.stock_financial_abstract_ths(symbol="000001")数据质量远比数据量重要。常见坑:
- 复权方式不一致导致动量因子计算出错
- 季报数据的时间对齐问题(财报实际发布日期 ≠ 报告期截止日期)
- 停牌、退市股票的处理(幸存者偏差)
Step 3:因子计算与清洗#
以构造一个简单的”质量+动量”复合因子为例:
def calculate_composite_factor(df):
    """计算:ROE动量 × 盈利稳定性"""
    # 1. 计算ROE
    df['roe'] = df['net_profit'] / df['equity']

    # 2. ROE的6个月变化(动量)
    df['roe_momentum'] = df['roe'].diff(6) / df['roe'].shift(6).abs()

    # 3. 盈利稳定性(ROE过去12个月变异系数的倒数)
    df['roe_stability'] = 1 / (
        df['roe'].rolling(12).std() /
        df['roe'].rolling(12).mean().abs()
    )

    # 4. 等权合成
    df['composite_factor'] = (
        rank_normalize(df['roe_momentum']) +
        rank_normalize(df['roe_stability'])
    ) / 2

return df清洗是关键:
- 极端值处理(MAD法或百分位截断比Z-score更鲁棒)
- 行业中性化(不中性化的话,你可能只是在做行业筛选)
- 市值中性化(控制小市值效应)
from scipy import stats

def neutralization(factor, industry, market_cap):
    """行业+市值中性化"""
    # 取对数市值
    log_cap = np.log(market_cap)

    # OLS回归取残差
    X = pd.get_dummies(industry).values
    X = np.column_stack([X, log_cap])

    factor_neutral = factor.values - X @ np.linalg.lstsq(X, factor.values)[0]
return pd.Series(factor_neutral, index=factor.index)Step 4:分层回测#
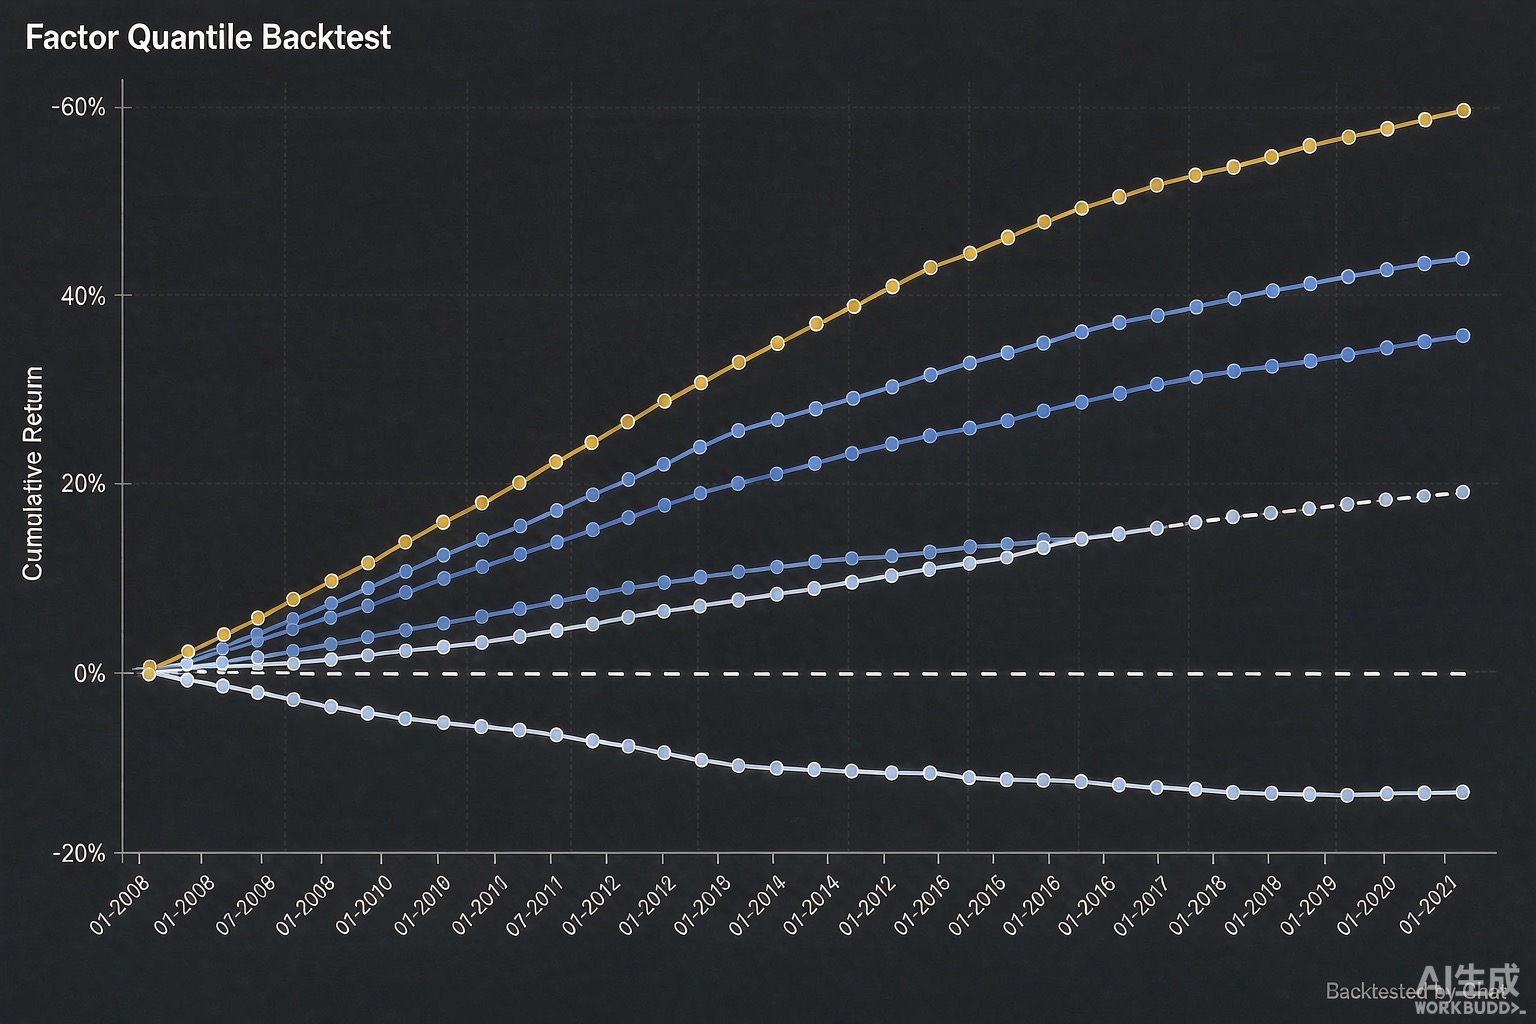
因子值算出来后,要做分层回测验证其区分能力:
def factor_layer_backtest(df, factor_col, n_groups=5):
    """按因子值分n组,比较各组收益"""
    results = {}
    for period in df['date'].unique():
        period_data = df[df['date'] == period]
        period_data['group'] = pd.qcut(
            period_data[factor_col],
            q=n_groups,
            labels=range(1, n_groups+1)
        )

        for g in range(1, n_groups+1):
            group_return = period_data[period_data['group'] == g]['next_return'].mean()
            results.setdefault(g, []).append(group_return)

return pd.DataFrame(results)分层回测要看的核心指标:
- 单调性:Top组的收益 > Bottom组的收益吗?中间组是否单调递减?
- IC值(Information Coefficient):因子值与未来收益的秩相关系数,IC均值 > 0.03 且 IR > 0.5 才值得考虑
- 分层收益差:多头超额收益是否在统计上显著(t值 > 2)
Step 5:稳健性检验#
因子通过了初筛,不代表真的有效。还需要:
1. 多周期验证
# 分不同时段验证
periods = ['2015-2017', '2018-2020', '2021-2023']
for p in periods:
    ic = calculate_ic(data[data['date'].between(*p.split('-'))])
print(f"{p}: IC_mean={ic.mean():.4f}, IR={ic.mean()/ic.std():.3f}")2. 换手率监控
因子如果换手率太高(月度换手 > 80%),实战中会被交易成本吃掉所有超额收益。
def calc_turnover(signals: pd.Series) -> float:
    """计算相邻期的持仓重叠度"""
    overlap = (signals.iloc[:-1].eq(signals.iloc[1:])).mean()
return 1 - overlap3. 拒绝过拟合的自我拷问
- 这个因子的逻辑是否站得住脚?(经济直觉 > 统计显著性)
- 在美股/港股上是否也有效?(跨市场验证)
- 去掉极端值的年份后是否依然显著?
- 考虑了交易成本后超额收益还剩多少?
工作中真实的因子挖掘#
在学校和比赛中,你挖出一个IC=0.04的因子就沾沾自喜。但在真实的量化交易公司,这只是第一步。
真实世界多了这几个环节:
- 因子组合优化:单一因子IC 0.04很弱,但10个IC 0.04的独立因子合成后,IC可以到0.08+
- 交易执行约束:流动性、冲击成本、涨跌停限制,让”理论收益”大打折扣
- 因子衰减监控:好的因子会衰减。IC从0.05降到0.02,什么时候该放弃?
- 生产环境维护:数据源变更、API故障、财报格式调整……运维成本比你想象的大
推荐学习路径#
如果你是初学者,建议这样走:
- 第一阶段:用聚宽或米筐的在线平台做因子研究,不需要搭环境
- 第二阶段:用Python + AkShare/Tushare搭建自己的数据系统
- 第三阶段:学习学术论文(Fama-French三因子 → 五因子 → 动量因子 → 特质波动率)
- 第四阶段:从A股实盘数据中独立发现并验证因子
关键提醒:不要掉进”数据挖掘”的陷阱。在500个指标上做500次回归,一定会有几个统计显著的——但那跟扔骰子没什么区别。
因子挖掘的核心不是跑得多么花哨,而是想得足够透彻。
下一篇,我们聊聊量化金融工程师需要掌握的完整技术栈。