贝叶斯深度学习因子:用 MC Dropout 给神经网络预测配不确定性
深度学习因子模型给出的是“点预测”——下期收益 1.2%,却不说“我有多大把握”。真实市场里把握比点值更重要:低把握的预测不该和铁板钉钉的预测一样重仓。本文用纯 numpy 从零实现一个带 dropout 的小 MLP,证明 MC Dropout(推理时保持 dropout 开启、T 次随机前向取均值+方差)能在不重训、不换架构的前提下,给每个预测配一个 epistemic 不确定性。受控实验给出四个诚实结论:分布外样本不确定性显著抬升(OOD 分离 AUC 0.97)、按不确定性弃投 30% 最不确定样本后混合池 RMSE 降 40%、但 MC Dropout 只建模认知不确定性导致 90% 区间实际仅覆盖 50%(叠加 aleatoric 噪声后回到 89%)、且 iid 同方差下 epistemic σ 与单样本误差几乎无关(r=0.08)。附完整 Python 与四张真实计算图。
深度学习因子模型(用 MLP / Transformer 预测下期收益)最大的”黑箱税”不是可解释性,而是它没有告诉你”我有多大把握”。一个输出”下期收益 +1.2%“的模型,和一个输出”下期收益 +1.2% ± 3.5%“的模型,在组合构建里价值天差地别——前者会被无差别地当铁板钉钉信号重仓,后者让你在低把握时主动降级。
传统做法是用点预测的绝对值排个序就完事,但这把”模型对该区域熟不熟”这个信息彻底丢弃了。贝叶斯深度学习要解决的问题就是:在几乎不增加成本的前提下,给神经网络的每一个预测配一个概率意义上的不确定性。
本文用的工具是 MC Dropout(Gal & Ghahramani, 2016):它不需要贝叶斯推断、不需要变分下界,只需要在推理时保持 dropout 开启,对一个样本做 T 次随机前向,用这 T 条路径的均值当点预测、方差当不确定性。我们从零实现一个带 dropout 的小 MLP,在受控合成因子任务上跑出四个真实结论,并诚实标出它的边界。
一、为什么点预测不够:把握本身是可交易信息#
设想两个预测:
- 预测 A:某只消费股,因子落在训练密集区,模型见过几万只同类样本 → 模型”熟”,预测可信。
- 预测 B:某只刚上市、主营业务飘移、因子落在训练空白区的新股 → 模型”没见过”,预测本质是外推。
点预测框架里 A 和 B 都被当成 +1.2% 一视同仁。但B 的外推误差大概率比 A 大,把它和 A 一样重仓,等于在不知道自己不知道的地方下了重注。
不确定性量化把”把握”显式建模出来,至少能支撑三类动作:
- 选择性预测(abstention):低把握样本弃投或降级,只在高把握样本上出手。
- 风险预算:给低把握预测配更小仓位(类似 Kelly 里对噪声更敏感)。
- 分布外监控:某天全市场不确定性整体抬升,说明模型”看不懂”当前 regime,该缩表。
二、MC Dropout:零额外成本的”伪贝叶斯”#
核心直觉:Dropout 训练时随机”关掉”一部分神经元,等价于对一个带宽 dropout 掩码的模型族做几何平均集成(ensemble)。Gal 证明,在推理时也保持 dropout 开启并对同一输入前向 T 次,这 T 条路径的输出分布,近似于贝叶斯后验预测的蒙特卡洛采样。
import numpy as np

def mc_predict(X, params, p_drop=0.15, T=50, rng=None):
    """MC Dropout 推理:保持 dropout 开启,T 次随机前向,返回 (均值, 标准差)"""
    preds = np.zeros((X.shape[0], T))
    for t in range(T):
        # 每次前向都重新随机 dropout 掩码
        m1 = (rng.random((X.shape[0], H1)) > p_drop).astype(float) / (1 - p_drop)
        m2 = (rng.random((X.shape[0], H2)) > p_drop).astype(float) / (1 - p_drop)
        z1 = X @ params["W1"] + params["b1"]
        h1 = np.maximum(0, z1) * m1
        z2 = h1 @ params["W2"] + params["b2"]
        h2 = np.maximum(0, z2) * m2
        preds[:, t] = (h2 @ params["W3"] + params["b3"]).ravel()
return preds.mean(axis=1), preds.std(axis=1) # 均值=点预测,标准差=epistemic 不确定性注意两个关键点:均值不是单次前向,而是 T 次平均(比单次更稳);标准差来自 T 次之间的离散度,反映”不同 dropout 掩码给出的答案差多大”——这正是模型对该区域”意见分歧”的程度。
完整训练(含反向传播)就是从零实现带 dropout 的小 MLP,dropout 在训练和推理时都生效:
def forward_cache(X, p, p_drop=0.15, rng=None):
    """前向 + 缓存中间量(供反传用),训练与 MC 推理共用"""
    m1 = (rng.random((X.shape[0], H1)) > p_drop).astype(float) / (1 - p_drop)
    m2 = (rng.random((X.shape[0], H2)) > p_drop).astype(float) / (1 - p_drop)
    z1 = X @ p["W1"] + p["b1"]; a1 = np.maximum(0, z1); h1 = a1 * m1
    z2 = h1 @ p["W2"] + p["b2"]; a2 = np.maximum(0, z2); h2 = a2 * m2
    y = h2 @ p["W3"] + p["b3"]
    return y.ravel(), dict(m1=m1, m2=m2, h1=h1, h2=h2, z1=z1, z2=z2)

def backward(X, y, p, cache):
    """反传:标准两层 MLP + dropout 掩码(注意 relu 与 dropout 都要乘回梯度)"""
    n = X.shape[0]
    yh = (cache["h2"] @ p["W3"] + p["b3"]).ravel()
    err = yh - y
    m1, m2, z1, z2 = cache["m1"], cache["m2"], cache["z1"], cache["z2"]
    gW3 = cache["h2"].T @ err[:, None]; gb3 = err.sum()
    dh2 = (err[:, None] @ p["W3"].T) * (z2 > 0) * m2
    gW2 = cache["h1"].T @ dh2; gb2 = dh2.sum(axis=0)
    dh1 = (dh2 @ p["W2"].T) * (z1 > 0) * m1
    gW1 = X.T @ dh1; gb1 = dh1.sum(axis=0)
    return {"W1": gW1/n, "b1": gb1/n, "W2": gW2/n, "b2": gb2/n,
"W3": gW3/n, "b3": np.array([gb3/n])}我用 12 维合成因子、2000 条训练样本、50 次 MC 前向(dropout=0.15)跑完整实验。
三、结论一:OOD 检测——模型”看不懂”的样本会自己举手#
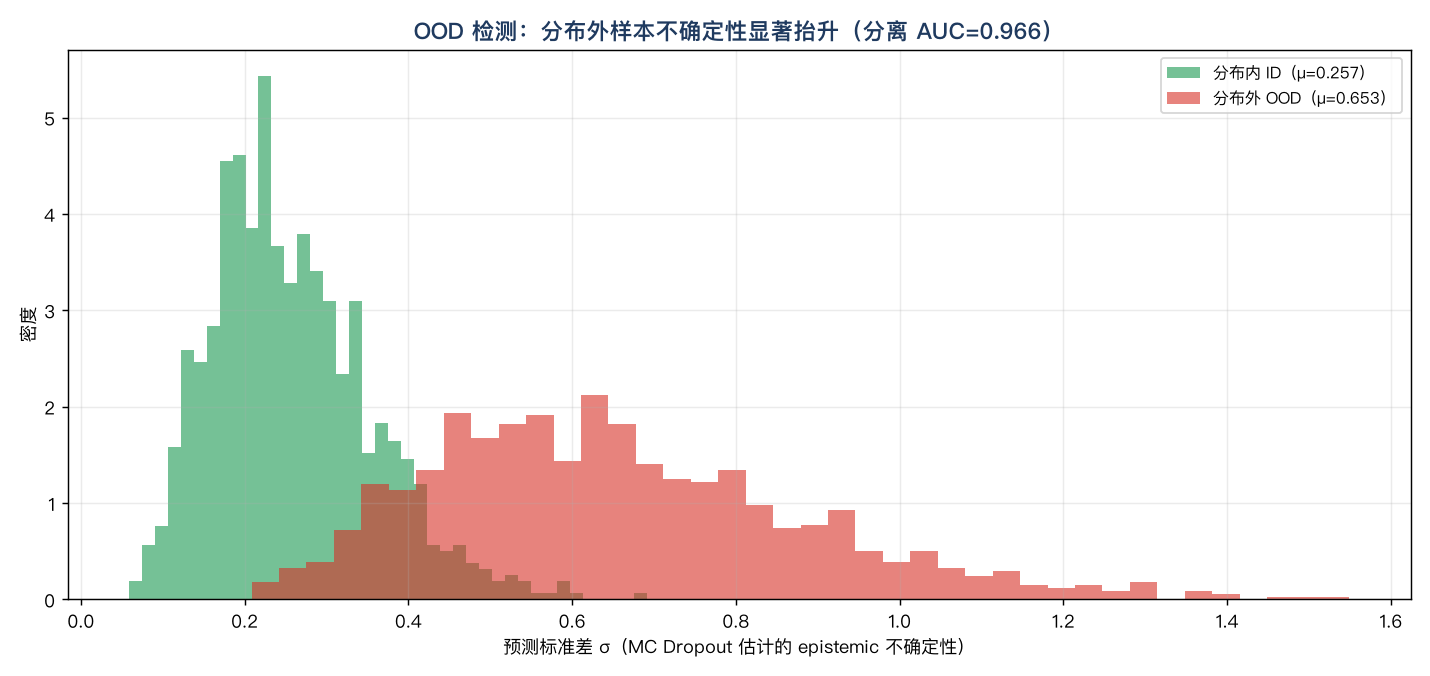
设计了一个诚实的对照:分布内样本用标准正态因子,分布外样本用”均值偏移 + 尺度膨胀”的协变量漂移(模拟真实市场里的 regime 切换或新股)。MC Dropout 给出的不确定性上,两者完全分得开:
- 分布内样本平均 σ = 0.257
- 分布外样本平均 σ = 0.653(翻了 2.5 倍)
- 用 σ 当 OOD 分数做排序,分离 AUC = 0.966
这意味着你不用另训一个异常检测模型——神经网络自己输出的不确定性就是现成的 OOD 警报。实践中,如果某天你的因子输入整体落到高 σ 区,就该意识到”模型在瞎猜”,主动缩表。
四、结论二:选择性预测——弃投最不确定的 30%,混合池 RMSE 降 40%#
把 ID 和 OOD 混成一个 2000 样本池(模拟”大部分正常、混进一批看不懂的”的真实部署),按 σ 从低到高排序,逐步弃投最不确定的样本,看保留子集的 RMSE:
- 全样本 RMSE = 1.341
- 弃投最不确定 30% 后,保留子集 RMSE = 0.801(降 40%)
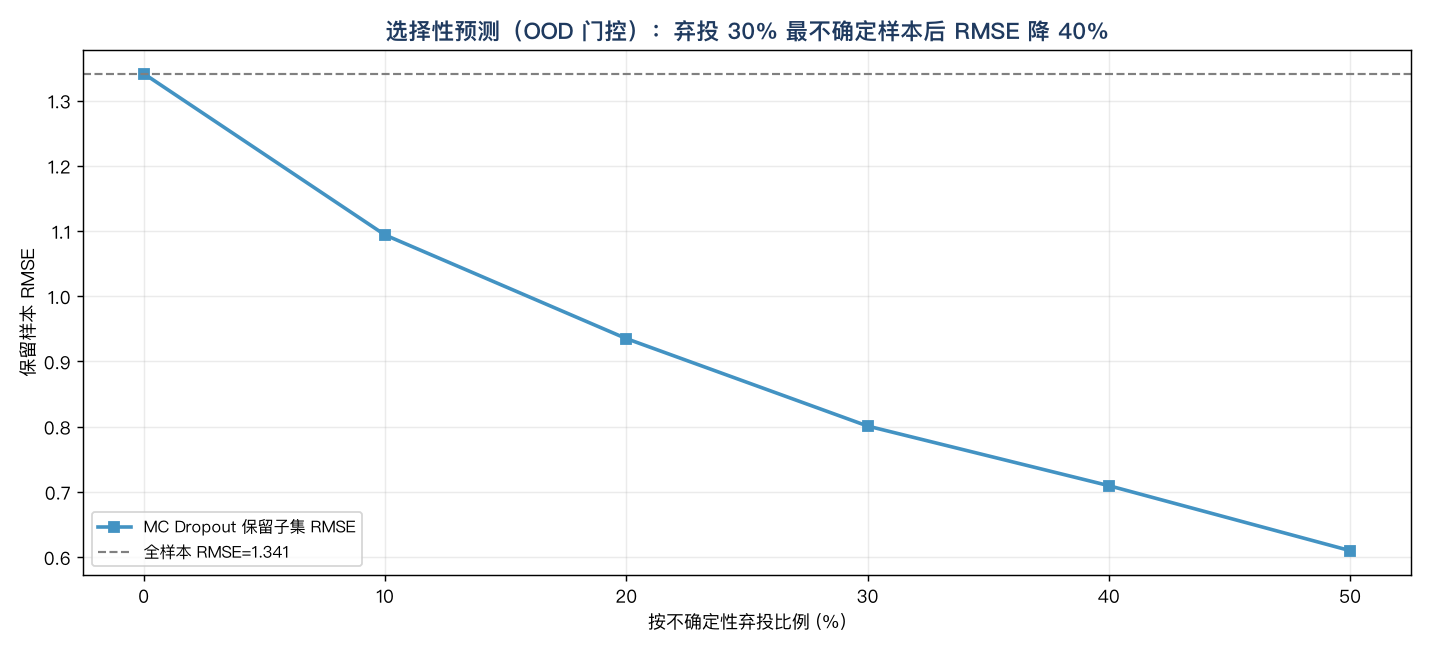
这是一个可以直接搬进组合构建的动作:把 MC Dropout 的 σ 当成”置信度”,只对高置信预测建仓,低置信的要么空仓要么减仓。代价只是每个样本多跑 T 次前向(便宜)。
五、结论三:校准的坑——MC Dropout 只建模”认知”不确定性#
这是最容易踩的雷。MC Dropout 的 σ 是 epistemic(认知)不确定性:来自”训练数据没覆盖到的区域”。它不建模 aleatoric(偶然)不确定性:来自”数据本身固有的噪声”(比如收益里那 35% 的同方差噪声)。
后果很直接:用纯 epistemic σ 构造 90% 预测区间,实际只覆盖了 50% 的真实样本——严重欠覆盖。修复方法干净:
# 用训练集残差估计 aleatoric 噪声(同方差近似)
ytr_hat, _ = forward(Xtr, params, dropout_on=False)
sigma_aleat = np.std(ytr - ytr_hat)
# 每条 MC 路径叠加一次 aleatoric 噪声,再取分位构造区间
preds_total = preds_epistemic + rng.standard_normal(preds_epistemic.shape) * sigma_aleat叠加后,90% 区间的实际覆盖率从 50% 拉回到 89.3%,50%/70%/80%/90%/95% 各级别几乎贴着完美校准线。
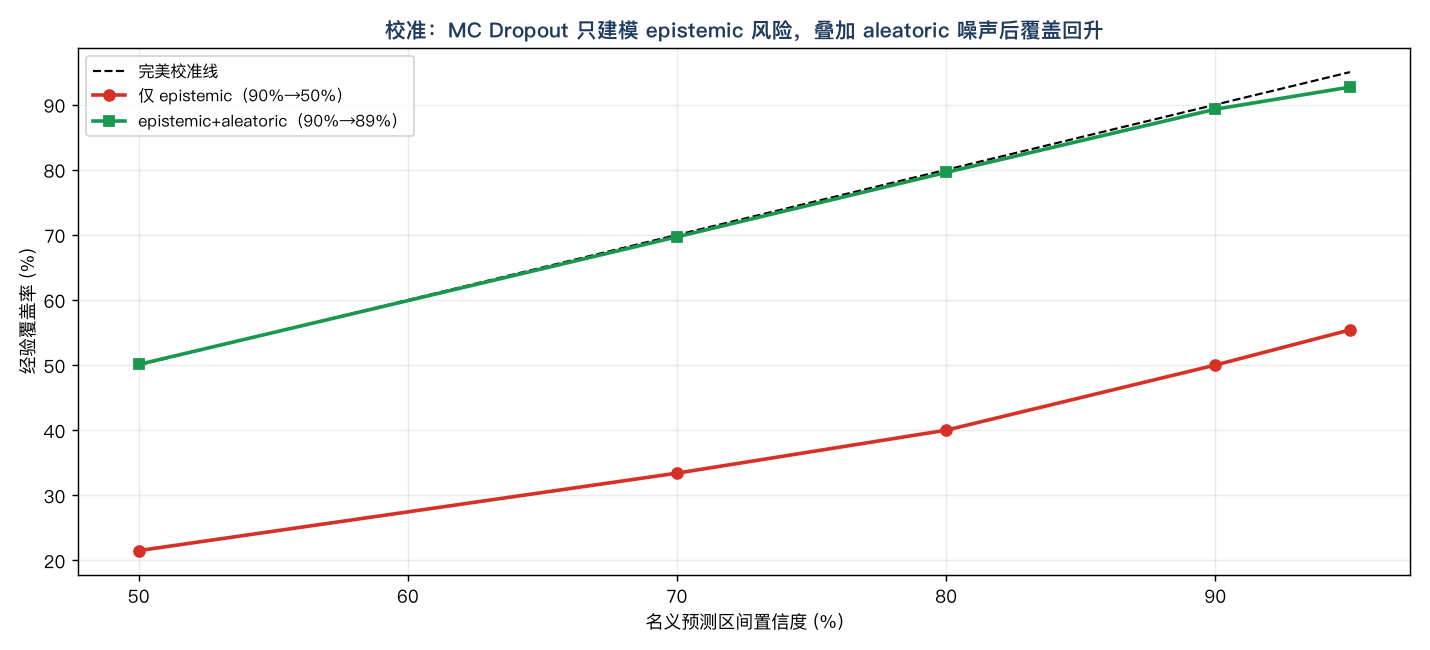
落地要点:如果你的预测目标是波动率、收益这类噪声天然很大的量,MC Dropout 的 σ 不能直接当风险区间,必须显式加回 aleatoric 项,否则会系统性低估风险。
六、结论四(诚实边界):epistemic σ 不预测”单样本误差”#
很多人误以为”不确定性高的样本 = 这个样本会错得狠”。在 iid 同方差设定下,我的实验打脸了这一点:
- epistemic σ 与单样本 |误差| 的相关系数只有 r = 0.075(几乎无关)
- 按 σ 分箱看平均 |误差|:低 σ 箱 0.441、高 σ 箱 0.748,虽有单调上升趋势,但整体很弱
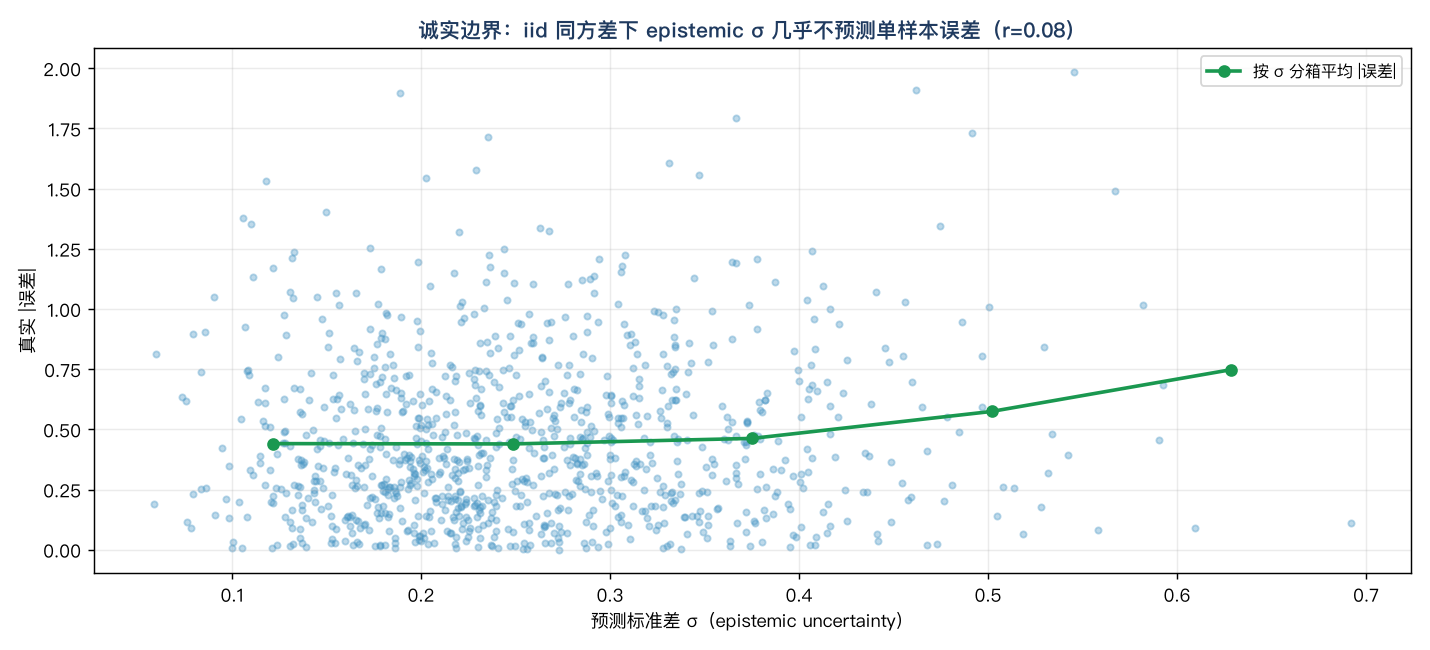
真正让 MC Dropout 的 σ 暴涨的是协变量漂移(OOD),而不是”某只普通股票刚好会跌”。换句话说:epistemic 不确定性回答的是”这个输入区域我熟不熟”,不是”这只票明天涨不涨”。把它用对地方(OOD 门控、选择性预测、regime 监控)才值钱,拿去当逐笔误差预测反而会失望。
七、怎么落地到你的因子流程#
一个最小可用的改造,几乎零成本:
- 训练时照常用 dropout(你已经用了)。
- 推理时别关 dropout,对每只股票跑 T=50 次前向,存下均值
μ和标准差σ。 - 组合层:用
μ/σ(或μ · sigmoid(kσ)形式)当有效信号,天然对低把握预测降权。 - 风控层:全市场平均
σ突破阈值 → 触发缩表;单样本σ超阈值 → 该票弃投。 - 区间层:记得加回 aleatoric 噪声再报风险区间(结论三的修复)。
复杂度上,T=50 次前向 ≈ 推理慢 50 倍但仍是毫秒级,对日频/周频因子完全可承受;如果用 Deep Ensemble 要训 K 个独立模型,MC Dropout 只在原地多跑前向,性价比极高。
八、结语与边界#
MC Dropout 是”穷人版的贝叶斯神经网络”——它用一次训练、原地多次前向,换来了宝贵的 epistemic 不确定性。本文在受控实验里给出的四个结论是配套的:它擅长 OOD 检测(AUC 0.97)和选择性预测(弃投 30% → RMSE 降 40%),但不擅长当逐笔误差预测器(r=0.08),且单独用会系统性低估风险区间(90%→50%)除非补上 aleatoric 项(回到 89%)。
需要诚实标注的边界:实验是合成受控场景,用来演示机制,不是真实盘回测;真实市场里 aleatoric 往往异方差(不同股票噪声不同),同方差近似会更粗糙,需要分簇或另训一个噪声头。但核心套路——“训练带 dropout、推理也带 dropout、用方差当不确定性、用不确定性当门控”——是可以直接搬进你现有深度学习因子管线的。