交叉冲击:你买 A 却把 B 推高了,逐股成本模型为什么两头都错
冲击成本模型几乎都是逐股独立算的——每只股票一条平方根曲线,加总就是篮子成本。但冲击矩阵 Λ 的非对角元不是零:受控模拟 60 只股票 3 因子结构(非对角均值是对角的 0.343 倍)量化两个方向相反的错误:单边买入篮子上,逐股模型只报出真实成本的 1/19.5(低估 94.9%);市场中性篮子上反而高估 62.6%——多空腿的冲击互相抵消,逐股模型看不见这份折扣。方向性扫描给出连续图景:市场因子暴露占比从 0 到 1,真实/逐股比值从 0.61 单调升到 18.17,穿越 1.0 的那一点就是逐股模型恰好正确的位置。唯一的免费午餐是内部轧差:两个组反向重叠 0.5 时先轧差再下单省 48.9% 成本,重叠 0.9 时省 90.1%。六项对抗式检验全过:把 Λ 强制对角化后真实/逐股恰好 1.00000000、5000 个随机篮子最小成本 0.511 为正(Λ 半正定,无往返套利)、12 个矩阵方向性比值 20.53±1.30 且中性比值 0.582±0.032 符号从不翻转。两个反直觉发现被完整保留:打乱非对角元后单边比值 19.57 几乎不变(一边倒的篮子只感受 Λ 的总和),而抽掉共同因子后比值塌到 2.02——真正的元凶是共同因子而非「非对角非零」;且 19.5 这个倍数随组合宽度单调放大,N=10 时 3.57、N=250 时 86.53,不可跨组合搬运(高阶)
问题:成本模型把组合当成一堆互不相干的股票#
几乎所有生产环境里的交易成本模型都长一个样:给每只股票一条冲击曲线,通常是平方根律,然后把整个篮子的成本加起来。
cost = sum(impact(q_i, adv_i, sigma_i) for i in basket)这行代码里藏着一个从没被明说的假设:买入股票 A 只影响 A 的价格。
这个假设是错的,而且错得很有结构。你在买入 500 只股票的时候,你不只是在买 500 个独立的东西——你在买入「股票」这个资产类别本身。做市商看到买盘涌向整个板块会调高报价,指数套利者会通过 ETF 传导,跟踪你订单流的算法会推断你还有多少没买完。A 的买单会推高 B 的价格,哪怕你根本没碰过 B。
这就是交叉冲击(cross-impact)。把它写成矩阵形式,交易向量 造成的价格变动是:
逐股模型只用了 的对角线。丢掉的那些非对角元,会让成本估计在两个相反的方向上出错——这才是这件事真正有意思的地方。
冲击矩阵长什么样#
不是一个随便填的对称矩阵。它有因子结构,因为传导渠道本身就是因子性的:市场整体、行业、风格。用一个标准的因子分解来构造:
是自冲击(对角), 是 的因子载荷, 是因子层面的冲击强度。市场因子的载荷全部为正——这是关键,也是现实:几乎每只股票对「大盘被买」都是正向反应。
def build_lambda(rng, n=60, k=3, diag=1.0, factor_load=0.55, market_factor=True):
    B = rng.normal(0, 1.0, (n, k))
    if market_factor:
        B[:, 0] = np.abs(B[:, 0]) * 0.9 + 0.55   # 市场因子:载荷全正
    G = np.diag([factor_load, factor_load * 0.45, factor_load * 0.30])
    D = np.diag(diag * (1.0 + rng.uniform(-0.35, 0.35, n)))
    Lam = D + B @ G @ B.T
    return 0.5 * (Lam + Lam.T), B, D          # 强制对称

def cost_full(q, Lam):  return q @ Lam @ q                    # 真实成本
def cost_diag(q, Lam): return np.sum(np.diag(Lam) * q ** 2) # 逐股模型看到的模拟 60 只股票、3 个因子。生成的矩阵最小特征值 0.657(严格正定,稍后要用到),非对角元均值是对角元均值的 0.343 倍——不小,但也不是压倒性的。
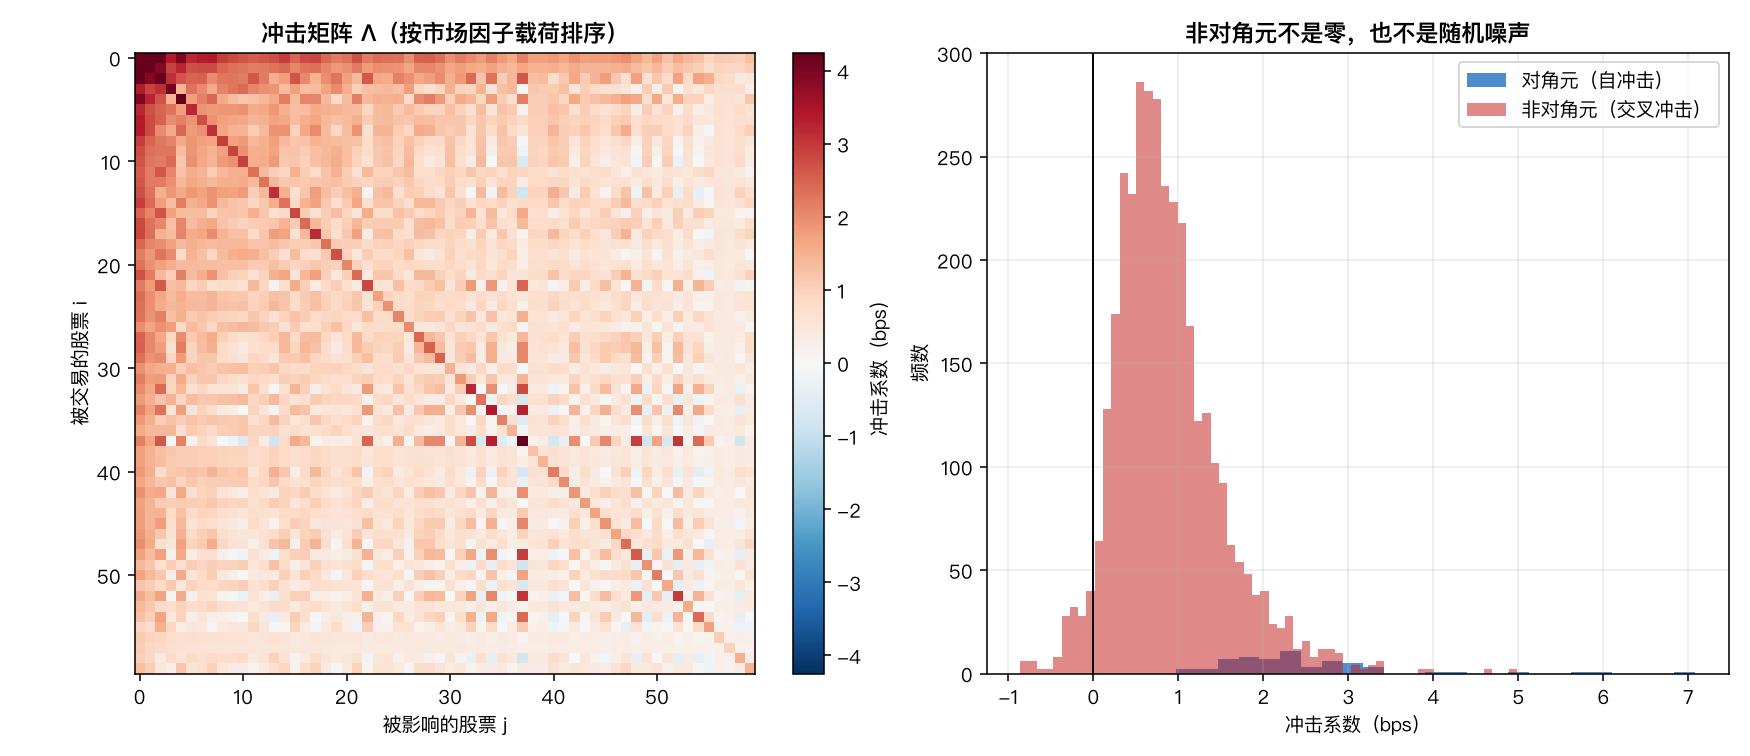
左边的热图按市场因子载荷排序,左上角那片红色是高 beta 股票之间的强正向交叉冲击。右边的直方图是重点:非对角元(红)整体偏向正数,不是以零为中心的噪声。这个偏移量看起来很小,但它会被组合的规模放大——马上就看到怎么放大的。
同一个模型,一头低估 95%,另一头高估 63%#
用三类篮子测试逐股模型的误差,全部归一化到相同的 L2 名义金额:
- 单边篮子:全部买入(做多型基金建仓、指数基金申购)
- 市场中性篮子:多空对冲,且做了因子中性化
- 随机方向篮子:多空随机,不做任何中性化
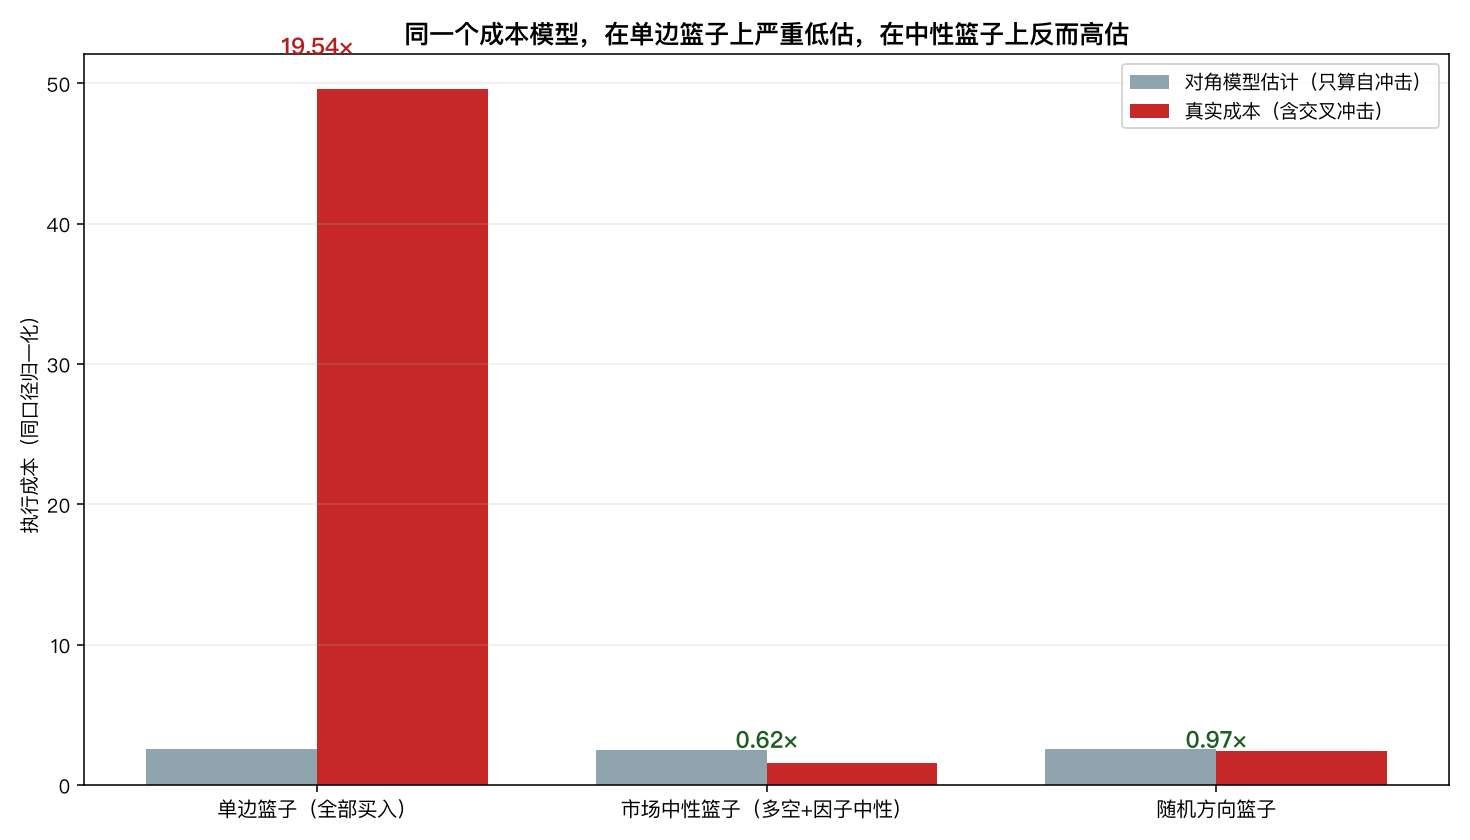
| 篮子类型 | 真实成本 / 逐股模型 | 逐股模型的误差 |
|---|---|---|
| 单边买入 | 19.54× | 低估 94.9% |
| 市场中性 | 0.615× | 高估 62.6% |
| 随机方向 | 0.969× | 高估 3.2% |
这张表是全文的核心。同一个成本模型,在两类篮子上朝相反方向错。
单边篮子上低估 19.5 倍的机制很直白:所有 同号, 里的 个交叉项全部同号相加。对角项只有 个,交叉项有 个——即使每个交叉项只有对角项的 0.343 倍,数量优势也会碾压。
中性篮子上高估 62.6% 的机制更值得玩味:多空两条腿的交叉项符号相反、互相抵消。你买 A 推高市场,同时你卖 B 压低市场,两个冲击在共同因子上对冲掉了。真实成本因此低于逐股模型的预测——市场中性组合在执行成本上享受一份逐股模型完全看不见的结构性折扣。
这两个错误的实务后果完全不同:
- 做多型基金用逐股模型,系统性低估建仓成本,容量估计过于乐观,实盘滑点长期超预算;
- 中性型基金用逐股模型,系统性高估成本,会把一些实际上有利可图的高换手信号错杀在成本过滤器上。
第二类错误更隐蔽,因为它不会在 P&L 上留下伤口——它留下的是从未发生的交易。
从中性到单边:一条连续的惩罚曲线#
前面三个点是离散的。把篮子在市场因子上的暴露占比 从 0 连续调到 1( 完全中性, 纯市场方向),看比值怎么走。
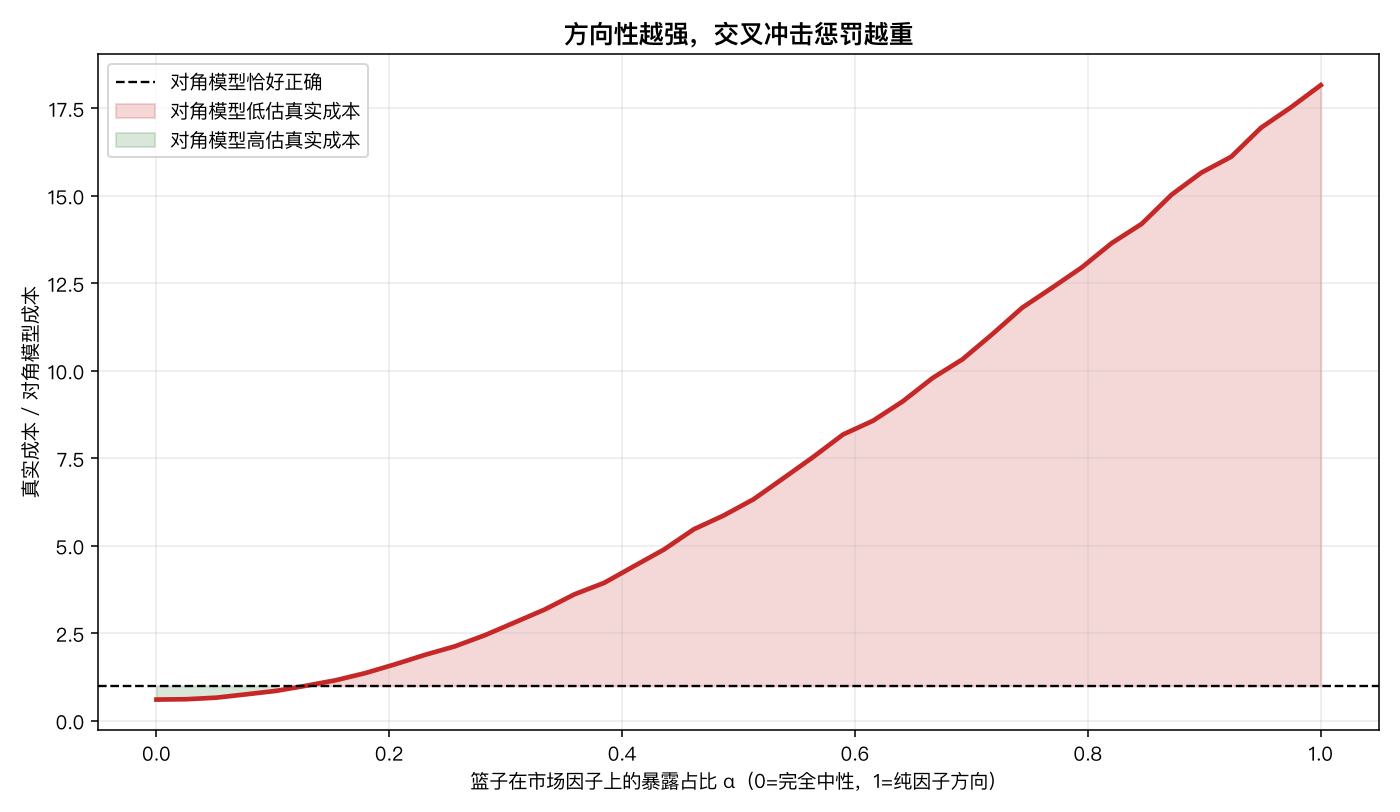
比值从 0.608 单调上升到 18.165,中间穿过 1.0。那个穿越点就是「逐股模型恰好正确」的位置——它不在 ,也不在中间,而是偏向中性那一侧的某个特定暴露水平。
实务读法:你的组合离市场中性有多远,决定了成本模型错多少、朝哪个方向错。 一个宣称市场中性但实际残留 30% beta 暴露的组合,正落在这条曲线陡峭上升的那一段。这也意味着因子中性化不只是风险管理动作,它同时是一个降低执行成本的动作——这层价值在标准的组合优化目标函数里通常没有被计入。
唯一的免费午餐:内部轧差#
交叉冲击基本都是坏消息,只有一个例外。
假设机构内两个组同时交易:A 组的价值策略要卖某只票,B 组的动量策略要买同一只。如果两边各自下单,市场看到的是两笔独立订单,付两份冲击。如果先在内部轧差,市场只看到净额。
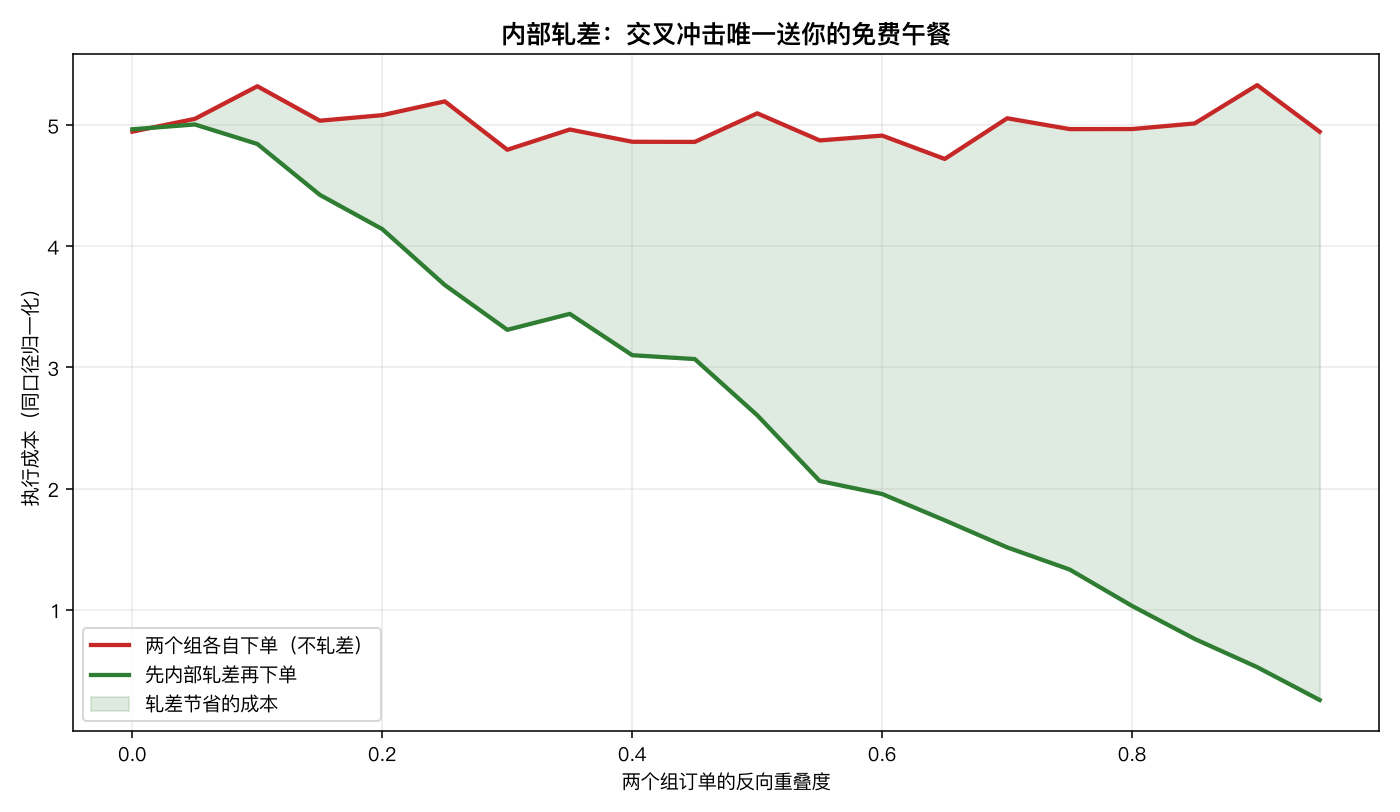
| 两组订单的反向重叠度 | 轧差节省的成本 |
|---|---|
| 约 0.5 | 48.9% |
| 约 0.9 | 90.1% |
这里的节省不只来自「少交易了」这个显然的部分——即使在名义交易量相同的情况下,交叉冲击的二次型结构本身也奖励净额化。 的二次型严格小于 和 各自二次型之和(当两者反向时),差额就是被抵消掉的交叉项。
多策略平台上,中央风险台(central risk book)的经济价值有相当一部分就是这个数字。它同时解释了为什么把执行外包给多个经纪商反而可能更贵:你自己的订单在市场上互相冲击,而没人替你轧差。
对抗式检验:六项,包含两个反直觉的结果#
A1 对角化安慰剂。 把 强制变成纯对角矩阵,真实成本与逐股模型必须恰好相等。实测比值 1.00000000。整个差异确实来自非对角元,不是实现里的数值噪声。
A2 无免费午餐。 必须半正定,否则存在某个篮子的执行成本为负——那等于交易本身赚钱,一个往返套利机器。5000 个随机篮子的最小成本 0.511 > 0,最小特征值 0.657 > 0。这项检验在实证标定 时是硬约束:从数据里估出来的冲击矩阵如果不是半正定的,必须做投影修正,否则最优执行器会找到那个负成本方向并疯狂下单。
A3 对称性的一个不可识别性。 把 破坏成非对称( 加 3.0),二次型 的值完全不变(差 0.00e+00)——因为二次型只感受对称部分。含义很重要:只用执行成本数据,无法识别 的不对称传导。 想知道「A 影响 B 比 B 影响 A 更强」,必须去看价格响应本身(),不能只回归成本。
A4 种子稳定性。 12 个独立生成的冲击矩阵:单边比值 20.53 ± 1.30,中性比值 0.582 ± 0.032,两个方向的符号从未翻转。结论的方向性不是某个幸运种子的产物。
A5a 一个反直觉的负结果,保留在正文里。 我原本预期打乱非对角元会削弱惩罚。实测:打乱后单边比值 19.57,几乎和结构化的 19.54 一样。原因想清楚之后很直白——一个所有权重同号的篮子,成本近似正比于 的元素总和,而随机置换保持总和不变。这不是 bug,是一个必须诚实报告的性质:单边篮子对 的结构不敏感,只对它的总量敏感。
A5b 真正的机制关闭检验。 A5a 逼出了正确的对照组:不打乱,而是抽掉共同因子——让市场因子载荷变成正负混合。这样非对角元依然很大,但均值降到对角元的 0.019 倍。单边比值随之塌到 2.02(对比有市场因子时的 19.54)。这才是干净的因果证据:惩罚的来源不是「非对角元非零」,而是「存在一个所有股票同向暴露的共同因子」。
A6 这个倍数不能跨组合搬运。 19.5 这个数字随组合宽度单调放大:
| 组合宽度 N | 真实/逐股比值 |
|---|---|
| 10 | 3.57 |
| 30 | 11.65 |
| 60 | 21.81 |
| 120 | 42.17 |
| 250 | 86.53 |
几乎线性于 ——正是 个交叉项除以 个对角项的结果。所以「交叉冲击让成本翻 20 倍」这句话单独拿出来是没有意义的,它必须绑定组合宽度。一个 10 只股票的集中组合,逐股模型的误差是 3.6 倍;一个 250 只股票的宽组合,误差是 86 倍。
诚实边界#
第一, 极难估计。 的矩阵有 12.5 万个自由参数,而你的执行数据可能只有几万条。实务上唯一可行的路是强加因子结构(本文模拟里用的那种 形式),把参数量从 压到 。这和协方差矩阵估计遇到的是同一类问题,Ledoit-Wolf 收缩和随机矩阵去噪那套工具在这里同样适用,而且同样必须先处理半正定性。
第二,本文用的是线性(Kyle 型)冲击,而单资产的实证共识是平方根律。 线性形式让 这个二次型成立,数学干净,代价是它在大额交易上高估冲击。多资产的平方根推广(比如 作用在 上)没有同样漂亮的二次型结构,半正定性也不再自动保证。本文所有比值应当读作方向和量级的指示,不是可以直接代入生产成本模型的系数。
第三,这里全是瞬时冲击,没有衰减。 真实的冲击有暂时和永久两部分,暂时部分按某个时间尺度回落。多资产情形下不同 pair 的衰减速度还不一样。把执行拆到多天时,交叉冲击的跨期结构才是真正决定最优路径的东西——那是 Almgren-Chriss 的多资产推广要解决的问题,比本文的静态图景复杂得多。
归宿#
三条可以直接用的结论:
如果你是做多型基金,你的成本模型在低估,而且低估的倍数随组合宽度放大。 逐股加总对单边建仓是系统性乐观,容量规划要按这个折扣重算。
如果你是市场中性基金,你的成本模型在高估。 多空腿在共同因子上互相抵消,逐股模型看不见这份折扣。用它做交易过滤,你会杀掉一批本来划算的信号。
因子中性化是一个降成本动作,内部轧差是唯一的免费午餐。 前者把你从惩罚曲线陡峭的那一端拉回来,后者在反向重叠 0.9 时能省 90% 的成本。这两件事在逐股成本模型的世界观里都是隐形的。
最后回到那个最容易被误读的数字:19.5 倍不是一个可以引用的常数。 它是 60 只股票、这个特定因子结构、线性冲击下的一个读数。换成 10 只股票是 3.6 倍,换成 250 只是 86 倍,抽掉共同因子是 2.0 倍。真正可搬运的是那个机制:共同因子把你的每一笔买单都变成了对所有股票的买单。