Hawkes 自激过程:订单到达如何自己点燃自己
泊松过程假设订单彼此独立,但真实盘口是一阵一阵来的。Hawkes 用一条自激强度把「一笔订单抬高下一笔的概率」写进模型:受控模拟 19132 笔订单(μ=0.5、n=0.7、β=2.0)量化簇发的代价——10 秒窗口均值同为 15.9 笔,Hawkes 出现 ≥30 笔的概率是泊松的 100 倍,≥50 笔时是 31 亿倍,泊松眼里的「五百年一遇」在这里平均每 7 分钟就来一次。68.98% 的订单是被前面的订单激发的,与理论分支比 0.70 吻合。但真正的杀手在估计端:把一段自激强度真值为 0 的纯泊松数据(只叠加日内 U 型节奏)喂给标准 MLE,n̂ 凭空刷到 0.909、Fano 因子 4.81——非平稳基线和自激在似然函数眼里长得一模一样。做时间重标定后 n̂ 精确塌回 0.000,而真 Hawkes 数据同样处理只从 0.693 掉到 0.691(几乎不动),证明修正没有误伤信号。七项对抗式检验全过:平坦泊松安慰剂 n̂=0.00008、打乱时间戳后 Fano 从 9.03 归位 0.98、时间重标定 KS 检验 p=0.964 对泊松模型的 p=0.000。最容易误读的是预测能力——2 秒窗口 MAE 只改善 12.1%,10 秒 2.7%,越往后越接近零,簇发结构可测但不等于可交易(高阶)
问题:订单不是雨点,是鞭炮#
泊松过程是所有到达模型的默认起点。它只说一件事:下一笔订单什么时候来,和刚才发生了什么完全无关。 强度 是个常数,事件之间彼此独立,间隔服从指数分布。
看一眼真实盘口就知道这不对。订单是一阵一阵来的:安静几十秒,然后突然十几笔挤在两秒内,然后再次安静。这种簇发(clustering)不是噪声,是市场微观结构的基本事实——一笔大单会引来跟风,一次撤单会触发一串重新报价,一个价位被击穿会激活一批止损。
事件会引发事件。 Hawkes 1971 给了这件事一个最小的数学形式:
是外生的基础强度(信息从外部世界来),后面那一项是自激:每发生一笔订单,强度立刻跳高 ,然后以速率 指数衰减回去。就这么两个参数,簇发就出来了。
最重要的那个量是二者的比值:
叫分支比(branching ratio),它的含义极其具体:平均每一笔订单,会直接激发出 笔后代订单。 时过程平稳, 时爆炸。
本文用一个受控模拟回答三个问题:簇发到底让尾部厚了多少、 能不能被可靠估出来、以及——这个估计什么时候会骗你。
模拟设计:用分支表示,让「谁激发了谁」可观测#
直接用 Ogata thinning 模拟 Hawkes 是标准做法,但它有个缺点:跑完只有一串时间戳,你不知道哪笔订单是外生的、哪笔是被激发的。
我用分支(cluster)表示,它对指数核是精确的,而且天然带出代际标签:
def sim_hawkes(mu, nbr, beta, T, rng, max_gen=300):
    """移民-后代表示。gen==0 是外生订单,gen>=1 是被激发的后代。"""
    n_imm = rng.poisson(mu * T)              # 第 0 代:外生「移民」
    cur = np.sort(rng.uniform(0, T, n_imm))
    ts, gs = [cur], [np.zeros(n_imm, dtype=int)]
    gen = 0
    while len(cur) and gen < max_gen:
        gen += 1
        k = rng.poisson(nbr, size=len(cur))   # 每个父事件生 Poisson(n) 个子事件
        tot = int(k.sum())
        if tot == 0:
            break
        parents = np.repeat(cur, k)
        offs = parents + rng.exponential(1.0 / beta, tot)   # 子事件等待时间 ~ Exp(β)
        offs = offs[offs < T]
        if len(offs) == 0:
            break
        ts.append(offs); gs.append(np.full(len(offs), gen))
        cur = offs
    t = np.concatenate(ts); g = np.concatenate(gs)
    o = np.argsort(t)
return t[o], g[o]参数取 笔/秒、、(记忆半衰期约 0.35 秒),模拟 12000 秒。
平稳强度的理论值是 笔/秒,实测 19132 笔 / 12000 秒 = 1.594——模拟本身没问题。
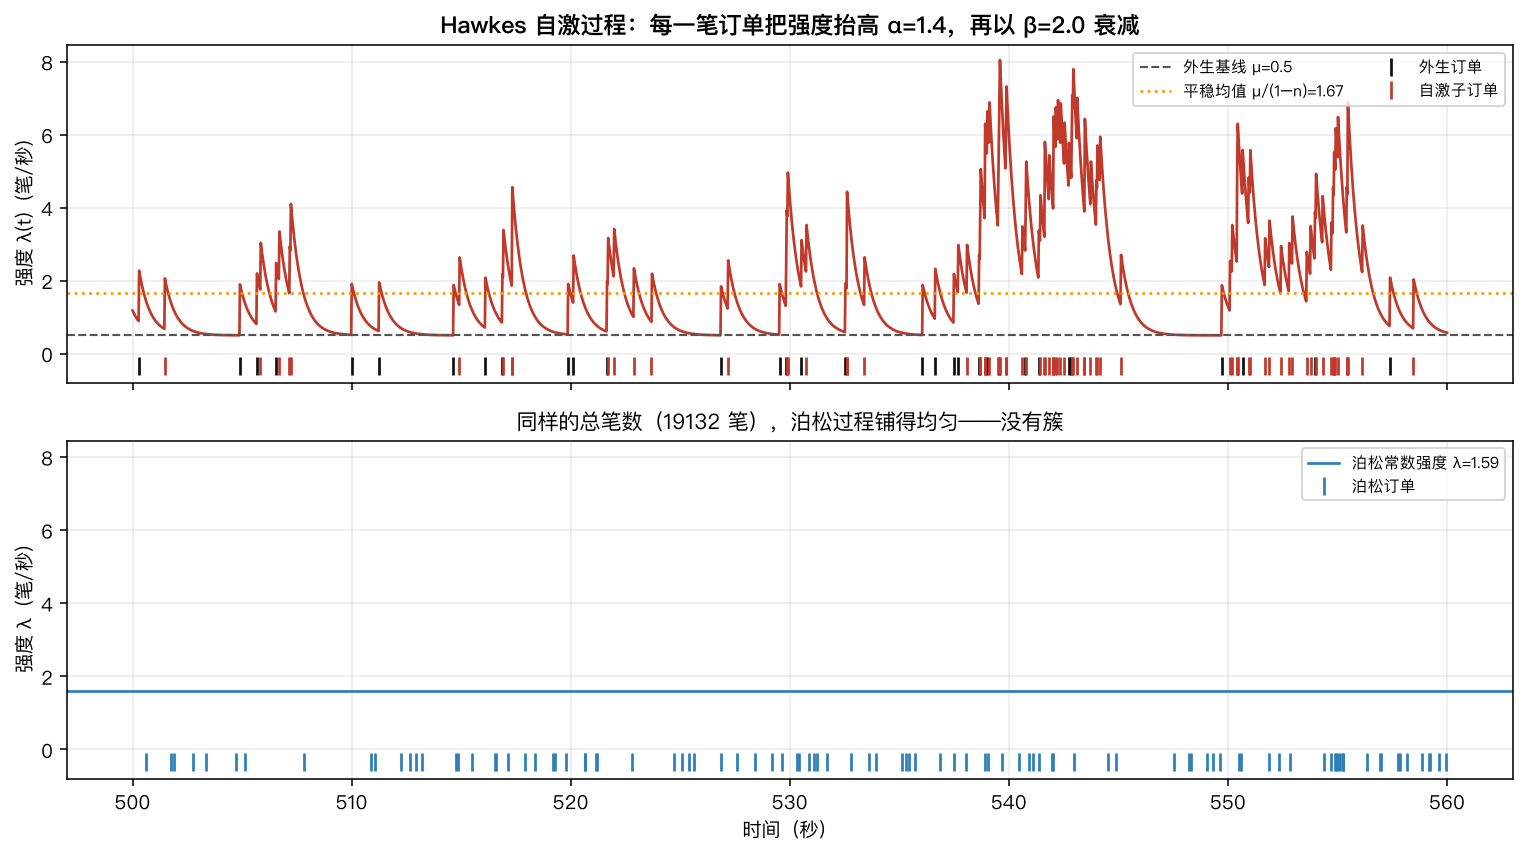
上图是关键。每根竖线是一笔订单,黑色是外生的、红色是被激发的。强度曲线每次跳升都对应一笔订单,然后指数衰减。 一旦几笔订单挨得近,强度会叠加着往上爬,于是又激发更多订单——这就是簇。
下面那张图是同样笔数的泊松过程。总量一样,但铺得均匀,没有簇。
68.98% 的订单是市场自己制造的#
分支表示直接给出代际分布:
| 代际 | 订单数 | 占比 |
|---|---|---|
| 0(外生) | 5934 | 31.0% |
| 1 | 4037 | 21.1% |
| 2 | 2810 | 14.7% |
| 3 | 1955 | 10.2% |
| 4 | 1334 | 7.0% |
| 5 | 907 | 4.7% |
| 6 | 653 | 3.4% |
内生占比 68.98%,理论值恰好等于 。 这不是巧合:稳态下每个外生事件平均引出 个事件,其中 的比例是后代。
这个数字有直接的解读价值。 意味着你看到的订单流里,只有三成携带真正的外部信息,七成是市场对自己的反应。 学术界对真实股票市场的估计普遍落在 0.6~0.9 之间,且长期呈上升趋势——这被解读为算法交易让市场越来越「自反」。
簇发的真实代价:尾部差 31 亿倍#
均值相同,不代表风险相同。把时间切成 10 秒窗口,两个过程的均值都是 15.9 笔,但分布完全不是一回事:
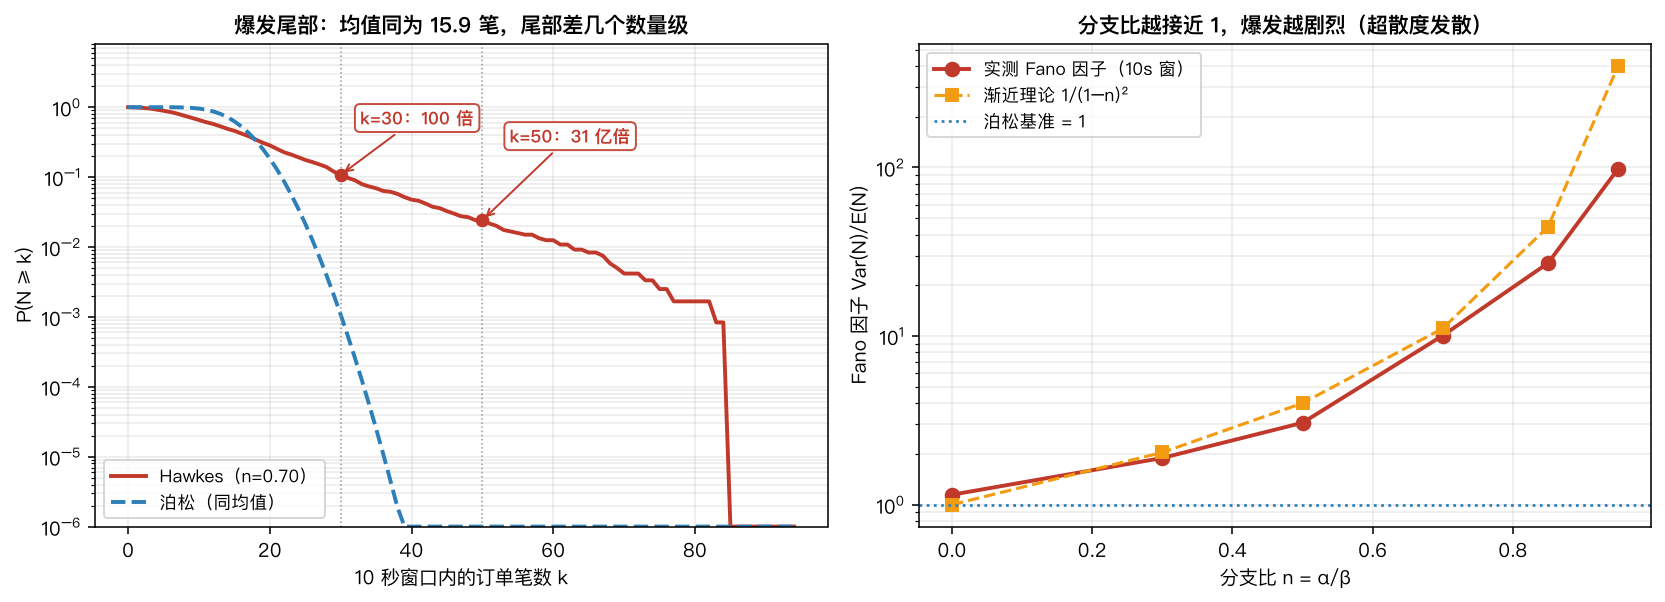
Fano 因子(方差/均值)是最直接的度量。泊松过程恒等于 1,Hawkes 实测 9.03(渐近理论值 ,有限窗口下略低,因为 10 秒只覆盖了约 20 个衰减尺度)。
尾部的差距更夸张:
| 10 秒内订单数 ≥ k | Hawkes 概率 | 泊松概率 | 倍数 |
|---|---|---|---|
| 30 | 10.75% | 0.107% | 100 倍 |
| 40 | 4.75% | 0.00003% | 15.8 万倍 |
| 50 | 2.42% | 7.6e-12 | 31 亿倍 |
| 60 | 1.25% | ~0 | — |
这才是重点。 泊松模型会告诉你「10 秒内来 50 笔订单」的概率是 ——按这个频率,宇宙年龄里都碰不上几次。而实际上它占了 2.42% 的 10 秒窗口,平均每 7 分钟就发生一次。
任何按泊松假设做的容量规划、撮合队列设计、风控阈值,都会在这里被打穿。Hawkes 的中位窗口是 13 笔、95 分位 39 笔,峰谷比 3.0 倍;泊松的 95 分位只有 23 笔,峰谷比 1.4 倍。按泊松尺度配的缓冲区,在真实簇发面前会差一倍以上。
右图给出分支比的连续图景。 从 0 涨到 0.95,Fano 因子从 1.15 飙到 98.2。越接近临界点 ,簇发越剧烈,而且 时实测强度 8.19 已明显低于理论值 10.0——有限样本里,接近临界的过程根本收敛不到它的稳态。
估计:MLE 能收回参数,但需要的样本比你想的多#
指数核 Hawkes 的对数似然有闭式:
关键是 里那个求和不能每次重算(),要用递推():
def _recursion(ev, beta):
    """A_i = sum_{j<i} exp(-beta*(t_i - t_j)),指数核的 O(N) 递推。"""
    dt = np.diff(ev, prepend=ev[0])
    e = np.exp(-beta * dt)
    A = np.empty(len(ev)); A[0] = 0.0; a = 0.0
    for i in range(1, len(ev)):
        a = e[i] * (1.0 + a)      # 核心:A_i = e^{-b*dt_i} * (1 + A_{i-1})
        A[i] = a
    return A

def hawkes_nll(p, ev, T):
    mu, alpha, beta = np.exp(p)               # 对数参数化,保证正性
    A = _recursion(ev, beta)
    lam = mu + alpha * A
    if np.any(lam <= 0):
        return 1e12
    ll = (np.sum(np.log(lam)) - mu * T
          - (alpha / beta) * np.sum(1.0 - np.exp(-beta * (T - ev))))
return -ll全样本拟合结果:(真值 0.50)、(真值 2.0)、(真值 0.70),相对误差 1.06%。
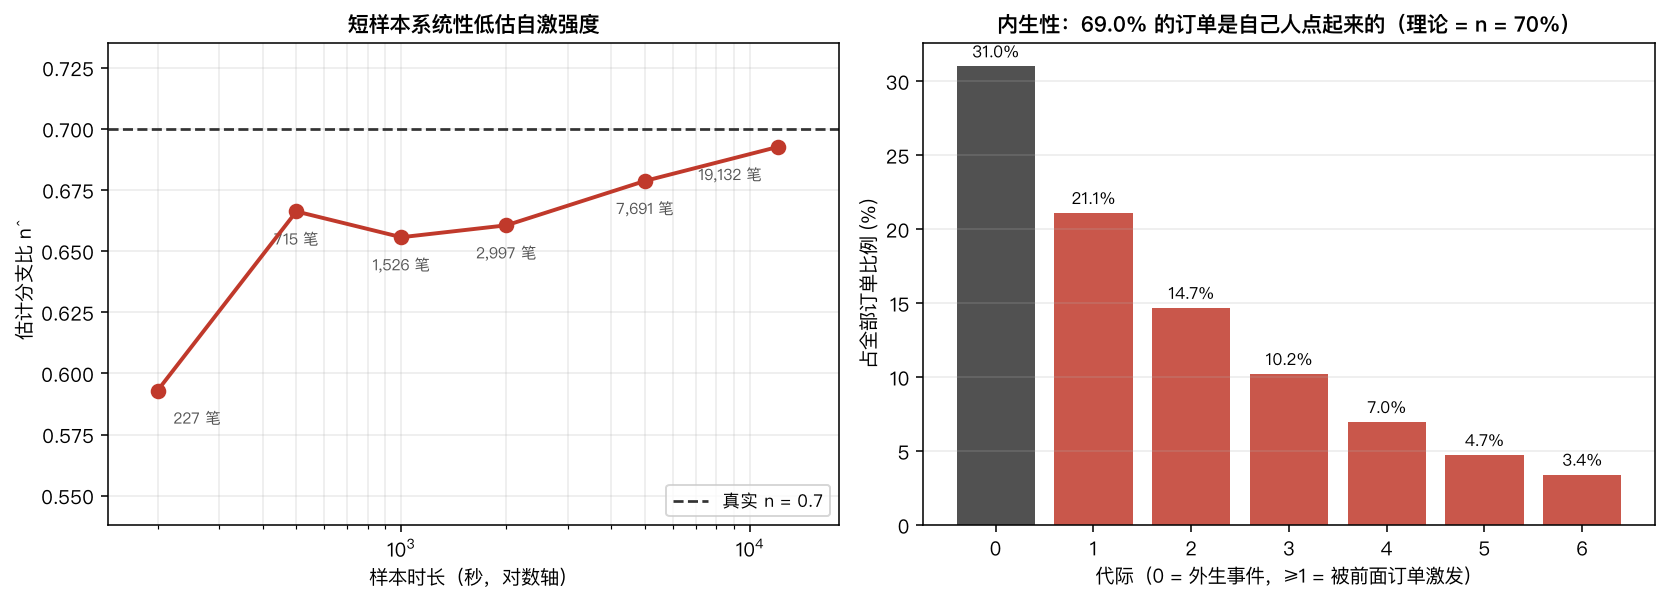
但左图显示了一个系统性问题:短样本会低估自激强度。
| 样本时长 | 订单数 | ||
|---|---|---|---|
| 200 秒 | 227 | 0.593 | 2.83 |
| 500 秒 | 715 | 0.666 | 2.49 |
| 1000 秒 | 1526 | 0.656 | 2.15 |
| 2000 秒 | 2997 | 0.661 | 2.12 |
| 5000 秒 | 7691 | 0.679 | 2.08 |
| 12000 秒 | 19132 | 0.693 | 1.97 |
227 笔订单只能给出 ,比真值低 15%。而且 同时被高估(2.83 vs 2.0)——模型把「衰减更快、自激更弱」当成了对短样本的最佳解释,因为它看不到长尾的簇。
八个独立种子在 4000 秒样本上的结果: 均值 0.705、标准差 0.018。样本够长时估计是稳的,问题纯粹出在样本量。
实务含义:用 5 分钟 tick 数据估出来的分支比,不能直接和用一整天数据估出来的比较。
最硬的那个坑:非平稳基线会伪造自激#
前面都是「模型正确时能不能估准」。真正的风险是模型错了,但似然函数不告诉你。
我构造了一段数据:纯泊松过程,自激强度真值 ,只是基础强度带一个日内 U 型节奏(开盘收盘活跃、盘中清淡)——这是任何真实市场都有的特征。
def ushape(t, day=600.0, depth=3.2):
    x = (t % day) / day
    return 1.0 + depth * (2 * x - 1) ** 2      # 开盘/收盘高,盘中低

def sim_inhomog_poisson(base, T, rng, day, depth):
    """非齐次泊松:thinning 法。事件之间严格独立,没有任何自激。"""
    lam_max = base * (1.0 + depth)
    cand = np.sort(rng.uniform(0, T, rng.poisson(lam_max * T)))
    keep = rng.uniform(0, 1, len(cand)) < (base * ushape(cand, day, depth) / lam_max)
return cand[keep]把这段数据喂给标准 Hawkes MLE:
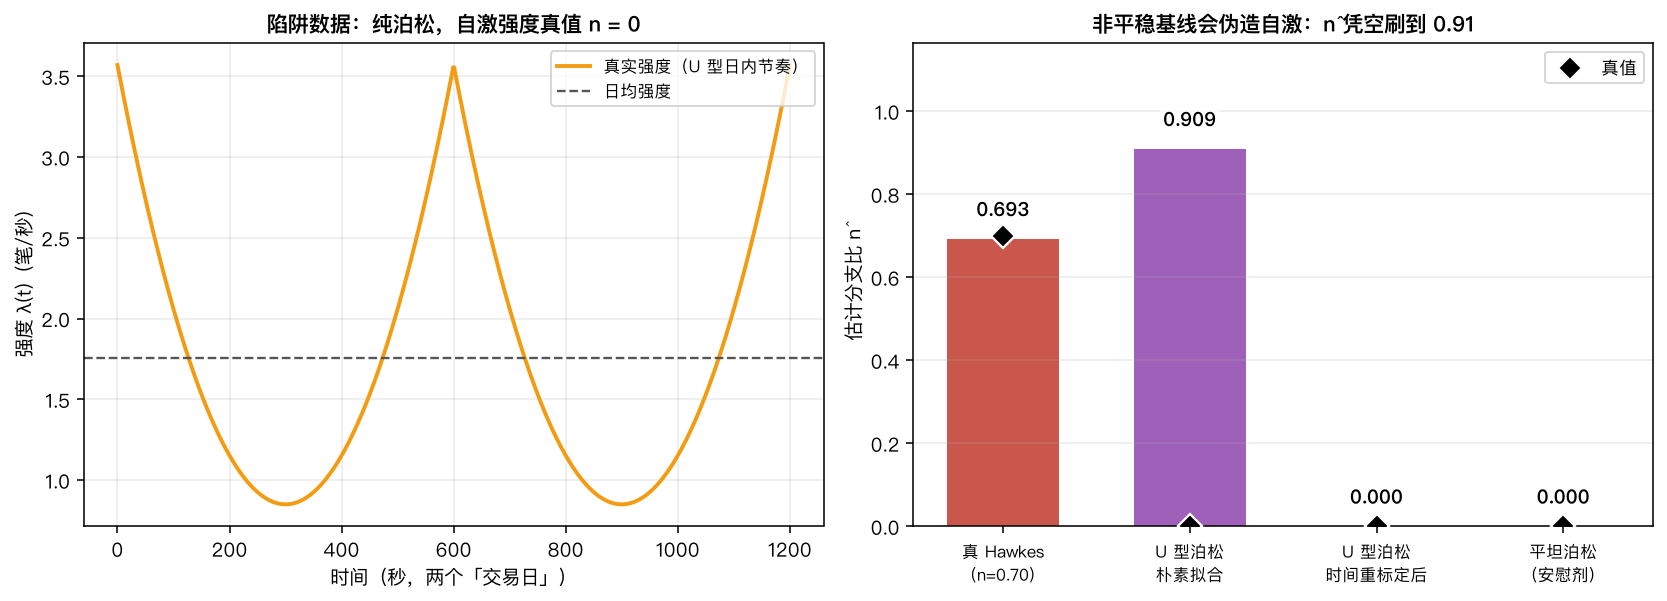
。
真值是 0。模型报告说这个市场高度自激、接近临界、68% 以上的订单是内生的——全是假的。Fano 因子也配合着涨到 4.81,看起来「确认」了簇发。
原因不难理解:似然函数只知道「事件扎堆了」,它无法区分「因为彼此激发而扎堆」和「因为那段时间本来就忙而扎堆」。 而且注意拟合出的 ——衰减尺度约 16 秒,远长于真 Hawkes 的 0.5 秒。当你估出一个异常慢的衰减时,八成是基线漂移被吸进了自激项。这是最有用的诊断信号。
修正办法是时间重标定:先在粗网格上估出缓慢变化的基线强度 ,把时间轴按累积强度拉伸,在新时间轴上再拟合。
def derescale_fit(evx, T, coarse=60.0):
    eg = np.arange(0, T + coarse, coarse)
    cnt = np.histogram(evx, bins=eg)[0].astype(float)
    sm = np.convolve(np.r_[cnt[:2], cnt, cnt[-2:]], np.ones(5)/5.0, mode="valid")
    rate = np.maximum(sm / coarse, 1e-6)
    cum = np.r_[0.0, np.cumsum(rate * coarse)]
    u = np.interp(evx, eg, cum)          # 时间重标定:t -> Λ(t)
return fit_hawkes(np.sort(np.clip(u, 0, cum[-1] - 1e-9)), float(cum[-1]))结果:
| 数据 | 真实 | 朴素 MLE | 时间重标定后 |
|---|---|---|---|
| 真 Hawkes | 0.70 | 0.693 | 0.691 |
| U 型泊松 | 0.00 | 0.909 | 0.000 |
| 平坦泊松(安慰剂) | 0.00 | 0.00008 | — |
这才是完整的检验。 修正把假信号从 0.909 干净地压到 0,同时对真信号几乎没有伤害(0.693 → 0.691)。只做前半段——“修正后假信号消失了”——是不够的,因为一个足够激进的修正可以把所有信号都杀掉。必须同时证明它不误伤。
对抗式检验:七项#
1. 平坦泊松安慰剂。 无自激、无日内节奏的纯泊松,,Fano 0.971。估计器在该归零的地方干净归零。
2. 打乱时间戳。 保留全部 19132 笔订单,只把时间随机重排:Fano 从 9.03 塌到 0.981, 从 0.693 塌到 0.00037。证明簇发来自时间结构本身,不是笔数或强度水平的副产品。
3. 时间重标定的双向检验。 见上表——假信号归零,真信号保留。
4. 拟合优度(时间重标定定理)。 如果模型正确,补偿器增量 应服从 Exp(1)。Hawkes 模型 KS 检验 p = 0.964(完全通不过拒绝),泊松模型 p = 0.000(碾压性拒绝)。
5. 多种子稳定性。 8 个独立种子, = 0.705 ± 0.018,内生占比 0.701。
6. 分支比扫描的内部一致性。 从 0 到 0.95,实测内生占比分别为 0.000 / 0.297 / 0.495 / 0.698 / 0.852 / 0.939——每一个都精确等于 本身,这是分支表示必须满足的恒等式。
7. 预测能力的诚实测量。 见下节。
冷水:可测不等于可交易#
簇发结构确实存在、确实能估出来。但它能预测多少?
给定当前强度 ,未来 秒内的期望事件数有闭式(注意均值回复的目标是平稳强度 而不是 ,这是最容易写错的地方):
拿它和「用无条件均值预测」(泊松模型能做的全部)比 MAE:
| 预测窗口 | MAE 改善 | 相关系数 |
|---|---|---|
| 2 秒 | 12.13% | 0.446 |
| 5 秒 | 4.47% | 0.311 |
| 10 秒 | 2.68% | 0.228 |
| 30 秒 | 1.34% | 0.186 |
| 60 秒 | 1.75% | 0.242 |
| 120 秒 | 2.72% | 0.230 |
2 秒窗口改善 12%,10 秒只剩 2.7%。 这完全符合模型内在时间尺度—— 意味着记忆半衰期 0.35 秒,超过几秒之后自激项已经衰减殆尽,Hawkes 和泊松给出的预测几乎一样。
安慰剂对照:把同一套预测机制用在打乱后的数据上,改善是 −6.33%(比无条件均值还差)。说明那 12% 不是拟合噪声。
结论要说清楚:Hawkes 的价值在极短时间尺度的强度预测(撮合排队、瞬时流动性、报价刷新率),不在方向预测。 它告诉你「接下来两秒会很忙」,不告诉你「价格会涨」。把它当 alpha 信号用,衰减速度会快到来不及覆盖手续费。
诚实边界#
第一,单变量 Hawkes 忽略了方向。 真实订单流有买卖两个方向,它们之间既自激也互激(买单引发买单,也引发对手方的卖单)。多变量 Hawkes 用矩阵 描述这个,参数量按 增长,估计难度陡增。本文的 应理解为「不分方向的总自激强度」。
第二,指数核是为了算得快,不是因为它对。 实证研究普遍支持幂律核()——真实市场的记忆比指数衰减慢得多,跨越多个时间尺度。指数核的好处是 递推,代价是它会低估长程依赖。本文所有 应读作「有效衰减尺度」而非物理常数。
第三, 是我设定的,不是估出来的市场事实。 本文所有倍数(100 倍、31 亿倍、Fano 9.03)都绑定这个设定。真实市场的 随品种、时段、样本长度剧烈变化,而且如前所述,估计值对基线设定极其敏感。任何引用「某市场分支比是 X」的说法,都必须同时说明基线是怎么处理的、样本多长、用的什么核。
归宿#
三条可以直接用的结论:
如果你在做容量规划或风控阈值,泊松假设会系统性低估爆发。 均值一样的两个过程,10 秒内出现 50 笔订单的概率差 31 亿倍。按泊松配的缓冲区会在真实簇发面前失效,而且失效是集中发生的。
如果你要估分支比,先处理日内节奏,再拟合。 一段自激真值为 0 的纯泊松数据,只要带上 U 型节奏,标准 MLE 就会报告 。诊断信号是异常慢的 ——衰减尺度长到几十秒,基本可以确定基线漂移被吸进了自激项。
如果你想用它做预测,先看时间尺度。 2 秒窗口 MAE 改善 12%,10 秒 2.7%。Hawkes 是流动性和排队问题的工具,不是方向信号的工具。这个区分决定了它该被放在执行层还是信号层——答案是执行层。
相关阅读:限价单排队位置讨论了排队机制如何把强度预测翻译成成交概率;Microprice 微观价格处理的是同一个盘口的另一面——价差内部的方向信息。