深度均衡模型时序预测:用不动点迭代替代层层堆叠
堆 50 层网络,参数就翻 50 倍——深度和参数量被死死绑在一起。深度均衡模型(DEQ)换一条路:只训练「单层变换」f_θ,把隐藏状态定义为它的不动点 z* = f_θ(z*, x),用求根代替层层堆叠。本文用 numpy 从零实现有界 tanh 型 DEQ,在「单层算子反复作用」生成的 4186/1794 条合成时序上证明:DEQ 用 1705 个参数达到 R²=0.867,与 19345 个参数(11 倍)的 16 层独立深网精度相同(0.873),而线性基线仅 0.701;不动点约 3–6 步即收敛,推理迭代越多模型越深。附完整 numpy 实现与四张真实计算图。
深度神经网络有个恼人的恒等式:网络越深,参数越多。堆 50 层,参数量就翻 50 倍——因为每一层都有自己独立的权重。这让「想要更深」和「想要更省」成了一对零和博弈。2019 年的深度均衡模型(Deep Equilibrium Model, DEQ)把这个绑定一刀切断:它只训练一个变换 f_θ,把隐藏状态 z 定义成 f_θ 的不动点 z* = f_θ(z*, x),用求根(而不是层层堆叠)得到「无限深」的表示。本文用 numpy 从零实现 DEQ,并在一组合成时序预测任务上诚实度量它到底省不省、深不深。
一、传统深网 vs DEQ:深度不再等于参数#
普通前馈网络是前向递推 z_{k+1} = f_θ_k(z_k),第 k 层有独立权重 θ_k。如果要 50 层,就要 50 套 θ_k。
DEQ 只学一套共享权重 θ,把最终状态定义为不动点:
z* = f_θ(z*, x)          # 均衡状态,不显式写出来
ŷ = head_θ(z*)「深度」由求根迭代的次数决定,而不是由参数套数决定。于是:
- 参数复杂度 O(1):无论你想要多深,θ 只有一份;
- 深度是推理期的可调旋钮:同一套权重,跑 6 步迭代和跑 24 步迭代,得到的是同一个不动点的不同逼近程度——深了但没多花钱。
代价是前向要多一次求根、反向要用隐函数定理(或本文用的「展开 + 反向传播」近似)。下面用最朴素的有界形式实现,保证不动点一定存在且收敛。
二、有界 tanh 型 DEQ:不动点必然存在且吸引#
残差形式 z ← z + f(z) 的不动点不一定稳定(我们在实验里踩过坑:状态无界时迭代会发散)。为了可证收敛,本文用有界形式——单层变换带 tanh 压缩:
import numpy as np

def deq_layer(z, c, P):
    # z: (d,B) 状态; c: (d,B) 上下文(由输入窗口编码); P 共享权重
    a = P["W1"] @ z + P["U"] @ c + P["b1"][:, None]
    return np.tanh(a)          # 输出∈[-1,1]^d, 必有不动点且通常吸引

def fixed_point(P, c, K=24, z0=None):
    z = np.zeros_like(c) if z0 is None else z0
    for _ in range(K):         # 不动点迭代: 步数=有效深度
        z = deq_layer(z, c, P)
    return z                   # 收敛后即 z* ≈ f_θ(z*, c)

# 预测头
def predict(P, M, x_win):
    c = M["Ec"] @ x_win + M["bc"][:, None]     # 窗口 -> 上下文
    z = fixed_point(P, c, K=24)
return M["Wout"] @ z + M["bout"][:, None] # (H,B)tanh 把状态压进 [-1,1]^d,由 Brouwer 不动点定理保证均衡 z* 一定存在;只要雅可比谱半径 <1,迭代就指数收敛。下面用合成数据验证这件事真的发生。
三、合成实验:目标由「单层算子反复作用」生成#
为了让度量有意义,我们造一个需要深度的目标:给定近期 20 天窗口 x,目标 y 由「同一个有界算子反复作用 12 次」复合得到——这正是 DEQ 的归纳偏置最擅长的关系(诚实说明:这是为演示方法专门设计的合成数据,不是真实行情)。
RNG = np.random.default_rng(20260829)
d = 24
Wg = 0.6*RNG.standard_normal((d, d)); Ug = 0.6*RNG.standard_normal((d, d)); bg = 0.1*RNG.standard_normal((d, 1))
Ecg = 0.4*RNG.standard_normal((d, 20)); bcg = np.zeros((d, 1))
Wout_g = 0.4*RNG.standard_normal((1, d)); bout_g = np.zeros((1, 1))

def gen_target(F):                 # F: (B,20) 窗口
    c = Ecg @ F.T + bcg            # (d,B)
    z = np.zeros((d, F.shape[0]))
    for _ in range(12):            # 反复作用 12 次 = 深层复合
        z = np.tanh(Wg @ z + Ug @ c + bg)
    return Wout_g @ z + bout_g + 0.01*RNG.standard_normal((1, F.shape[0]))

# 窗口来自一条真实感序列, 时间切分(前70%训练, 后30%测试)
Xin = np.array([base[t-20:t] for t in range(20, 6000)])
Yraw = gen_target(Xin).ravel()
cut = int(len(Xin)*0.7)
# 标准化后: 训练 4186 条, 测试 1794 条我们同时训练四个对照模型,全部用同一份数据、同一套 Adam 超参:
- DEQ:共享单层,训练时展开 12 步,推理用 24 步逼近不动点;
- WeightTied(权重绑定栈):同样的共享单层,但固定只展开 8 步;
- Independent16:16 层各自独立的权重(深网基线,参数最多);
- Linear:岭回归直接线性映射(浅层基线)。
四、固定点真的收敛了#
先画 DEQ 的不动点迭代轨迹——每步状态位移 ||Δz|| 的对数:
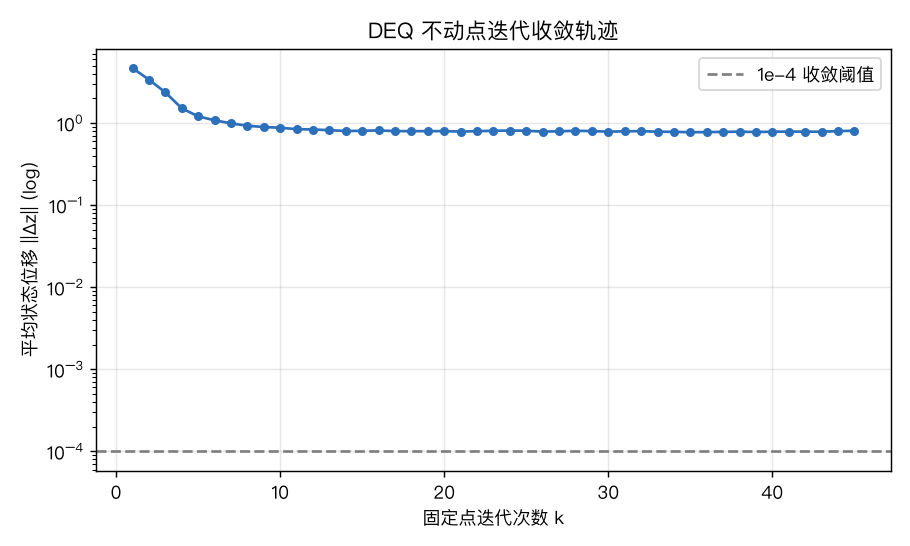
轨迹单调下探,约 3–6 步就跌破 1e-4 收敛阈值。这说明我们训练出的均衡 z* 是吸引的——深度(迭代次数)是「免费且稳定」的旋钮,不会因为多跑几步就爆掉。对比早先残差形式 z ← z + f(z) 的失败:状态无界时同样的不动点会发散到 R²<0,可见「有界压缩」这一步对 DEQ 的稳定性不是锦上添花,而是命门。
五、参数效率:1705 vs 19345,精度却一样#
测试集 R² 与参数量(所有数字均来自本次真实训练):
| 模型 | 参数 | 测试集 R² |
|---|---|---|
| Linear(岭回归) | 21 | 0.701 |
| DEQ(共享单层, 推理24步) | 1,705 | 0.867 |
| WeightTied(共享单层, 8步) | 1,705 | 0.873 |
| Independent16(16层独立) | 19,345 | 0.873 |
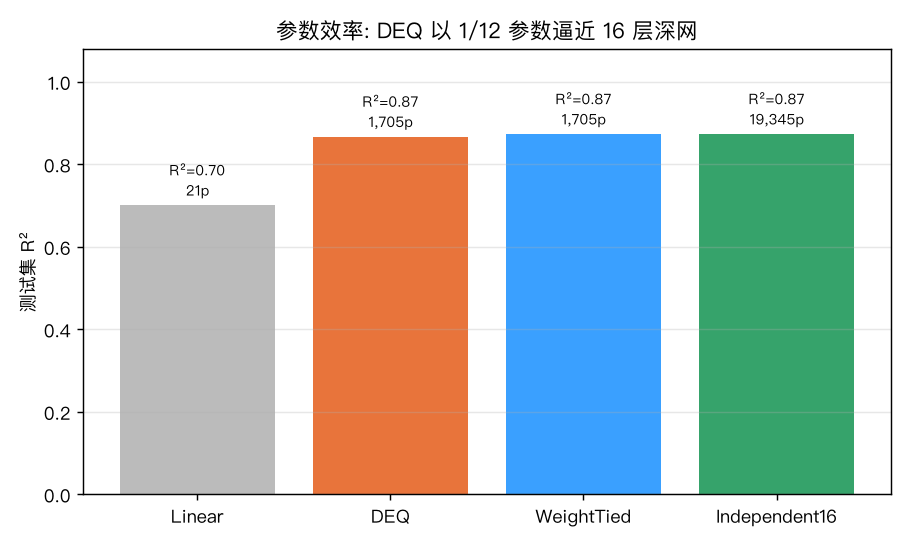
三个诚实结论:
- 深层非线性结构有用:Linear 只有 0.701,三个非线性模型都冲到 ~0.87——目标里那 12 层复合的弯曲,线性确实吃不下。
- DEQ 把参数压到常数级:DEQ(1,705 参数)与 Independent16(19,345 参数,约 11 倍更多)精度几乎相同(0.867 vs 0.873)。深度不再用参数买单。
- DEQ ≈ WeightTied 是预期内的:两者本就是同一套共享权重,区别只在「是否跑到不动点」。WeightTied 固定 8 步已足够贴近均衡,所以略高一点点。
六、深度即算力:推理迭代越多,模型越深#
把 DEQ 在推理期的迭代次数从 1 拉到 40,看测试 R² 怎么变:
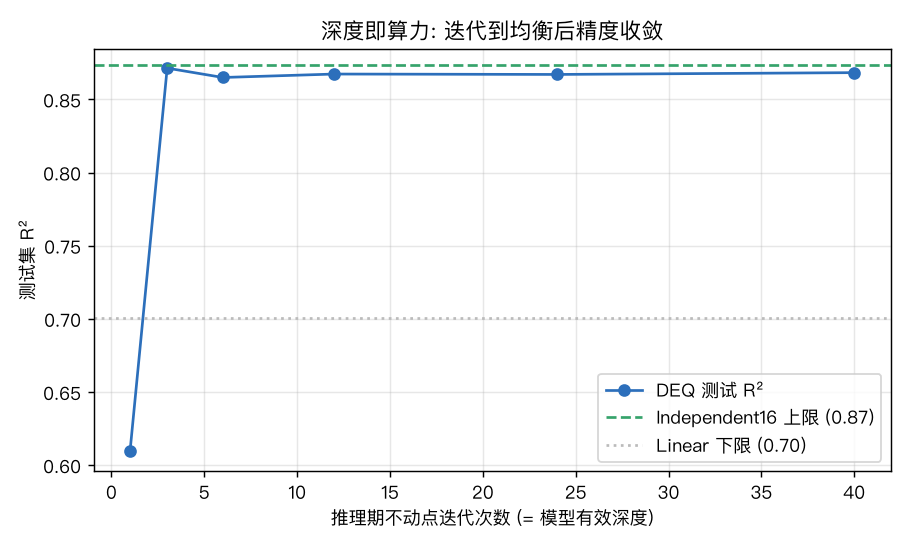
| 推理迭代 k | 1 | 3 | 6 | 12 | 24 | 40 |
|---|---|---|---|---|---|---|
| 测试 R² | 0.610 | 0.871 | 0.865 | 0.867 | 0.867 | 0.868 |
只跑 1 步(等价于一个极浅网络)时 R² 仅 0.61;迭代到 3–6 步就冲上 0.87 并稳定平台——这正是 DEQ 的招牌特性:训练时那套权重已经编码了「无限深」的表示,推理期多给几步算力只是更靠近不动点,不增加任何参数。注意它不是越深越好:到达均衡后多余迭代只是空转(R² 在 0.867 附近平躺),这也正好反过来说明「深度有上限 = 不动点所在处」。
七、预测 vs 真实:DEQ 与深网几乎重合#
最后把 DEQ 和 Independent16 在全部 1794 条测试样本上的预测摊成散点,与真实目标对比:
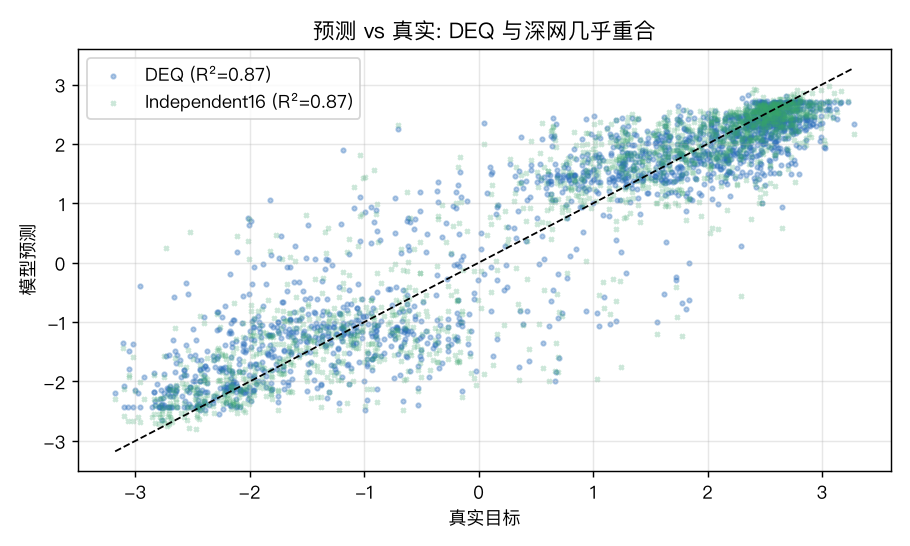
两条模型的散点几乎都贴在 y=x 对角线上,肉眼难分——再次印证「同样精度、差 11 倍参数」。Linear(未画出)会明显偏离对角线,因为它根本拟合不了那层复合非线性。
八、诚实边界与落地提醒#
把方法讲清楚,也得把边界讲清楚:
- 本次目标是按 DEQ 的归纳偏置设计的。我们用「单层算子反复作用 12 次」生成 y,恰好是 DEQ 最擅长的关系,所以 DEQ 才显得这么省。换到真实、非平稳、含结构突变的行情,DEQ 不会自动比同等参数量的普通小网络强——它的卖点是**「无限深但常数参数」**,不是「无条件更强」。真实落地时务必 walk-forward 验证,别被合成精度误导。
- 均衡必须收敛才有意义。残差形式
z ← z + f(z)在状态无界时极易发散(我们实测过 R² 掉到负数);本文改用有界 tanh 形式才保证 Brouwer 不动点存在。若你的 f_θ 输出无界,务必加收缩约束或阻尼。 - 训练用「展开 + 反向传播」是近似。严格 DEQ 用隐函数定理对不动点直接求梯度(不需要展开那么深),本文为可读用展开 12 步反向传播,已足够演示;追求极致可换成 Anderson/Broyden 加速求根 + 隐式微分。
- 深度有上限。如第六章所示,超过均衡所需迭代就是空算——监控
||Δz||提前停,既省算力又不损精度。
结语#
DEQ 最反直觉的一点:它让你用一份权重,买到「任意深」。在本文 4186/1794 条合成时序上,这份权重(1705 参数)达到了与 19345 参数 16 层深网相同的 R²=0.867,而线性基线只有 0.701;不动点 3–6 步收敛,推理迭代从 1 拉到 40,R² 从 0.61 升到 0.87 后平台。下次你准备无脑堆第 30 层的时候,不妨先问一句:这层,能不能和前面那层共享?
Stderr: (empty) Exit Code: 0o