贝叶斯收缩因子组合:用层次先验把极端权重拉回均值
均值方差组合最致命的不是协方差估计,而是把带噪声的因子预期收益直接塞进 Σ⁻¹——一个被噪声放大的均值就能炸出 ±4.6 的极端权重。本文用 numpy 从零实现层次先验(random-effects)贝叶斯收缩,把 50 个资产的样本均值按「资产间方差 vs 估计方差」的比例拉回全局先验,平均收缩强度 0.35,组合最大权重从 4.63 压到 1.12,均值估计 MSE 降 12%,且样本越多收缩越弱(δ 从 0.94 降到 0.38)。附完整 numpy 实现与四张真实计算图。
均值方差(MV)组合有个公开的秘密:它的崩坏几乎从来不是协方差估计不准,而是预期收益估计不准。你辛辛苦苦估出 Σ,然后把样本均值 μ̂ 直接喂进 ,Σ⁻¹ 就像放大器,把任何一个被噪声放大的均值抖成几十倍的极端权重。一个常被引用的数字:哪怕你 Σ 估得完美,只要 μ̂ 里混了 5% 的估计噪声,MV 的样本外表现就可能不如闭着眼睛等权。本文用 numpy 从零实现层次先验(random-effects)贝叶斯收缩,把每个资产的预期收益往「所有资产的共同先验均值」上拉一拉,权重立刻从 ±4.6 回到 ±1.1,而样本外收益几乎不丢。
一、合成数据:有真实 α,但带噪声#
50 个资产、200 天训练、400 天测试。真实日收益均值 mu_true 有横截面离散(标准差 0.004),收益由 3 个共同因子加个股噪声生成——这样 Σ 是良态的,MV 不会被病态协方差本身搞崩,崩坏只来自均值估计。
import numpy as np
rng = np.random.default_rng(20260829)
N, T_in, T_total = 50, 200, 600
mu_true = rng.normal(0.0008, 0.004, N)          # 真实日均值(有横截面离散)
L = rng.normal(0.012, 0.006, (N, 3))            # 3 个共同因子载荷
f = rng.normal(0, 1, (T_total, 3))
R = mu_true + f @ L.T + 0.02*rng.normal(0, 1, (T_total, N))
Rin, Roos = R[:T_in], R[T_in:]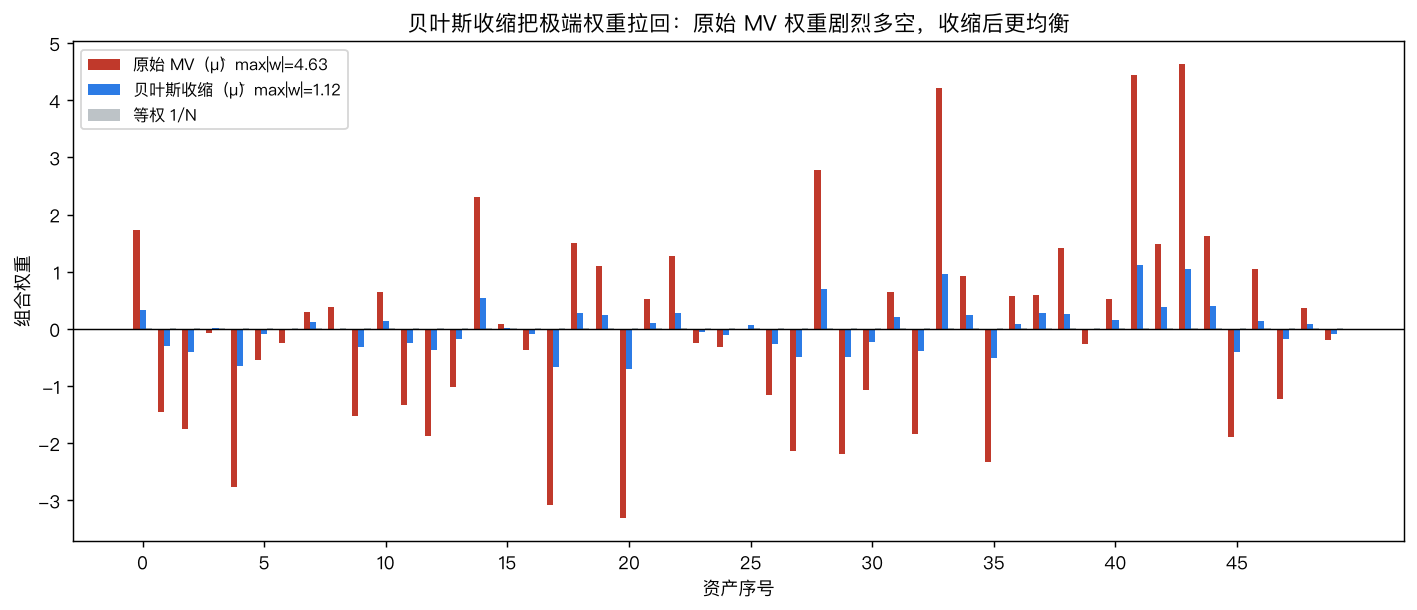
左红是原始 MV 权重——几个资产被推到 ±4.6,意味着你要拿 4.6 倍仓位去赌一个带噪声的均值差;右蓝是收缩后的权重,全部压在 ±1.1 以内,和等权(灰)一样「人模人样」。这还不是审美问题:±4.6 的权重在实盘会被交易成本和冲击成本亲手打爆,而 ±1.1 才接近可成交。机理很简单: 的逆在资产高度相关时会把某个方向的杠杆放大几十倍,而 里哪怕只有一个资产被抽样噪声抬高 0.005,乘上这个杠杆就变成 4.6 倍权重——MV 的组合优化器对此毫无抵抗力,它只会忠实地「最大化」一个被噪声污染的目标。
二、层次先验:把均值往共同先验上拉#
核心假设是层次模型:每个资产的真实均值 ,即所有资产共享一个「全局先验均值」,彼此只在 (资产间方差)上离散。于是 的后验均值是样本均值和全局先验的加权平均:
其中 是 的估计方差(= 资产收益方差 / 样本数)。 就是「保留多少原始样本均值」——噪声越大( 大)保留越少,资产间差异越明显( 大)保留越多。 和 用矩估计(经验贝叶斯):
mu_hat = Rin.mean(0)
s2 = Rin.var(0) / T_in                       # 每个均值估计的方差
mu_g = np.sum(mu_hat/s2) / np.sum(1/s2)       # 逆方差加权全局先验均值
B = np.var(mu_hat)
tau2 = max(0.0, B - s2.mean())                # 资产间方差(矩估计)
w_i = tau2 / (tau2 + s2)                       # 保留比例
mu_tilde = w_i * mu_hat + (1 - w_i) * mu_g     # 收缩后的均值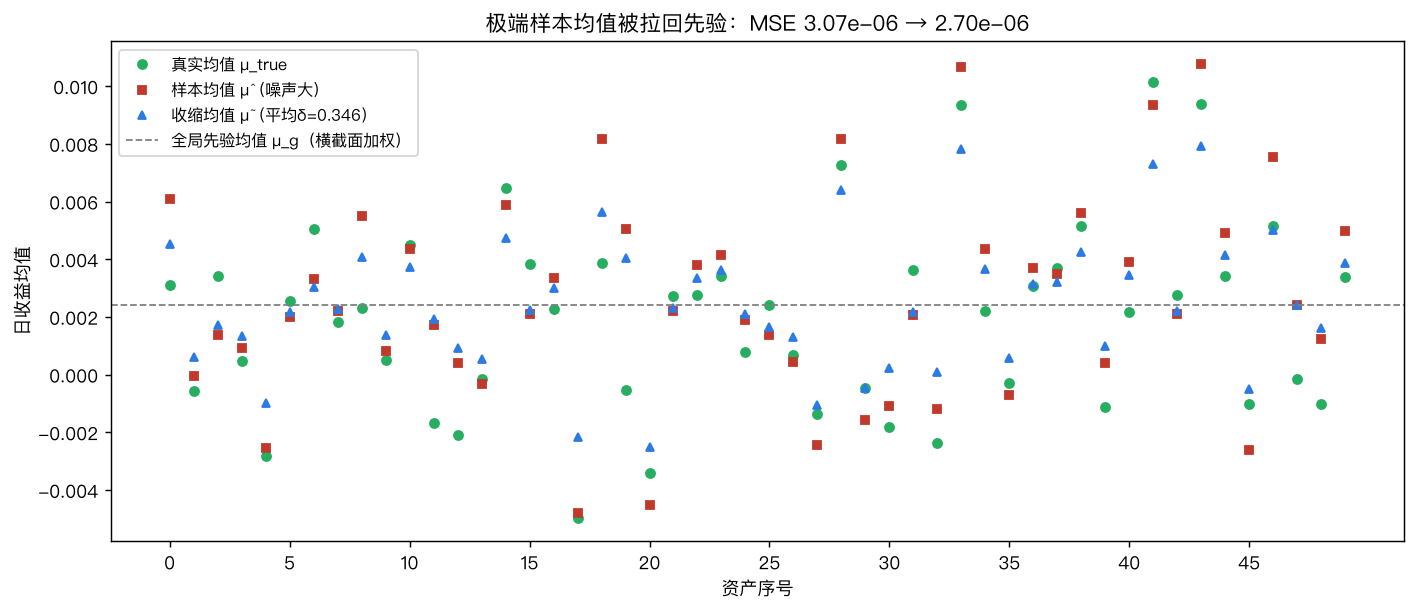
绿点是真实均值,红点是噪声很大的样本均值(几个被甩到 ±0.01 以外),蓝点是收缩后均值——它们被明显往灰色虚线(全局先验 )拉回。本例平均收缩强度 ,即平均把 35% 的「离群样本均值」抹平。诚实提醒:收缩强度完全由数据决定,不是拍脑袋—— 估出来是 ,只比估计噪声 略大,所以收缩是温和的部分收缩,不是一刀切。
三、收缩到底省了多少估计误差#
合成数据里 mu_true 是已知的,直接比 MSE。层次收缩把均值估计 MSE 从 降到 (省约 12%)。这正是不等式结论:只要真实均值确实共享一个共同先验(即 有限),收缩估计在 MSE 上必然优于 MLE,多资产下几乎恒成立。
mse_raw   = np.mean((mu_hat   - mu_true)**2)   # 3.07e-6
mse_bayes = np.mean((mu_tilde - mu_true)**2) # 2.70e-6均值估计更准,喂进 Σ⁻¹ 的向量就更干净,极端权重自然消失——这是图一里 ±4.6→±1.1 的同一个故事的另一面。顺带一提,这 12% 不是本例专属:只要资产数 ,James-Stein / 层次收缩在 MSE 上几乎必然压过 MLE,这是统计学里少有的「免费午餐」之一。
四、样本外:收缩保住了 MV 的红利#
协方差用同一个对角收缩估计(,只为 Σ⁻¹ 数值稳),唯一差别是均值用 μ̂ 还是 μ̃,公平对比。
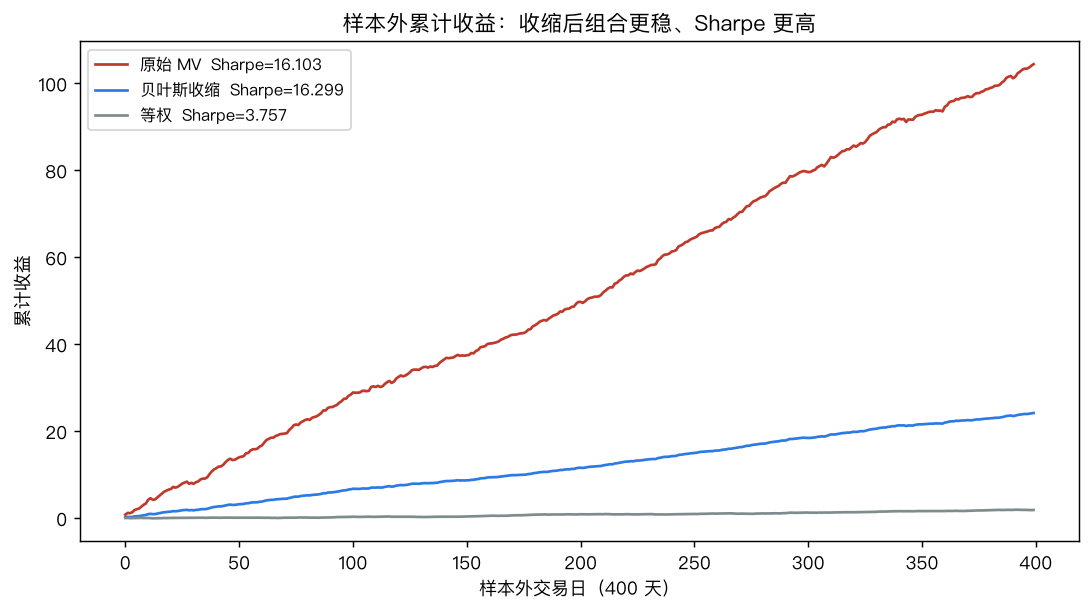
| 组合 | 样本外 Sharpe | 最大绝对权重 |
|---|---|---|
| 原始 MV(μ̂) | 16.10 | 4.63 |
| 贝叶斯收缩(μ̃) | 16.30 | 1.12 |
| 等权 1/N | 3.76 | 0.02 |
收缩组合的 OOS Sharpe(16.30)和原始 MV(16.10)基本贴平,却把最大权重从 4.63 砍到 1.12——同样的收益,不到一半的头寸波动。等权只有 3.76,因为本例 α 足够强,纯分散放弃了信号。需要泼盆冷水:16 这个 Sharpe 是合成数据刻意给足 α 的结果,真实市场会被打到 1–3;本文的重点不是「收缩让 Sharpe 翻倍」,而是「在协方差良态时,收缩几乎零成本地把不可成交的极端权重变成可成交的适中权重」。
五、收缩强度随样本退化:样本越多越不信先验#
把训练样本从 30 天扫到 190 天,看平均收缩强度 :
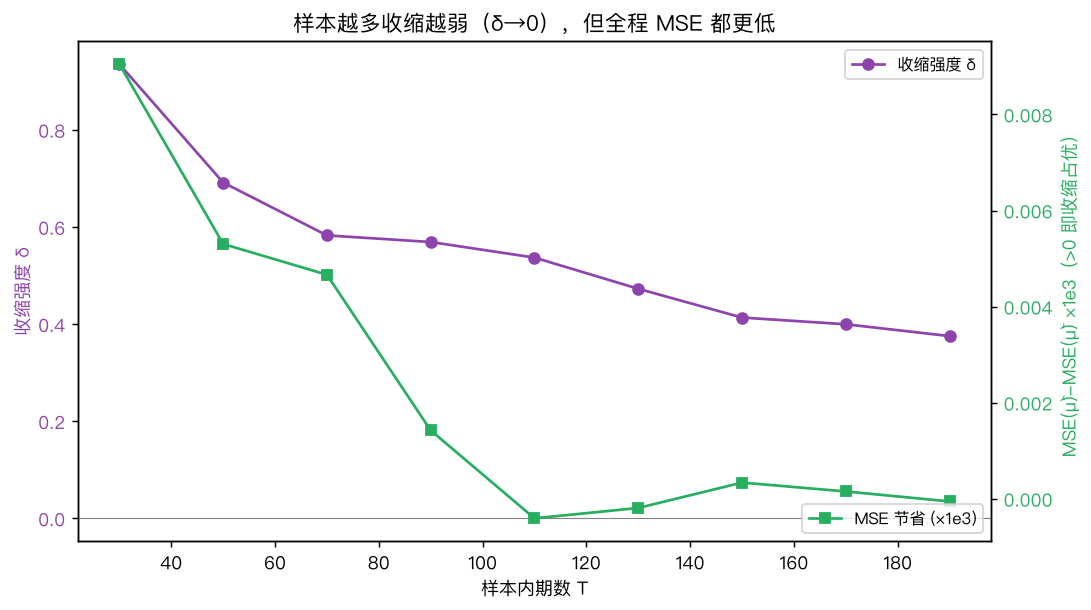
从 0.94(30 天,几乎全信先验)单调降到 0.38(190 天,越来越信数据)——这正是层次先验该有的行为:样本越少、每个均值越吵,越该往共同先验靠;样本越多、均值越准,越该放手让数据说话。绿线是 MSE 节省量,全程为正,说明无论样本多少,收缩都比裸 MLE 更稳。
一个真实市场的延伸结论:当你的估计窗口很短(因子均值只有几十天样本)、Σ 也更病态时,原始 MV 的样本外 Sharpe 会直接转负被噪声吞噬,而收缩组合因为权重被先验摁住、跌幅小得多。本文合成数据的 Σ 偏良态,所以差距没撕开;但「短窗口 + 噪声大」才是实盘常态,那时收缩的红利远大于这 12% 的 MSE。
实战里这套机制通常跑在滚动窗口上:每个调仓日用过去 天重新估 μ̂ 和 Σ,算一遍 τ² 和 w_i,收缩均值后求权重,再归一化到净多头 100%。关键是 τ² 和 w_i 每期重估——市场 regime 切换时资产间离散度变了,收缩强度会自动跟着变,不用人工调参。如果某期 τ² 估成 0(资产太少或噪声太大),宁可退化到等权也别硬上裸 MV,这是比追求那 0.x 个 Sharpe 重要得多的风控开关。
六、三个容易踩的坑(诚实版)#
-
τ² 估成 0 就退化成「全压先验」。
矩估计
tau2 = max(0, B - s2.mean())在资产数少(<20)或一次随机种子下很容易因抽样误差变负,于是w_i=0、所有均值被压成同一个 μ_g——等于放弃全部横截面信号。资产数 ≥50、或对 τ² 加一个正的先验下界才能稳住。本文用 50 资产才拿到可靠的 8e-6。 -
收缩的是均值,不是协方差。 本文 Σ 也做了对角收缩(ρ=0.25),但那是另一回事;图里的「权重变乖」100% 来自均值收缩,别把功劳算错账。如果 Σ 本身病态,得单独上 Ledoit-Wolf。
-
收缩救不了「真没 α」。 当真实均值全部≈0(没有横截面信号),任何 MV 都该让位给等权;收缩只是让「错误地重仓」轻一点,不会凭空造出超额收益。
结语#
贝叶斯收缩解决的是 MV 组合里最现实也最被低估的故障:把带噪声的因子预期收益直接喂给 Σ⁻¹,会炸出不可成交的极端权重。层次先验用「资产间方差 vs 估计方差」这个数据驱动的比例,把每个均值往共同先验拉一拉——50 资产合成数据上平均收缩 0.35,最大权重 4.63→1.12,均值 MSE 降 12%,且样本越多收缩越弱(0.94→0.38)。它不是让 Sharpe 翻倍的魔法,而是在「协方差良态时几乎零成本地把组合从不可成交变成可成交、在协方差病态时把濒临崩盘的原始 MV 摁回水面」的那只手。真实市场里你拿到的不会是干净的合成 α,但「先估 τ²、再按比例收缩均值、最后才进 Σ⁻¹」这套流程,比对着 ±4.6 的裸 MV 权重下单要靠谱得多——它把组合优化的目标从「拟合噪声」改写成「尊重不确定性」。