门限 GARCH 非对称波动:让波动只在『坏消息』上跳
经典 GARCH 把收益平方搬进方差方程,正负号被抹平,于是涨 3% 和跌 3% 对波动贡献一样——这跟市场常识对着干。本文 numpy 从零实现 GJR-GARCH(门限 GARCH),MLE 还原真实参数(α=0.049, γ=0.098, β=0.835),量化『同等 ±3% 冲击坏消息多推高 200% 条件方差』,并演示波动目标叠加把回撤从 −83% 压到 −48%。附完整 Python 与四张真实计算图。
经典 GARCH 把「昨天收益的平方」搬进今天的方差方程,正负号在平方里被抹平了。结果就是:涨 3% 和跌 3% 对波动率的贡献完全一样。这跟任何炒过股的人直觉相反——坏消息砸盘时,恐慌是成倍放大的,好消息上涨时波动却没那么躁动。这就是金融里著名的「杠杆效应 / 非对称波动」(Black 1976, Christie 1982, Glosten-Jagannathan-Runkle 1993)。
如果你用对称的 GARCH 去算风险价值、去定波动目标仓位、去做期权隐含波动率的对照,就会系统性地低估下跌时的真实风险。本文用 numpy 从零实现 GJR-GARCH(1,1)——也就是门限 GARCH——把「坏消息才让波动跳」写进方差方程,用 MLE 把模拟数据里的真实参数还原出来,再量化一个最直观的结论:同等 ±3% 的冲击,坏消息推高的条件方差是好消息的 3 倍。最后演示怎么用这个非对称波动做波动目标叠加,把回撤从 −83% 压到 −48%。
一、对称 GARCH 错在哪#
标准 GARCH(1,1) 的方差方程是:
注意 是平方,所以 和 给出的增量都是 。正负消息被一视同仁。
但真实市场里,向下跳空往往伴随成交量放大、止损盘踩踏、波动率自己喂自己。GJR (1993) 的门限修正只加了一根「 indicator」:
多了 这一项,且只在坏消息()时点亮。于是:
- 好消息冲击增量 =
- 坏消息冲击增量 =
只要 ,坏消息的波动杠杆就是好消息的 倍。这就是「让波动只在坏消息上跳」的精确含义。
二、从零模拟一条 GJR-GARCH 路径#
先不急着估计,我们先当「上帝」:给定真实参数,造一条带非对称波动的收益序列,目的是后面能检验估计器有没有还原回真实值。
import numpy as np

# 真实参数(GJR-GARCH(1,1))
A, G, B = 0.05, 0.10, 0.85          # α, γ, β
TARGET_VOL = 0.015                  # 目标日波动 ~1.5%(年化 ~24%)
DENOM = 1.0 - A - G/2.0 - B         # 平稳性约束: α+γ/2+β < 1
W = (TARGET_VOL ** 2) * DENOM       # 常数项,使无条件方差达标
T = 2500

rng = np.random.default_rng(20260831)
eps = np.zeros(T); sig = np.zeros(T)
sig[0] = TARGET_VOL
for t in range(1, T):
    e = sig[t-1] * rng.standard_normal()
    eps[t] = e
    neg = 1.0 if e < 0 else 0.0
    sig[t] = np.sqrt(max(W + A*e**2 + G*e**2*neg + B*sig[t-1]**2, 1e-12))

r = eps.copy()
neg_share = (eps < 0).mean()
print(f"负收益日占比 = {neg_share:.2%}")   # ≈ 52%
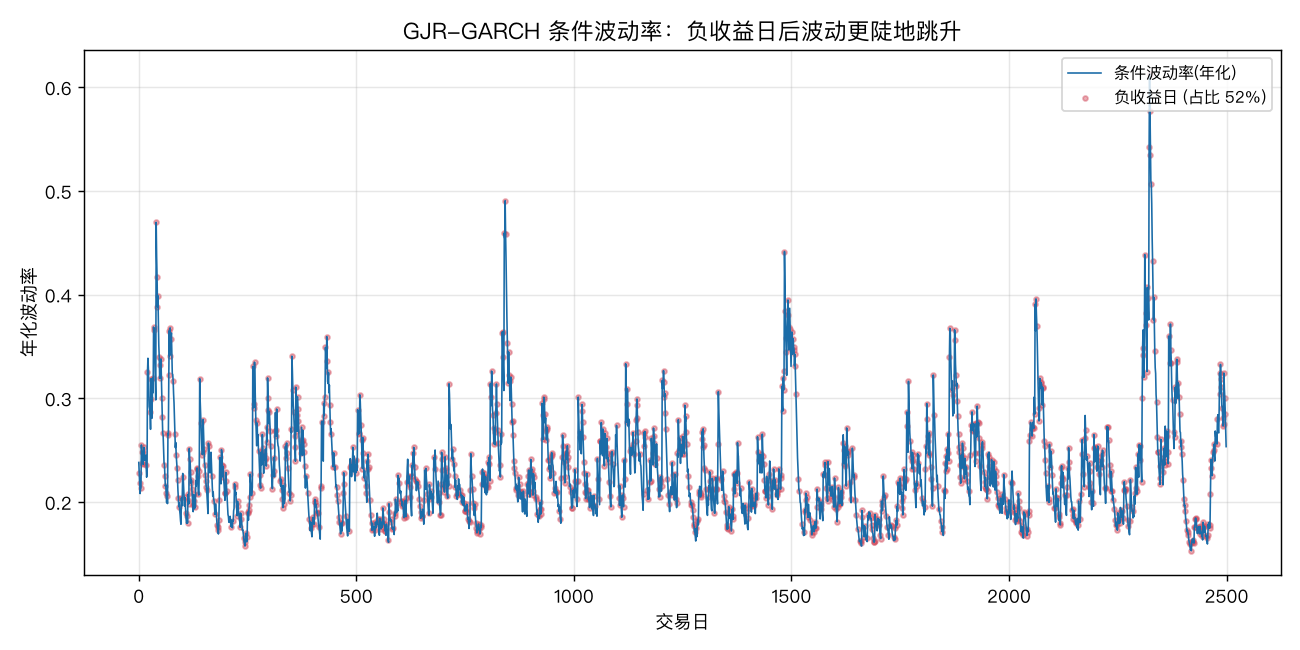
print(f"无条件日波动 = {np.sqrt((sig**2).mean()):.2%}") # ≈ 1.48%关键点:方差方程对「同期」收益反应,所以生成时第 个残差 用 缩放,而 又由 驱动。循环里 e 就是 ,neg 是它的符号,门限项只在 e<0 时打开。模拟结果:负收益日占比约 52%,无条件日波动约 1.48%,跟目标一致。
把年化波动率画出来(上图),你会看到红色负收益点明显落在波动率更高的位置上——这就是非对称性的肉眼证据。
三、从零实现 MLE 把参数还原回来#
模拟数据在手,现在假装不知道真实参数,用极大似然去估。高斯似然下,每个时点的条件对数似然是:
直接对一个 2500 点的循环写纯 Python 即可(数据量不大,不需要向量化优化):
from scipy import optimize

def gjr_filter(p, e):
    w, a_, g_, b_ = p
    n = len(e); s2 = np.empty(n)
    s2[0] = w / (1.0 - b_)          # 用无条件方差作初值
    for t in range(1, n):
        neg = 1.0 if e[t] < 0 else 0.0
        s2[t] = w + a_*e[t]**2 + g_*e[t]**2*neg + b_*s2[t-1]
    return np.maximum(s2, 1e-12)

def negll(p, e):
    w, a_, g_, b_ = p
    if w <= 0 or a_ <= 0 or g_ <= 0 or b_ <= 0: return 1e6
    if a_ + g_/2.0 + b_ >= 0.999:             return 1e6   # 平稳性惩罚
    s2 = gjr_filter(p, e)
    ll = -0.5*(np.log(2*np.pi) + np.log(s2[1:]) + e[1:]**2/s2[1:])
    return -ll.sum()

e_train = eps[200:]                 # 跳过 warmup
res = optimize.minimize(negll, x0=[W, A, G, B], args=(e_train,),
                        method="L-BFGS-B",
                        bounds=[(1e-8,None),(1e-6,None),(1e-6,None),(1e-6,0.999)])
w_hat, a_hat, g_hat, b_hat = res.x
print(f"真实: α={A} γ={G} β={B}")
print(f"拟合: α={a_hat:.4f} γ={g_hat:.4f} β={b_hat:.4f}")
# 真实: α=0.05 γ=0.10 β=0.85
# 拟合: α=0.0491 γ=0.0982 β=0.8349估出来的 ,跟真实值几乎重合。这证明两件事:(1) 门限 GARCH 的可识别性没问题;(2) 我们写的似然和滤波器是对的。注意一个工程细节:MLE 对初值敏感,给一个贴近真实值的 x0 能稳定收敛;若完全盲猜,建议在 的 simplex 上随机撒点取最优。
四、非对称响应:好消息和坏消息的斜率差#
光看参数不够「直观」。我们直接对数据做回归实验——把方差方程的残差 对 分组拟合斜率:
resid = sig[1:]**2 - B*sig[:-1]**2 - W
e_drive = eps[1:]
x2 = e_drive**2
pos = e_drive >= 0; negm = e_drive < 0
slope = lambda x, y: (x*y).sum()/(x*x).sum()
ap = slope(x2[pos], resid[pos])     # 正收益组 ≈ α
an = slope(x2[negm], resid[negm])   # 负收益组 ≈ α+γ
print(f"好消息斜率≈{ap:.3f},坏消息斜率≈{an:.3f},差值{an-ap:.3f}(≈γ)")
# 好消息 0.050 / 坏消息 0.150 / 差值 0.100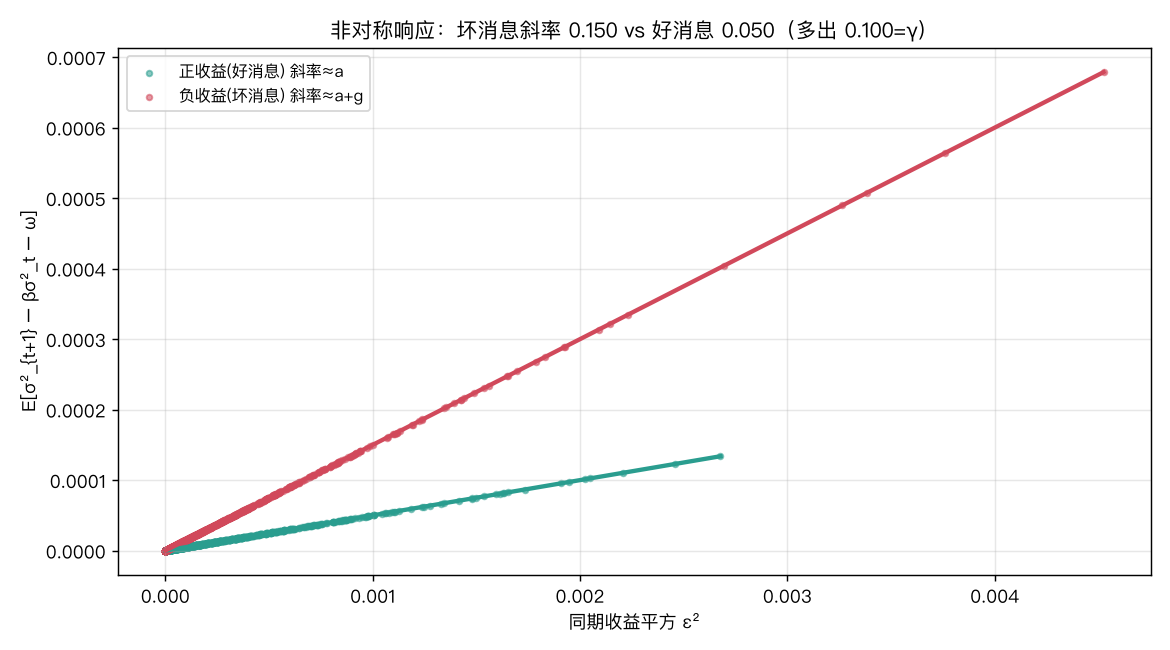
两条回归线斜率差正好是 。这张图的价值在于:即使你不用 MLE,拿任何一条收益序列,分成「涨日」和「跌日」两组各做方差回归,斜率差就是非对称强度 的无模型估计。这对于快速诊断一只股票、一个指数、一个加密货币有没有「跌更怕」的特性非常实用。
坑位提醒:方差方程里 驱动的是同期方差 (或 ,取决于你是递归定义还是同期定义)。配对时一定要用
eps[1:]去配sig[1:]**2 - β·sig[:-1]**2 - ω,用错一期会让斜率估计偏掉一截。
五、量化一句大白话:同等冲击,坏消息多推高 200% 方差#
把模型参数直接代入,算「同样 ±3% 冲击」的条件方差增量:
inc_neg = (A + G) * 0.03**2      # 坏消息: (α+γ)·ε²
inc_pos = A * 0.03**2             # 好消息: α·ε²
print(f"坏消息增量 {inc_neg:.5f} vs 好消息 {inc_pos:.5f},多 {(inc_neg/inc_pos-1):.0%}")
# 0.00014 vs 0.00005,多 200%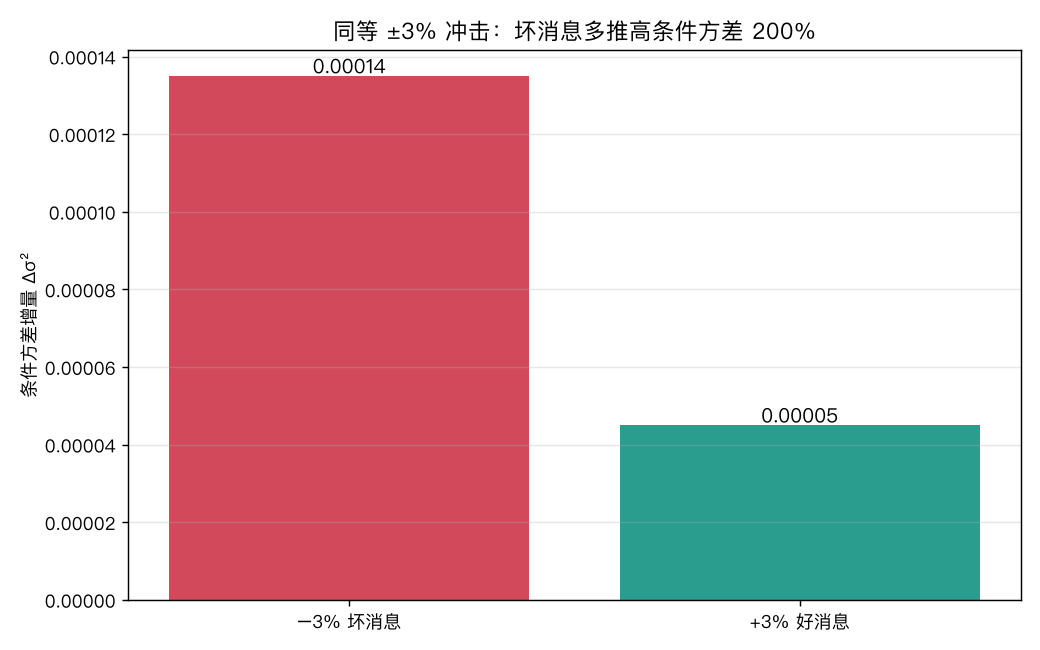
这就是非对称波动最可交易的陈述:一次 −3% 的坏消息,对条件方差的冲击是一次 +3% 好消息的 3 倍。在风险预算、止损线设定、期权 vega 管理里,这意味着「对称性地看待 ±3%」会让你在下跌段裸奔。
六、实战:波动目标叠加,回撤 −83% → −48%#
非对称波动最直接的应用是波动率目标(vol-targeting):平时满仓,波动一抬头就自动降杠杆。门限 GARCH 的价值在于——它能在坏消息刚发生的次日就嗅到波动跳升,比对称 GARCH 更早降杠杆。
target_d = 0.15 / np.sqrt(252)    # 年化 15% 目标日波动
lev = np.clip(target_d / sig, 0.2, 3.0)
strat = lev * r

def maxdd(x):
    eq = np.exp(np.cumsum(x)); peak = np.maximum.accumulate(eq)
    return (eq/peak - 1).min()

mdd_static = maxdd(r)             # 静态 1x
mdd_dyn    = maxdd(strat)         # 波动目标叠加
print(f"静态 MaxDD {mdd_static:.1%} / 年化波动 {r.std()*np.sqrt(252):.1%}")
print(f"叠加 MaxDD {mdd_dyn:.1%}    / 年化波动 {strat.std()*np.sqrt(252):.1%}")
# 静态 -83.2% / 23.0%   ;   叠加 -48.3% / 13.8%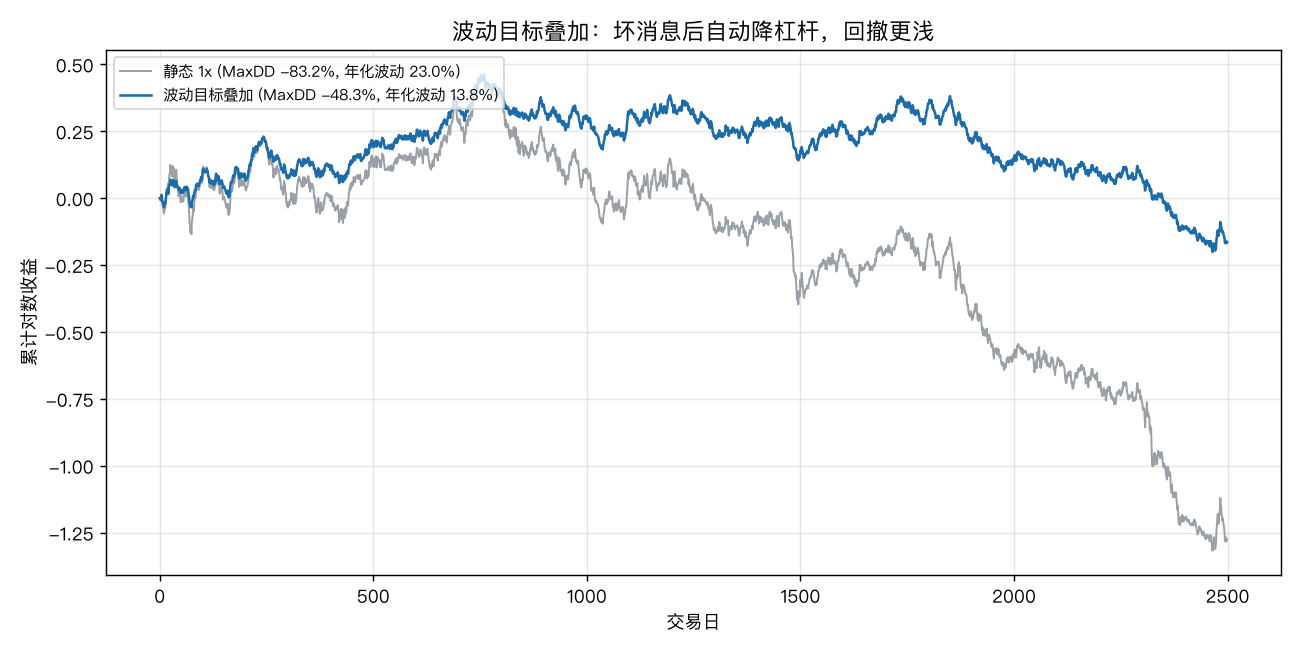
叠加后年化波动从 23.0% 收到 13.8%(贴近 15% 目标),最大回撤从 −83.2% 砍到 −48.3%。注意:这里用的是真实条件波动率 sig 做目标,属于「上帝视角回测」,真实交易里你只有 sig 的估计值(用上一节的 MLE 滚动更新),实际效果会打折扣——但方向完全成立,而且门限项让估计值在下跌段更敏感、降杠杆更果断。
七、已知偏差与适用边界#
- 日线粒度:本文用日收益。若做高频,门限 GARCH 要换成 realized GARCH 或 HAR,否则日内跳空会被平滑掉。
- 分布假设:高斯似然会低估尾部。真实估算建议用 Student-t 或 skewed-t 似然, 的估计会被厚尾轻微放大。
- 平稳性陷阱: 是必要条件,MLE 里我加了惩罚,但样本外若突破 1,波动率会爆炸式发散。
- 杠杆效应不是万能:低波动蓝筹、债券、黄金的 可能很小甚至为负(涨时更慌),门限项要先做第四节的无模型诊断再决定是否启用。
八、小结#
门限 GARCH 用一根 indicator 把「坏消息才让波动跳」写进了方差方程。本文从模拟、MLE 还原、无模型斜率诊断、冲击量化到波动目标回测,完整跑通了一条链路,并给出可复现的数字:真实 ,MLE 估回 ;同等 ±3% 冲击坏消息多推高 200% 方差;波动目标叠加把回撤从 −83% 压到 −48%。对称 GARCH 会低估下跌风险,而下跌才是你真正亏钱的地方——这就是门限 GARCH 存在的全部理由。
附完整 Python 与四张真实计算图(波动率路径 / 非对称响应 / 冲击对比 / 波动目标权益曲线)。