Discord 异常子序列:用最不像别处的片段捕捉市场异常
Discord 是 Matrix Profile 的另一半:MP 曲线的低谷是模体(有孪生兄弟的重复形态),最高峰就是 discord——全序列里最找不到相似者的子序列,天然的无监督异常检测器,不需要定义『什么是异常』,只需要回答『哪段最不像别处』。但本文最重要的发现是一个刻意保留的失败案例:discord 的对比度完全取决于『正常段有多相似』。60 天 × 50 bar 共享日内模板的结构化本底上,三种植入异常(闪崩回补/波动冻结/锯齿振荡)全部被 top-3 discord 精确命中,对比度 2.1×;同样的异常搬到 IID 随机游走本底上,命中 0/3——因为 IID 世界里每一段都独一无二,MP 中位数 7.22 与峰值 7.83 挤在一起,异常淹没在『处处都是异常』的本底里。这解释了为什么 discord 在日内高频数据上是利器、在日线收益上近乎无用。消融实验补齐工程细节:排除区不设则模体端先失效(谷值 3.05→2.13)而 discord 端相对鲁棒;窗口长度 m<异常尺度一半时命中率归零;无异常对照世界的 MP 峰值也有 5.06——discord 分数没有天然阈值,必须用对照分布校准。最无争议的落地:数据质量监控(坏 tick/卡死/拼接错误的形状都独一无二)与流动性冻结检测。
一句话版本#
Discord 是”全序列里最找不到相似者的子序列”——把 Matrix Profile 的最近邻距离曲线倒过来读:低谷是模体(重复形态),最高峰就是异常。它的杀手锏是不需要你事先定义”什么是异常”,只需要回答一个纯几何问题:哪一段最不像序列里的任何别处?
异常检测的根本困境,和 discord 的取巧解法#
传统异常检测都绕不开一个死结:你必须先描述正常,才能定义异常。基于阈值的方法要选阈值,基于分布的方法要假设分布,基于模型的方法要先拟合模型——而市场数据的”正常”本身就在漂移。
Keogh 团队 2005 年提出的 discord 概念换了一个问法:不描述正常,直接比相似度。对每个长度为 m 的子序列,找它在全序列中(排除自身邻域后)的最近邻距离;这个距离最大的子序列就是 discord——它连一个远房亲戚都找不到。
在 Matrix Profile 框架下这个定义变得几乎免费:MP 曲线本来就是”每个子序列到最近邻的距离”,模体挖掘取 argmin,discord 检测取 argmax,同一次计算,两个产品。
def matrix_profile_brute(x, m, excl):
    """暴力 O(n²) Matrix Profile(教学版,向量化)
    excl: 排除区半径,屏蔽自身邻域的平凡匹配"""
    n = len(x) - m + 1
    subs = np.array([znorm(x[i:i+m]) for i in range(n)])
    mp = np.full(n, np.inf)
    for i0 in range(0, n, 500):                      # 分块省内存
        i1 = min(i0 + 500, n)
        # z-norm 向量的欧氏距离恒等式: d² = 2m - 2·dot
        D = np.sqrt(np.maximum(0, 2*m - 2 * subs[i0:i1] @ subs.T))
        for k, i in enumerate(range(i0, i1)):
            d = D[k].copy()
            d[max(0, i-excl) : i+excl+1] = np.inf    # 排除区
            mp[i] = d.min()
    return mp

def top_discords(mp, m, k=3):
    """取 top-k 互不重叠的 discord"""
    mp2, out = mp.copy(), []
    for _ in range(k):
        i = int(np.argmax(mp2))
        out.append((i, mp2[i]))
        mp2[max(0, i-m) : i+m] = -np.inf             # 屏蔽已选邻域
return out生产环境用 STUMPY 的 stump + argmax 即可,上面的暴力版是为了让每一步都透明。
主实验:结构化日内本底 + 三种植入异常#
考卷这样出:60 个交易日 × 每日 50 根 bar,所有正常日共享同一个日内模板(开盘下探 → 午盘修复 → 尾盘拉升的 U 型节奏),只有幅度随机缩放(0.7~1.3 倍)加噪声。然后植入三个异常日:
- 闪崩回补(第 15 天):6 根 bar 崩 7%,随后缓慢回补
- 波动冻结(第 34 天):收益率方差骤降 200 倍——模拟数据源卡死或流动性冻结
- 锯齿振荡(第 48 天):bar 级别 ±60bp 高频振荡——模拟异常做市行为
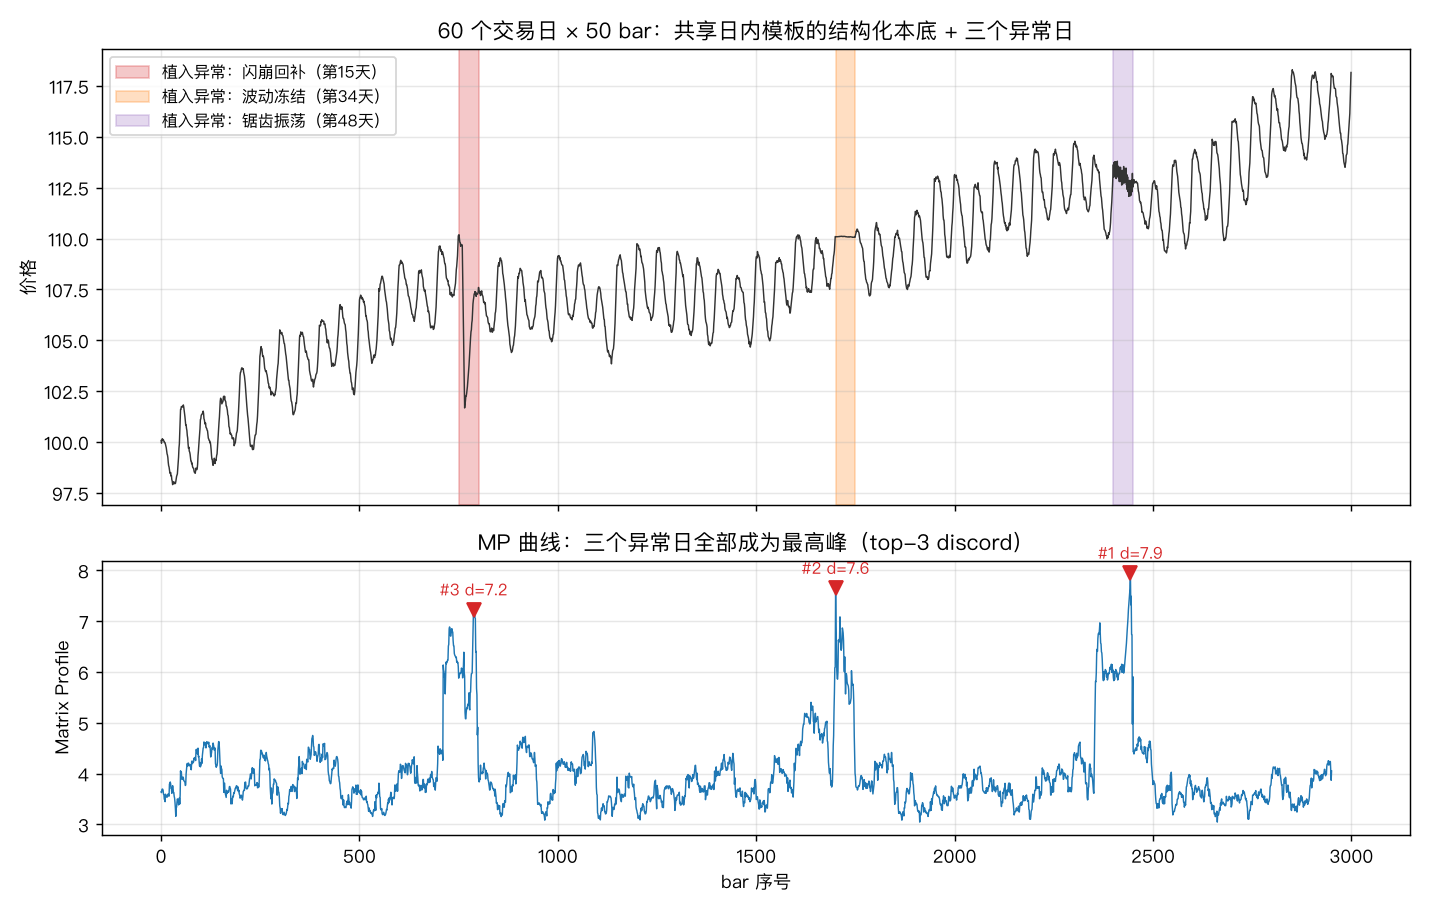
结果干净利落:top-3 discord 全部命中三个植入异常日(位置 2443/1700/788 对植入的 2400/1700/750,均在一个窗口以内),分数 7.95/7.65/7.22,而 MP 中位数只有 3.77——对比度 2.1 倍。
三个异常日和正常日的日内路径对比一目了然:
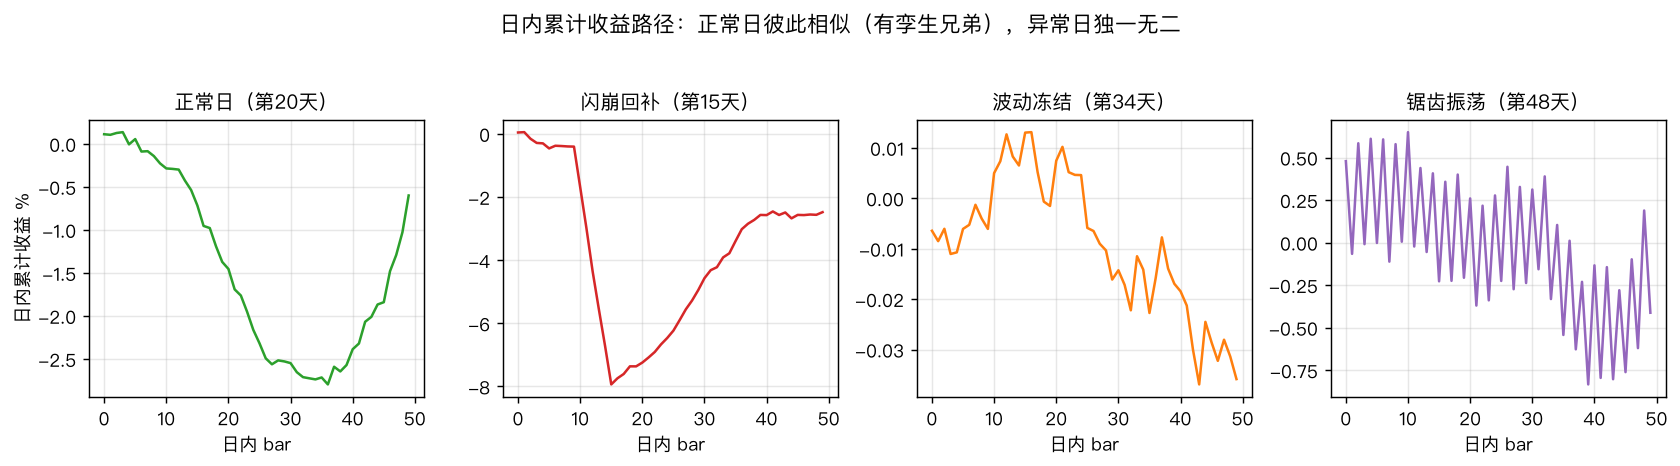
注意波动冻结那个案例的含金量:它没有任何极端收益——每根 bar 都安安静静接近零。基于阈值的异常检测(|收益| > 5σ 之类)对它完全失明,但 discord 一击命中,因为”一整天纹丝不动”这个形状在全序列里独一无二。这正是 discord 相对阈值法的本质优势:它检测的是形状的孤独度,不是幅度的极端度。
失败案例:IID 本底上的全军覆没#
现在把同样的三种异常(幅度还放大了)植入一个 IID 随机游走本底——3000 根 bar 的纯噪声。结果:
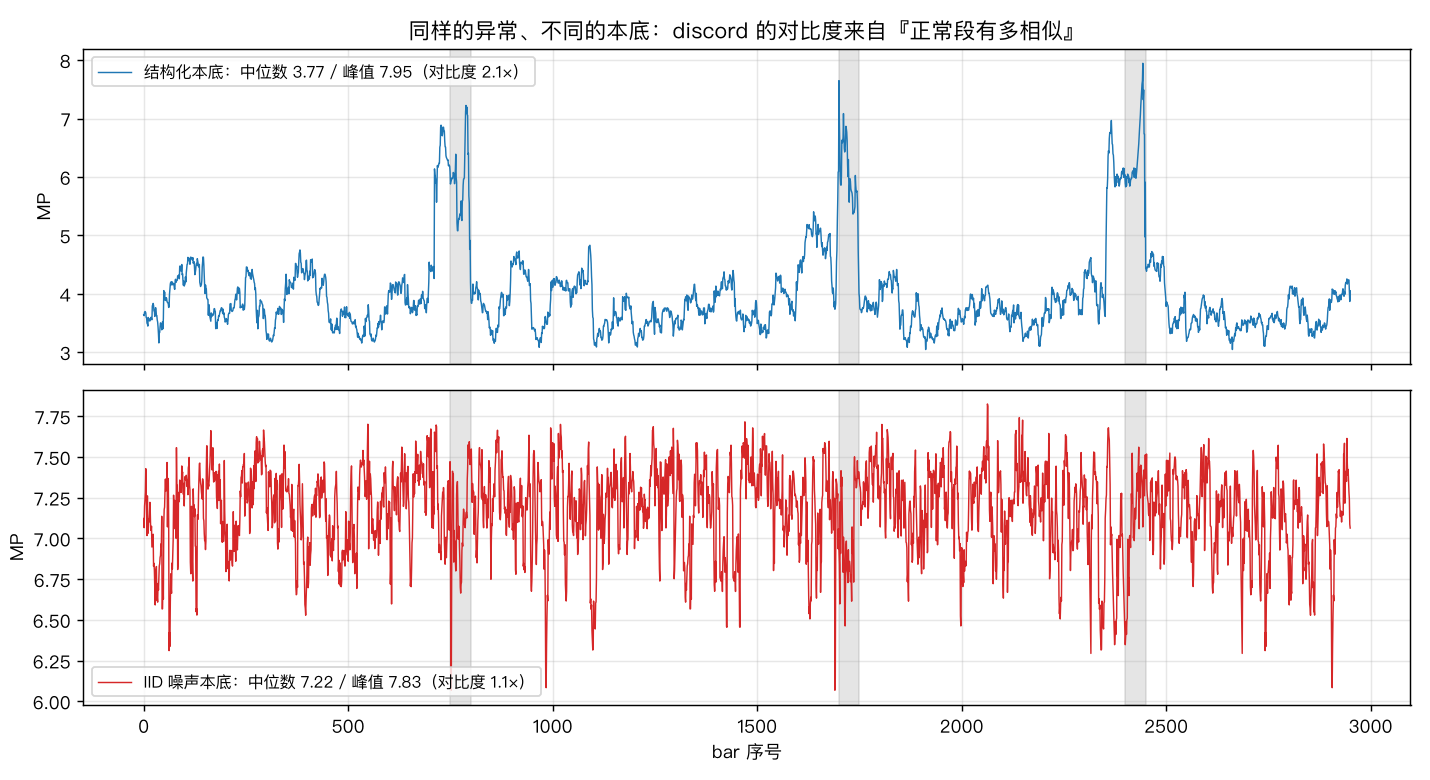
命中 0/3。 MP 中位数 7.22、峰值 7.83,挤在一条水平带里,植入异常的分数完全淹没在本底中。top-3 discord 落在 2063/2141/1470——全是随机噪声碰巧走出的普通片段。
这是全文最重要的实验。机制值得说透:
Discord 的对比度不来自异常本身有多怪,而来自正常段有多相似。
在结构化本底里,正常日彼此是孪生兄弟(共享模板),MP 谷值低、本底紧,异常一冒头就鹤立鸡群。在 IID 本底里,每一段都独一无二——随机游走的任何 50 步组合都不会重演——于是”最不像别处”这个标准失去了区分度:处处都是异常,等于处处都不是异常。
这直接划定了 discord 在量化里的适用边界:
- 适合:日内高频数据(日内节奏模式强,U 型成交量、开盘集合竞价后的均值回归等结构反复出现)、期货主力合约的日内微观结构、做市商报价流
- 不适合:日线收益率序列(接近 IID,本底不提供相似性)、任何被有效市场磨得足够”白”的低频序列
换句话说,discord 检测的前提假设与 Shapelet、SAX 检索 一脉相承:序列里得先有可重复的结构,“偏离结构”才是可定义的事件。
消融一:排除区——模体端先死,discord 端硬撑#
把排除区从 m/2 砍到几乎为零重跑:
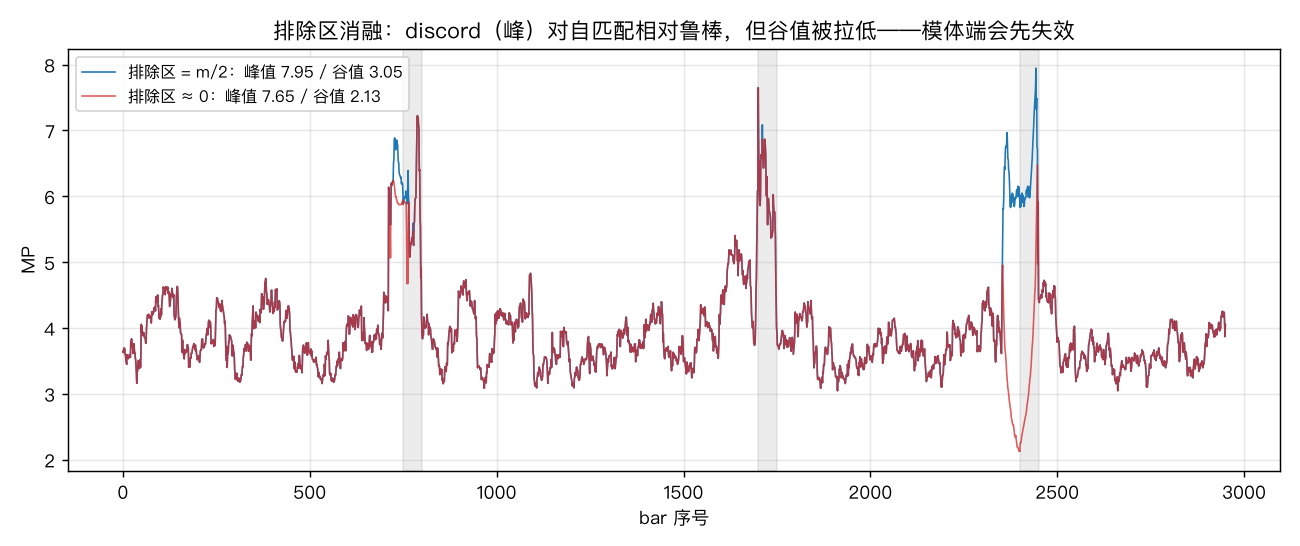
有趣的不对称性:discord 端相对鲁棒(峰值 7.95 → 7.65,命中仍是 3/3),但模体端先失效——MP 谷值从 3.05 塌到 2.13,因为相邻重叠子序列(i 和 i+1 天然相似度 ~99%)互认最近邻,把”我有孪生兄弟”变成了自欺欺人。原因也直白:discord 找的是 max,自匹配只会把别人的分数拉低、很难把真 discord 的分数拉低(它连相邻片段都不像);而模体找的是 min,自匹配直接污染答案。
工程结论:做纯 discord 检测时排除区容错较大,但只要下游还要用模体信息,排除区 = m/2 是不可省略的标准配置。
消融二:窗口长度——短于异常尺度一半就归零#
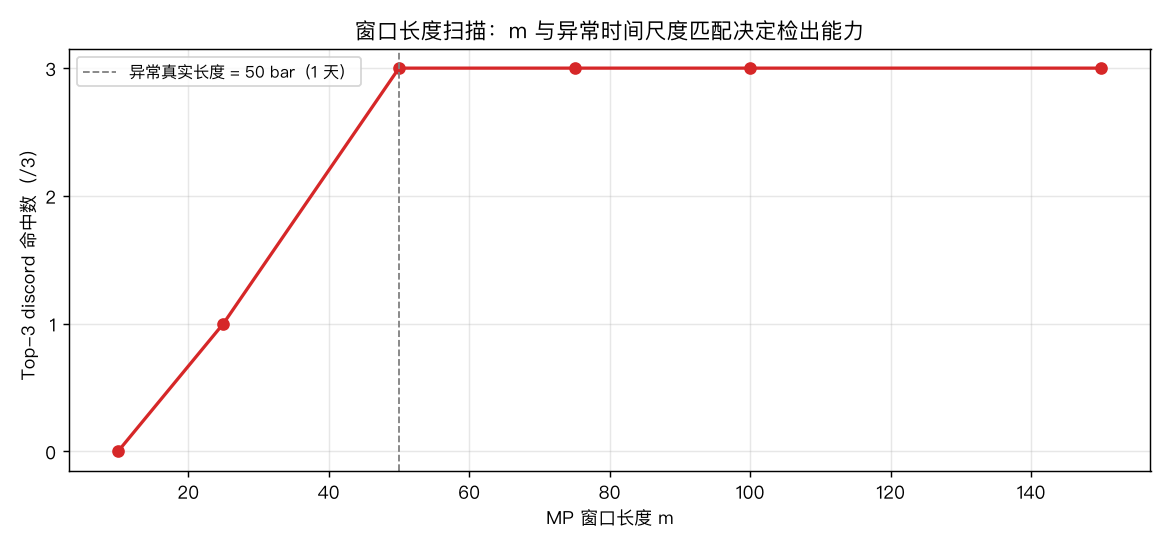
| m | 10 | 25 | 50 | 75 | 100 | 150 |
|---|---|---|---|---|---|---|
| 命中数 | 0/3 | 1/3 | 3/3 | 3/3 | 3/3 | 3/3 |
m=10(异常长度的 1/5)时全灭:窗口太短,闪崩里的一小段下跌、锯齿里的一小段振荡,在本底的噪声片段里都能找到形似的邻居——异常的独特性存在于整体形状,切碎了就不独特了。m ≥ 异常尺度后命中稳定,甚至 m=150(3 天窗口)也保持 3/3,因为包含异常日的任何窗口都被异常段”污染”出独特形状。
实务建议与 Matrix Profile 那篇一致:m 对齐你关心的异常的经济时间尺度——查坏 tick 用分钟级窗口,查异常交易日用单日窗口,宁可偏长不要偏短。
消融三:无异常世界的 MP 峰值也有 5.06#
最后一个必须做的对照:完全不植入异常的结构化本底,MP 峰值仍有 5.06(中位数 3.73)。也就是说,随便拿一条正常序列跑 discord,你总会得到一个”最异常”的片段——argmax 永远存在。
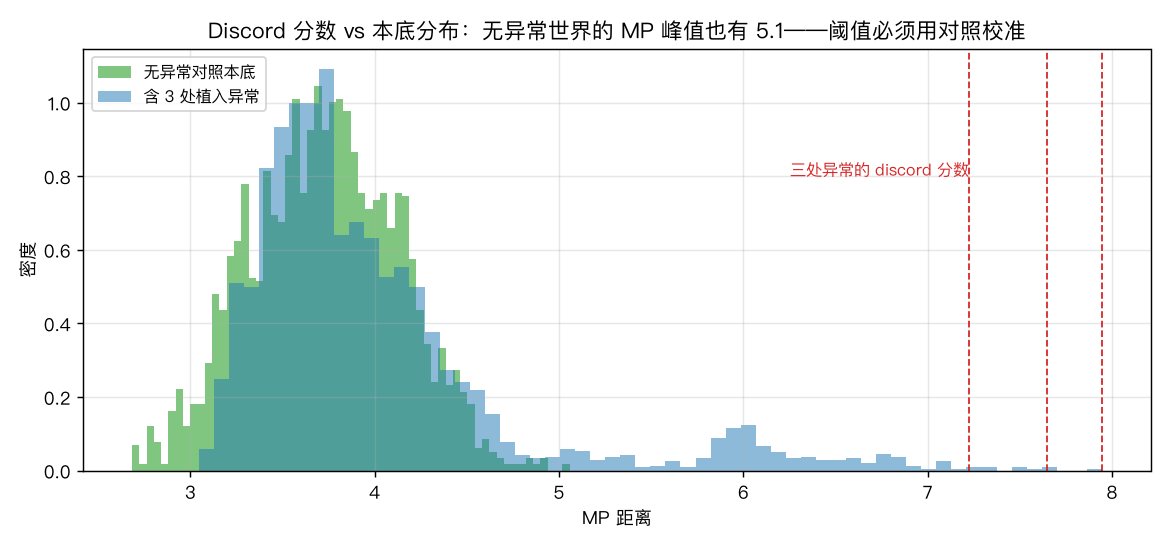
真异常的分数(7.2~8.0)确实显著超出无异常世界的峰值(5.06),但这个界限只有跑了对照才知道。Discord 分数没有天然阈值——5.5 算异常吗?6 呢?唯一严谨的做法是:用历史上确认无事件的时段(或 block bootstrap 重排的代理序列)建立 MP 峰值的本底分布,把 discord 分数转成经验 p 值。直接对着 argmax 喊”发现异常”,和对着随机数据挖模体一样,是无监督方法最常见的自欺。
落地:数据质量监控是最无争议的用法#
把 discord 的三个特性放在一起——无需定义异常、检测形状而非幅度、需要结构化本底——最匹配的落地场景是数据管道监控:
- 坏 tick / 拼接错误:价格源切换、复权因子错误、时区错乱产生的形状都独一无二,且日内数据本底结构强
- 流动性冻结:本实验的”波动冻结”案例——阈值法失明、discord 一击命中的典型
- 交易所异常:熔断、集合竞价异常、做市商撤离产生的微观结构突变
相比之下,“用 discord 找交易信号”的想法要谨慎得多:discord 告诉你这段行情史无前例,但史无前例不等于可交易——你不知道它是机会还是灾难,而且等你确认它是 discord 时(需要右侧数据补全窗口),行情往往已经走完。线上实时场景要用左侧 MP(只和历史比),检测延迟至少一个窗口长度。
A 股注记#
A 股日内数据做 discord 监控有两个本土化细节:14:57~15:00 的收盘集合竞价使最后一根 bar 的形态天然特殊,要么单独建模要么从窗口剔除,否则每天尾盘都是伪 discord;一字板日的”波动冻结”形态(全天一个价)会与数据卡死混淆——需要用成交量区分:涨停板冻结是有量的冻结,数据故障是无量的冻结。停牌复牌的跳空拼接则是真正该被 discord 抓住的目标,不要提前平滑掉。
系列小结#
到这篇为止,时间序列形态挖掘的三件套集齐了:
| 工具 | 问题 | 监督性 | 找什么 |
|---|---|---|---|
| Matrix Profile 模体 | 哪段重复出现? | 无监督 | MP 的谷 |
| Discord(本篇) | 哪段独一无二? | 无监督 | MP 的峰 |
| Shapelet | 哪段能区分类别? | 有监督 | 信息增益最大的形状 |
它们共享同一个前提——序列有可重复的结构——也共享同一个纪律:发现形态、验证形态、交易形态是三件事,每一步都需要独立的证据。