美元棒采样 Dollar Bars:按成交金额而非时钟切分K线
K线按『每5分钟一根』切分是历史遗留而非统计最优:市场信息不按时钟到达,开盘和收盘挤满成交、午盘空转,固定时间间隔意味着信息密集时段被欠采样、清淡时段被过采样,结果是时间棒收益呈现肥尾与波动聚集,直接违反大多数 ML 模型的 iid 近似假设。Dollar Bars 的解法:累计成交金额每达到阈值就切一根 bar,让采样节奏跟着市场活跃度自适应。我们用 Hawkes 自激强度 + 日内 U 型季节性合成 60 个交易日的分钟级市场(14400 分钟,活跃度高度成簇),在等量 bar 数(~1100-1200 根)下对比三种采样:时间棒超额峰度 1.16、Jarque-Bera 统计量 72、绝对收益一阶自相关 0.132;成交量棒分别降到 -0.13 / 2 / 0.013;美元棒做到 -0.01 / 0(正态性检验直接不拒绝)/ -0.035,波动聚集被采样方式本身消解。原理是 Ané-Geman (2000) 的时间变换:以成交活动为『市场时钟』重新计时,收益向高斯回归。文章给出完整合成与采样代码、QQ 图与 bar 时长分布证据,并交代三条实务边界:阈值需随市值漂移动态调整、bar 数量不齐导致多资产对齐成本、以及『分布更正态』不等于『更可预测』。
一句话版本#
时间棒按墙上的钟采样,美元棒按市场自己的钟采样——累计成交金额到阈值就切一根,信息涌入时切得快,市场空转时切得慢,切出来的收益序列显著更接近 iid 高斯。
每 5 分钟一根 K 线,是谁规定的#
日线、小时线、5 分钟线——所有主流行情数据都按固定时间间隔切分。这个约定源于人类的作息和交易所的报表周期,与市场的信息流没有任何关系。
而市场信息的到达是高度成簇的:财报落地后的三分钟可能比午盘三小时承载更多价格发现;开盘和收盘的成交额是午间的数倍。在时钟采样下:
- 信息密集时段被欠采样:一根 5 分钟 bar 里塞进了十根 bar 的信息量,收益出现巨幅跳变——肥尾的直接来源;
- 信息稀疏时段被过采样:午盘的十根 bar 里没有任何新信息,收益挤在零附近——分布中间凸起一个尖峰。
尖峰 + 肥尾 = 超额峰度,再叠加活跃度自身的持续性(今天忙、明天大概率也忙)= 波动聚集。这两个「风格化事实」教科书上通常当作市场的内禀属性,但 Mandelbrot & Taylor (1967) 和 Clark (1973) 早就指出了另一种解读:它们相当程度上是时钟采样的伪影。 如果按成交活动重新计时(所谓 subordinated process / 时间变换),收益分布会向高斯回归。Ané & Geman (2000) 在个股 tick 数据上给出了系统证据;López de Prado 在《Advances in Financial Machine Learning》第 2 章把它工程化为 information-driven bars 家族,美元棒是其中最实用的一种。
三种采样的定义#
统一的框架:选一个「计量器」,累计到阈值就切 bar。
| Bar 类型 | 计量器 | 一根 bar 的含义 |
|---|---|---|
| 时间棒 Time Bars | 经过的时间 | 每 k 分钟 |
| 成交量棒 Volume Bars | 累计成交量(股数) | 每 V 股成交 |
| 美元棒 Dollar Bars | 累计成交金额 | 每 D 元成交 |
美元棒相对成交量棒的优势在长周期上体现:一只股票从 10 元涨到 100 元,同样 100 万股的成交量代表的经济意义差了 10 倍;拆股、增发会让「股数」的含义跳变,而「金额」始终可比。核心实现只有十几行:
def threshold_bars(minute_ret, meter, threshold):
    """累计 meter(成交量或成交金额)达到 threshold 就切一根 bar"""
    bars, acc_meter, acc_ret = [], 0.0, 0.0
    for i in range(len(minute_ret)):
        acc_meter += meter[i]
        acc_ret   += minute_ret[i]
        if acc_meter >= threshold:
            bars.append(acc_ret)
            acc_meter, acc_ret = 0.0, 0.0
    return np.array(bars)

# 阈值定为总额/目标bar数,保证三种bar数量可比
dollar_threshold = dollar_flow.sum() / TARGET_BARS
dollar_bars = threshold_bars(minute_ret, dollar_flow, dollar_threshold)实验:一个活跃度成簇的合成市场#
要公平对比采样方式,需要一个已知信息到达过程的市场。我们合成 60 个交易日、共 14400 分钟:
- 信息到达强度 λ(t) 用 Hawkes 式自激:每个事件抬升后续强度(分支比 0.55,指数衰减),产生成簇的活跃度;
- 叠加日内 U 型季节性:开收盘强度约为午间的 1.9 倍;
- 分钟收益方差 ∝ 事件数:信息多的分钟波动大(这正是 subordination 假设本身);
- 分钟成交量与事件数正相关,成交金额 = 量 × 价。
# Hawkes 式自激强度 + 日内 U 型
base, alpha, decay = 0.3, 0.55, 0.08
excite = 0.0
for t in range(T):
    tod = t % 240                                    # 日内分钟
    seasonal = 1.0 + 0.9 * ((tod/240 - 0.5)**2 * 4)  # U 型
    lam[t] = min((base + excite) * seasonal, 60.0)
    n_events[t] = rng.poisson(lam[t])
    excite = excite*(1-decay) + alpha*decay*n_events[t]

# 收益方差随事件数走:信息驱动波动
minute_ret[t] = 0.0006 * np.sqrt(n_events[t]) * rng.standard_normal()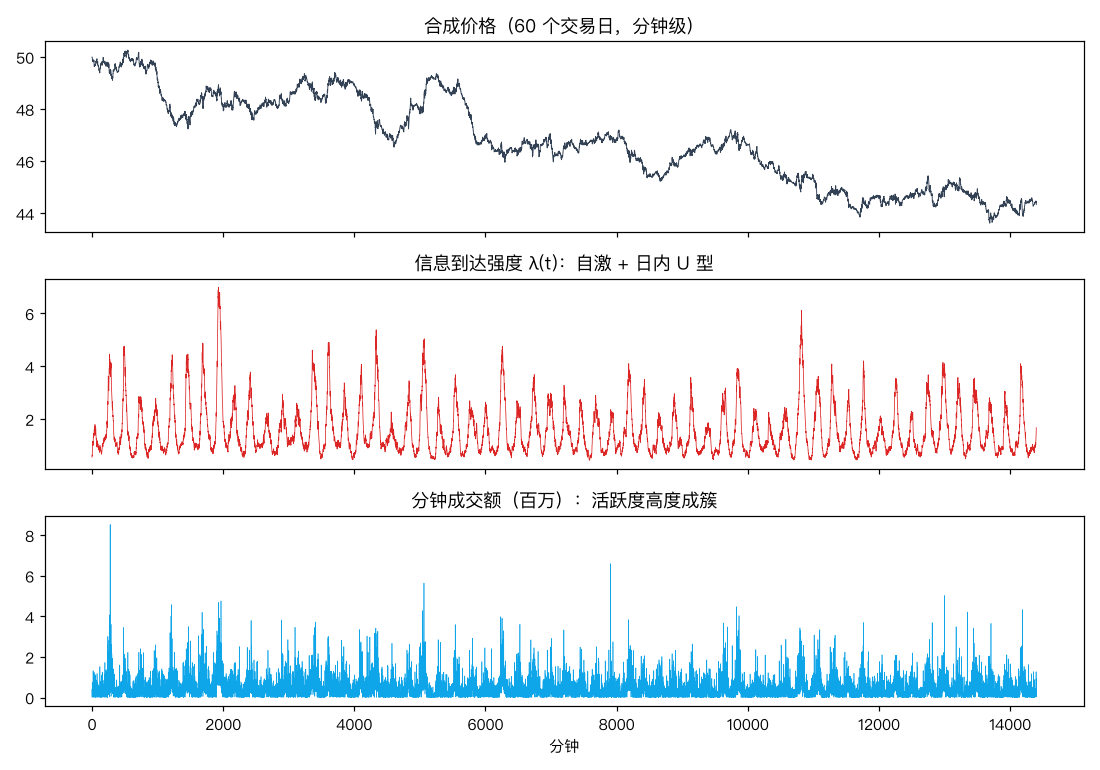
中图的强度 λ(t) 能看到清晰的簇状爆发与日内 U 型齿纹;下图的分钟成交额同样成簇——这就是真实市场里「财报日 vs 平静午盘」的抽象版。
三种采样各切约 1100–1200 根 bar(阈值按总量/目标 bar 数设定,保证公平),对 bar 收益做标准化后检验:
结果:正态性差距是数量级的#
| 指标 | 时间棒 | 成交量棒 | 美元棒 |
|---|---|---|---|
| bar 数 | 1200 | 1098 | 1100 |
| 超额峰度 | 1.16 | −0.13 | −0.01 |
| Jarque-Bera 统计量 | 72 | 2 | 0 |
| 绝对收益一阶自相关 | 0.132 | 0.013 | −0.035 |
三个结论:
-
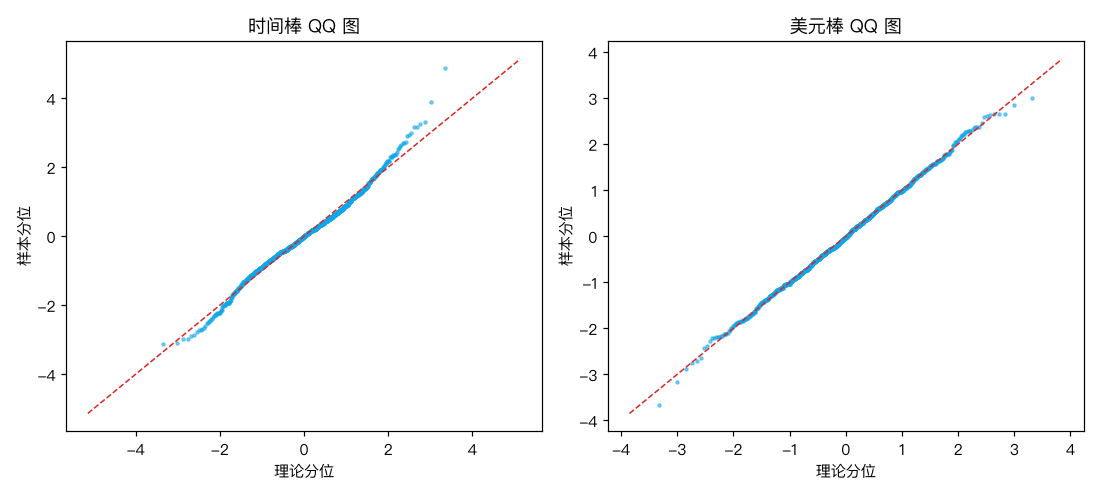
肥尾几乎完全是采样伪影。 同一个市场、同一段价格路径,时间棒超额峰度 1.16(JB=72,正态性在任何常用显著性水平下被拒绝),美元棒 −0.01(JB≈0,无法拒绝正态)。分布形状的差异不来自市场,来自你切数据的方式。
-
波动聚集也被消解了大半。 绝对收益的一阶自相关从 0.132 降到近零。原理直白:活跃期美元棒切得密,每根 bar 承载的信息量被拉平,「大波动跟着大波动」的时钟效应自然消失。对 GARCH 类模型这未必是好事(它就是吃波动聚集的),但对假设样本近独立同分布的 ML 流水线,这是实打实的前处理增益。
-
成交量棒已经拿到大部分收益,美元棒更进一步。 本实验里两者接近,因为合成价格漂移小、量价含义没有大幅漂移;真实市场里跨越数年的回测中,美元棒的稳健性优势会拉开。
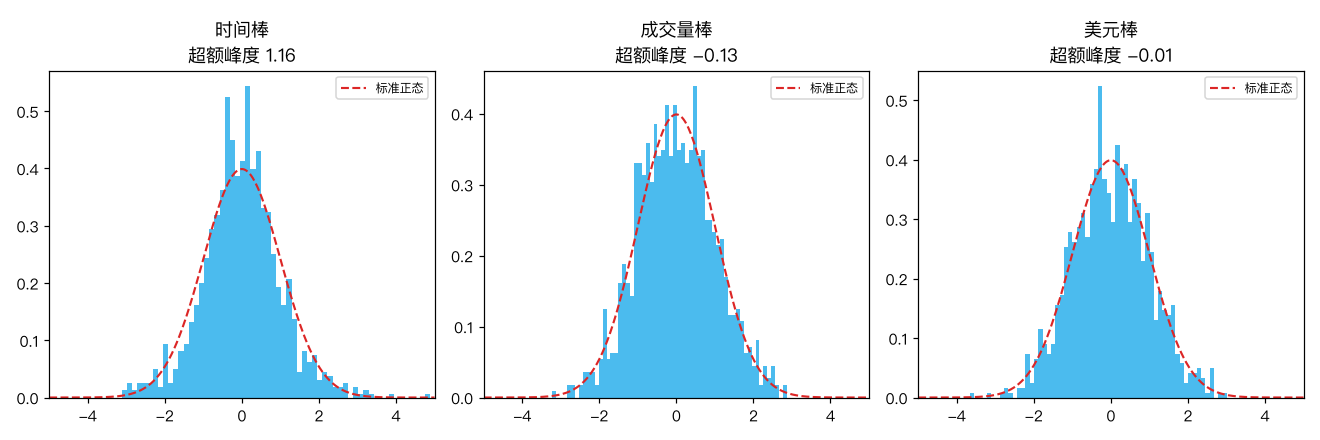
QQ 图把差异看得更细:时间棒在两侧尾部系统性偏离对角线(肥尾),美元棒几乎贴线:
美元棒的自适应性长什么样#
每根美元棒覆盖的分钟数分布,直接可视化「市场时钟」与墙上时钟的差异:
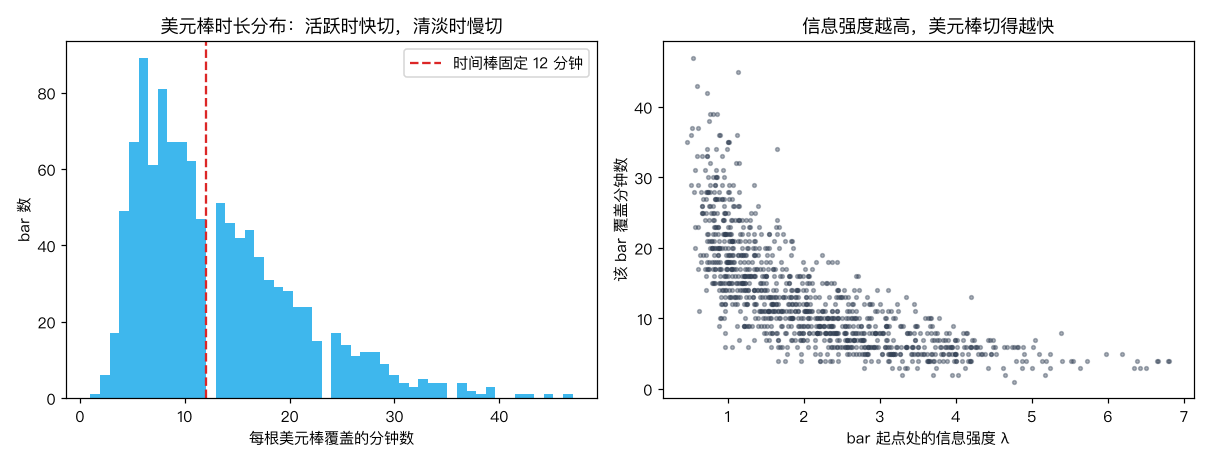
时间棒固定 12 分钟一根(红色虚线);美元棒的时长从 2 分钟到 60+ 分钟不等——右图显示 bar 起点处信息强度 λ 越高,该 bar 覆盖的分钟数越少。采样频率成了市场活跃度的函数:财报爆发时一分钟切三根,午盘空转时一小时切一根。下游模型看到的每根 bar,承载的信息量大致相等——这正是「iid 近似」得以改善的机制。
三条实务边界#
第一,阈值不能一劳永逸。 固定美元阈值在牛市里会越切越密(价格涨了,同样的换手对应更多金额)、熊市里越切越疏,bar 数量随行情漂移。实务上用滚动窗口的日均成交额动态校准阈值(如目标「每天约 N 根 bar」),或用 EWMA 跟踪。这一步做不好,你只是把「时钟不均匀」换成了「阈值不均匀」。
第二,多资产对齐成本高。 时间棒天然对齐(所有资产的 15:00 是同一时刻),美元棒每只资产的 bar 边界都不同,截面策略(配对、组合再平衡)需要额外的对齐层——通常是「以慢资产的 bar 为主时钟、快资产向其对齐」或退回混合方案:信号特征用美元棒计算,组合层面用日频对齐。这笔工程成本在单资产 CTA 里不存在,在 500 只股票的截面框架里不可忽视。
第三,分布更正态 ≠ 更可预测。 美元棒改善的是统计性质(峰度、独立性),不是信息含量。一个在时间棒上没有 alpha 的特征,换到美元棒上大概率还是没有。它的正确定位是 ML 流水线的前处理:让后续的标注(如三重障碍法)、抽样加权和交叉验证的假设更接近成立,而不是直接创造收益。预测力的来源仍然要靠特征和标签设计。
与更激进的采样方式的关系#
美元棒只用了「活动量」,没用「方向」。信息驱动 bar 家族里更激进的成员——失衡棒(imbalance bars)——进一步累计带方向的订单流,在买卖失衡超阈值时切 bar,试图在知情交易者动手时加密采样。方向判定依赖 tick rule 或逐笔主动性标记,实现复杂度和对数据质量的要求都高一个台阶;美元棒是这个家族里性价比最高的入门款:只需要分钟级量价数据,就能把峰度从 1.16 砍到 0。
顺带一提,本实验合成市场用的 Hawkes 自激过程本身就是订单流建模的主力工具,对其感兴趣可移步自激点过程与订单流。
结语#
「每 5 分钟一根 K 线」不是自然规律,是电报时代的路径依赖。市场有自己的钟——成交金额就是最容易读到的钟面。把采样从墙上的钟切换到市场的钟,一段代码不到二十行,换来的是峰度归零、波动聚集消解、ML 假设从「明显违反」变成「大致成立」。在特征工程越来越卷的今天,改采样这一层的性价比,往往高于在坏采样上堆更复杂的模型。
完整合成过程、采样实现与检验代码均在文中,固定随机种子可复现全部数字。