DTW 重心平均:对齐时间扭曲后求出K线形态的『平均脸』
『把 20 段 V 形恐慌-回补走势平均一下』听起来无害,但逐点算术平均是形态学的绞肉机:每段下跌时长 5~14 天随机、底部位置随机,逐点平均把错位的底相互抵消——实测平均后的 V 形深度只剩 -0.62,而样本真实平均深度是 -1.03,形态被抹掉 40%。DBA(Petitjean 2011)的解法:先用 DTW 把每段序列与当前重心逐点对齐(允许时间轴伸缩),把对齐到同一坐标的所有点取均值,迭代到收敛。实测 DBA 重心深度 -1.02 几乎完美还原,到样本的平均 DTW 距离从逐点平均的 0.907 降到 0.351(改善 61%),且目标函数单调下降。模板分类实验暴露完整依赖链:V 形单底 vs W 形双底(深度相同、位置时长随机,判别信息只在形状),逐点平均模板+欧氏距离准确率 53%(≈抛硬币)、逐点模板+DTW 50%、DBA 模板+DTW 88%——模板和度量必须同时懂时间扭曲,换任何一半都直接坍塌回随机线。三盆冷水:DTW 对齐自由度本身是过拟合来源(无窗口约束的 DTW 能把任何两段序列都对齐得很像)、DBA 是局部最优且对初始化敏感、『平均形态存在』不等于『形态有预测力』——DBA 只回答形态学问题,交易价值要靠时间外检验另行审判。
一句话版本#
逐点算术平均会把时间上错位的形态相互抵消掉;DBA 先用 DTW 把时间轴对齐、再对”对齐后的同类点”取均值,从而保住形态。 一句话之外的所有内容,都是在回答两个问题:抹掉了多少?保住之后有什么用?
一个看似无害的需求#
假设你从十年日内数据里挖出了 20 段”恐慌下杀后 V 形回补”的走势——可能来自 Matrix Profile 模体发现,可能来自 SAX 词典检索。现在你想回答一个再自然不过的问题:
这 20 段走势的”典型形态”长什么样?
直觉做法:把 20 条序列逐点平均。这是形态学的绞肉机,原因藏在一个被忽略的事实里——同一形态在不同实例里的时间轴是弹性的。有的恐慌 5 天跌完,有的磨了 14 天;有的底在第 20 根 bar,有的在第 35 根。逐点平均时,A 样本的底遇到的是 B 样本的横盘、C 样本的下跌中段——错位的极值互相抵消,平均出来的是一条被稀释的、幅度缩水的”糊状曲线”。
实测数据:20 段合成 V 形(深度 0.81.2 随机、下跌时长 514 bar 随机、回补时长 10~30 bar 随机、起点随机、噪声 σ=0.06),样本真实平均深度 -1.03,逐点平均后的曲线深度只剩 -0.62——形态被抹掉 40%。用这条被稀释的曲线当模板去匹配新样本,等于拿一张重影的照片去认人。
DTW:先解决”哪个点对应哪个点”#
问题的根源是逐点平均隐含了”第 i 根 bar 对应第 i 根 bar”的刚性假设。DTW(Dynamic Time Warping)把这个假设换成弹性对齐:允许一条序列的一个点对应另一条的多个点(时间拉伸),或多个点对应一个点(压缩),在所有合法对齐里找总代价最小的那条路径。
import numpy as np

def dtw_path(a, b, window=None):
    """返回 DTW 距离和最优对齐路径 [(i,j), ...]"""
    n, m = len(a), len(b)
    if window is None:
        window = max(n, m)
    D = np.full((n + 1, m + 1), np.inf)
    D[0, 0] = 0
    for i in range(1, n + 1):
        lo, hi = max(1, i - window), min(m, i + window)
        for j in range(lo, hi + 1):
            cost = (a[i - 1] - b[j - 1]) ** 2
            D[i, j] = cost + min(D[i - 1, j - 1],   # 对角:正常前进
                                 D[i - 1, j],        # 竖直:a 被压缩
                                 D[i, j - 1])        # 水平:a 被拉伸
    # 回溯最优路径
    path, (i, j) = [], (n, m)
    while i > 0 and j > 0:
        path.append((i - 1, j - 1))
        step = np.argmin([D[i-1, j-1], D[i-1, j], D[i, j-1]])
        if step == 0:   i, j = i - 1, j - 1
        elif step == 1: i -= 1
        else:           j -= 1
return np.sqrt(D[n, m]), path[::-1]window 是 Sakoe-Chiba 带宽约束:只允许对齐路径偏离对角线 window 步以内。这不是可有可无的加速技巧,后面会讲它是防过拟合的生命线。
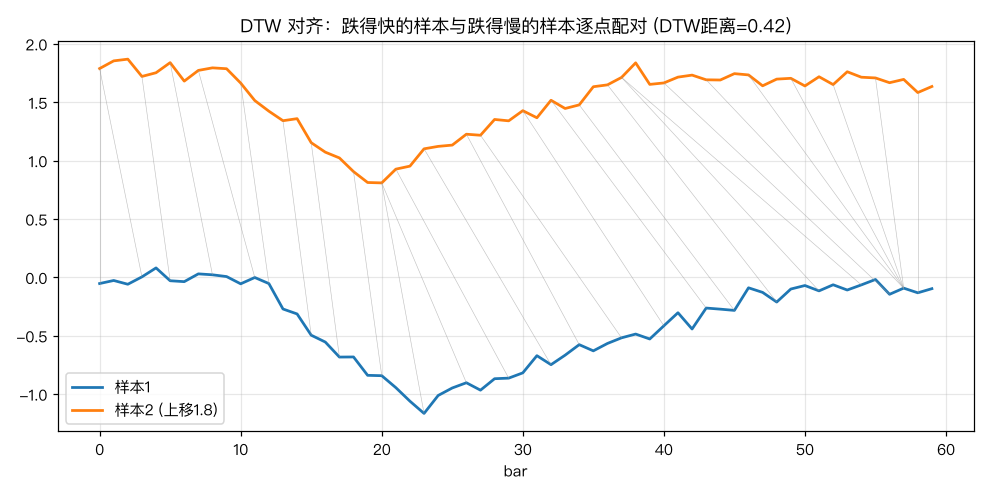
图里灰色连线是最优对齐:跌得快的样本的陡峭段被”拉伸”去匹配跌得慢的样本的漫长下跌段——两个 V 底被正确地连在了一起,尽管它们在原始时间轴上相距十几根 bar。
DBA:在 DTW 几何下求”平均脸”#
有了对齐工具,平均的正确姿势是什么?Petitjean、Ketterlin、Gançarski 2011 年的 DBA(DTW Barycenter Averaging)给出的答案是一个 EM 风格的迭代:
- 初始化:选一条现有序列当初始重心(推荐 medoid——到其他所有序列平均 DTW 距离最小的那条)
- E 步(对齐分配):把每条样本序列与当前重心做 DTW,按最优路径把样本的每个点”分配”给重心的某个坐标
- M 步(重心更新):重心的每个坐标更新为分配到它名下的所有点的均值
- 重复 2-3 直到收敛
def dba(series_list, n_iter=10, window=None):
    # medoid 初始化
    n = len(series_list)
    dmat = np.zeros((n, n))
    for i in range(n):
        for j in range(i + 1, n):
            d, _ = dtw_path(series_list[i], series_list[j], window)
            dmat[i, j] = dmat[j, i] = d
    center = series_list[np.argmin(dmat.sum(axis=1))].copy()

    for it in range(n_iter):
        assoc = [[] for _ in range(len(center))]
        for s in series_list:
            _, path = dtw_path(center, s, window)
            for (ci, sj) in path:          # E步:按对齐路径分配
                assoc[ci].append(s[sj])
        center = np.array([np.mean(pts) if pts else center[k]
                           for k, pts in enumerate(assoc)])  # M步:坐标均值
return center关键性质:每轮迭代都单调降低目标函数(重心到所有样本的 DTW² 距离和),因为 M 步在固定对齐下是闭式最优解。这继承自 k-means 的收敛逻辑——也意味着继承了 k-means 的所有毛病(局部最优、初始化敏感),后面冷水部分细说。
实测:抹掉的 40% 被找回来了#
20 段随机扭曲的 V 形样本,两种平均法对比:
| 指标 | 逐点算术平均 | DBA 重心 |
|---|---|---|
| 到样本的平均 DTW 距离 | 0.907 | 0.351(改善 61%) |
| 重心形态深度 | -0.62 | -1.02 |
| 样本真实平均深度 | -1.03 | -1.03 |
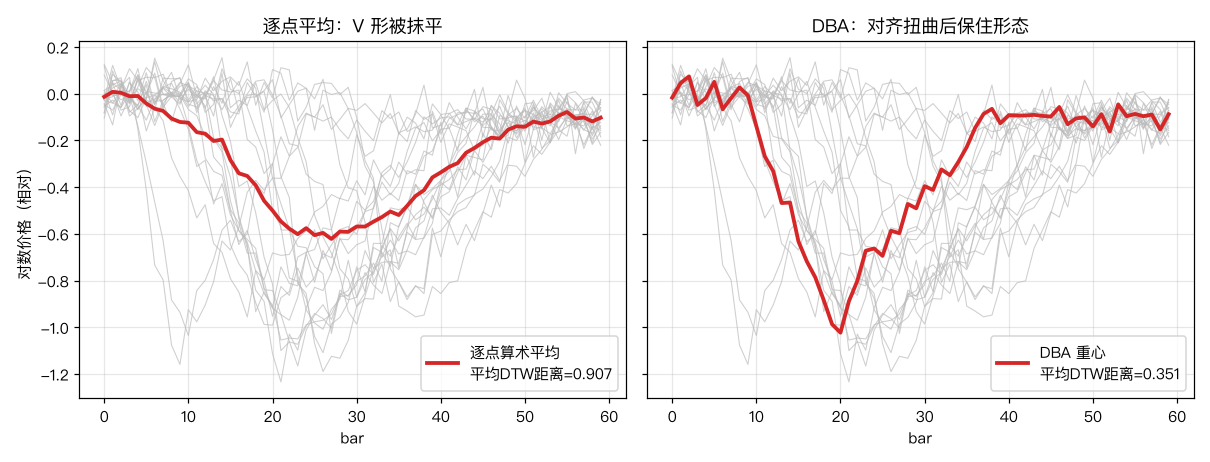
左图逐点平均的红线是一个又浅又宽的糊状盆地;右图 DBA 的红线是一个深度几乎与样本真值一致的干净 V 形。DBA 不是把形态”锐化”了——它只是没把形态抹掉。 那 40% 的深度从来就在数据里,是刚性时间轴假设把它抵消掉的。
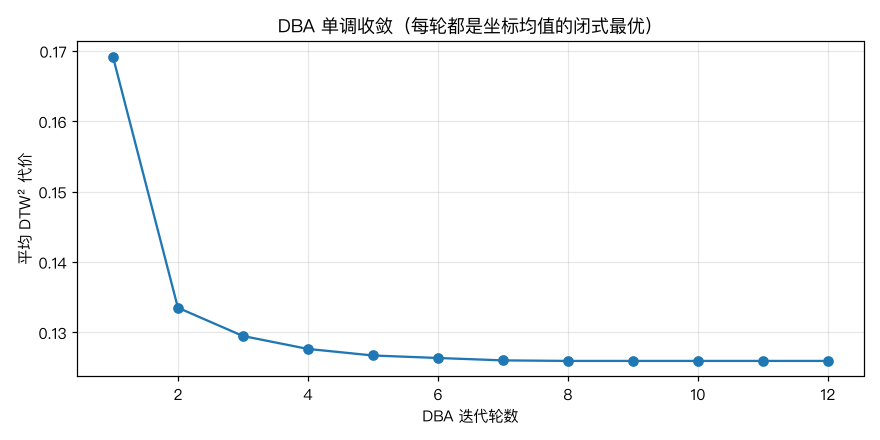
目标函数 12 轮迭代单调下降,前 3 轮完成绝大部分改善——实务中 5~10 轮足够。
模板分类实验:依赖链上一环都不能少#
平均形态好看不是目的,能用才是。设计一个对形态学有区分度的分类任务:V 形单底 vs W 形双底——两类深度分布相同(0.8~1.2)、起点随机、各段时长随机,唯一的判别信息是”跌到底后直接回补”还是”回补一半再探底”。各 30 条测试样本,用”到两类模板的距离谁近”做 1-NN 分类:
| 模板 + 度量 | 分类准确率 |
|---|---|
| 逐点平均模板 + 欧氏距离 | 53.3%(≈抛硬币) |
| 逐点平均模板 + DTW 距离 | 50.0%(抛硬币) |
| DBA 模板 + DTW 距离 | 88.3% |
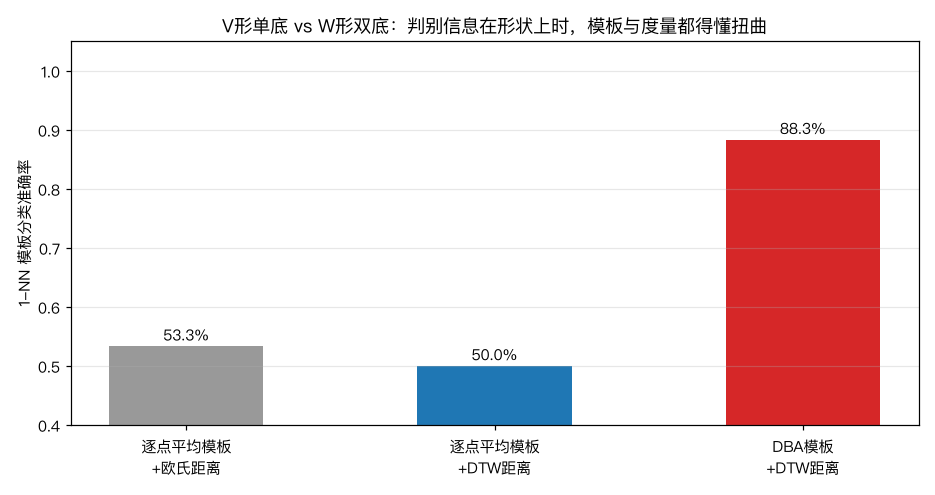
这张表比任何理论论述都锋利:
- 只换度量不换模板(第 2 行)毫无帮助:逐点平均出来的 V 形模板和 W 形模板都被抹成了相似的浅盆地,两个模板本身就长得差不多,再好的度量也测不出差异。垃圾模板 + 精确度量 = 精确地测量垃圾。
- 模板和度量必须同时升级:DBA 模板保住了”单底 vs 双底”的结构差异,DTW 度量容忍测试样本的时间扭曲,两者缺一不可。
- 剩下约 12% 的错误来自噪声下 W 形的中间反弹被淹没——这是任务本身的贝叶斯误差,不是方法的锅。
对做形态特征工程的人,这个实验的寓意是:如果你的 pipeline 里有任何一步做了”逐点对应”的隐性假设(逐点平均、逐点相关、固定滞后回归),而你的形态在时间轴上有伸缩,那一步就在漏信息。
三盆冷水#
第一盆:DTW 的对齐自由度本身是过拟合来源。 无窗口约束的 DTW 拥有病态的弹性——它可以把一根 bar 拉伸到匹配几十根 bar,把任何两条大致同向的序列都对齐得”很像”。金融数据信噪比低,无约束 DTW 会把噪声也对齐掉,距离度量退化成”趋势方向是否一致”。Sakoe-Chiba 窗口必须设(本文实验 window=20,序列长 60),窗口大小和 SAX 的字长一样,是隐式定义”相似容忍度”的超参数,必须在时间外样本上验证。
第二盆:DBA 是局部最优,且对初始化敏感。 目标函数(DTW 距离平方和)非凸,medoid 初始化只是工程上的稳妥选择,不保证全局最优。样本里如果混入了两种真实形态(比如一半 V 形一半 W 形),DBA 会强行平均出一个谁都不像的四不像——先聚类再平均(DBA 配 k-means 就是 DTW k-means)是标准流程,直接对未分群的样本跑 DBA 是常见误用。
第三盆:平均形态存在 ≠ 形态有预测力。 DBA 回答的是纯形态学问题:“这些片段的共同形状是什么”。它对”看到这个形状后市场接下来会怎样”保持完全沉默。Matrix Profile 文章里的教训在这里同样适用:模体重复出现、平均脸清晰漂亮,事件研究照样可以毫无预测力。DBA 模板的正确用途是检索与监控(找出历史上所有类似当前走势的时期、监控形态漂移),把它接到交易信号上之前,隔着时间外检验、多重检验校正、成本容量三座大山。
在工具链里的位置#
DBA 是形态学流水线的”压缩”环节:
- 盘点:Matrix Profile 无监督找出重复形态的实例集合
- 检索加速:SAX 把十亿级序列压成可哈希的词做粗召回
- 压缩表示:DBA 把每簇实例压成一条可解释、可画出的模板(本文)
- 判别筛选:Shapelet 用监督信息筛出真正有判别力的形状
- 审判:时间外事件研究决定它有没有交易价值
DBA 的独特贡献是可解释性:一条能画在研报里、能给风控看、能和交易员讨论的”平均脸”,比一个 128 维嵌入向量在组织里走得远得多。
参考文献#
- Petitjean, F., Ketterlin, A., & Gançarski, P. (2011). A global averaging method for dynamic time warping, with applications to clustering. Pattern Recognition, 44(3), 678-693.
- Sakoe, H., & Chiba, S. (1978). Dynamic programming algorithm optimization for spoken word recognition. IEEE Transactions on Acoustics, Speech, and Signal Processing, 26(1), 43-49.
- Petitjean, F., Forestier, G., Webb, G. I., et al. (2014). Dynamic Time Warping Averaging of Time Series Allows Faster and More Accurate Classification. ICDM 2014.
- Paparrizos, J., & Gravano, L. (2015). k-Shape: Efficient and Accurate Clustering of Time Series. SIGMOD 2015.