熵特征工程:用信息熵度量价格序列的『可预测性』
波动率告诉你市场动得多猛,熵告诉你市场动得多『乱』——同样 1% 的日波动,趋势机制块熵 0.956、随机游走 0.980,那 0.024 bit 的差距就是动量策略的全部生存空间。260 段随机 AR(1) 实测:样本内块熵与未来 120 天可预测性相关 -0.65,熵是少数能对『未来』说话的样本内统计量。落地成过滤器:趋势/随机游走交替市场上,35 分位熵阈值让动量 Sharpe 从 0.40 升到 0.50、最大回撤从 0.54 砍到 0.25、持仓时间只剩 35%——它赚的不是更多的钱,是躲掉的亏损。三盆冷水最值钱:符号编码丢掉幅度信息(跳空 8% 和阴跌 0.1% 同为一个 0)、窗口-块长组合的统计量噪声大到 60 天窗口只够分辨『很乱』和『不那么乱』、低熵只说明有结构不说明结构是什么——均值回复段的低熵会诱导动量满仓接刀。熵过滤器的正确定位是否决权而非指挥权:它有资格说『这段别交易』,没资格说『这段该做多』(中阶)。
波动率量的是猛,熵量的是乱#
两段行情,日波动率都是 1%。第一段是缓慢爬升的趋势市,第二段是纯抛硬币的随机游走。任何用波动率、ATR、方差做的风控系统都会把它们当同一种东西——但对一个动量策略来说,前者是提款机,后者是绞肉机。
区分它们需要一个不同维度的统计量:不问”动得多大”,问”动得多有规律”。这正是信息熵的本职工作。
香农熵度量一个序列的不确定性。对二值序列(今天涨=1,跌=0),如果每天完全独立且各 50% 概率,每个符号携带正好 1 bit 的不确定性——这是熵的上限,对应完全不可预测。任何低于 1 bit 的部分,都意味着序列里存在统计结构:某些模式出现得比随机情形更频繁,而模式,就是一切量化策略赖以生存的东西。
换句话说:熵是可预测性的负象。熵越低,序列里可供策略开采的结构越多。
块熵:十几行代码的实现#
直接对单个符号算熵没有意义(涨跌各半的序列熵永远接近 1)。有信息量的是块熵——把序列切成长度为 w 的滑动窗口”词”,统计词频分布的熵,再归一到每符号:
import numpy as np

def block_entropy(bits, w=3):
    """插入式块熵,归一到每符号比特"""
    bits = np.asarray(bits, dtype=int)
    n = len(bits) - w + 1
    words = {}
    for i in range(n):
        key = tuple(bits[i:i + w])
        words[key] = words.get(key, 0) + 1
    p = np.array(list(words.values()), dtype=float) / n
    return -np.sum(p * np.log2(p)) / w

def rolling_entropy(returns, win=100, w=3):
    """滚动窗口块熵,符号编码保留漂移信息"""
    out = np.full(len(returns), np.nan)
    for t in range(win, len(returns)):
        seg = returns[t - win:t]
        bits = (seg > 0).astype(int)   # 涨=1 跌=0
        out[t] = block_entropy(bits, w)
return out直觉:趋势市里”111”(连涨三天)出现的频率远高于随机情形,词频分布偏斜,熵下降。随机游走里 8 种三字词等概率出现,熵贴着 1 bit 的天花板。
实测:三种机制的熵指纹#
构造三段等波动率的合成行情——AR(1) 趋势机制(φ=0.35 加漂移)、OU 均值回复(κ=0.15)、纯随机游走——各 1500 天,跑 100 天窗口、块长 3 的滚动熵:
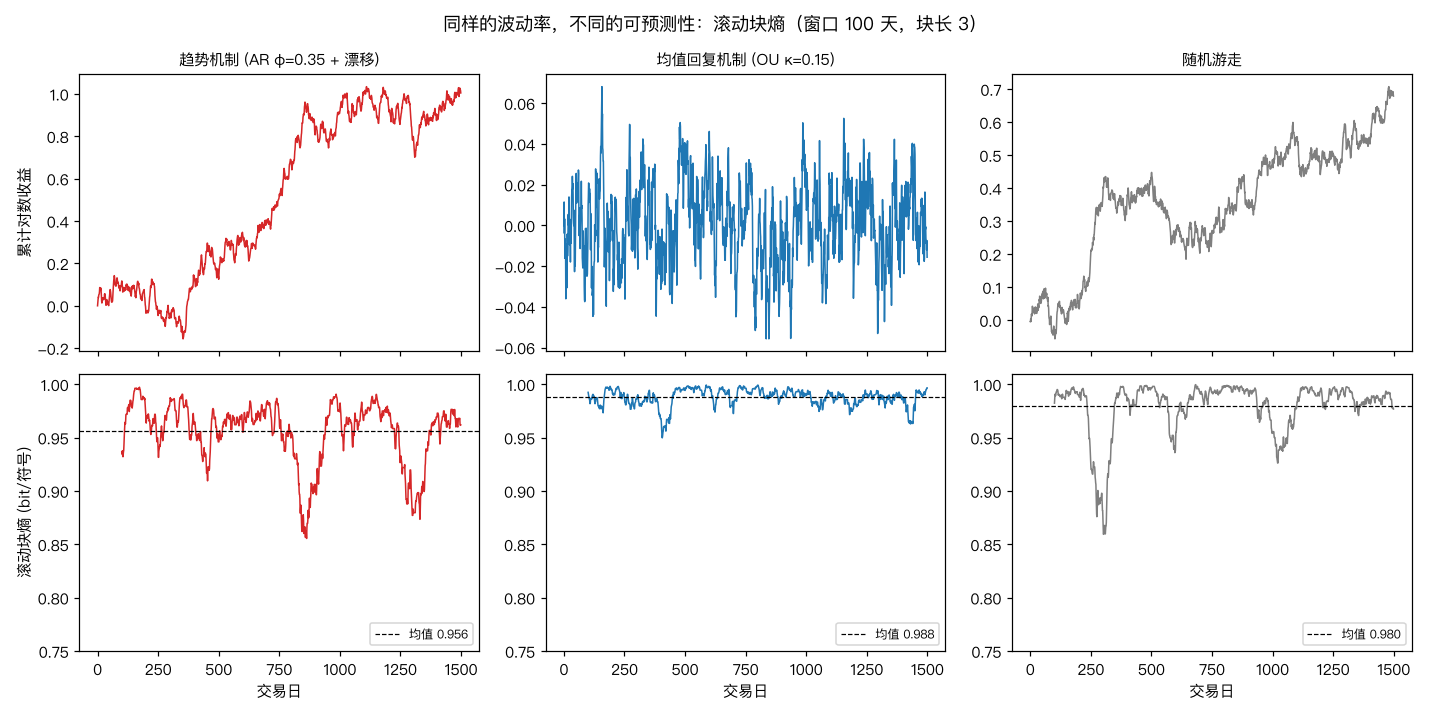
| 机制 | 平均块熵 (bit/符号) |
|---|---|
| 趋势 (AR φ=0.35 + 漂移) | 0.956 |
| 均值回复 (OU κ=0.15) | 0.988 |
| 随机游走 | 0.980 |
三个值得盯住的细节:
-
差距很小但方向确定。趋势机制比随机游走低 0.024 bit——听起来微不足道,但记住熵的天花板是 1,地板由机制强度决定。真实市场的自相关比 φ=0.35 弱得多,可开采的熵缺口只会更小。量化策略的全部生存空间,就藏在这零点零几个 bit 里。
-
符号编码下均值回复段的熵反而高于随机游走。原因:OU 过程的涨跌符号在日频上负自相关很弱,而”涨跌交替”模式(0101)与”连涨连跌”模式(0011)对块熵的贡献是对称的——块熵探测的是任何偏离均匀的结构,但结构太弱时探测不到。想抓均值回复,得换编码(比如按与均值的偏离方向编码)。
-
滚动熵本身噪声很大。100 天窗口里只有 98 个三字词,8 个桶的频率估计标准误足以吞掉 0.01 级别的真实差异。这决定了熵特征的正确用法:分位数阈值,而不是绝对值。
关键验证:熵对『未来』有没有话语权#
样本内统计量千千万,绝大多数对未来一言不发。熵是不是其中一员?
做一个干净的实验:生成 260 段随机 AR(1) 过程(φ 在 ±0.55 均匀抽取),每段用前 220 天算块熵,再看之后 120 天的一阶自相关绝对值(可预测性的代理):
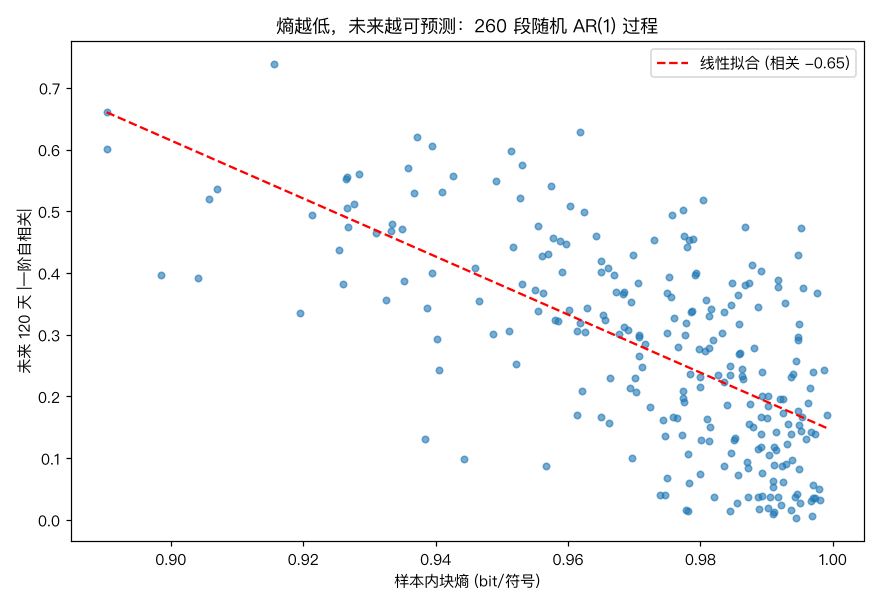
相关系数 -0.65。样本内熵低的段,未来确实更可预测。这不是魔法——AR 系数是持续的,熵只是把”这段过程有结构”这个事实测量了出来,而结构会延续到未来。但这个实验划清了熵的能力边界:它的预测力完全来自机制的持续性。如果市场机制切换比你的熵窗口还快,熵读数就是刻舟求剑。
落地:熵过滤动量策略#
最自然的用法不是把熵当信号,而是当过滤器:动量策略只在低熵(有结构)时段开仓,高熵(近似随机)时段空仓旁观。
构造一个 3600 天的机制切换市场:150 天趋势段(φ=0.45,漂移方向交替)与 150 天随机游走段交替。策略是最土的 20 日动量(回看收益符号定方向,次日执行),对照组加一层熵过滤:60 天滚动熵低于其 35 分位才持仓。单边成本 10bp:
H = rolling_entropy(r, win=60, w=3)
threshold = np.nanquantile(H, 0.35)          # 分位数阈值,不用绝对值
position = np.where(H < threshold, momentum_signal, 0.0)
ret = position * r - 0.001 * np.abs(np.diff(position, prepend=0.0))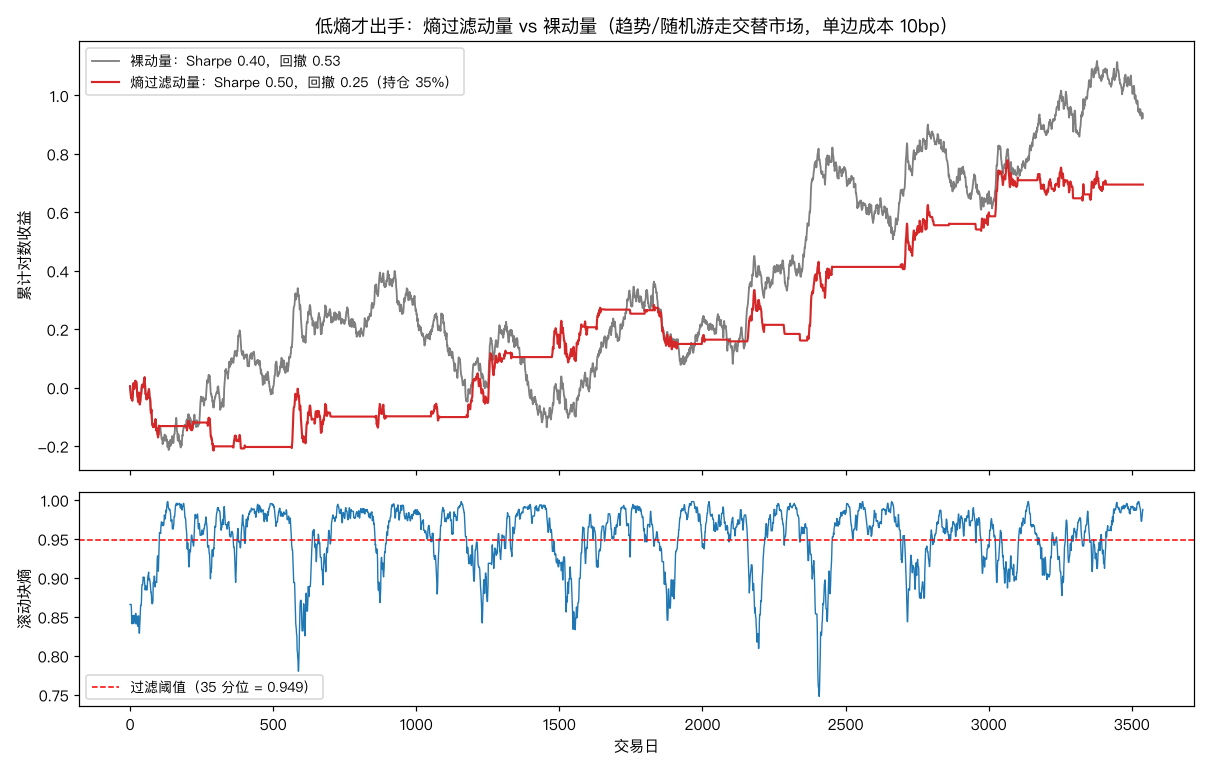
| 策略 | 年化 Sharpe | 最大回撤(对数) | 持仓占比 |
|---|---|---|---|
| 裸动量 | 0.40 | 0.535 | 100% |
| 熵过滤动量 | 0.50 | 0.250 | 35% |
先验证过滤器确实在做正确的事:趋势段平均熵 0.934,随机游走段 0.968——熵确实分得开两种机制。
然后看账本。Sharpe 从 0.40 到 0.50 的提升不算惊艳,真正的价值在另外两个数字:最大回撤从 0.535 砍到 0.250(减半还多),而持仓时间只有 35%。裸动量在随机游走段的表现是负期望减去交易成本的双重放血——动量信号在无结构市场里就是抛硬币,而抛硬币还要付 10bp 过路费。熵过滤器赚的不是更多的钱,是躲掉的亏损和省下的成本。
单位持仓时间的收益效率提升了近三倍。对任何有资金机会成本的账户,这才是熵过滤的真实卖点。
敏感性:这个结果稳吗#
任何单点参数的回测结果都可能是运气。扫一遍阈值分位(25%~100%,100% 即不过滤)× 熵窗口(60/100/150 天):
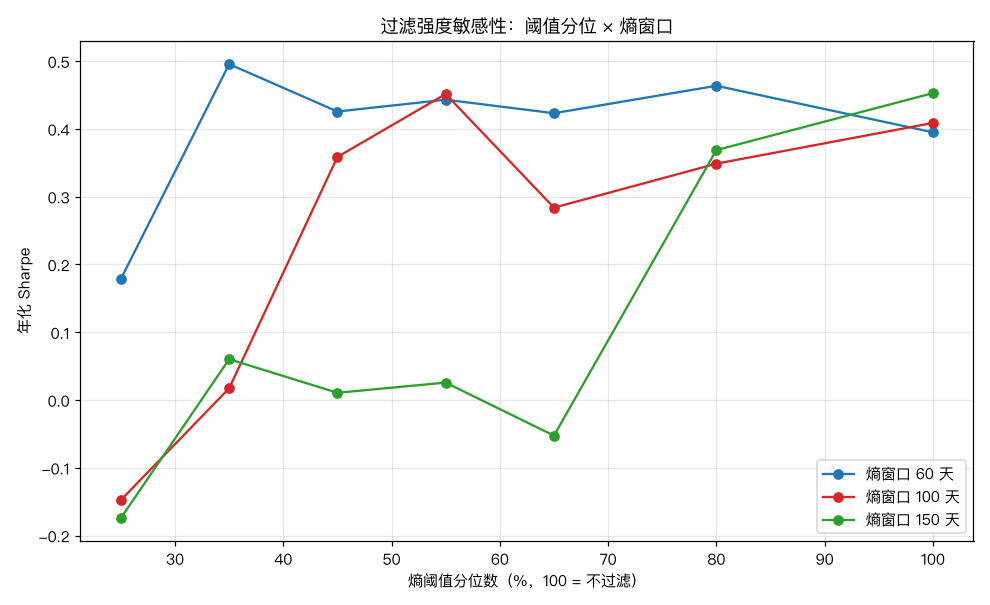
诚实地读这张图:
- 60 天窗口全域最稳:从 35 分位到 80 分位 Sharpe 都在 0.42-0.50 之间,高于不过滤的 0.40。窗口与机制段长(150 天)的比例是关键——窗口必须显著短于机制持续时间,否则一个窗口横跨两种机制,熵读数是两团噪声的平均。
- 150 天窗口全面翻车:大部分阈值下 Sharpe 低于不过滤。窗口恰好等于段长,滚动熵永远在追赶上一个机制,过滤信号系统性滞后。
- 过严的阈值(25 分位)在所有窗口下都受伤:持仓时间太短,趋势段的盈利机会被一并扔掉。
结论:熵过滤的参数敏感性主要集中在窗口与机制时长的比例上,阈值分位在 35-65% 之间相对钝感。实盘中机制时长未知,这是最大的不确定性来源。
三盆冷水#
第一盆:符号编码扔掉了幅度信息。 涨 8% 和涨 0.1% 都编码成 1,跳空崩盘和阴跌横盘都是 0。块熵眼里的”有序”只是方向序列的有序。改进方向是多分位离散化(比如按收益三分位编码成 0/1/2),但字母表变大后,同样窗口下每个词的频率估计误差急剧膨胀——100 天窗口配 3 字母、块长 3 就已经有 27 个桶,统计上接近破产。编码粒度和估计精度是一对刚性矛盾,窗口长度决定了你最多能负担多细的编码。
第二盆:熵是慢变量,别拿它做快决策。 60 天窗口意味着机制切换后至少几十天熵读数才能反映现实。上面实测里过滤器能赚钱,是因为合成市场的机制段长达 150 天。如果真实市场的机制以周为单位切换,熵过滤器会永远慢半拍——在趋势启动后才放行、在趋势死亡后才禁足。熵适合做周频以上的机制仪表盘,不适合做日内开关。
第三盆:低熵 ≠ 该做多,甚至 ≠ 该做动量。 低熵只说明”有结构”,不说明结构是什么。一段强均值回复行情在合适的编码下同样是低熵的,此时放行动量策略等于满仓接刀。本文的实验里过滤器有效,是因为市场只有”趋势”和”随机”两种机制,低熵与趋势恰好一一对应——这是实验设计送的礼物,不是熵的功劳。实盘中熵过滤器必须与方向性诊断(比如自相关符号)配合:熵回答”有没有戏”,别的特征回答”是哪出戏”。
写在最后#
熵特征工程的正确定位,是给策略一个否决权而不是指挥权。它不产生信号,它审查环境:这段行情里到底有没有统计结构可供开采?没有,就把手从键盘上拿开。
对表现时好时坏的策略,与其继续调参数,不如先查一查它亏损的时段是不是恰好熵贴着 1 bit 的天花板——如果是,问题不在策略,在于那段时间任何策略都没有东西可赚。知道什么时候不交易,和知道怎么交易一样值钱,而前者便宜得多:十几行代码,一个滚动窗口。