指数梯度组合 EG:用乘性更新在线追踪最优资产权重
EG(Helmbold-Schapire-Singer-Warmuth 1998)是在线组合选择里的『轻量派』:Cover 通用组合要对整个单纯形做指数开销的积分,EG 只用一行乘性更新——每天把权重乘上 exp(η·相对收益) 再归一化,计算量 O(m),天然保持权重为正且和为一。翻倍-暴跌交替市场 3000 日实测:η=0.01 的 EG 对数财富 175.0,紧咬事后最优 CRP(b*=0.70,对数财富 107.6 的遗憾仅 6.7),而买入持有波动资产归零(2e-271)。η 敏感性扫描呈单谷形:η=0.01 遗憾 6.7 最优,η=1.0 遗憾 273——乘性更新对学习率的容忍度远比教科书想象的窄。regime 切换市场上 η=0.15 终值 85.2 vs η=0.03 的 59.1:理论最优的小 η 在结构突变市场跑输大 η,因为 O(√T) 遗憾界是对最坏情况的保险,而切换市场奖励快速适应。日均换手仅 0.39%、50bp 成本下终值只从 85.3 降到 78.9——EG 是三兄弟(Cover/EG/ONS)里最便宜的。三盆冷水:√T 遗憾比 ONS 的 log T 慢一个量级(对手够坏时差距真实存在)、乘性更新永不清零导致死资产权重衰减极慢、EG 追的是 CRP 基准而 CRP 本身在趋势市就是弱基准。
一句话版本#
EG(Exponential Gradient)每天只做一件事:把每个资产的权重乘上 exp(η × 该资产今日相对表现),再归一化。表现好的资产权重指数式上调,表现差的指数式下调。一行代码,O(m) 计算量,没有积分、没有矩阵求逆、没有投影 QP——这是在线组合选择三兄弟(Cover / EG / ONS)里最轻的一个。
代价也明码标价:遗憾界是 O(√T),比 ONS 的 O(m log T) 慢一个数量级。本文用可复现实验展示 EG 什么时候够用、什么时候不够,以及教科书很少讲的 η 敏感性有多刺眼。
从 Cover 的困境说起#
Cover 通用组合的思路是对所有常数再平衡组合(CRP)做财富加权平均——理论优美,但 m 个资产的单纯形积分需要 O(k^(m-1)) 个网格点,资产一多直接爆炸。
Helmbold、Schapire、Singer、Warmuth 在 1998 年的《On-Line Portfolio Selection Using Multiplicative Updates》里给出了工程解。他们注意到:对数财富损失的在线优化,可以用相对熵(KL 散度)做正则项的镜像下降来解。在单纯形上,KL 正则的镜像下降恰好就是乘性更新:
其中 是资产 i 当日价格相对数(今日价/昨日价), 是组合当日收益, 是归一化常数。指数里的分式是对数财富对 的梯度——所以叫”指数梯度”。
三点直觉:
- 为什么是乘性而不是加性? 加性梯度更新(OGD)走出单纯形后需要投影,投影会把小权重直接打到 0。乘性更新天然保持权重为正、和为一,永远不需要投影。
- 为什么除以组合收益? 梯度是相对表现:一个资产涨 1% 在组合整体涨 1% 的日子里不加分,在组合跌 1% 的日子里大幅加分。EG 追踪的是超额贡献,不是绝对涨幅。
- 和 softmax 的关系? 展开递推会发现 ——EG 就是对累积梯度做 softmax。它和多臂老虎机的 Hedge/EXP3、深度学习的注意力权重是同一个数学物种。
理论保证: 时,EG 对最优 CRP 的对数财富遗憾是 。注意 ——资产数量只以对数进入遗憾界,这是乘性更新家族的招牌福利。
核心实现:一行更新#
import numpy as np

def eg_update(w, x, eta):
    """EG 乘性更新
    w: 当前权重 (m,), x: 当日价格相对数 (m,), eta: 学习率"""
    grad = x / (w @ x)              # 对数财富的梯度
    nw = w * np.exp(eta * grad)     # 乘性更新
    return nw / nw.sum()            # 归一化

def run_eg(X, eta):
    """X: (T, m) 价格相对数矩阵,返回财富曲线和权重轨迹"""
    T, m = X.shape
    w = np.ones(m) / m              # 均匀初始化
    wealth, weights = np.zeros(T), np.zeros((T, m))
    W = 1.0
    for t in range(T):
        weights[t] = w
        W *= w @ X[t]               # 当日财富更新
        wealth[t] = W
        w = eg_update(w, X[t], eta) # 收盘后更新明日权重
return wealth, weights注意时序:第 t 天用的是根据 t-1 天及之前信息算出的权重,当天收盘后才用当天数据更新——signal-on-t、execute-on-t+1,没有 look-ahead。
实验一:翻倍-暴跌交替市场#
经典测试场:资产 1 是现金(每天 ×1.0),资产 2 每天在 ×2.2 和 ×0.3 之间交替。买入持有任何单一资产都是灾难(现金不增长,波动资产两天净值 ×0.66 越拿越少),但常数再平衡能收割波动。
网格搜索给出事后最优 CRP:b* = 0.70(70% 波动资产),3000 日对数财富 107.6(终值 5.6e+46)。EG 的表现:
| 策略 | 3000 日对数财富 | 对 BCRP 的对数遗憾 |
|---|---|---|
| 事后最优 CRP (b*=0.70) | 107.6 | 0 |
| EG (η=0.01) | 100.9 | 6.7 |
| EG (η=0.005) | 98.0 | 9.6 |
| EG (η=0.05) | 94.3 | 13.3 |
| 买入持有波动资产 | -623(归零) | — |
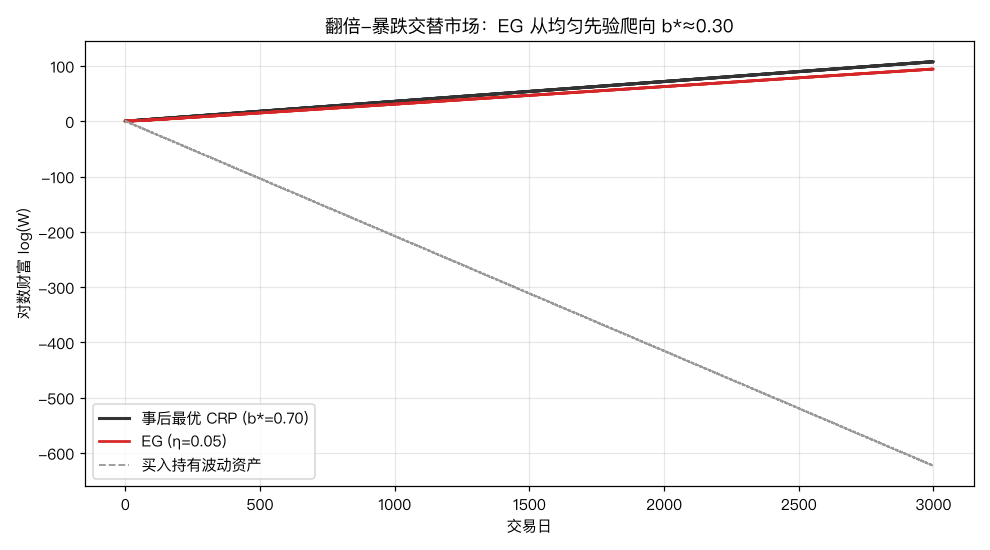
对数坐标下 EG 曲线与 BCRP 几乎平行——斜率(长期增长率)已经追平,差距只是常数级的”学费”。EG 从均匀先验 (0.5, 0.5) 出发,靠乘性更新自己爬到 b* 附近,不需要知道市场结构。
这个市场里买入持有归零、再平衡致富的机制是香农的恶魔:波动资产的算术平均收益 +25%/天但几何平均 -18%/天,只有不断把利润搬回现金、把子弹补给跌深者,才能把方差变成收益。
实验二:η 敏感性——比教科书说的更刺眼#
理论说 η 取 ,但常数呢?扫描 8 个 η:
| η | 对数遗憾 |
|---|---|
| 0.005 | 9.6 |
| 0.01 | 6.7 |
| 0.02 | 7.1 |
| 0.05 | 13.3 |
| 0.1 | 25.3 |
| 0.2 | 50.5 |
| 0.5 | 130.1 |
| 1.0 | 273.0(终值 1.5e-72,归零) |
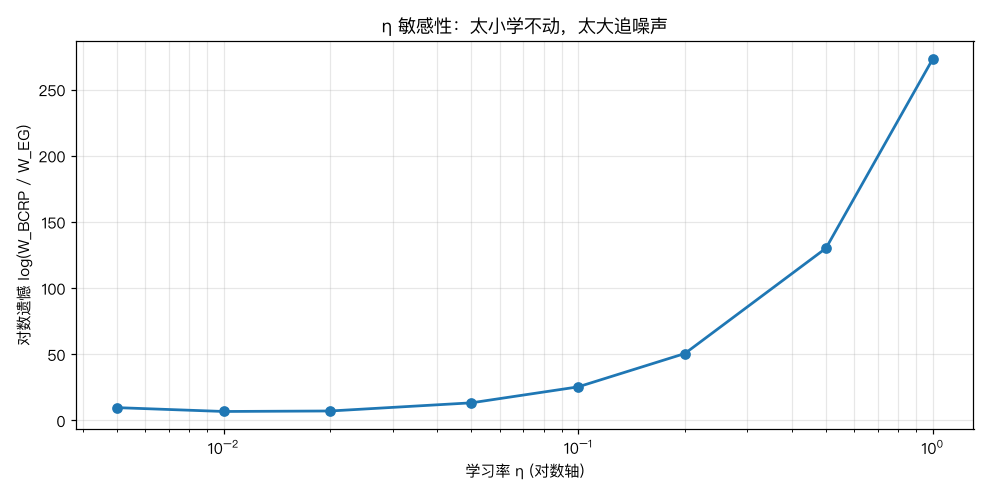
单谷曲线,但两侧完全不对称:η 太小只是学得慢(遗憾 9.6),η 太大是灾难——η=1.0 时 EG 每天疯狂追逐昨日赢家,在交替市场里恰好每次都追反,3000 日亏到 10⁻⁷²。
这揭示了乘性更新的阿喀琉斯之踵:指数函数放大一切。加性更新学习率大十倍,步子大十倍;乘性更新学习率大十倍,权重变化是 e 的十次方倍。在高波动市场用 EG,η 宁小勿大——小 η 的代价是线性的,大 η 的代价是指数的。
实验三:regime 切换市场——理论最优 η 不是实战最优#
真实市场没有 3000 天不变的结构。构造三资产市场(资产 A、资产 B、现金),每 500 日切换一次 regime:前 500 日 A 日均 +0.8%、B 日均 -0.2%,后 500 日反转,如此循环 2000 日。
| 策略 | 终值 |
|---|---|
| 事后最优 CRP(全仓 A) | 553.2 |
| EG (η=0.15) | 85.2 |
| EG (η=0.03) | 59.1 |
| OGD (η=0.01) | 59.2 |
| 等权 CRP | 53.3 |
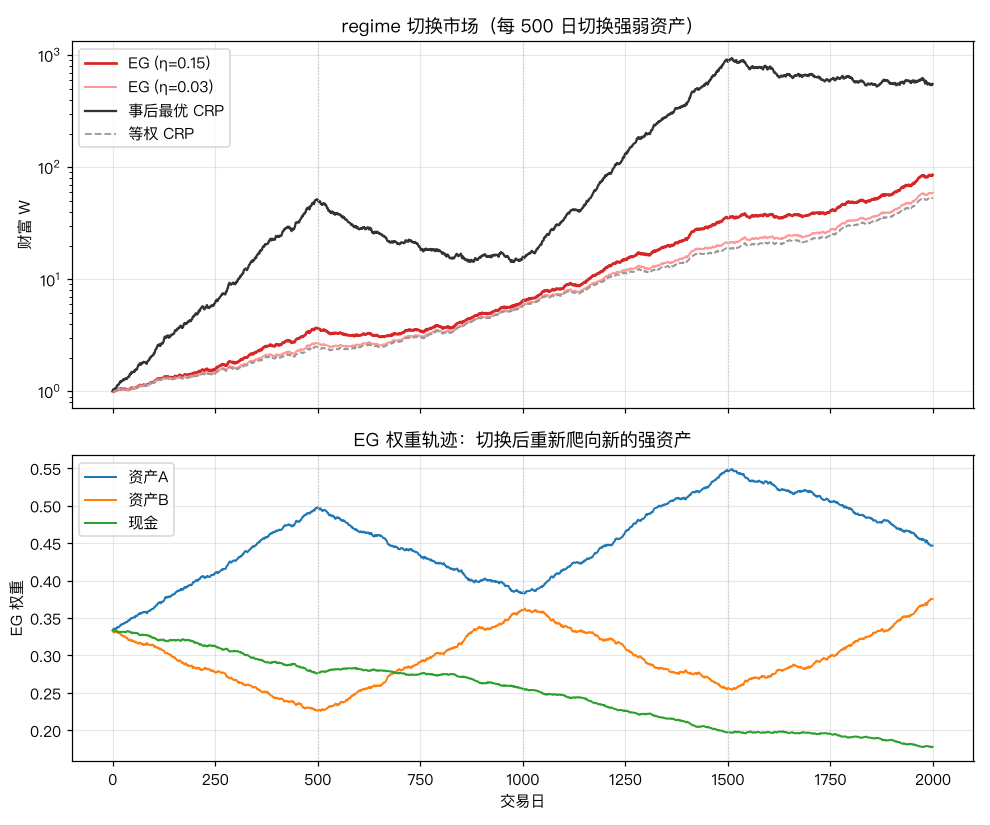
两个观察:
第一,大 η 赢了小 η(85.2 vs 59.1)。 理论遗憾界偏好小 η,但那是对最坏情况的保险。切换市场奖励快速适应:η=0.15 的 EG 在每次 regime 切换后约 100 日就把权重从旧强者搬到新强者,η=0.03 要爬 300 日以上,一半时间浪费在过时的权重上。权重轨迹图里能清楚看到 η=0.15 的锯齿状快速爬坡。这与我们在 ONS 文章里看到的现象同源:遗憾界是下界保险,不是上界预言。
第二,事后最优 CRP 是全仓 A(终值 553),EG 只拿到 85。 这不是 EG 笨——全仓 A 恰好是因为模拟里 A 的两段强势期收益略高于 B,事后才知道。任何在线算法都不可能预知这一点。更公平的基准是”每段 regime 内的条件最优”,EG 对它的追踪才是能力的真实体现。拿自适应算法和全知事后最优比终值,是对在线学习最常见的误读。
实验四:换手与成本——EG 是三兄弟里最便宜的#
η=0.15 的 EG 在 regime 市场里日均单边换手仅 0.39%。成本压力测试:
| 单边成本 | 终值 |
|---|---|
| 0 bp | 85.2 |
| 10 bp | 83.9 |
| 20 bp | 82.6 |
| 50 bp | 78.9 |
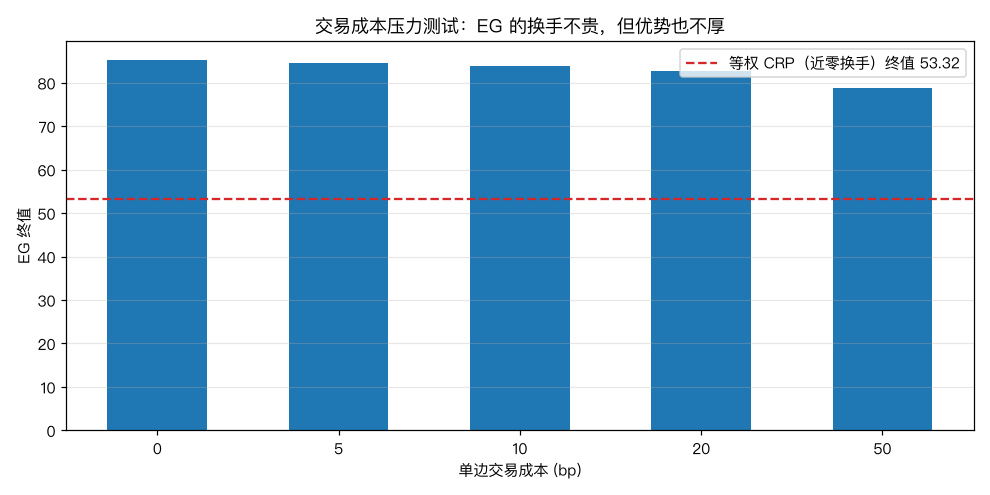
50bp 的惩罚性成本只吃掉 7.5% 的终值——对比 ONS 日均 207bp 换手,EG 的乘性更新天然平滑:权重按指数因子渐变,不会像牛顿步那样一夜大迁移。低换手是 EG 被低估的实战优势:在成本敏感的场景(A 股双边千分之一以上),EG 可能是三兄弟里唯一活得下来的。
三盆冷水#
第一盆:√T 对 log T 的差距是真的。 在对抗性市场(比如实验一的交替市场),T=3000 时 ONS 的遗憾是 0.4 量级,EG 是 6.7——差 15 倍对数财富。对手越坏、时间越长,二阶方法的优势越大。EG 适合”市场温和、资产多、成本敏感”的场景,不适合和魔鬼对赌。
第二盆:乘性更新永不清零,死资产阴魂不散。 权重只会指数衰减、永远不会精确归零。一个已经退市边缘的资产可能还挂着 10⁻⁶ 的权重——数值上无害,但如果实现时对全 universe 循环,计算和数据成本白白浪费。工程上需要显式的权重截断,而截断又破坏理论保证——这是论文不会告诉你的工程税。
第三盆:EG 追的是 CRP,而 CRP 本身在趋势市是弱基准。 整个遗憾框架的参照物是”最优常数再平衡组合”。在单边趋势市场里,最优 CRP 接近全仓强者,任何再平衡都是拖累——此时 EG”成功追平 CRP”的保证毫无安慰价值,因为基准本身就跑不过简单的动量。选择在线组合算法之前,先问一句:我的市场里 CRP 是个值得追的目标吗? 轮动市、震荡市答案是肯定的;单边趋势市,你需要的不是更好的 CRP 追踪器,而是换一个基准类(比如切换专家/滑动窗口版本的 EG)。
与三兄弟的关系图#
| 算法 | 遗憾界 | 单步计算 | 换手 | 适用场景 |
|---|---|---|---|---|
| Cover UP | O(m log T) | 指数(积分) | 低 | 理论标杆,m≤3 |
| EG | O(√(T log m)) | O(m) | 最低 | 资产多、成本敏感、市场温和 |
| ONS | O(m log T) | O(m²)+投影QP | 高 | 对抗性强、T 大、m≤50 |
EG 用一行 softmax 换掉 Cover 的积分,代价是遗憾从 log T 涨到 √T;ONS 用二阶曲率把遗憾压回 log T,代价是矩阵运算和 5 倍换手。没有免费午餐,只有明码标价的三张菜单。
实战建议从 EG 开始:先确认策略逻辑在低成本近似下成立,再决定是否值得为 log T 遗憾支付 ONS 的换手税。
参考文献#
- Helmbold, D. P., Schapire, R. E., Singer, Y., & Warmuth, M. K. (1998). On-Line Portfolio Selection Using Multiplicative Updates. Mathematical Finance, 8(4), 325-347.
- Cover, T. M. (1991). Universal Portfolios. Mathematical Finance, 1(1), 1-29.
- Hazan, E., Agarwal, A., & Kale, S. (2007). Logarithmic Regret Algorithms for Online Convex Optimization. Machine Learning, 69(2-3), 169-192.
- Li, B., & Hoi, S. C. H. (2014). Online Portfolio Selection: A Survey. ACM Computing Surveys, 46(3).