分数凯利准则:在全凯利的暴涨暴跌与半凯利的稳健之间选择
全凯利在理论上增长最快,在实践里几乎总是错的。年化 8%/波动 18% 的资产 f* = 2.47 倍杠杆,20 年 × 400 条路径实测:全凯利中位增长 9.5% 但中位最大回撤 80.6%,半凯利用 7.1% 的增长换回撤降到 51.5%——增长率对仓位是二次函数(k=0.5 保留 75% 增长),回撤对仓位是指数惩罚。解析式 P(回撤>D) = D^(2/k−1) 给出残酷账单:全凯利一生撞上 50% 回撤的概率是 50%,半凯利只有 12.5%,蒙特卡洛圆点几乎落在理论曲线上。但分数凯利最硬的理由是参数无知:10 年日频数据估 mu 的标准误 5.7%,与 mu 本身同数量级,把估计误差灌进仓位公式后 k=1.5 的负增长概率飙到 41%,而 k=0.5 中位增长 7.4% 反而与全凯利的 7.7% 几乎打平——估计误差面前,多扛的杠杆几乎白扛。三盆冷水:k 本身也依赖被估错的参数(分数化是缓冲不是豁免)、肥尾市场里连续时间解析式系统性低估尾部(跳空一夜越过全部止损)、多资产凯利需要逆协方差矩阵——估计误差被求逆放大后,实务中 0.2-0.5 倍凯利加总杠杆上限才是常态(中阶)。
理论最优,实践毒药#
凯利公式是资金管理领域少有的、有严格数学根基的结论:按 f* = μ/σ² 的比例下注,长期对数财富增长率最大化。没有任何其他固定比例策略能在足够长的时间里跑赢它——这是定理,不是经验。
然后是所有实践者都撞过的墙:按全凯利下注的账户,几乎没有人拿得住。
以一个年化收益 8%、波动 18% 的资产为例(大致是宽基股指的量级):
mu, sigma = 0.08, 0.18
f_star = mu / sigma**2 # = 2.47f* = 2.47——凯利公式建议你上 2.47 倍杠杆。任何管过真钱的人看到这个数字都会本能地后退一步。这一步后退,量化成公式就是分数凯利:仓位 = k × f*,k 取 0.5 就是著名的”半凯利”。
问题是:k 到底该取多少?这不是玄学,是一笔可以精确计算的账。
第一笔账:增长是二次的,回撤是单调的#
对连续时间近似,仓位 f 下的长期对数增长率是:
g(f) = f·μ − ½·f²·σ²
这是一条开口向下的抛物线,顶点在 f*。抛物线的几何性质直接给出分数凯利的核心定价:g(k·f) = k(2−k) · g(f)**。代入几个 k:
- 半凯利(k=0.5):保留全凯利增长率的 75%
- 0.75 凯利:保留 93.75%
- 2 倍凯利(k=2):增长率归零——和把钱放床垫下等价,但天天坐过山车
增长率对仓位钝感(顶点附近是平的),而回撤对仓位一路陡峭。用 20 年 × 400 条蒙特卡洛路径把两边同时画出来:
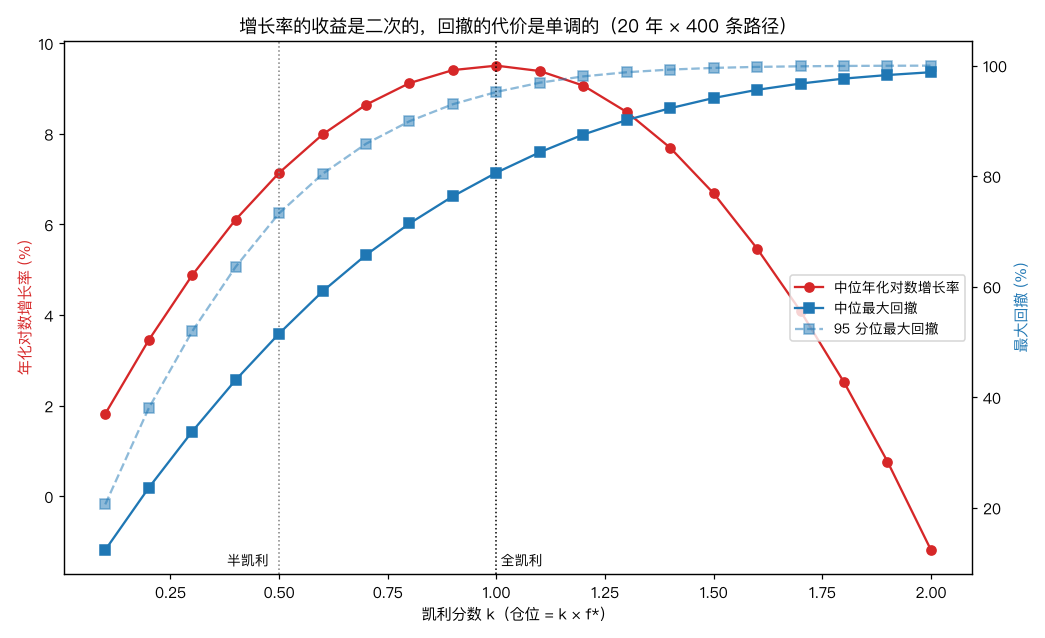
| 凯利分数 k | 中位年化增长 | 中位最大回撤 |
|---|---|---|
| 0.5(半凯利) | 7.1% | 51.5% |
| 1.0(全凯利) | 9.5% | 80.6% |
| 2.0 | −1.2% | 98.8% |
读这张表的正确姿势:从半凯利到全凯利,你多赚 2.4 个百分点的年化增长,代价是中位回撤从 51.5% 恶化到 80.6%。注意是中位数——这意味着按全凯利下注,你有一半的概率在 20 年里的某个时刻看到账户从峰值蒸发五分之四。没有几个投资人、更没有几个基金 LP 能在 -80% 处继续持有。
同一条市场路径下三种杠杆的财富轨迹,把这件事画得更直观:
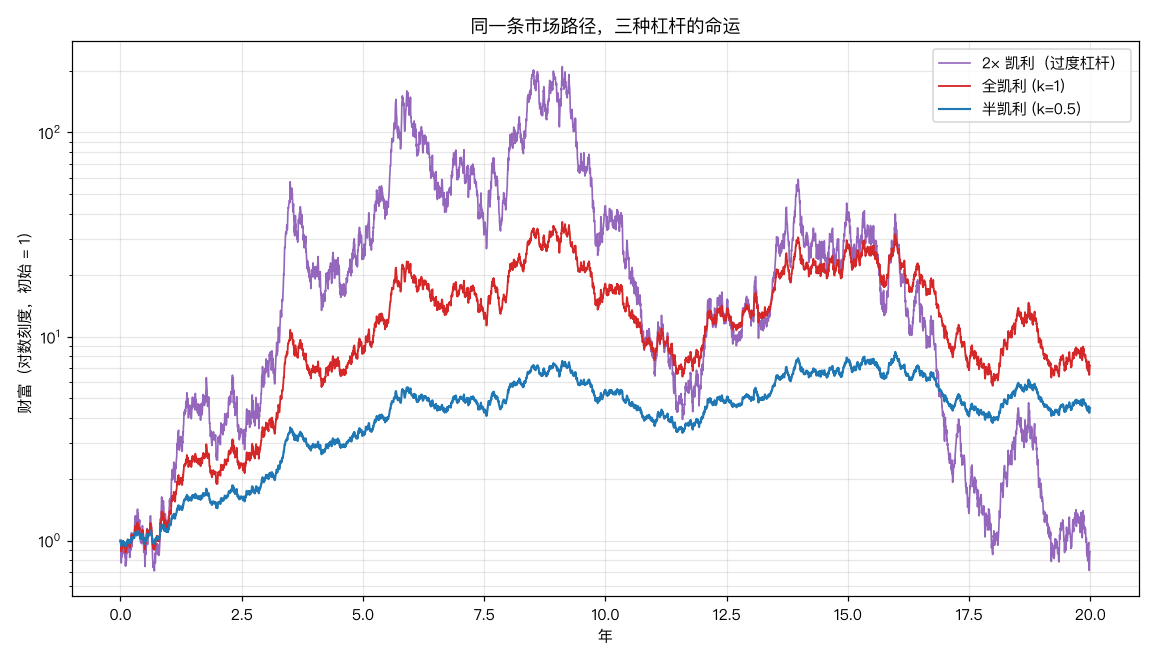
这条路径上半凯利终值 4.5 倍、全凯利 7.2 倍、2 倍凯利 0.88 倍——2 倍凯利在 20 年过山车之后亏钱。波动侵蚀(-½f²σ²)不是修辞,是复利的物理定律。
第二笔账:回撤概率有解析式#
连续时间凯利框架下有一个漂亮到不像话的结果:按 k 分数凯利下注,一生中最大回撤超过深度 D 的概率是
P(回撤 > D) = D^(2/k − 1)
代入 D=50%:
- 全凯利(k=1):指数为 1,P = 50%。抛硬币。
- 半凯利(k=0.5):指数为 3,P = 0.5³ = 12.5%
- 1/4 凯利(k=0.25):指数为 7,P = 0.8%
用 40 年蒙特卡洛验证解析式:
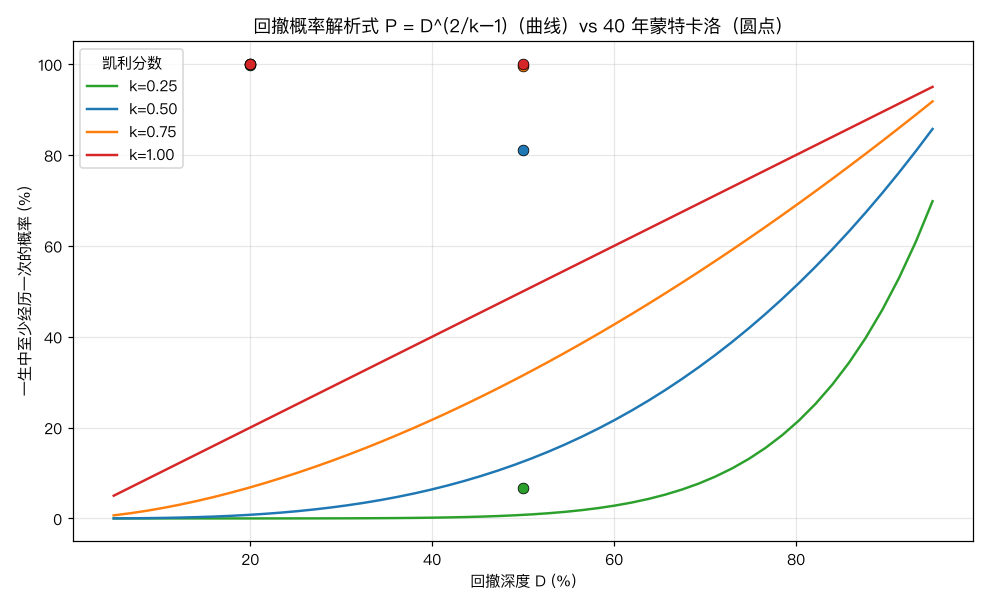
圆点(模拟)几乎落在曲线(理论)上。这个公式值得背下来,因为它把”我能忍受多深的回撤”直接翻译成 k:如果你要求 50% 回撤的终身概率低于 10%,k 就不能超过约 0.46。分数凯利从”拍脑袋打折”变成了带约束的显式求解。
第三笔账:你根本不知道 μ——这才是最硬的理由#
前两笔账假设 μ 和 σ 是已知的。σ 还好说(高频数据下估计收敛很快),μ 是金融数据里最难估的参数,没有之一。
10 年日频数据估年化 μ 的标准误是 σ/√10 = 5.7%——和 μ = 8% 本身同一个数量级。也就是说,一个真实 μ 为 8% 的资产,你用十年数据估出 3% 或 13% 都是家常便饭。
现在把估计误差灌进仓位决策:抽 3000 次 μ̂ ~ N(8%, 5.7%),每次都按估计值定仓位 f = k·μ̂/σ²,但财富按真实 μ 增长。看不同 k 下真实增长率的分布:
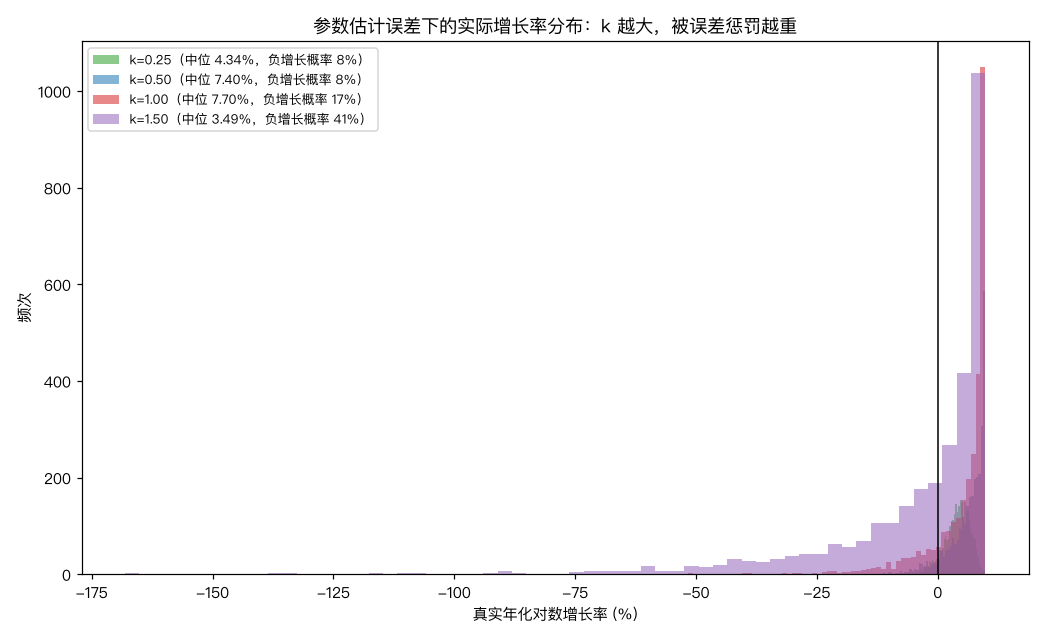
| k | 中位真实增长 | 负增长概率 |
|---|---|---|
| 0.25 | 4.3% | 8.2% |
| 0.50 | 7.4% | 8.2% |
| 1.00 | 7.7% | 16.7% |
| 1.50 | 3.5% | 40.7% |
这张表是全文最重要的一张。在确定性世界里,全凯利比半凯利多赚 2.4 个百分点;在参数无知的真实世界里,这个优势缩水到 0.3 个百分点(7.7% vs 7.4%),而负增长概率翻倍(16.7% vs 8.2%)。k=1.5 更惨:中位增长被腰斩到 3.5%,四成的概率长期亏钱。
机制不难理解:增长率函数 g(f) 在 f* 附近是平的,但不对称地惩罚过冲——超过 f* 之后曲线加速下坠。估计误差是双向的,可后果不是:低估 μ 让你少赚一点,高估 μ 让你冲过山顶滚下悬崖。k < 1 的分数凯利本质上是给”μ̂ 高估了”这个坏事件买的保险,而这份保险在增长率上的保费,被抛物线的平顶压到接近免费。
这就是半凯利在从业者中近乎共识的真正原因:不是风险偏好保守,而是贝叶斯意义上的正确——对参数不确定性积分之后,最优 k 本来就显著小于 1。Ed Thorp 本人在实盘中用的也是分数凯利,他的原话大意是:市场给你的 μ 估计太糙,全凯利承受不起这种糙。
三盆冷水#
第一盆:k 本身也依赖你估不准的参数。 分数凯利没有把你从参数估计里解放出来——f* = μ/σ² 里的 μ 还是那个标准误 5.7% 的 μ。k=0.5 只是把误差的杠杆效应打了对折,误差本身原封不动。真正稳健的做法是把 μ̂ 主动向零收缩(贝叶斯先验:绝大多数策略没有 alpha),再在收缩后的估计上取分数。分数化是缓冲垫,不是豁免权。
第二盆:解析式活在高斯世界,你的账户不是。 P = D^(2/k−1) 和 g = f·μ − ½f²σ² 都来自连续时间几何布朗运动——没有跳空、没有肥尾、可以连续调仓。真实市场一夜跳空 -20% 时,2.47 倍杠杆意味着单日 -49%,任何止损都在跳空缺口面前失效。肥尾分布下的”真实凯利”比高斯公式给出的更小,且尾部越肥缩得越狠。把本文所有公式的输出再打一个安全折扣,才是对肥尾的正确敬畏。
第三盆:多资产凯利是另一头怪兽。 组合版凯利解是 f⃗* = Σ⁻¹μ⃗——需要对协方差矩阵求逆。矩阵求逆是估计误差的放大器:资产数逼近样本量时,Σ̂⁻¹ 的误差可以大到让仓位向量完全是噪声,个别资产被建议上数十倍杠杆。实务界的常见配置是 0.2~0.5 倍凯利,再叠加一个与凯利无关的加总杠杆硬上限。单资产场景里分数凯利是优化;多资产场景里它是救命。
写在最后#
凯利准则最大的价值不是那个具体的 f*,而是它提供的思考框架:仓位是一个有最优解的数学对象,过度下注的惩罚是超线性的,而”下注太少”的代价远小于”下注太多”。
分数凯利把这个框架变成一条可执行的纪律:算出 f*,然后清醒地只用它的一半甚至四分之一——不是因为胆小,而是因为你对 μ 的无知是定量的、可证明的、且不会因为回测好看而消失。全凯利属于知道真实参数的神;分数凯利属于知道自己不知道的人。在这个行业里,后者活得久得多。