隐含相关性交易:指数波动率与成分股波动率的价差
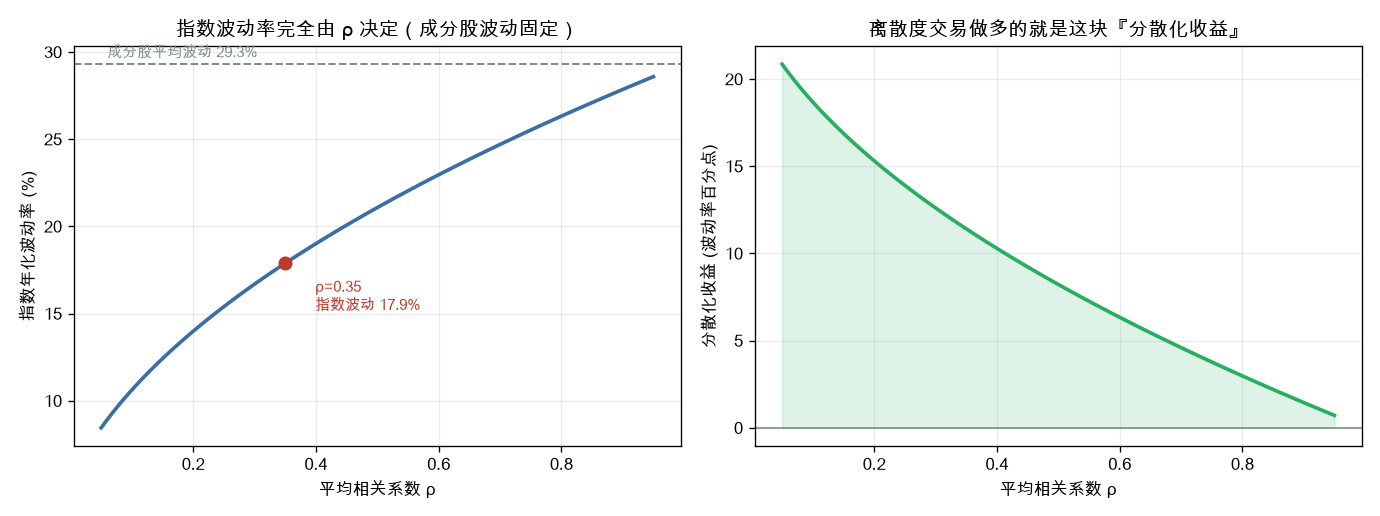
离散度交易完整拆解:指数方差恒等式反解出隐含相关性(数值往返误差 5.6e-17),30 只成分股平均波动 29.3% 而 ρ=0.35 时指数波动仅 17.9%,中间 11.4 个百分点就是策略要做多的分散化收益。1000 天模拟给出相关性风险溢价 8.57 个相关点、86.1% 交易日为正,但溢价在危机期塌成 -1.3 点——保险费恰在赔付时消失。47 笔不重叠交易毛 Sharpe 3.13,扣执行成本后 n=30 降到 2.68、n=100 只剩 1.75,n=500 净边际被吃掉 83% - halo的技术博客
有一个让很多人第一次听到会愣住的事实:指数期权的隐含波动率,长期系统性地”贵”于它成分股期权隐含波动率所能解释的水平。这不是定价错误,而是一个可以精确量化的量——隐含相关性。围绕这个价差建立的交易,叫离散度交易(dispersion trading):卖出指数波动率,同时买入成分股波动率组合。
本文把这个策略从恒等式推导到损益归因完整跑一遍。先说结论:
溢价是真的——模拟给出隐含相关性平均比前瞻已实现相关性高 8.57 个相关点,86.1% 的交易日为正,毛 Sharpe 3.13。但它的形状很危险:溢价在平常期是 9.64 点,在危机期塌成 -1.34 点——你收了 47 个月的保险费,恰恰在需要赔付的时候费率转负。而执行成本是这个策略真正的杀手:n=30 的篮子扣成本后 Sharpe 从 3.13 降到 2.68,n=100 只剩 1.75,n=500 时净边际被吃掉 83%。
一、恒等式:指数波动率里藏着一个相关系数#
一切从组合方差公式开始。指数由 n 只权重 wᵢ、波动率 σᵢ 的成分股构成:
σ_idx² = Σᵢ wᵢ²σᵢ² + Σᵢ≠ⱼ wᵢwⱼσᵢσⱼρᵢⱼ如果把所有配对相关系数 ρᵢⱼ 简化为一个共同的平均值 ρ(这是关键的简化假设,后面会讨论它的代价),方程就只剩一个未知数,可以直接反解:
def implied_corr(w, sig, sig_idx):
    diag  = np.sum(w**2 * sig**2)              # 特质方差部分
    cross = (np.sum(w * sig))**2 - diag        # 交叉项 Σ_{i≠j} wi wj si sj
return (sig_idx**2 - diag) / cross这就是 CBOE 的 COR3M / ICJ 等隐含相关性指数背后的全部数学。把指数期权的隐含波动率代入 σ_idx,把成分股期权的隐含波动率代入 σᵢ,反解出的 ρ 就是”市场对未来平均相关性的定价”。
数值校验:给定真实 ρ=0.35 正向造出指数波动率,再反解回去,误差 5.6×10⁻¹⁷——是恒等式而非近似,浮点精度以内完全还原。
关键的量级感在第一张图里:30 只成分股平均年化波动 29.3%,但 ρ=0.35 时指数波动率只有 17.9%。中间 11.4 个百分点的差距就是分散化收益——而这正是离散度交易要做多的东西。
看右图的斜率还能读出一个重要性质:当 ρ→1 时,指数波动率收敛到成分股平均波动,分散化收益归零。这就是”危机时刻所有资产一起跌”的数学表达——分散化恰好在你最需要它的时候消失。记住这句话,第三节它会以损益的形式回来。
二、相关性风险溢价:保险费从哪来#
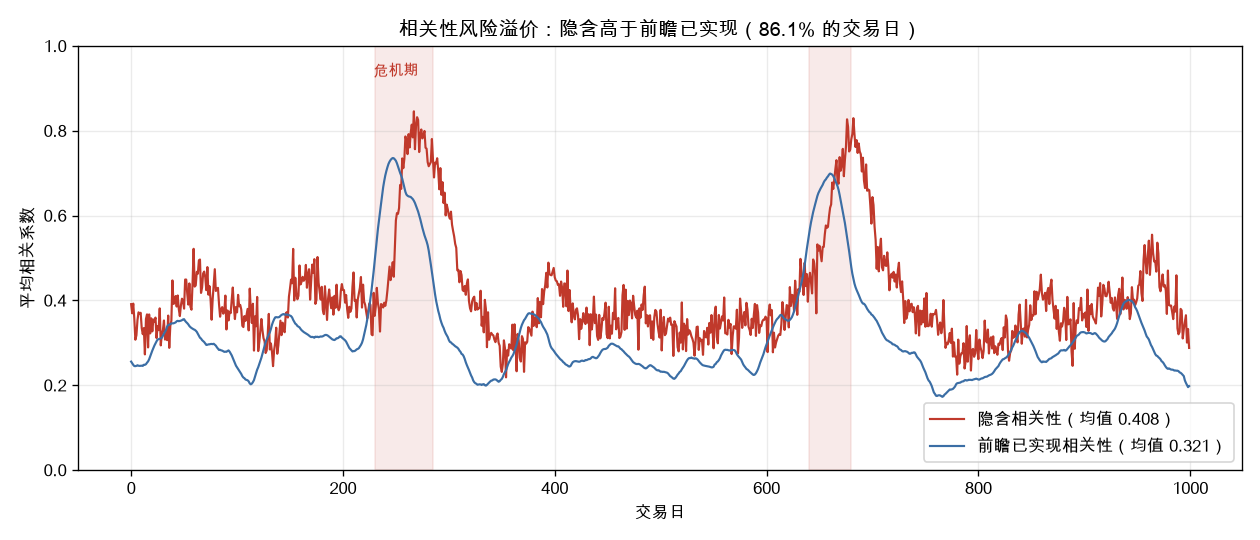
隐含相关性系统性高于已实现相关性,这个现象叫相关性风险溢价(Correlation Risk Premium)。它的经济学解释很直白:指数期权是尾部风险保险,而尾部风险的本质就是相关性跳升。
买指数看跌期权的人是在对冲”整个组合一起跌”的风险;卖方承担的正是相关性飙升的风险。为承担这个风险,卖方索要溢价——溢价体现在指数期权隐含波动率里,反解出来就是偏高的隐含相关性。
模拟里让真实相关性做均值回复(平常期中枢 0.28)并嵌入两段危机(中枢跳到 0.72),隐含相关性由近期已实现 + 溢价 + 报价噪声构成:
H = 21                                    # 期权到期(交易日)
# 关键:隐含相关性只能用 t 时刻信息(近期已实现 + 溢价),不能偷看未来危机
rho_bwd = np.array([rho_real[max(0,i-H):i+1].mean() for i in range(T)])
rho_imp = np.clip(rho_bwd + 0.085 + 0.030*rng.standard_normal(T), 0.03, 0.97)

# 前瞻已实现相关性:持有期内真正兑现的那个 rho
rho_fwd = np.array([rho_real[i:min(T,i+H)].mean() for i in range(T)])⚠️ 这里是全文最容易翻车的地方。我的第一版直接写
rho_imp = rho_real + premium,等于让期权市场在危机发生的当天就已经把危机定价进去了——结果 Sharpe 算出 46。任何波动率策略回测出这个量级的 Sharpe,第一反应都应该是找前视偏差,而不是庆祝。隐含量必须只用 t 时刻可得的信息构造。
修正后的结果诚实得多:
| 指标 | 数值 |
|---|---|
| 平均隐含相关性 | 0.408 |
| 平均前瞻已实现相关性 | 0.322 |
| 平均溢价 | +8.57 个相关点 |
| 溢价为正的交易日占比 | 86.1% |
| 平常期溢价 | +9.64 点 |
| 危机期溢价 | -1.34 点 |
最后两行是全文最重要的一组数字。溢价不是均匀分布的,它在危机期直接转负。 这不是模型缺陷,恰恰是相关性风险溢价的定义:它是保险费,而保险公司在灾难年份是赔钱的。任何用全样本平均溢价(8.57 点)去外推收益的人,都在无视这个结构。
三、策略损益:漂亮的净值曲线和它的真实形状#
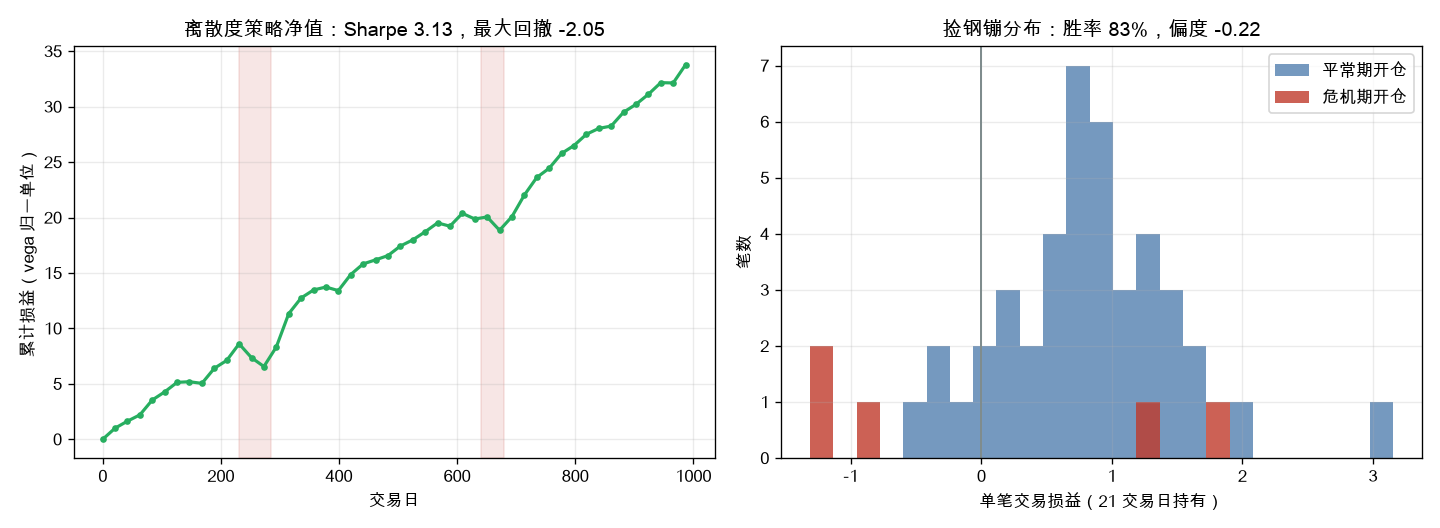
离散度策略的损益近似正比于卖出的隐含 ρ 与实际兑现的前瞻 ρ 之差,乘以交叉项:
entries = np.arange(0, T-H, H)     # 每 H 天开一笔不重叠交易
# 篮子复制误差:个股期权无法完美复制指数方差(离散对冲/跳空/vol-of-vol)
replication_noise = 0.022 * rng.standard_normal(len(entries))
trade_pnl = ((rho_imp[entries] - rho_fwd[entries]) + replication_noise) * cross * 100

per_year = 252 / H
sharpe = trade_pnl.mean() / trade_pnl.std() * np.sqrt(per_year)⚠️ 第二个必须避开的坑:不能每日开仓然后按 √252 年化。持有期 21 天的头寸日日重叠,相邻观测高度相关,独立性假设破裂,Sharpe 会被系统性放大。改成每 21 天开一笔不重叠交易、按 √12 年化后,Sharpe 从 13.6 降到 3.13——同一份数据,两个数字差 4 倍,区别只在于有没有正视重叠。
47 笔交易的结果:
| 指标 | 数值 |
|---|---|
| 毛 Sharpe | 3.13 |
| 胜率 | 83.0% |
| 平均盈利 / 平均亏损 | 0.98 / -0.57(盈亏比 1.73) |
| 最差单笔 | -1.25 |
| 最好单笔 | +3.00 |
| 偏度 | -0.22 |
| 平常期累计 | +34.03 |
| 危机期累计(5 笔) | -0.25 |
83% 的胜率配 1.73 的盈亏比看起来近乎完美,但危机期开的 5 笔交易累计为负——占比 10.6% 的交易贡献了全部的负收益。最差 10% 的交易亏损相当于全部盈利的 10.0%。
值得注意的是偏度只有 -0.22,比真实的离散度策略温和得多。这是模型的局限而非策略的优点:模拟里的相关性跳升是连续均值回复过程,而现实中 2008 年 10 月、2020 年 3 月的相关性是隔夜跳到 0.9 以上的。真实离散度基金在这类事件里的单月回撤可以吞掉数年利润——这也是 2008 年多家离散度专户清盘的直接原因。
这个策略的正确心理定位是:你在卖保险,不是在套利。 83% 的月份收保费,剩下的月份赔付,长期为正取决于溢价是否足够覆盖赔付——而这是个信仰问题,不是数学问题。
四、规模诅咒:为什么这不是散户策略#
前三节都在讲收益端。现在讲为什么绝大多数人做不了这个策略。
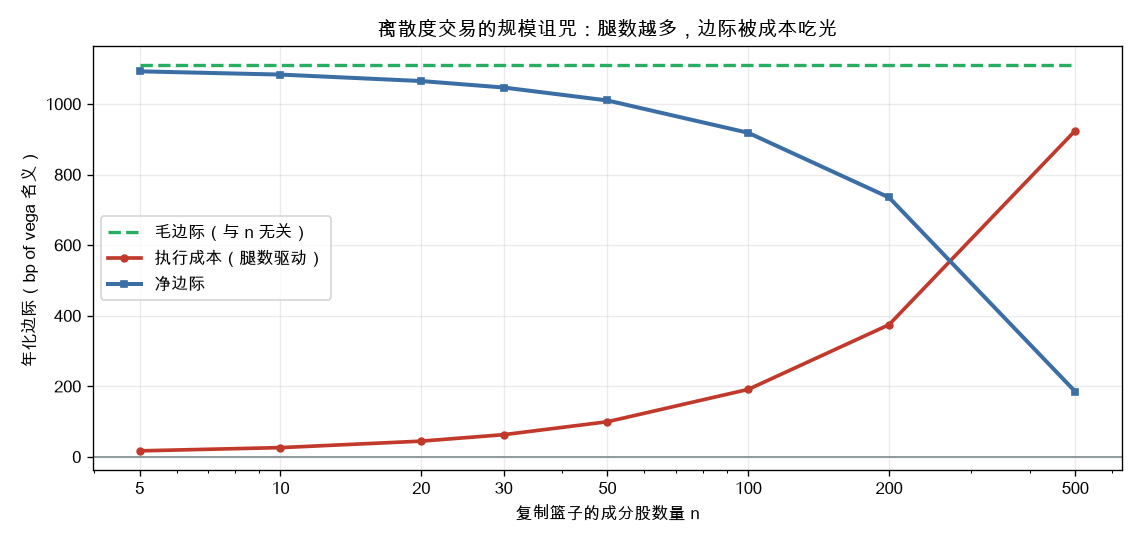
离散度交易的结构是卖 1 条指数腿 + 买 n 条个股腿。毛边际与 n 无关(它由相关性溢价决定),但成本几乎随 n 线性上升,原因有三:
- 个股期权价差远宽于指数期权——模型取指数腿 8 bp、个股腿 55 bp(相对 vega 名义),这个比例在现实中甚至更悬殊;
- 腿数越多,单腿名义越小,小额单在宽价差市场上的滑点占比更高;
- 每条腿都要独立再平衡 delta,运营成本按腿数计。
| 篮子规模 n | 年化毛边际 | 执行成本 | 净边际 | 成本占比 |
|---|---|---|---|---|
| 10 | 1110 bp | 26 bp | 1084 bp | 2.4% |
| 30 | 1110 bp | 63 bp | 1047 bp | 5.7% |
| 100 | 1110 bp | 191 bp | 919 bp | 17.2% |
| 500 | 1110 bp | 925 bp | 185 bp | 83.3% |
把成本代回损益,Sharpe 的衰减比总额更直观:
| 篮子规模 | 毛 Sharpe | 净 Sharpe | 净胜率 |
|---|---|---|---|
| 无成本 | 3.13 | — | 83.0% |
| n=30 | 3.13 | 2.68 | 80.9% |
| n=100 | 3.13 | 1.75 | 74.5% |
这张表解释了离散度交易的产业结构:它只对能把执行成本压到最低的机构成立。做市商自营台有内部流动性、能用自己的库存对冲、拿得到机构级价差;散户在零售期权界面上复制 30 条腿,光是买卖价差就能吃掉全部边际。
同时它也解释了为什么实务中用精简篮子(挑 10-30 只权重最大、期权流动性最好的成分股)而非全复制:n=500 的全复制在数学上跟踪最准,在经济上是自杀。代价是引入篮子跟踪误差——精简篮子的方差不完全等于指数方差,这部分残差是无法对冲的裸风险。离散度交易的核心工程权衡,就是在跟踪误差和执行成本之间找那个凹函数的顶点。
五、四个模型没说的真相#
1. “单一 ρ” 是一个很粗的简化。 恒等式里把所有配对相关性压成一个数,但真实的相关矩阵有结构——同行业股票高度相关、跨行业低。当你卖指数买成分股时,你实际做空的是”平均相关性”,但赔付却发生在特定的相关性结构变化上(比如整个科技板块一起崩)。这两者在压力时刻会显著背离。
2. 波动率水平与相关性纠缠不清。 反解 ρ 时用的成分股波动率 σᵢ 本身也是期权隐含量,同样含有各自的方差风险溢价。你以为在交易相关性,实际上交易的是”指数方差溢价减去加权个股方差溢价”这个复合量。 学术界(Driessen-Maenhout-Vilkov 等)花了很大力气分离这两者,结论是相关性溢价确实独立存在,但它在实证上与方差溢价的分离比理论上困难得多。
3. 模型没有跳空。 第三节说过,模拟中相关性以连续过程演化,最大单笔亏损 -1.25。现实中相关性会隔夜跳变,且离散度头寸在跳空日的损失是非线性的(gamma 效应叠加相关性效应)。这份模拟给出的尾部风险是系统性低估的,2.68 的净 Sharpe 应当理解为”在没有真正危机的世界里”的表现。
4. A 股的适用性有限。 中国目前有 50ETF、300ETF、500ETF 期权和中金所股指期权,但个股期权尚未推出。这意味着经典离散度交易在 A 股无法直接实施。可行的近似是跨指数离散度——比如用 300ETF 期权对 50ETF 期权,交易的是”大盘股内部相关性 vs 中大盘整体相关性”。这个变体的溢价更薄、样本更少,需要独立验证,不能照搬本文数字。
六、如果要落地,检查清单#
- 先算隐含相关性有没有超出历史区间——ρ_imp 长期在 0.2-0.6 波动,超过 0.7 时做空相关性的赔率显著恶化(因为上方空间有限、下方空间还很大,这是个有界变量的赔率不对称问题);
- 溢价要用前瞻已实现相关性检验,不是同期——用同期已实现算出的溢价含前视偏差,这是本文第二节踩过的坑;
- 篮子规模从 15-25 只起步,用市值权重前 N 只覆盖 60%+ 指数权重,同时要求个股期权日均成交量达标;
- vega 中性只是起点,还要监控 delta(个股腿的 delta 不会自动抵消指数腿)和 skew 暴露(个股 skew 与指数 skew 的形态差异会带来额外损益);
- 仓位上限按”危机期单月赔付”设定,不是按 Sharpe 设定——一个 Sharpe 2.68 的策略如果尾部能亏三年利润,凯利公式给出的仓位会严重过大。
总结#
隐含相关性把”指数期权为什么比成分股期权贵”这个模糊的观察,变成了一个可以反解、可以交易、可以归因的数字。它背后的恒等式是精确的(往返误差 10⁻¹⁷),溢价是真实存在的(8.57 个相关点,86.1% 的交易日为正),策略在温和世界里表现优异(毛 Sharpe 3.13)。
但它的三个约束同样具体:溢价在危机期转负(-1.34 点,保险费恰在赔付时消失)、成本随腿数吞噬边际(n=500 时吃掉 83%)、尾部风险被连续模型系统性低估。
离散度交易不是套利,是一门承保生意。判断它值不值得做,不是看 Sharpe 有多高,而是看你有没有能力在赔付年份活下来——以及你的执行成本,能不能让你在收保费的年份真的收到钱。