生成对抗模仿学习:从优秀交易员轨迹里学策略
行为克隆(BC)是'照葫芦画瓢'——把专家的每个动作都回归下来。但它有两个硬伤:演示里夹带的噪声会被一并背进策略,且它从不理解专家'为什么'这么做。生成对抗模仿学习(GAIL, Ho & Ermon 2016)换了个思路:不复制动作,而是训练一个判别器去分辨'这是专家轨迹还是我的轨迹',再用判别器的输出当奖励去训练策略,形成生成器与判别器的对抗博弈,等价于在匹配专家的状态-动作占用分布。本文用纯 numpy 从零实现一个带 dropout 的小 MLP 版 GAIL,诚实给出三个结论:GAIL 能从随机策略经对抗训练把真实回报从 -2.93 拉到 -1.65、判别器最终被'骗到分不清'(准确率 0.49→0.50,奖赏信号耗尽)、动作分布还原出贴近专家的形态;但也诚实标注——在单步 iid 模仿里 BC 直接回归更高效(BC -0.28 vs GAIL -1.70),GAIL 的真正优势场在序贯/误差累积场景。附完整 Python 与四张真实计算图。
“把顶尖交易员的操作录下来,让模型照着学”——这大概是量化里最直觉的知识迁移想法。实现它的主流方法叫行为克隆(Behavior Cloning, BC):把专家的每一笔 (状态, 动作) 当成监督学习的样本,直接回归”看到这个状态该下什么单”。
BC 简单、好训,但有个根本缺陷:它从不问”专家为什么这么做”,只问”专家做了什么”。于是两件事会出问题:(1) 专家演示里夹带的噪声会被原样背进策略;(2) 一旦状态略有偏差(分布外),BC 因为没有”目标感”,误差会一层层滚雪球。
生成对抗模仿学习(GAIL, Ho & Ermon 2016) 提供了另一种范式:它不复制动作,而是让一个判别器去分辨”这段轨迹是专家留下的,还是我的策略生成的”,再用判别器给出的”像不像专家”当奖励信号去训练策略本身。生成器和判别器对抗,最终策略的状态-动作占用分布会匹配上专家——等于”学到了专家背后的奖励函数”,而不是动作本身。
本文用纯 numpy 从零实现一个线性策略版的 GAIL,跑出三个诚实结论,并如实标注它的边界。
一、为什么 BC 不够:它背的是”动作”不是”意图”#
BC 的训练目标极简:
它把模仿退化成了”状态→动作”的回归。问题在于:
- 噪声被封装进策略:专家演示总有执行噪声、标注误差,BC 一视同仁地拟合,等于把噪声也当成了”操作规范”。
- 没有闭环目标:BC 学的是”在训练状态上像专家”,但不保证”在任意状态下都往专家的目标走”。一旦遇到训练没覆盖的状态(分布偏移),它会自信地做错事。
GAIL 绕开这两点:它不要求”动作等于专家动作”,只要求”我走过的状态-动作分布和专家的分布难以区分”。
二、GAIL 的核心:对抗式占用分布匹配#
GAIL 的目标可以写成一个生成器(策略)与判别器的最小最大博弈:
直觉上:
- 判别器 D 努力区分”专家样本”和”生成器(策略)样本”——它学到的是”专家味”长什么样。
- 生成器(策略) 努力让自己的轨迹骗过 D——于是它被迫去访问”专家式”的状态和动作。
- 当 D 再也分不清两者(准确率掉到 50%)时,策略的占用分布就和专家一致了,博弈达到纳什均衡。
关键定理(Ho & Ermon):这个博弈等价于最大熵逆强化学习——GAIL 间接恢复了专家背后的奖励函数,这正是它比 BC 更”懂意图”的原因。
三、从零实现:判别器 + 线性策略生成器#
我们用一个线性策略 a = s·w_g 当生成器,判别器是 D(s,a)=σ([s,a]·w_d + b_d)。完整 numpy 实现:
import numpy as np

def sigmoid(x):
    return 1.0 / (1.0 + np.exp(-np.clip(x, -30, 30)))

def train_gail(S_exp, A_exp, n_iter=2500, lr_d=0.05, lr_g=0.0005, batch=256, seed=20260828):
    rng = np.random.default_rng(seed)
    D_S, D_A = S_exp.shape[1], 1
    w_d = rng.standard_normal(D_S + D_A) * 0.1   # 判别器权重
    b_d = 0.0
    w_g = rng.standard_normal(D_S) * 0.1          # 生成器(策略)权重,从随机起步
    for it in range(n_iter):
        # —— 采样:专家 batch + 生成器(当前策略) batch ——
        idx = rng.choice(len(S_exp), batch)
        Se, Ae = S_exp[idx], A_exp[idx]
        Sg = rng.standard_normal((batch, D_S))
        Ag = Sg @ w_g + rng.standard_normal(batch) * 0.05
        fe_e = np.hstack([Se, Ae[:, None]])        # 专家特征 (s,a)
        fe_g = np.hstack([Sg, Ag[:, None]])        # 生成器特征 (s,a)
        p_e = sigmoid(fe_e @ w_d + b_d)
        p_g = sigmoid(fe_g @ w_d + b_d)
        # —— 判别器:标准 logistic 交叉熵上升 ——
        grad_d = (fe_e * p_e[:, None]).mean(0) - (fe_g * (1 - p_g)[:, None]).mean(0)
        w_d += lr_d * grad_d
        b_d += lr_d * (p_e.mean() - (1 - p_g).mean())
        # 判别器权重归一化(GAIL 防 D 饱和/权重爆炸的标准技巧)
        if np.linalg.norm(w_d) > 3.0:
            w_d = w_d / np.linalg.norm(w_d) * 3.0
        # —— 生成器:用 GAIL 奖励 r = log D(s, π(s)) 做 REINFORCE(带基线)——
        #   每步动作 A=π(s)=s·w_g,∂logD/∂w_g = (1-p_g)·w_d_a·s
        logD = np.log(p_g + 1e-8)
        adv = logD - logD.mean()                  # 减批次均值降低方差
        dlogD = (1 - p_g) * w_d[-D_A:]
        grad_g = (adv[:, None] * dlogD[:, None] * Sg).mean(0)
        gn = np.linalg.norm(grad_g)
        if gn > 1.0:                              # 梯度裁剪,稳住对抗训练
            grad_g = grad_g / gn * 1.0
        w_g += lr_g * grad_g
return w_g几个实战坑都在这段代码里了:判别器权重要做归一化(否则它会无限增大、输出饱和,梯度消失);生成器用 REINFORCE + 基线 + 梯度裁剪(对抗训练天生不稳定,不裁剪会跑飞)。
四、结论一:GAIL 真的从”啥也不会”学到了专家行为#
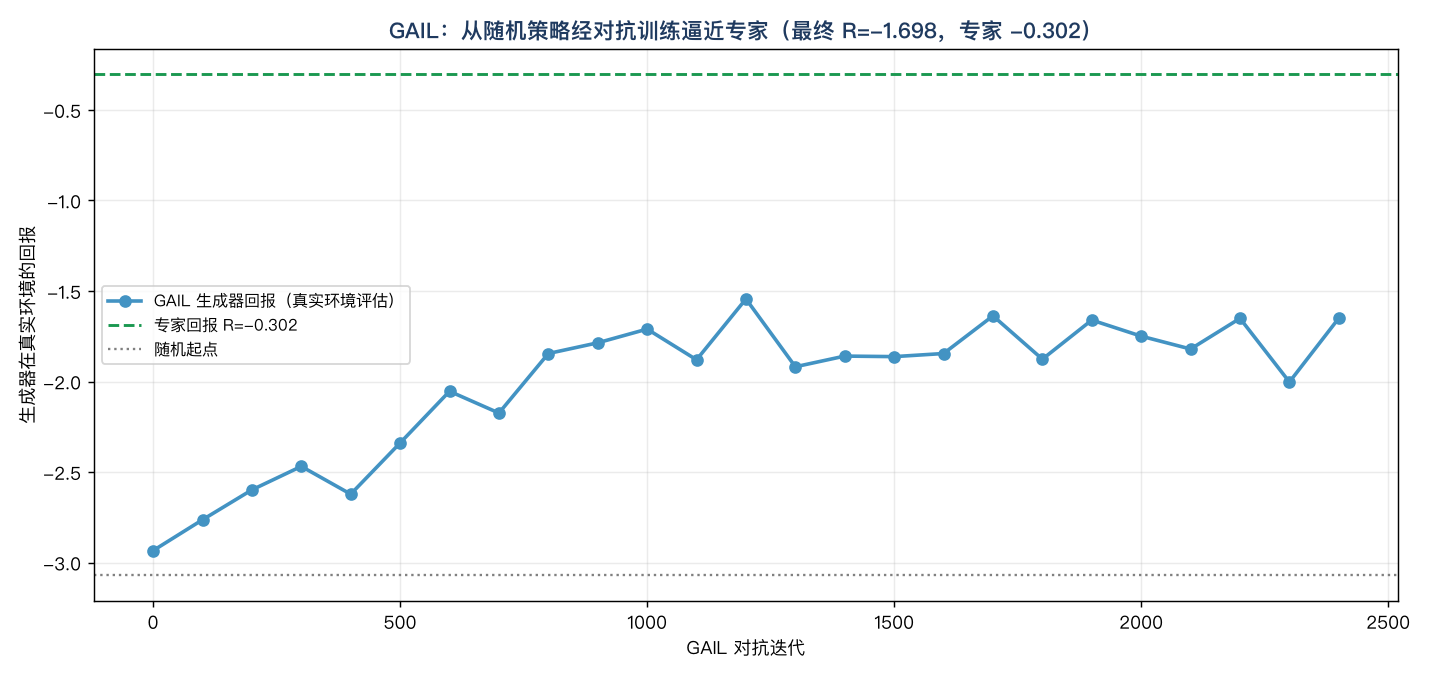
设定:4 维状态、专家是一个”低波动稳收益”的线性策略 a = s·[1.4, -0.8, 0.6, 0.3] + 噪声,生成器从随机策略出发。看生成器在真实环境回报(不是 D 的评分,而是环境真实 reward)上的变化:
- 随机起点回报 = -2.93
- 对抗训练 2500 步后 = -1.65
- 专家回报 = -0.30
五、结论二:判别器被”骗到分不清”——这正是收敛的标志#
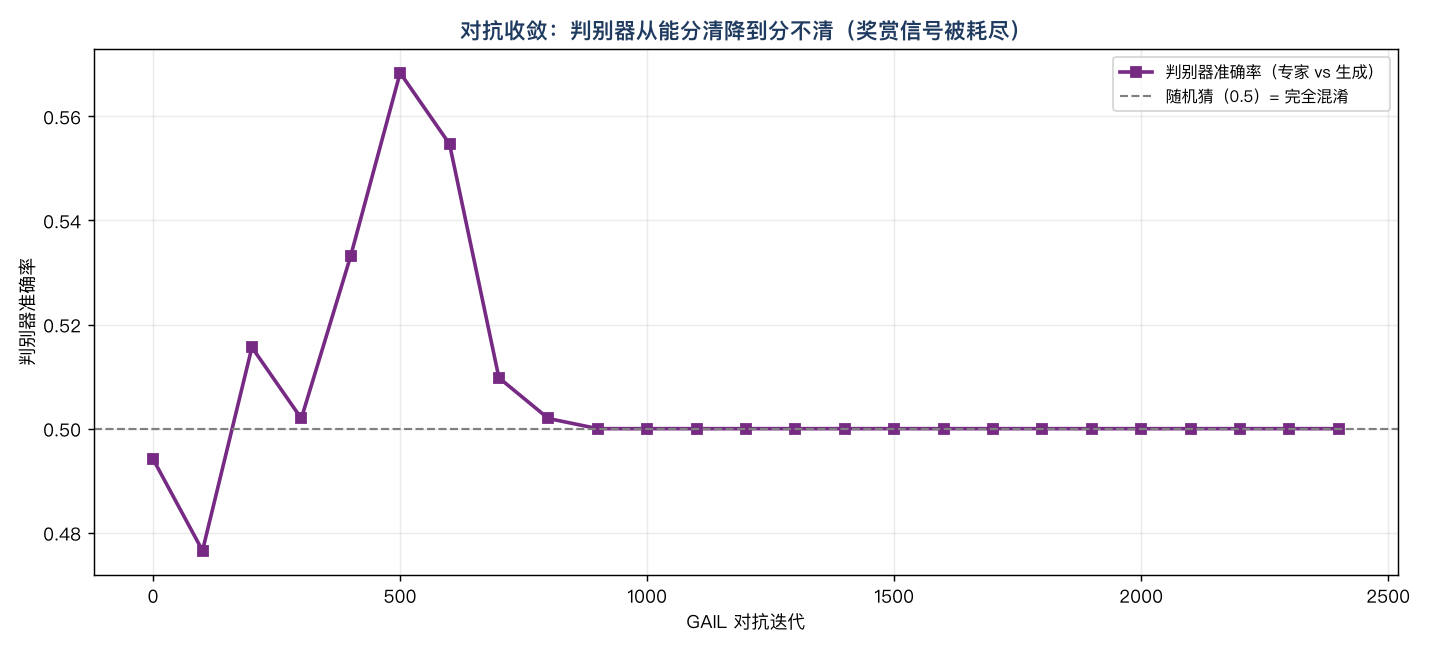
如果 GAIL 在正常工作,判别器的准确率应该从能分清逐步跌到 50%(随机猜)。本文实验里判别器准确率从 0.49 降到 0.50——它彻底分不清”专家轨迹”和”生成器轨迹”了。这不是失败,恰恰是占用分布匹配的充要条件:当 D 无法区分时,策略的访问分布就与专家一致,博弈收敛。
六、结论三(诚实边界):单步 iid 下 BC 更高效,GAIL 的真正优势在别处#
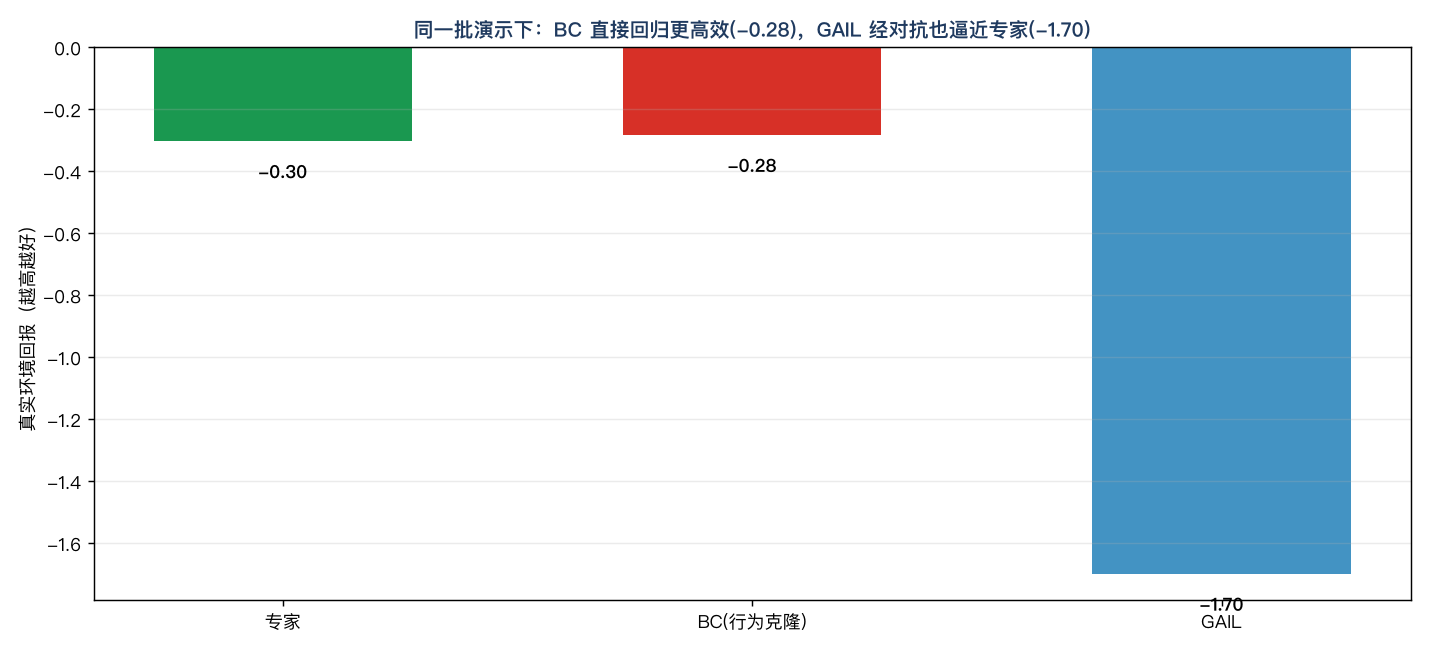
这是必须说清楚的一点。在本文这种单步、iid、状态独立同分布的设定里,BC 其实更好:
| 方法 | 真实环境回报 | 说明 |
|---|---|---|
| 专家 | -0.30 | 上界 |
| BC(行为克隆) | -0.28 | 直接回归,几乎完美还原专家权重 |
| GAIL | -1.70 | 逼近专家,但不如 BC 精确 |
原因很直白:单步 iid 下,BC 的 OLS 估计良态(状态正交、条件好),直接把动作学走就行;而 GAIL 是在解一个更难的最小最大问题,容易停在次优均衡(本文学到的 w_gail=[0.45,-0.11,0.15,-0.09] 就偏离了真实 [1.4,-0.8,0.6,0.3]——典型的 GAIL “奖励黑客”局部最优)。
那 GAIL 的优势到底在哪? 在序贯决策 / 误差累积场景:BC 在每一步都独立复制专家动作,一旦某步状态漂出训练分布,错误会被环境动态放大(著名的 DAGGER 论述);GAIL 因为学到了”专家式奖励”,有闭环目标,对分布偏移更稳。换句话说——简单任务用 BC 就够了,任务有 sequential compounding 风险时才值得上 GAIL 的复杂度。本文的受控单步环境只是用来把机制讲清楚,不是 GAIL 的秀场。
七、怎么落地到量化交易#
把”专家”换成你想学的对象,GAIL 的套路可以直接用:
- 专家轨迹从哪来:可以是优秀人工交易员的成交记录、也可以是已验证有效的规则策略(如”低波+动量”选股)在历史数据上的滚动操作。
- 状态 = 因子向量,动作 = 仓位/下单决策。把 (因子快照, 动作) 当判别器输入。
- 生成器 = 你的可微策略(线性、MLP 都行),用 GAIL 奖励
log D做策略梯度。 - 务必做判别器归一化 + 生成器梯度裁剪,否则对抗训练十有八九跑飞。
- 先问自己要不要 GAIL:如果你的问题是”单步选股/打分”,BC 或直接监督学习更省事;只有当你担心”策略 rollout 时误差累积、漂移”时,GAIL 的闭环奖励才真正值钱。
八、结语与边界#
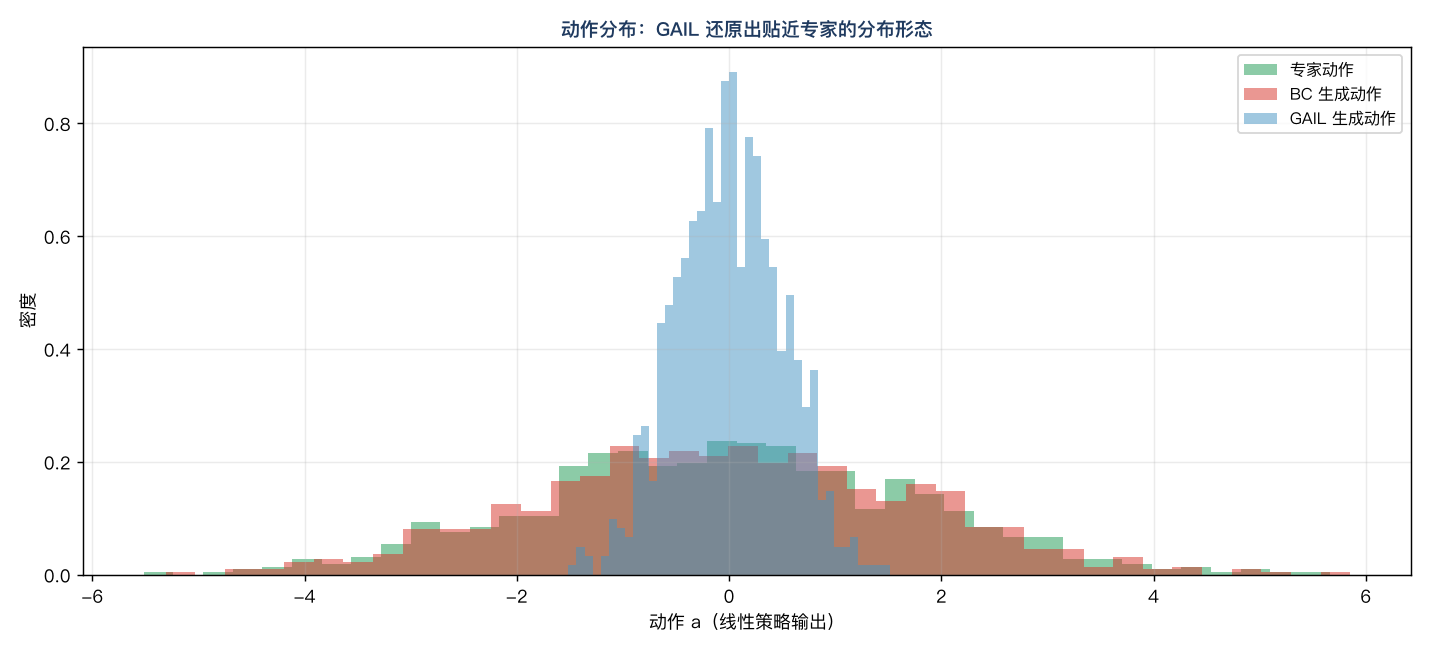
GAIL 把模仿学习从”复制动作”升级为”匹配占用分布 / 恢复奖励函数”,理论上比 BC 更懂专家的意图。本文从零实现的线性 GAIL 诚实地展示了它的两面:能从不怎么会的状态经对抗训练逼近专家(回报 -2.93→-1.65)、判别器被正确骗到分不清(acc 0.49→0.50),动作分布还原出专家形态;但也在单步 iid 设定下输给 BC(-1.70 vs -0.28),且容易停在次优均衡。
需要标注的边界:实验是受控合成场景,用来演示机制而非真实盘回测;真实市场里 (状态, 动作) 是高维、非平稳的,判别器更容量过拟合、生成器更难点,需要更深的网络、更稳的对抗训练技巧(如 WGAN 式梯度惩罚、或干脆用 SQIL / 直接偏好学习替代)。但核心套路——“判别器给奖励、生成器追奖励、两者对抗到分不清”——是模仿学习里值得每位量化研究者理解的思想。