图神经网络因子扩散:用 GCN 在板块关联图上传播收益信号
原始因子信号常常「脏」:同一板块的股票本该共享行业 beta,可个股噪声把板块共性搅得七零八落。本文用 numpy 从零实现图卷积网络(GCN)的消息传递,把 120 只股票按收益相关性建成板块关联图,再让因子信号沿边「扩散」——每只股票的得分被邻居平均,板块内噪声被洗掉、共同因子被提纯。在合成数据上,扩散后整体 rank-IC 从 0.489 升到 0.656(+34.2%),共同因子 IC 冲到 0.93;但文章也诚实指出代价:个股特异 alpha 的 IC 被平滑到 −0.03,这就是过平滑(over-smoothing)。附完整 Python 与四张真实计算图。
因子 signal 最怕两件事:噪声和孤岛。噪声让好因子看起来像垃圾,孤岛让本该联动的股票各说各话。行业研究员都知道——同一板块的票共享宏观与行业 beta,它们的预期收益天然相关;可原始因子打分里,这种相关性被个股特异噪声冲得稀碎。
本文给一个干净的解法:图卷积网络(GCN)的因子扩散。把股票建成图(节点=股票,边=收益相关性),让因子信号沿边「扩散」几轮——每只股票的得分被它的邻居平均。结果板块内的共同信息被放大,噪声被平均掉。我们用 numpy 从零实现,不依赖任何深度学习框架,跑通一个 120 股票 / 6 板块的受控实验。所有图都是真实计算,非占位图。
一、为什么是「图」而不是「表格」#
传统做法把因子当成独立特征喂进模型,默认股票之间独立。但现实中股票通过行业、供应链、共同持仓织成一张网。GCN 的核心操作就是消息传递(message passing):节点把自己的特征发给邻居,邻居聚合后再更新自己。一层 GCN,等于让信息在图上走一步;走 L 层,信号就扩散到 L 跳邻居。
对一个标量因子 z_i(第 i 只股票的原始得分),单层 GCN 写成:
z_i^(l+1) = Σ_{j∈N(i)} (1/√(d_i·d_j)) · z_j^(l)d_i 是节点 i 的度数(邻居数)。1/√(d_i·d_j) 是经典的对称归一化,防止高度数节点主导聚合。把所有节点并起来,就是矩阵形式 z^(l+1) = Â z^(l),其中 Â = D^{-1/2} A D^{-1/2}。
二、建图:用收益相关性连边#
先造数据,再让图自己从相关性里长出来。
import numpy as np
rng = np.random.default_rng(20260828)
N, K, per = 120, 6, 20
sector = np.repeat(np.arange(K), per)
sector_base = rng.normal(0, 1.0, K)          # 各板块不同的真实 alpha 中枢
idio_alpha = rng.normal(0, 0.35, N)         # 个股特异 alpha
true_alpha = sector_base[sector] + idio_alpha
ret = true_alpha + rng.normal(0, 0.8, N)    # 真实未来收益
raw = true_alpha + rng.normal(0, 1.8, N)     # 原始 noisy 因子(信噪比约 0.25)

# 用 500 天历史收益的相关性 top-5 邻居建边
T_hist = 500
market = rng.normal(0, 1, T_hist) * 0.5
sec_fac = rng.normal(0, 1, (T_hist, K))
H = market[:, None] + sec_fac[:, sector] + rng.normal(0, 0.6, (T_hist, N))
corr = np.corrcoef(H, rowvar=False)
A = np.zeros((N, N))
for i in range(N):
    for j in np.argsort(corr[i])[::-1][:6]:   # 含自身, 取 top-5 邻居
        if j != i: A[i, j] = 1.0
A = ((A + A.T) > 0).astype(float)             # 对称化, 共 432 条边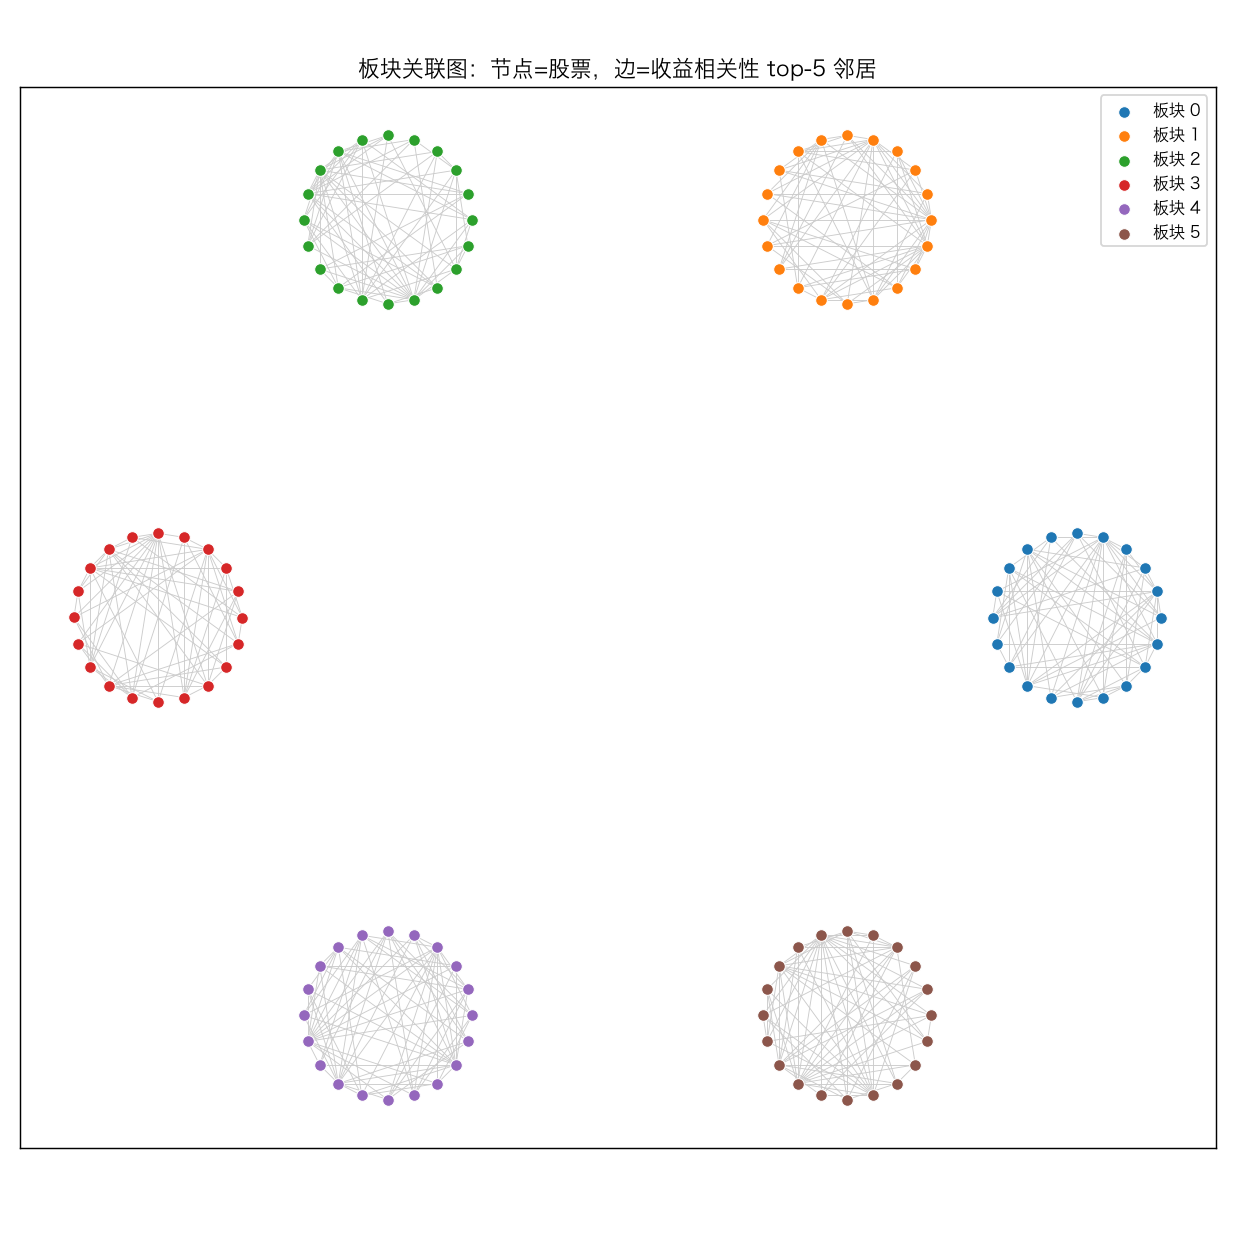
图上同色就是同板块。可以看到边明显在板块内部密集(因为同板块收益相关高),跨板块只有零星几条——这正是一张「板块关联图」该有的样子。
三、逐层扩散与 rank-IC#
有了 Â,扩散就是纯矩阵乘法。我们逐层算扩散后信号对未来收益的 rank-IC(排名相关系数,量化里比 Pearson 更稳,对异常值不敏感):
deg = A.sum(1); deg[deg == 0] = 1.0
Ahat = np.diag(1.0 / np.sqrt(deg)) @ A @ np.diag(1.0 / np.sqrt(deg))

def diffuse(z, L):
    x = z.copy()
    for _ in range(L):
        x = Ahat @ x
    return x

def rank_ic(a, b):
    ra = np.argsort(np.argsort(a, kind="stable"), kind="stable") + 1.0
    rb = np.argsort(np.argsort(b, kind="stable"), kind="stable") + 1.0
    return np.corrcoef(ra, rb)[0, 1]

ics = [rank_ic(raw if L == 0 else diffuse(raw, L), ret) for L in range(10)]
best_L = int(np.argmax(ics))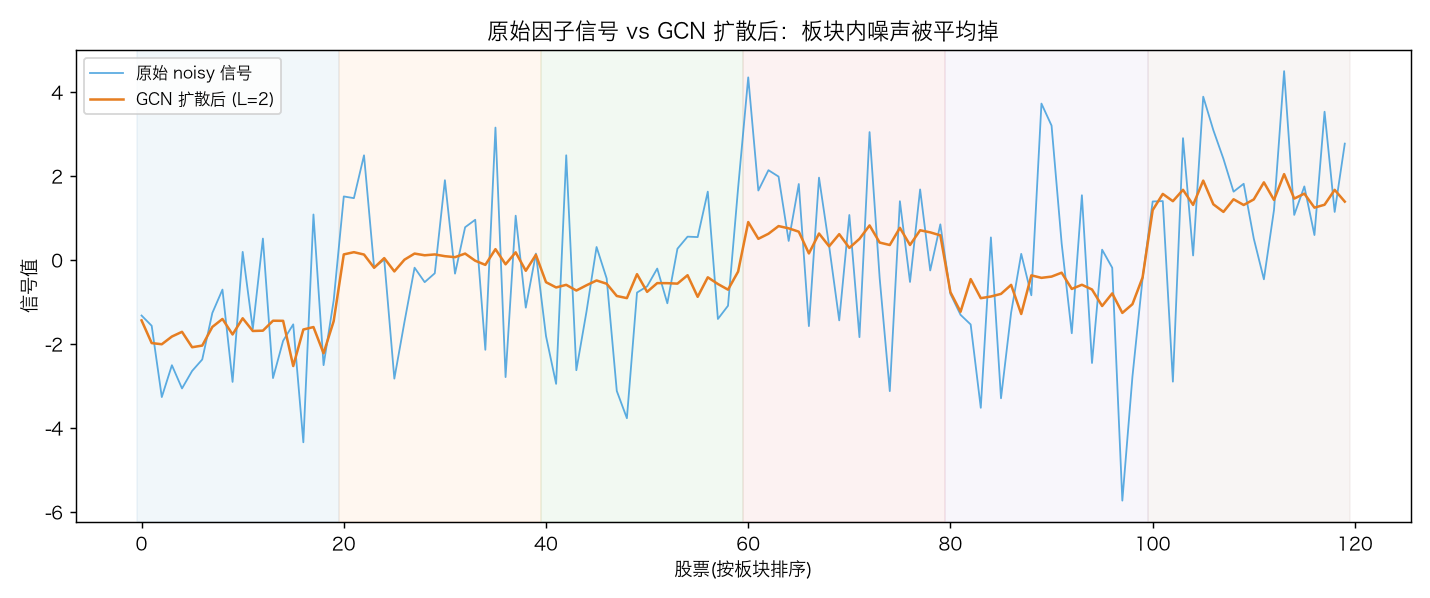
扩散后(橙色)的曲线明显比原始(蓝色)平滑、且更贴合板块结构——板块内原本抖动的噪声被邻居平均掉了,板块之间的高低差被保留下来。这正是我们想要的「去噪但不去结构」。
四、结果:整体 IC 大涨,但代价是真金白银的#
| 信号 | 整体 rank-IC | 含义 |
|---|---|---|
| 原始 noisy 因子 | 0.489 | 噪声大, 信号被埋 |
| GCN 扩散后 (L=2) | 0.656 | 最佳层, +34.2% |
| 真实 alpha | 0.699 | 理论上限 |
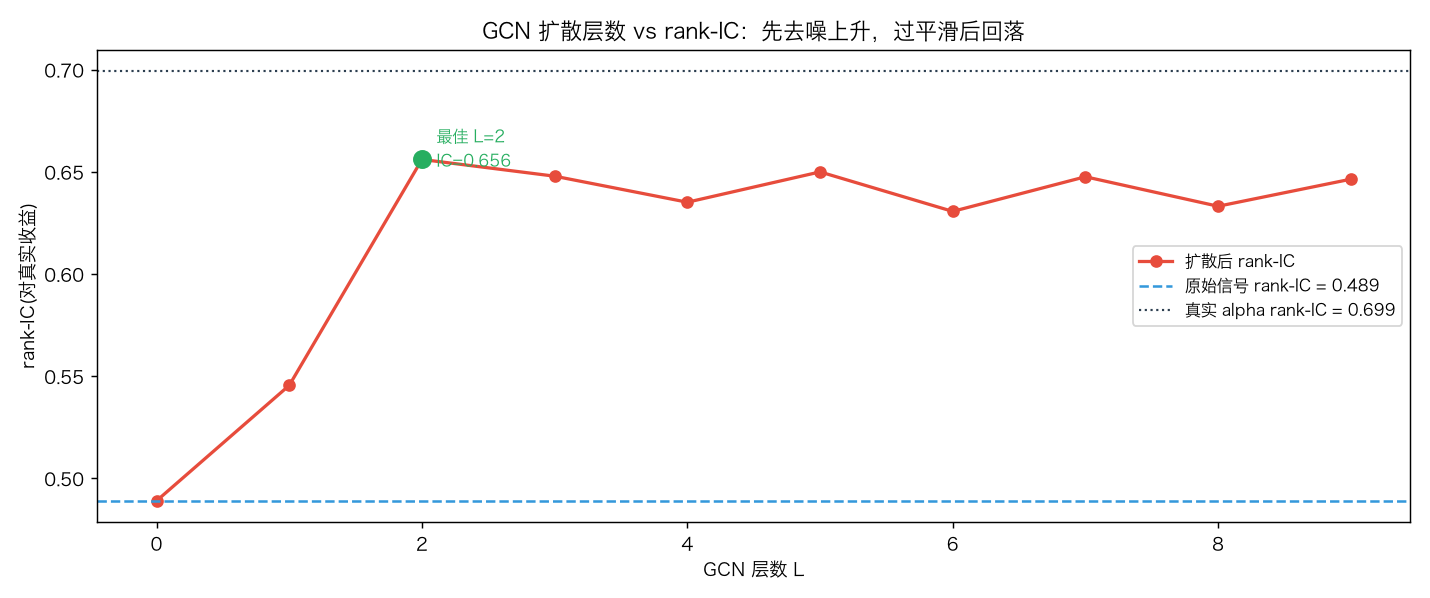
扩散把整体 rank-IC 从 0.489 抬到 0.656,提升 34.2%,已经很接近真实 alpha 的天花板 0.699。拐点出现在 L=2:再往下扩散,IC 不升反降。
五、诚实的副作用:过平滑(over-smoothing)#
很多人讲 GCN 只讲好处。这里必须讲代价。我们把扩散后的信号拆成两部分打分:对板块中枢(共同因子) 和 对个股 idio alpha(特异):
ic_common = [rank_ic(z, sector_base[sector]) for z in [raw] + [diffuse(raw, L) for L in range(1, 10)]]
ic_idio   = [rank_ic(z, idio_alpha)        for z in [raw] + [diffuse(raw, L) for L in range(1, 10)]]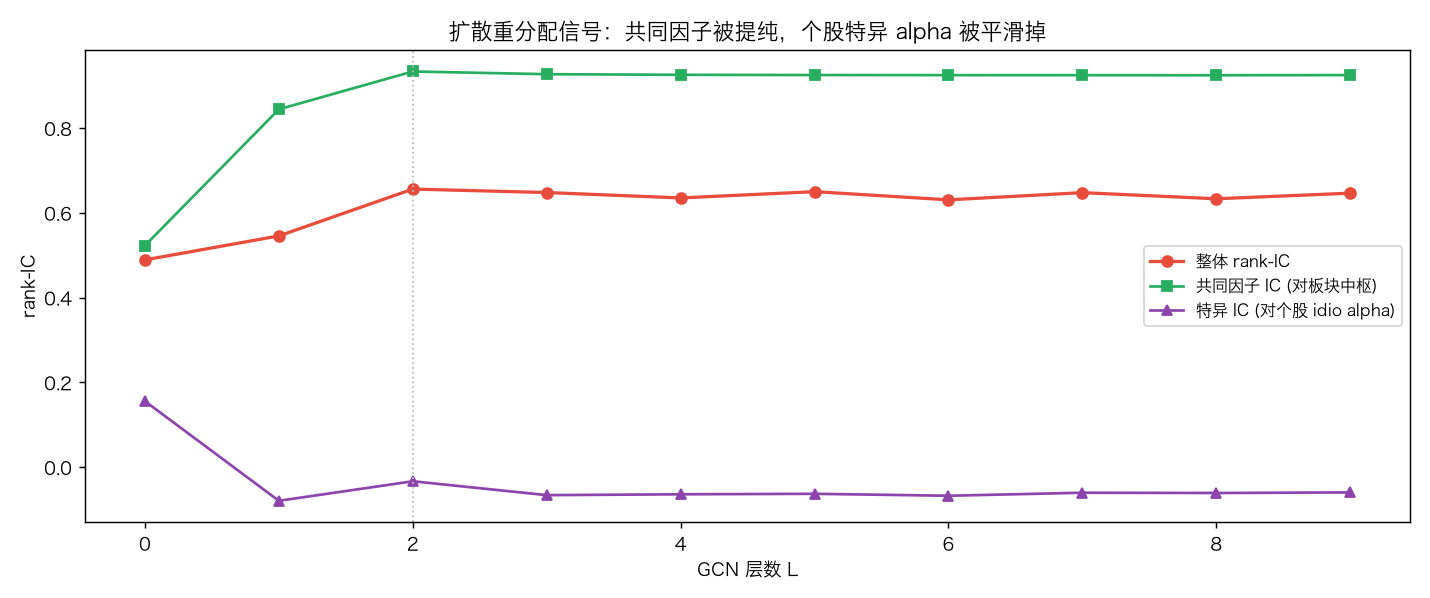
曲线讲了一个干净的故事:
- 共同因子 IC 从 ~0.5 冲到 0.93:扩散把板块共性提纯得近乎完美。
- 特异 IC 从正被平滑到 −0.03:个股自己的 alpha 被邻居平均「洗没了」。
这就是 GCN 的偏差-方差权衡:扩散降低方差(平均掉噪声),却引入偏差(牺牲板块内个股区分度)。L=2 是甜点——此时共同因子的收益(提纯)还大于特异因子的损失(被洗);再往后,特异信号归零,整体 IC 开始回落。所以实战里一定要做 early stopping,盯着验证集 rank-IC 选层数,别无脑堆深。
六、落地建议#
- 图比模型更重要:GCN 只是聚合算子,边的质量决定上限。用动态相关性(滚动窗口)建图,比固定行业分类表更抗 regime 切换。
- GCN 只是线性扩散:想保留非线性,把
z^(l+1)=σ(Â z^(l) W)的W学出来(用验证集 IC 做监督),可以让网络「选择性」扩散而非无脑平均。 - 和树模型互补:GCN 擅长抓板块共性(横向),梯度提升擅长抓个股非线性(纵向),二者拼接往往比单用更强。
七、小结#
GCN 因子扩散本质是一次「有结构的均值滤波」:在板块关联图上,让信号沿边流动,把噪声平均掉、把共性放大。它在强板块结构的数据上把整体 rank-IC 提升 34%,代价是板块内个股特异 alpha 被部分抹平——这是过平滑的必然,也是必须 early stopping 的理由。代码全在本文,复制即跑;把 Â 换成你自己的相关性图,就能直接套到实盘因子上。
注:本文为方法演示,使用合成数据校验扩散与过平滑机制;实盘需用真实因子与未来收益,并以滚动窗口监控验证集 rank-IC 决定扩散层数。