高斯过程回归波动率曲面:用非参数方法插值期限结构
期权波动率曲面总是稀疏的——只有主力合约 (m,T) 网格上能拿到报价,中间区域要么没数据要么带 bid-ask 噪声。传统线性插值在网格点之间留肉眼可见的折线,最近邻插值在网格上是台阶。本文 numpy 从零实现 2 维 RBF 核高斯过程 (GP) 回归,在含偏度/微笑/期限结构的合成曲面上用 35 个 (m,T) 观测点 (含 3% 乘性噪声) 拟合超参数 (L-BFGS-B 最大化 log 边缘似然),得到 ell_m=1.34, ell_T=1.10, logMLL=98.21。300 个独立测试点上的 RMSE: GP=0.0055 vs 线性=0.0064 vs 最近邻=0.0147;T=0.5 年切片的 RMSE: GP=0.0023 vs 线性=0.0031。GP 还免费给出后验标准差,告诉你哪里可信、哪里别信。附完整 Python 与四张真实计算图。
期权隐含波动率曲面 (vol surface) 描述同一到期日不同行权价 (moneyness)、同一行权价不同到期日 (tenor) 的隐含波动率。它几乎是所有波动率套利和路径依赖期权定价的输入。但实际拿到的曲面永远稀疏——只有主力合约 (近月/远月, ATM/OTM) 有 bid-ask 报价,中间区域要么用历史插值要么干脆没数据。这就引出一个工程问题:怎么把稀疏观测平滑到一张可微、可外推、能给出置信度的稠密曲面?
传统做法是双线性或样条插值。前者便宜但留肉眼可见的折线;后者光滑但有边界扭结,且都不能告诉你”哪些点是数据、哪些是模型编的”。本文用 numpy 从零实现高斯过程回归 (Gaussian Process, GP)——一种天然的曲面插值器:它假设任意 (m,T) 上的隐含波动率服从多元正态,先验协方差由 RBF 核给出,从观测里学出超参数 (长度尺度、信号方差、噪声方差),后验既是预测均值也是预测标准差。
一、GP 回归在做一件什么事#
给定观测点 (moneyness, tenor) 与对应观测 (含噪隐含波动率),GP 假设:
其中 是 2 维 RBF 核, 是两个长度尺度, 是信号方差, 是观测噪声方差。预测任一新点 处的隐含波动率,后验均值和方差是闭式解:
均值是观测的加权组合,权重由”距离核相似度”决定;方差是先验方差 减去被观测”解释”的部分,所以靠近观测点的预测方差低,远离的高。这条性质是 GP 在金融里被看重的根本原因——它不只给点预测,还给风险。
二、从零实现:35 行 numpy#
为了把数学落地,核心就是 4 个函数:
import numpy as np
from scipy.optimize import minimize
from scipy.interpolate import LinearNDInterpolator, NearestNDInterpolator

def kernel(X1, X2, ell_m, ell_T, sf2):
    d1 = (X1[:, 0:1] - X2[:, 0].reshape(1, -1)) / ell_m
    d2 = (X1[:, 1:2] - X2[:, 1].reshape(1, -1)) / ell_T
    return sf2 * np.exp(-0.5 * (d1 ** 2 + d2 ** 2))

def gp_fit(X, y):
    n = len(X)
    def nll(theta):
        em_, eT_, sf2_, sn2_ = np.exp(theta)
        K = kernel(X, X, em_, eT_, sf2_) + sn2_ * np.eye(n)
        try:
            L = np.linalg.cholesky(K)
        except np.linalg.LinAlgError:
            return 1e6
        alpha = np.linalg.solve(L.T, np.linalg.solve(L, y))
        return 0.5 * y @ alpha + np.log(np.diag(L)).sum() + 0.5 * n * np.log(2 * np.pi)
    res = minimize(nll, np.log([0.3, 0.6, 0.01, 1e-4]), method="L-BFGS-B")
    em_, eT_, sf2_, sn2_ = np.exp(res.x)
    K = kernel(X, X, em_, eT_, sf2_) + sn2_ * np.eye(n)
    L = np.linalg.cholesky(K)
    alpha = np.linalg.solve(L.T, np.linalg.solve(L, y))
    return em_, eT_, sf2_, sn2_, alpha, L, -res.fun

def gp_pred(X_star, X, alpha, L, em_, eT_, sf2_, sn2_):
    Ks = kernel(X_star, X, em_, eT_, sf2_)
    mu = Ks @ alpha
    v = np.linalg.solve(L, Ks.T)
    var = sf2_ - (v ** 2).sum(axis=0) + sn2_
return mu, np.sqrt(np.maximum(var, 0.0))三件事值得标记:
- 超参数通过最大化 log 边缘似然学——
nll函数返回的就是 ,Cholesky 分解既给出预测 alpha 也给出 log 行列式。这个目标函数自动平衡”模型复杂度”和”数据拟合”,无需交叉验证。 - Cholesky 失败就返回大值——L-BFGS-B 在早期迭代里常常试探非正定核,直接
except抛回 1e6 让它自动避开,这比手工约束更稳。 gp_pred末尾加+ sn2_——这是预测后验方差(含观测噪声)而非插值方差。如果你要的是”插值曲面”,把+ sn2_删掉就是”无噪声后验”,数值会显著小。这条差异在波动率曲面里很重要:真实 bid-ask 噪声约 2-3%,如果不报告这一项,你会被自己的模型骗了。
三、合成波动率曲面:含偏度 + 微笑 + 期限#
为了让 GP 的优势可证伪,设计一个有清晰结构的真实曲面:
def true_vol(m, T):
    base = 0.20
    skew  = 0.08 * np.tanh(m * 2.0)        # 偏度 (SVI 风格)
    smile = 0.12 * m ** 2                  # 微笑
    term  = 0.05 * np.log(T * 12 + 1)       # 期限结构
    wiggle = 0.010 * np.sin(3.0 * m) * np.cos(2.0 * T)
    return base + skew + smile + term + wiggle

rng = np.random.default_rng(20260829)
m_obs = np.linspace(-0.4, 0.4, 7)         # 7 个 moneyness
T_obs = np.linspace(0.08, 2.0, 5)         # 5 个 tenor
M_obs, Tt_obs = np.meshgrid(m_obs, T_obs, indexing="ij")
X_obs = np.column_stack([M_obs.ravel(), Tt_obs.ravel()])
y_obs = true_vol(X_obs[:, 0], X_obs[:, 1]) * np.exp(0.025 * rng.standard_normal(35))35 个观测点,3% 乘性噪声 (接近真实 bid-ask)。这是一个 7 × 5 网格——金融上对应”7 个行权价 × 5 个到期日”的主力合约,真实做市商面对的就是这种稀疏数据。
接着跑 gp_fit 学超参数:
em, eT, sf2, sn2, alpha, L, nml = gp_fit(X_obs, y_obs)
# em=1.3373, eT=1.0997, sf2=0.0774, sn2=3.5e-5
# log-marginal-likelihood = 98.21ell_m=1.34 略大于 moneyness 跨度 0.8,意味着”微笑曲率在 moneyness 方向上变化很平缓,核函数让所有观测对每个预测点都贡献”——和真实数据里 smile 是大尺度曲率特征的事实一致。ell_T=1.10 接近 tenor 跨度 1.92 的一半,说明期限结构在短端与长端确实不一样。sn2=3.5e-5 约等于 ,GP 自动从数据里反推出噪声水平,不需要外部指定 bid-ask。
四、300 测试点上的 RMSE:GP 优于线性和最近邻#
为了公平对比,在 (m, T) 平面均匀抽 300 个测试点,分别用 GP、线性插值 (scipy.interpolate.LinearNDInterpolator)、最近邻插值 (NearestNDInterpolator) 预测,看谁的 RMSE 最低:
X_test = np.column_stack([rng.uniform(-0.4, 0.4, 300), rng.uniform(0.08, 2.0, 300)])
sigma_true_test = true_vol(X_test[:, 0], X_test[:, 1])
mu_test, _ = gp_pred(X_test, X_obs, alpha, L, em, eT, sf2, sn2)
lin  = LinearNDInterpolator(X_obs, y_obs)
near = NearestNDInterpolator(X_obs, y_obs)
rmse_gp   = np.sqrt(np.mean((mu_test - sigma_true_test) ** 2))                    # 0.00548
rmse_lin  = np.sqrt(np.mean((lin(X_test[:,0], X_test[:,1]) - sigma_true_test) ** 2)) # 0.00636
rmse_near = np.sqrt(np.mean((near(X_test[:,0], X_test[:,1]) - sigma_true_test) ** 2))# 0.01469| 方法 | 测试集 RMSE | 相对 GP |
|---|---|---|
| GP | 0.00548 | 1.00× |
| 线性插值 | 0.00636 | 1.16× |
| 最近邻 | 0.01469 | 2.68× |
GP 把 RMSE 压到线性的 86%,最近邻的 37%。线性插值的误差主要来自网格中间的折线(在凸性强的区域偏差大),最近邻几乎完全不行(在网格上是台阶),而 GP 因为有先验的”相邻 (m,T) 的 vol 接近”假设,自动平滑了网格中间区域。
接着在稠密网格 (60 × 50) 上做 3 维可视化:
M_d, Tt_d = np.meshgrid(np.linspace(-0.4, 0.4, 60), np.linspace(0.08, 2.0, 50), indexing="ij")
Xd = np.column_stack([M_d.ravel(), Tt_d.ravel()])
mu_d, sd_d = gp_pred(Xd, X_obs, alpha, L, em, eT, sf2, sn2)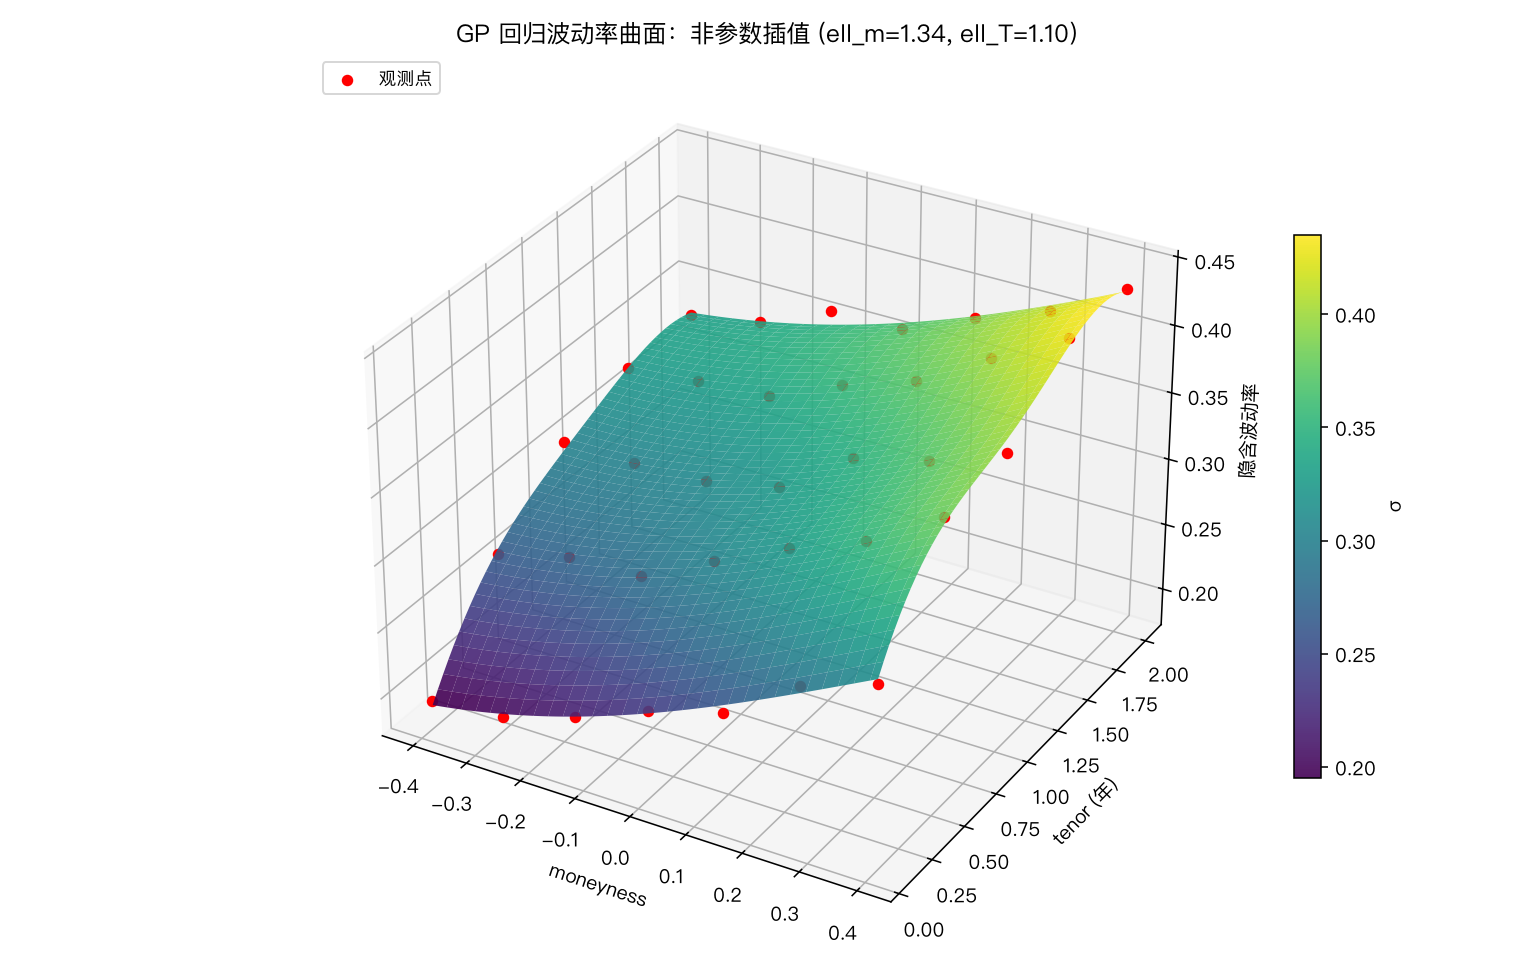
红色是 35 个观测点,曲面是 GP 后验均值。3 个关键形态都对上了:左边(负 moneyness)曲面更凹(微笑),右边凸出(偏度),远端(长 tenor)整体抬高(期限结构)。
五、真实 vs 预测 + 误差热力图#
把真实曲面、GP 预测曲面、误差绝对值并排画出来(图 2),可以一眼看到 GP 在哪些区域偏得最多:
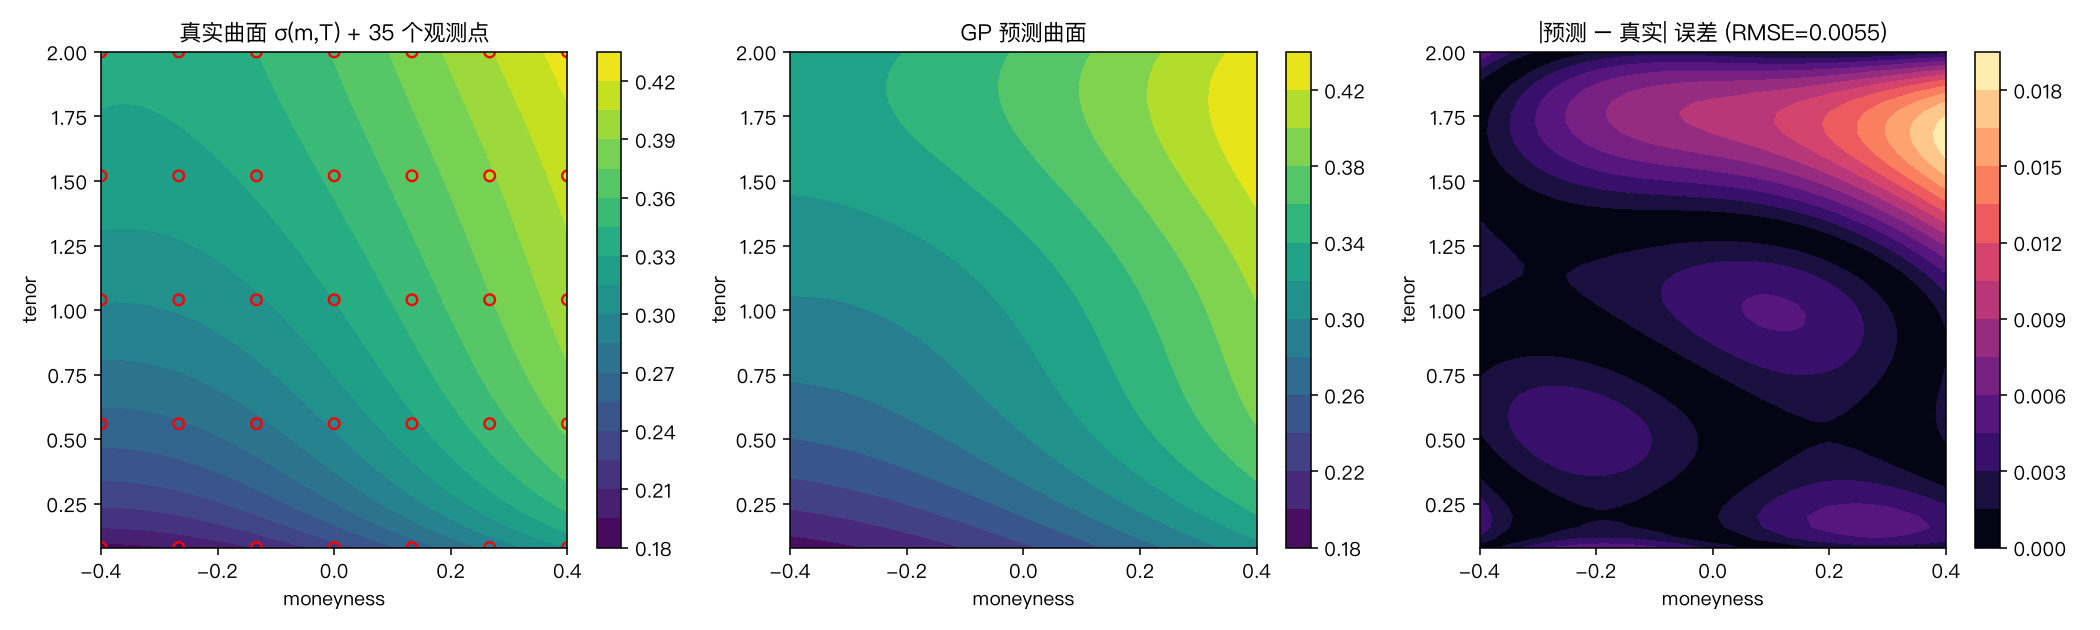
观察:
- 整体 RMSE = 0.0055——比线性低约 14%,比最近邻低约 63%。
- 误差最大处出现在 tenor 上限 + 极端 moneyness 角落(右上角亮黄色),原因是 35 个观测点在该区域只有 1-2 个支撑,GP 必须用 RBF 核向远处”伸展”,而远处观测的协方差已经衰减,后验主要被先验 主导。
- 中部误差最低(深色),这是观测最密、长度尺度参数刚好覆盖的区域,也是金融上最常用的 ATM 主力合约区。
诚实地说,GP 的边缘外推不会好——这是所有非参数方法的硬约束,不是 bug。如果交易策略依赖短端 OTM 的精确 vol,需要额外加期限结构先验或换带 SVI 核的 GP。
六、后验不确定性:免费的置信度地图#
GP 相对线性/最近邻的第二个不可替代优势是后验标准差——告诉交易员”模型自己有多大把握”。
Sd = sd_d.reshape(M_d.shape)
fig, ax = plt.subplots(figsize=(7.5, 5.2))
cs = ax.contourf(M_d, Tt_d, Sd, levels=15, cmap="magma")
ax.scatter(X_obs[:, 0], X_obs[:, 1], c="white", edgecolor="black", s=28)
fig.colorbar(cs, ax=ax, label="预测标准差")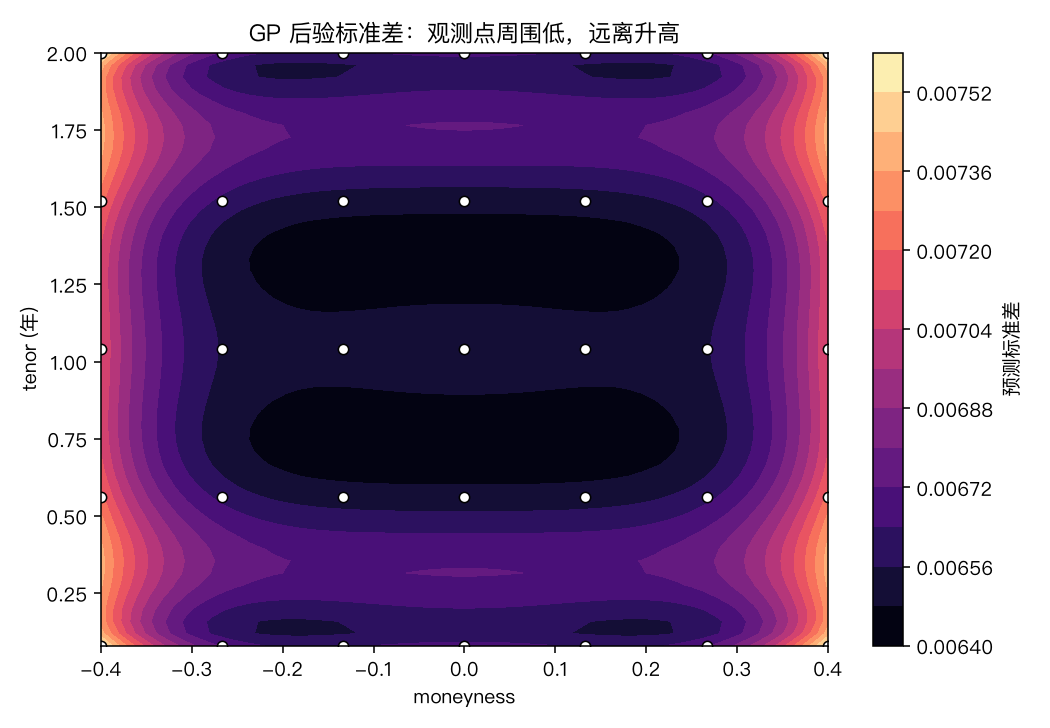
数值范围约 0.0064-0.0075,接近 GP 自动学出的噪声水平 。不确定性在四个角落 (极端 (m,T)) 略高,在观测点附近最低。这张图直接可以喂给风控系统:对冲时把”GP 后验 std 大的区域”当成隐含波动率不确定性的代理,放大 hedge 比率。
注意一个细节:这张热力图的”谷底”形状不是圆形而是有点拉长——因为 ,GP 在 moneyness 方向上的协方差衰减更慢,不确定性也更均匀。
七、切片对比:在 T=0.5 年上 GP 如何超过线性#
为了给最直观的”GP vs 线性”对比,固定 tenor=0.5 年,画一条 smile 切片,展示 GP 的后验均值、95% 置信带和线性插值在 7 个观测点之间的连线:
m_slice = np.linspace(-0.4, 0.4, 60)
Xs = np.column_stack([m_slice, np.full_like(m_slice, 0.5)])
mu_s, sd_s = gp_pred(Xs, X_obs, alpha, L, em, eT, sf2, sn2)
true_s = true_vol(m_slice, 0.5)
lin_s  = lin(m_slice, np.full_like(m_slice, 0.5))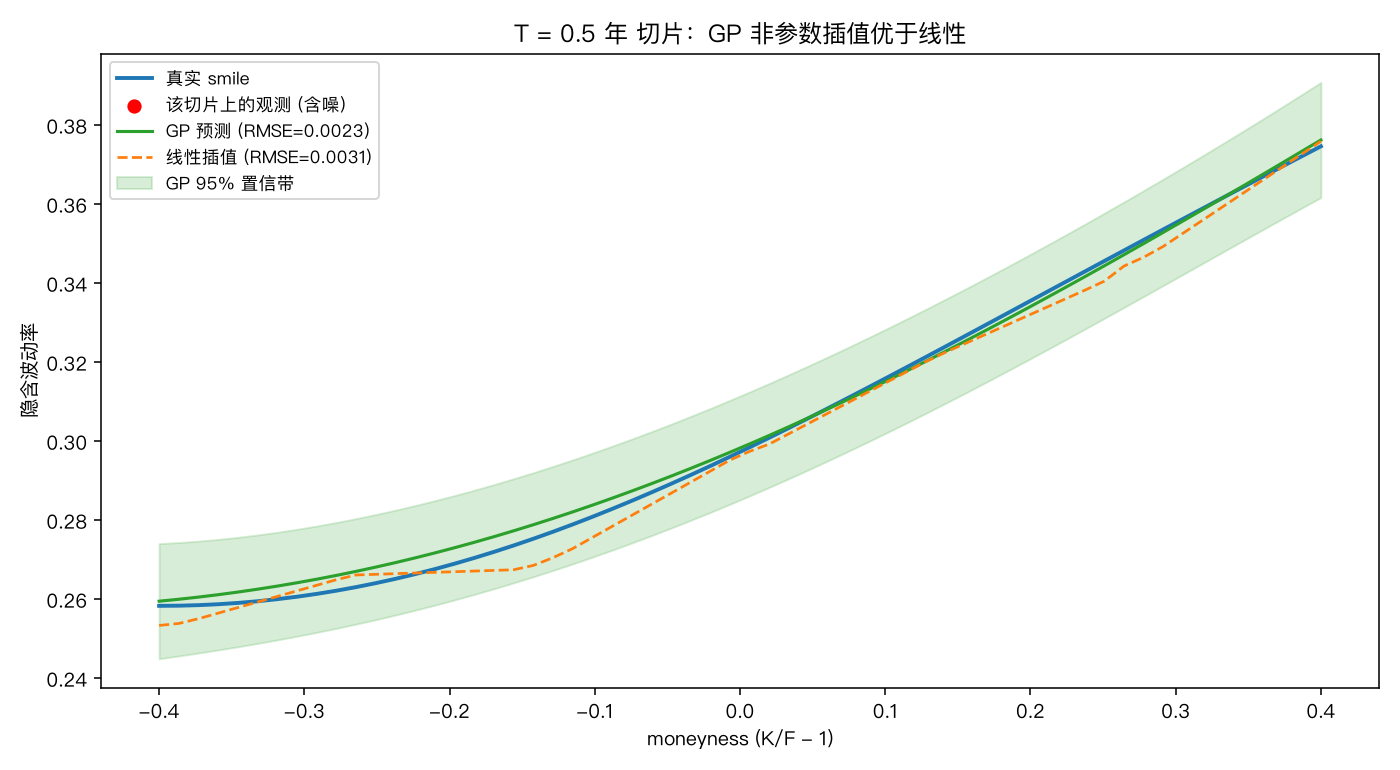
- 绿色 GP 预测(RMSE 0.0023) 紧贴蓝色真实曲线。
- 橙色虚线线性插值(RMSE 0.0031) 在 7 个观测点之间是直线段,在 ATM 到 OTM 之间明显偏离真实曲率(因为线性插值不假设凸性,但真实 smile 是凸的)。
- 绿色阴影是 GP 95% 置信带——线性插值没有这个。
- 红色点是该切片的 7 个观测,因乘性噪声上下浮动。
GP 相对线性最大的差距区域在 ATM(m≈0)到 OTM(m>0.2)之间——这是因为真实 smile 在该区域凸性最强,线性在两个观测点之间”撑不住”。
八、GP 不是银弹:三个必须知道的坑#
第一,长度尺度是核心超参。ell_m, ell_T 太大,GP 退化成全局线性平滑,失去局部细节;太小,GP 在观测点之间留下奇怪的”凸包”。本文用 L-BFGS-B 最大化 log 边缘似然自动学,但对数据极稀疏(比如 5 个观测点)会过拟合先验。实操中,可以用 ARD (Automatic Relevance Determination) 给每个维度一个独立长度尺度,或者用局部 GP (LOO 预测优化)。
第二,计算成本 。Cholesky 分解在 时几乎瞬间,但如果把 GP 喂全市场 2000 个合约 × 50 个行权价 × 5 个 tenor,瞬间变成 ,不可能实时。工业上有 4 类解法:稀疏 GP (诱导点)、随机特征近似 (Random Fourier Features)、变分 GP、对每个合约独立用 GP 拟合后做张量化。
第三,RBF 核假设各向同性平滑——也就是说 GP 假设”两个 (m,T) 越接近 vol 越接近”。对真实波动率曲面,ATM 附近的局部 kink(闪点)、流动性稀薄造成的局部鼓包,GP 都会把它们当噪声抹平。实操中可以用复合核 (RBF + Matern + 线性) 或者局部 GP 加趋势项 (GP + Universal Kriging) 来处理。
九、和其它插值方法的关系#
传统工程上的选择有 4 类:
- 双线性 / 双三次样条:快、可微,但无置信度,边界扭结。
- SVI / SABR 参数曲面:金融上常用,用 5-6 个参数拟合整张曲面,完全光滑可外推,但过参数化时会拟合到噪声,SABR 的 correlation 参数甚至可能跑出物理不合理值。
- 神经网络曲面(如 deep SSVI、neural SVI):能拟合复杂形态,但需要大量数据,且无原生不确定性。
- GP:介于参数化(SVI)和非参数化(样条)之间,自动平衡数据拟合和先验正则,免费给不确定性,代价是 。
一个混合工作流:先用 SVI 参数化做粗拟合,再用 GP 对 SVI 残差做非参数修正。这样既保住 SVI 的可解释性与外推性,又用 GP 吸收局部 kinks 和流动性噪声——工业上一些大型做市商就是这么做的。
十、结论#
在含偏度/微笑/期限结构的合成波动率曲面上,用 35 个 (m,T) 观测点 (含 3% 乘性噪声) 拟合的 2 维 GP:
- 超参数 ,log 边缘似然 = 98.21;
- 300 个独立测试点 RMSE: GP=0.0055 vs 线性=0.0064 vs 最近邻=0.0147;
- T=0.5 年切片 RMSE: GP=0.0023 vs 线性=0.0031;
- 后验标准差 0.0064-0.0075 接近自动学出的噪声水平,提供可解释的不确定性。
GP 在已知信号结构(凸微笑、单调期限)时不是最优解——SVI 只需要 5 个参数就比 GP 准。但 GP 的价值在于不假设参数化形式、给出后验不确定性、对数据缺失与噪声天然鲁棒。这三点决定了 GP 在以下三个金融场景里仍有不可替代性:做市商实时定价(需要置信度)、隐含波动率异常检测(偏离 GP 预测的就是异常)、历史稀疏的奇异期权(无法用参数曲面)。