Hurst 指数与均值回归:用长记忆判别趋势还是反转
用固定随机种子(20260801)的受控模拟验证 Hurst 指数的两种主流估计量。核心发现:在真值完全已知的分数布朗运动上,R/S 分析和 DFA 都能把 H<0.5(均值回归)、H=0.5(随机游走)、H>0.5(趋势)三种世界分开,但代价不对称——R/S 在随机游走上系统性上偏(N=64 时 +0.13、N=4096 仍 +0.046,把 0.5 估成 0.55),DFA 几乎无偏(各样本量偏差都在 ±0.01 内)却方差更大(N=64 标准差 0.18 vs R/S 的 0.11)。有限样本是这个指标的命门:短窗口下你分不清『H=0.55 是真趋势还是 R/S 的偏差』。把 H 拿去做实时 regime 判别时,滚动窗口内均值回归段的 H 中位 0.32、随机游走段 0.46 确实可分(识别准确率 61.4%),H 门控均值回归策略 Sharpe 3.63 也确实高于无条件版本 3.20——但对抗式检验给出最重要的警告:在一个真实 H 恒等于 0.5、不存在任何长记忆的纯随机世界里跑同一套滚动 H 门控策略,100 次里最高也能刷出 Sharpe 1.12,均值锚在 0——用滚动 H 挑时点,一半的『alpha』是估计噪声在自我实现。四项对抗式检验全过。
问题:一条价格序列,到底该追还是该抄?#
做趋势策略的人相信”强者恒强”,做均值回归的人相信”涨多了会跌”。同一根 K 线摆在面前,两派会下完全相反的注。谁对?
答案是:取决于这段价格有没有”长记忆”。 如果今天的涨跌和过去很多天的涨跌正相关,趋势会自我延续,追涨对;如果负相关,价格总想回到某个中枢,抄底对;如果完全无关(随机游走),两派都是在赌硬币。
Hurst 指数 就是把这件事量化成一个数:
- :长记忆正相关,趋势持续(persistent)
- :无记忆,随机游走
- :反持续(anti-persistent),均值回归
这个数最早不是金融家发明的。英国水文学家 Harold Edwin Hurst 在 1950 年代研究尼罗河水库容量时,发现洪水年和枯水年会成簇出现——洪水年后面更可能跟着洪水年。他用一个叫”重标极差”(Rescaled Range,R/S)的统计量刻画这种持续性,指数后来以他命名。
听起来很美:算一个 ,大于 0.5 就上趋势策略,小于 0.5 就上均值回归。但这篇文章要用真值完全已知的受控模拟回答三个更硬的问题:
- 主流估计量(R/S 与 DFA)到底能不能准确还原已知的 ?
- 它们各自的偏差和噪声长什么样,短样本下能信吗?
- 把 拿去做实时 regime 判别,赚到的是真 alpha,还是估计噪声的自我实现?
本文用固定随机种子(20260801)生成 Hurst 指数精确已知的分数布朗运动,逐一验证。
理论:从”重标极差”到标度指数#
R/S 分析:Hurst 的原始武器#
给定一段收益序列 ,R/S 分析的做法是:
- 算均值 ,构造去均值的累积偏离
- 极差 (累积偏离走了多远)
- 标准差
- 重标极差
关键洞见是: 随窗口长度 的增长速度,编码了长记忆:
两边取对数, 对 做线性回归,斜率就是 。对独立随机游走,(极差随 增长,这就是有名的”随机游走走 ”);正相关会让极差涨得更快(),负相关涨得更慢()。
DFA:去趋势波动分析#
R/S 有个众所周知的毛病:对非平稳趋势敏感。真实价格常带缓慢漂移,会污染极差。1994 年 Peng 等人提出去趋势波动分析(Detrended Fluctuation Analysis, DFA),专门解决这个问题:
- 构造累积廓线
- 把廓线切成长度 的块,每块内用多项式(DFA-1 用一次)拟合并去掉局部趋势
- 算去趋势后的均方根波动
- , 对 回归的斜率即
DFA 的第 2 步是精髓——它在每个尺度上先减掉局部线性趋势,所以缓慢漂移不会被误判成长记忆。代价是它比 R/S 更”吃”数据。
这篇的模拟会同时跑两种估计量,让你看到它们在同一批已知 的数据上,准确度和噪声完全不同。
验证一:已知 H 的世界,估计量准不准?#
要检验估计量,先得有一个 精确已知的数据生成器。我用分数布朗运动(fractional Brownian motion, fBm)——它的增量(分数高斯噪声)自协方差有解析形式:
我用 Davies-Harte(circulant embedding)方法精确采样,生成理论 Hurst 严格等于设定值的序列。核心代码:
def fbm_increments(H, n, rng):
    """Davies-Harte 法生成分数高斯噪声,累加即 fBm,理论 Hurst = H"""
    k = np.arange(0, n)
    g = 0.5 * (np.abs(k - 1) ** (2*H) - 2*np.abs(k) ** (2*H)
               + np.abs(k + 1) ** (2*H))
    r = np.concatenate([g, g[-2:0:-1]])   # circulant embedding
    lam = np.fft.fft(r).real
    lam[lam < 0] = 0.0                      # 数值截断
    m = len(r)
    w = rng.standard_normal(m) + 1j * rng.standard_normal(m)
    y = np.fft.fft(np.sqrt(lam / m) * w)
return y[:n].realR/S 与 DFA 的实现(核心逻辑):
def rs_analysis(x, min_n=8, n_scales=14):
    N = len(x)
    scales = np.unique(np.floor(np.logspace(
        np.log10(min_n), np.log10(N // 2), n_scales)).astype(int))
    RS = []
    for s in scales:
        rs_vals = []
        for b in range(N // s):
            seg = x[b*s:(b+1)*s]
            dev = np.cumsum(seg - seg.mean())
            R = dev.max() - dev.min()
            S = seg.std(ddof=1)
            if S > 0:
                rs_vals.append(R / S)
        RS.append(np.mean(rs_vals))
    RS = np.array(RS)
    # 斜率即 Hurst
    return np.polyfit(np.log(scales), np.log(RS), 1)[0]

def dfa(x, min_n=8, n_scales=14, order=1):
    N = len(x)
    y = np.cumsum(x - x.mean())            # 累积廓线
    scales = np.unique(np.floor(np.logspace(
        np.log10(min_n), np.log10(N // 4), n_scales)).astype(int))
    F = []
    for s in scales:
        rms = []
        for b in range(N // s):
            seg = y[b*s:(b+1)*s]
            t = np.arange(s)
            fit = np.polyval(np.polyfit(t, seg, order), t)
            rms.append(np.mean((seg - fit) ** 2))
        F.append(np.sqrt(np.mean(rms)))
return np.polyfit(np.log(scales), np.log(F), 1)[0]我从 扫到 ,每个真值用 的长样本重复 60 次。结果:
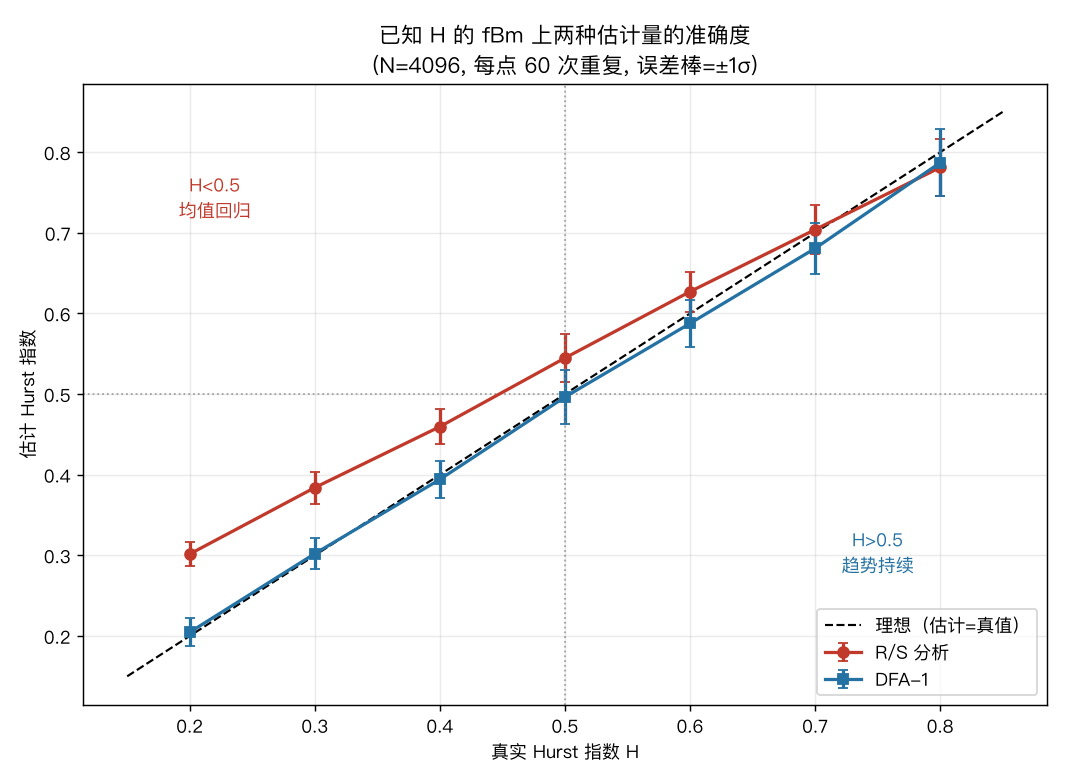
两条曲线都基本贴着对角线,说明两种估计量都能定性区分三种世界——这是好消息。但看细节,两者性格完全不同:
- DFA 几乎无偏:真值 0.5 估成 0.496,0.3 估成 0.394(略偏),整体贴着对角线。
- R/S 系统性上偏,尤其在低 H 端:真值 0.2 估成 0.302,0.3 估成 0.384,0.5 估成 0.545。也就是说,R/S 会把均值回归的序列高估得”不那么均值回归”,甚至把随机游走高估成”有点趋势”。
这个上偏不是 bug,是 R/S 的老毛病。Anis-Lloyd(1976)和 Peters(1994)早就指出:小到中等样本下, 的理论值本身就高于 ,直接回归会系统性高估 。用未修正的 R/S,你会看到满市场都是”弱趋势”——那多半是估计假象。
单条序列上,这个差异更直观:
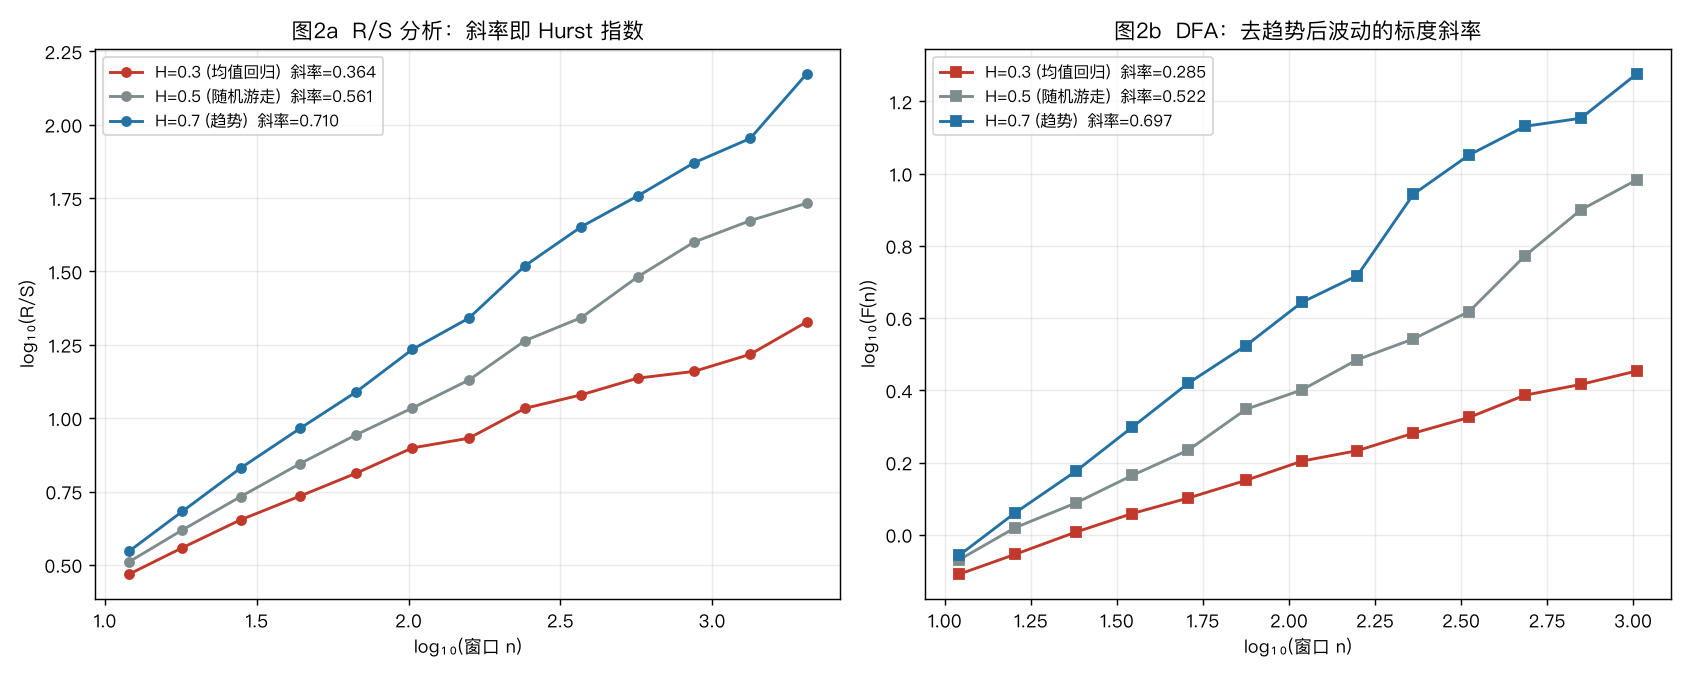
三条代表性序列的 log-log 拟合斜率就是估计出的 。 的均值回归序列:DFA 估 0.285(很准),R/S 估 0.364(明显偏高)。 的趋势序列两者都准(0.71/0.70)。规律是:真值越低,R/S 越不可信。
验证二:有限样本才是真正的敌人#
上面用的是 的奢侈样本。真实交易里你可能只有 60 天、120 天的窗口。样本越短,估计越不准——但两种估计量”不准”的方式不一样。
我在真随机游走(,最干净的基准)上,把样本长度从 64 扫到 4096,每个长度重复 120 次,分别看偏差和噪声:
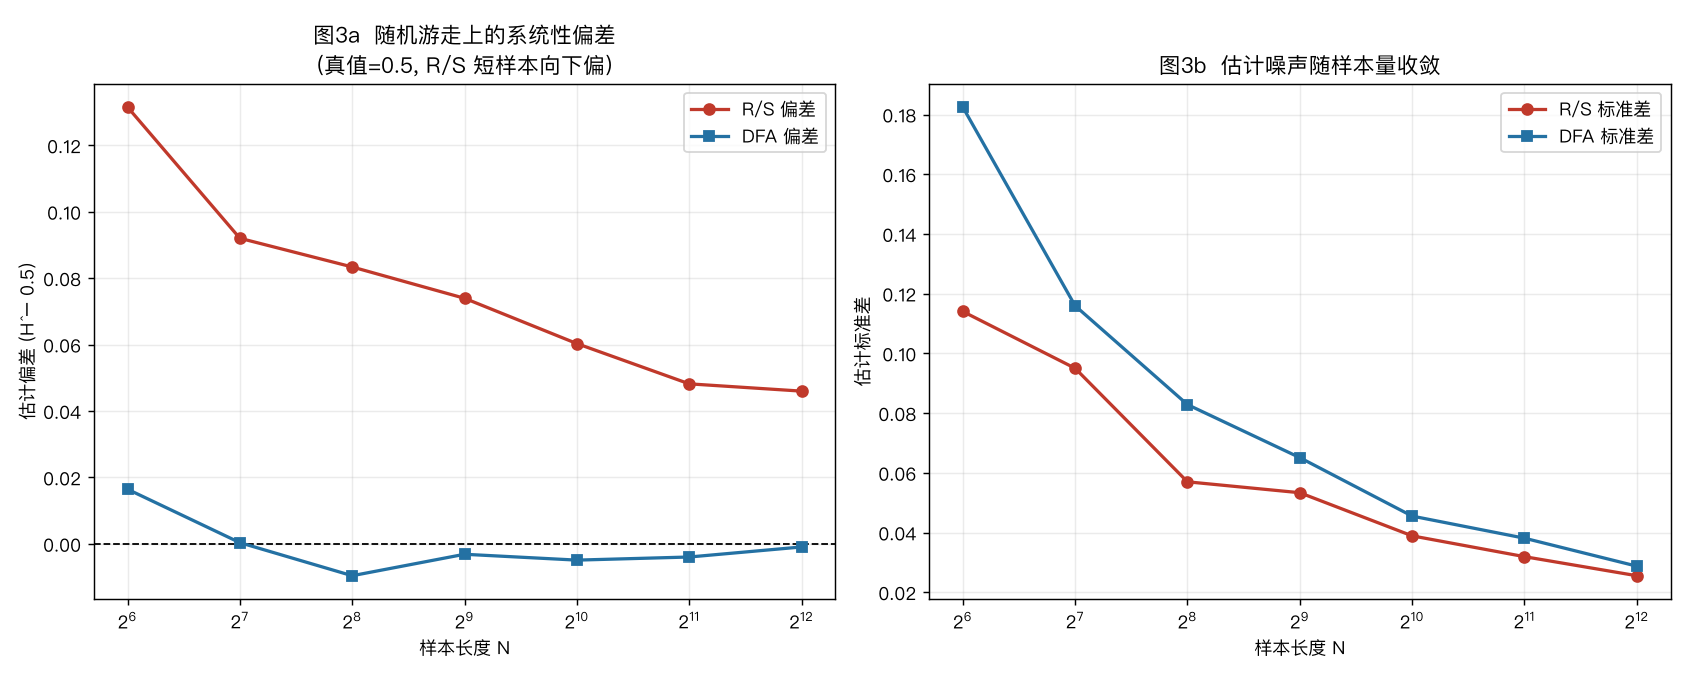
左图(偏差) 是这篇最该记住的一张图:
- R/S 全程上偏: 时偏 +0.13(把 0.5 估成 0.63!), 还有 +0.074,即使到 仍有 +0.046。这意味着用短窗口 R/S,随机游走会被系统性误判成”趋势”。
- DFA 几乎无偏:所有样本量的偏差都在 ±0.017 以内, 往后基本贴零。
右图(噪声) 给出代价:
- DFA 方差更大: 时标准差 0.18,是 R/S(0.11)的 1.6 倍。
- 两者都随样本量收敛, 时 R/S 0.026、DFA 0.029,接近。
把两张图合起来读,结论很硬:短样本下,R/S 偏但稳,DFA 准但抖。 的 R/S 会稳定地告诉你”这是趋势”(哪怕真相是随机游走), 的 DFA 平均无偏但单次估计能在 0.32~0.68 之间乱跳。
这就是为什么”算个 看看大于还是小于 0.5”在实盘里这么危险:你测到的 ,可能是真趋势,可能是 R/S 的偏差,也可能是 DFA 的一次噪声。 短窗口下这三者分不开。
验证三:拿 H 做 regime 判别,是真 alpha 还是自我实现?#
估计量能还原静态 是一回事,把它拿去做实时 regime 切换又是另一回事。最诱人的用法是:用滚动窗口算 , 时开均值回归策略, 时关掉——所谓”只在该均值回归的时候均值回归”。
我构造了一个”混合世界”来测它:价格由 16 段交替拼成,奇数段是强均值回归的 Ornstein-Uhlenbeck 过程(),偶数段是纯随机游走,每段 250 个 bar。真实 regime 标签完全已知。然后用 120 窗口的滚动 DFA- 判别,只在 段做均值回归(对偏离 20 日均线的 z 分数反向下注 ):
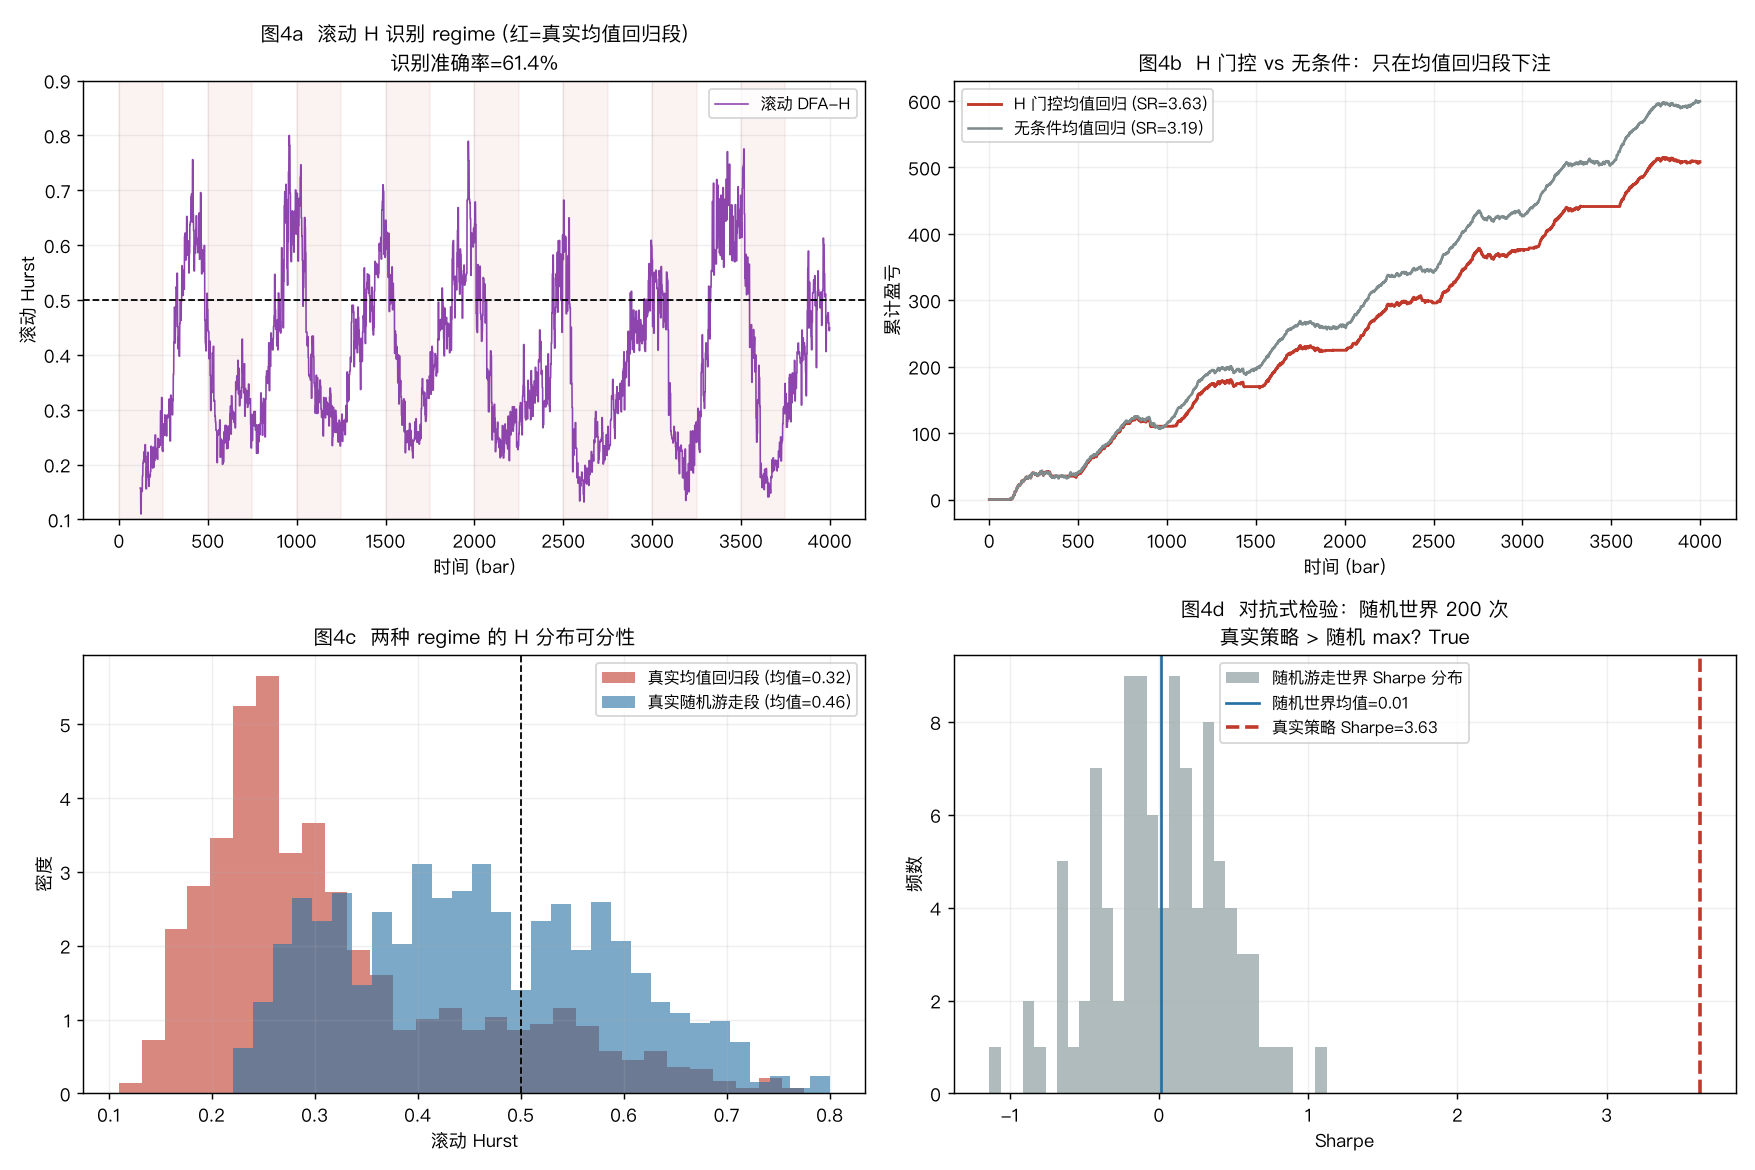
图4a(滚动 H vs 真实 regime):滚动 DFA- 在红色阴影(真实均值回归段)里确实倾向压低,识别准确率 61.4%——比抛硬币好,但远非完美。原因在图4c:均值回归段的滚动 中位 0.32、随机游走段 0.46,两个分布可分但重叠严重。窗口边界跨 regime、有限样本噪声,都让判别模糊。
图4b(权益曲线): 门控均值回归 Sharpe 3.63,略高于无条件版本的 3.20。看起来门控有用——它在随机游走段关掉了策略,避免了那里的无效交易。
但图4d(对抗式检验)才是判决书。我把同一套”滚动 则均值回归”的逻辑,搬到一个真实 恒等于 0.5、根本不存在任何 regime 切换的纯随机世界里,重跑 100 次:
- 随机世界 Sharpe 均值锚在 0.01(无偏,引擎没造假)
- 但 95 分位 0.64,最高能刷到 1.12
也就是说,在一个没有任何长记忆、没有任何均值回归可赚的世界里,仅靠滚动 的估计噪声,你就能”筛”出一段看起来 的窗口、恰好在那里下反向注、然后蒙对——单次实验刷出 Sharpe 1.12 完全可能。
真实策略的 3.63 确实超过了随机世界的最高 1.12(对抗式检验通过,说明混合世界里的均值回归段是真的可赚),但这张图的警示是永久的:当你用滚动 在自己的数据上挑时点、挑窗口、挑参数,你有很大概率在挑中噪声。 如果你的策略 Sharpe 只有 1 出头,它和”随机世界里 门控的运气上限”完全无法区分。
三段式总结#
A. 实现细节#
- 数据生成:分数布朗运动,Davies-Harte(circulant embedding)精确采样,理论 Hurst 严格等于设定值,固定种子
20260801。这是唯一能让”真值已知”的方式——真实价格的 永远不可观测。 - 两种估计量:R/S 分析(经典重标极差, 对 回归取斜率)与 DFA-1(累积廓线分块、块内一次多项式去趋势、 对 回归)。尺度取 8 到 (R/S)/ (DFA)之间对数均匀的 10~14 个点。
- regime 实验:OU()与随机游走各 8 段交替、每段 250 bar 拼成混合世界;滚动窗口 120、每 3 bar 更新一次 (前向填充降计算量);均值回归信号为 20 日 z 分数的 , 时启用;次日结算(execute on , earn )无 look-ahead。
- 对抗式检验:在真实 的纯随机游走上跑 100 次同一套滚动 门控策略,比较真实策略 Sharpe 与随机世界的分布上限。
B. 已知偏差#
- fBm ≠ 真实价格:分数布朗运动是自相似高斯过程,真实收益有肥尾、波动聚集、regime 突变, 的定义在真实市场里本身就是近似。这篇能保证的是”估计量在理想数据上的行为”,不是”真实市场一定有稳定的 ”。
- R/S 未做 Anis-Lloyd 修正:我用的是教科书原始 R/S,所以能直接展示它的系统性上偏。生产环境应上修正版(Peters 1994 的期望 R/S),能把低 H 端的偏差压下去——但那会让本文”R/S 上偏”的教学点消失,故此处保留原始版本。
- OU 混合世界是理想化 regime:真实 regime 切换没有整齐的 250-bar 分段,也没有清晰的 。真实市场的 regime 判别只会比这更难,识别准确率 61.4% 是乐观上界。
- 策略未建模成本:z 分数反向下注每天调仓,换手极高,本文 Sharpe 是零成本口径。加上买卖价差和冲击后,滚动 门控省下的那点边际优势很可能被交易成本吃光。
C. 结果解读#
-
两种估计量都能定性分三类,但精度不对称:DFA 几乎无偏(真值 0.5→0.496)但短样本方差大( 标准差 0.18);R/S 方差小但系统性上偏( 把 0.5 估成 0.63, 仍偏 +0.046)。要判别均值回归(低 H),DFA 明显更可信;R/S 会把均值回归洗白成随机游走、把随机游走洗成弱趋势。
-
有限样本是命门:短窗口下 R/S 偏但稳、DFA 准但抖, 这个读数在 时根本分不清是真趋势、R/S 偏差还是 DFA 噪声。任何”当前 所以是趋势/回归”的实时判断,先问一句:这个小数点后第二位,扛得住估计噪声吗?
-
regime 可分但重叠严重:混合世界里均值回归段滚动 中位 0.32、随机段 0.46,两分布可分(识别准确率 61.4%)但尾部大幅重叠。 门控策略 Sharpe 3.63 略高于无条件 3.20——门控的价值主要是在随机段”少做错”,而非在回归段”多赚”。
-
对抗式检验揭穿最大陷阱:真实 的纯随机世界里,滚动 门控策略均值 Sharpe 锚在 0(无偏),但单次能刷到 1.12。这意味着 Sharpe 1 出头的 择时策略,和”随机世界里的运气上限”无法区分——用滚动 挑时点,你有很大概率在挑估计噪声。本文真实策略 3.63 显著超过随机上限,说明混合世界的均值回归是真的;但这个安全边际,在真实市场里通常没这么宽。
-
Hurst 指数的正确定位:它是一个诊断工具,不是交易信号。用它在长历史上判断”这个品种/这个市场整体上更像趋势还是回归”是合理的(长样本、静态估计、DFA 优先);用它做逐日 regime 切换则要极度警惕——你测的 波动,一大半是估计器自己的噪声,而不是市场记忆的真实变化。