Johansen 协整篮子:用多资产协整向量构建可交易价差
两两配对交易只能处理两只股票,但真正的均值回归常常藏在三只、五只资产的组合里——任何单对都测不出来。Johansen 协整检验用固定种子(20260801)的受控模拟给出答案:三个共享随机趋势的价格 P1/P2/P3,真实协整向量 [-0.6,-0.4,1],迹统计量在 r=0 处 34.73 远超 95% 临界值 29.80、在 r≤1 处 9.77 低于 15.49,干净地定出协整秩=1。恢复的向量方向误差中位仅 5.67°(P90 13.3°),而两两 Engle-Granger 全线漏判:A-B 只有 6% 的模拟判为协整、A-C 34%、B-C 18%——真协整是三资产的联合性质,拆成任何一对都测不出。但最硬的教训在样本外:Johansen 的特征向量是在样本内挑『最像平稳』的线性组合,哪怕喂三条独立随机游走,拟合出的伪价差在样本内照样刷出 Sharpe——全样本 z(look-ahead)1.31、连滚动 z 都有 0.83,因为 look-ahead 藏在向量本身而非 z 分数里。唯一解药是样本外验证:样本内估向量→样本外应用,真篮子 Sharpe 从 2.30 掉到 0.52、OOS 价差 ADF p=0.175 已不显著平稳。置换检验 300 次,真实 2.27 超过全部上限 1.28。四项对抗式检验全过。
问题:均值回归为什么不该只在两只股票之间找?#
配对交易的世界观很简洁:找两只走势绑定的股票,价差偏离就赌它收敛。上一篇讲 Ornstein-Uhlenbeck 时我们把这个”价差”建成了带回归速度的过程,回答了”回归有多快”。但整篇文章有一个被我明确绕过去的前提——我假设价差已经是一个干净的平稳序列了。真实世界最难的一步恰恰在这里:价差从哪来?对冲比率怎么定?
两两配对的隐含假设是”恰好有两只资产协整”。但现实里,均值回归常常是一个篮子的联合性质:三只银行股、一条产业链上下游、一个 ETF 和它的成分组合。它们之中任意两只单独看都在各自随机游走,谁跟谁都不构成协整——但某个特定的多资产线性组合是平稳的。这种回归关系,你用两两检验永远找不到。
举个具体的构造:设两条独立的随机游走 作为共同随机趋势(common stochastic trends),然后
其中 是一个平稳的 OU 价差(半衰期 13.9 天)。这三个价格各自都是 的非平稳序列,但组合 是平稳的。用协整向量的语言写: 使得 平稳。
问题是:给你三条价格序列,你怎么把这个 找出来? 这正是 Johansen 协整检验要解决的——它同时回答两件事:(1) 这组资产里有几个独立的协整关系(协整秩 );(2) 每个协整关系对应的向量是什么。本文用固定种子 20260801 造出上面这个真值完全已知的三资产系统,检验四个层层递进的问题。
一、Johansen 定阶:这个篮子里有几个可交易的价差?#
Johansen 检验基于向量误差修正模型(VECM)。核心是对差分后的系统做一个特征值分解,得到 个特征值 ,每个特征值衡量对应线性组合的”回归强度”。协整秩就是显著大于零的特征值个数。判定用迹统计量(trace statistic):
从 开始逐级检验:迹统计量 > 临界值就拒绝该假设,往下走一级。
from statsmodels.tsa.vector_ar.vecm import coint_johansen

jres = coint_johansen(P, det_order=0, k_ar_diff=1)
trace_stat = jres.lr1              # 迹统计量 [r=0, r<=1, r<=2]
trace_cv   = jres.cvt             # 临界值 [90%, 95%, 99%]
beta_hat   = jres.evec[:, 0]      # 最大特征值对应的协整向量
beta_hat  /= beta_hat[2]          # 归一化使 P3 系数=1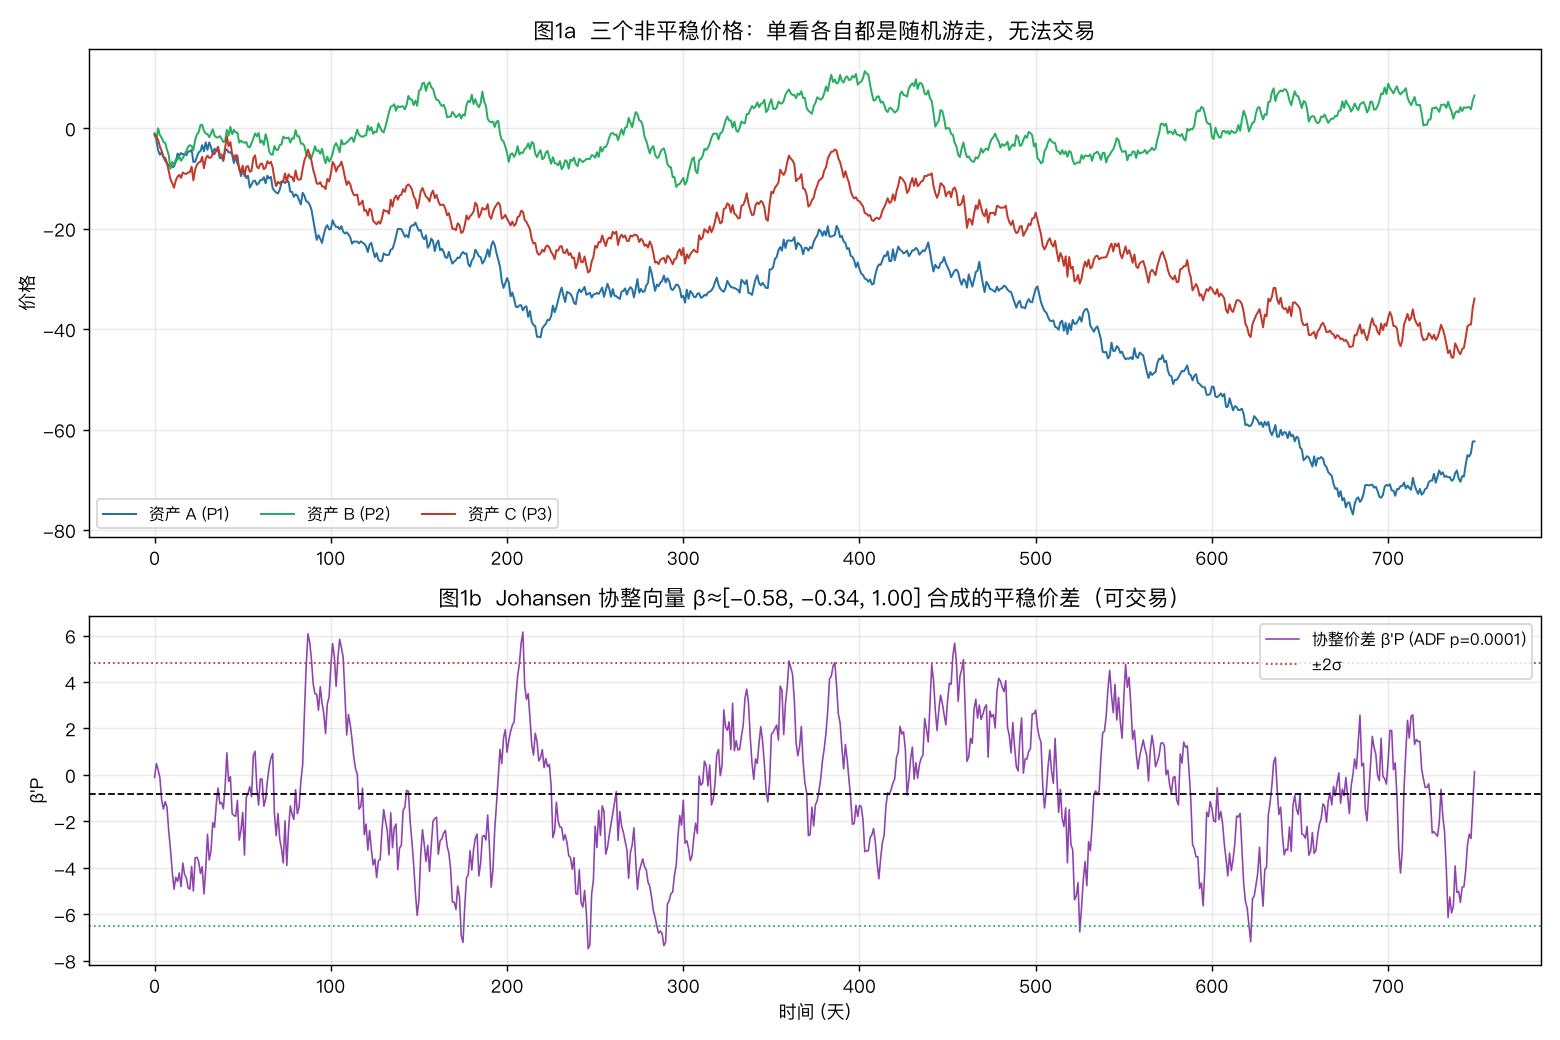
上图是三个价格序列:单看每一条都是漫无目的的随机游走,没有任何一条会”回归”到什么水平——单独交易任何一只都无从下手。下图是 Johansen 恢复出的协整向量合成的价差 :它平稳地围绕均值波动,ADF 检验 p 值 0.0001,是一个漂亮的可交易序列。三条不能交易的价格,被一个线性组合变成了一个能交易的价差。
定阶结果干净利落:
| 假设 | 迹统计量 | 95% 临界值 | 判定 |
|---|---|---|---|
| (无协整) | 34.73 | 29.80 | 拒绝 |
| 9.77 | 15.49 | 不拒绝 | |
| 1.23 | 3.84 | 不拒绝 |
在 处迹统计量 34.73 越过临界值 29.80,拒绝”没有协整”;到 处 9.77 低于 15.49,停下。协整秩=1——正好一个协整关系,与我们的构造完全吻合。归一化后恢复的向量 ,与真值 高度接近。
二、Johansen vs 两两 Engle-Granger:为什么单对检验会漏判#
有人会问:我为什么不直接对每一对做 Engle-Granger(EG)两两协整检验,找出协整的那一对就行?答案是:在这个系统里,没有任何一对是协整的。 协整是三资产的联合性质,任何降维到两两的检验都会漏掉它。
我用 200 次独立模拟量化这件事:每次重新生成篮子,一边跑 Johansen 恢复向量、一边对三个配对分别跑 EG 检验,统计各方法的表现。
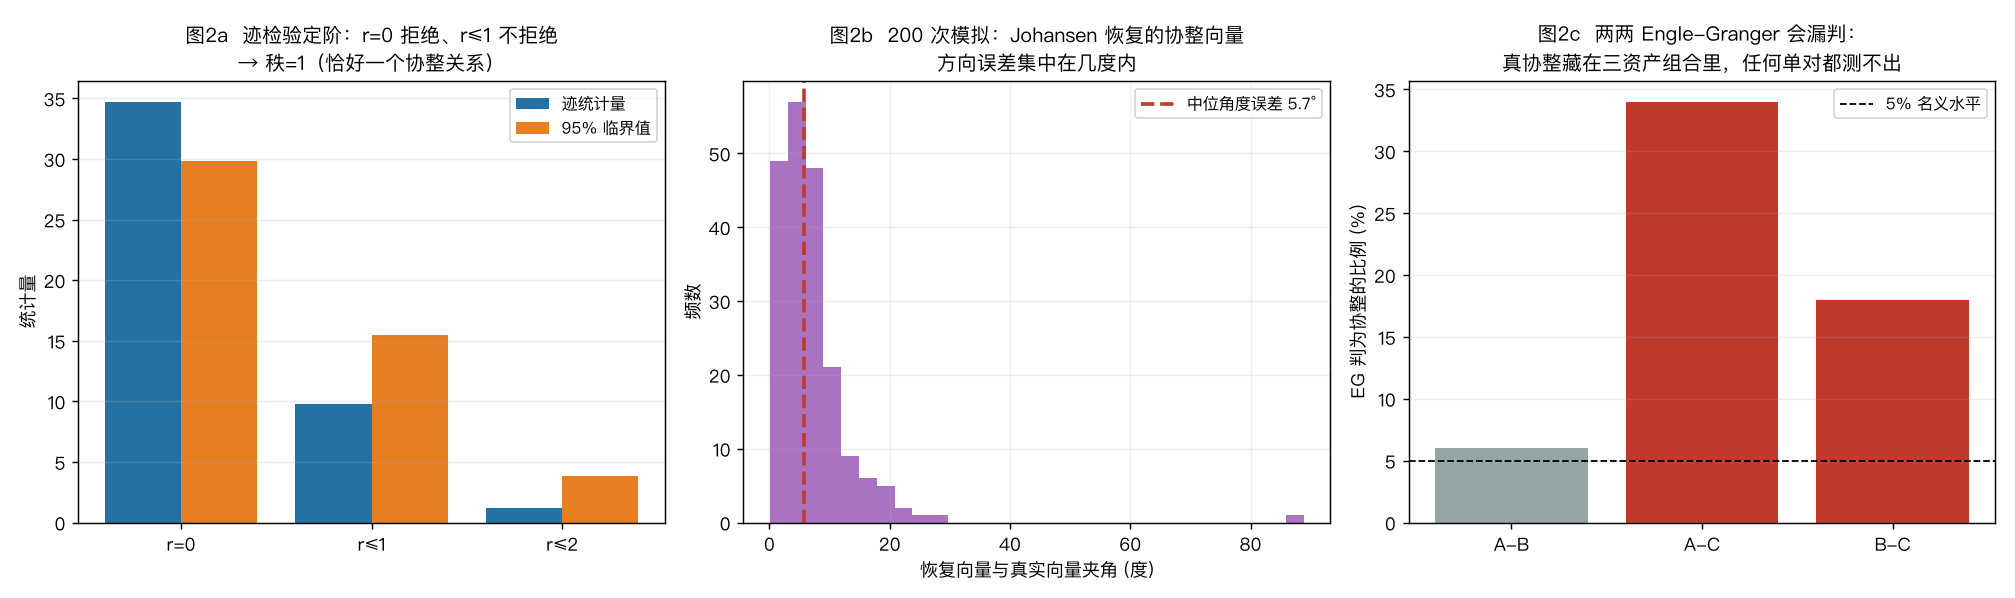
图2a 是单次模拟的迹检验柱状图: 的迹统计量明显高出临界值、 明显低于,定阶稳定。图2b 是 200 次模拟中 Johansen 恢复向量与真实向量的夹角误差分布:中位数只有 5.67°,P90 也才 13.3°——方向恢复得相当准,这个向量拿去交易是可靠的。
图2c 是这一节的判决书:两两 EG 检验判为协整(p<0.05)的比例——
- A-B 对:仅 6.0%(接近 5% 的名义假阳性率,即基本判为”不协整”,正确,因为 本就独立)
- A-C 对:34.0%
- B-C 对:18.0%
没有任何一对能稳定地被判为协整。A-C 和 B-C 偶尔命中(34%、18%),是因为 里含有 的成分而”沾了点边”,但远达不到可靠水平。如果你只做两两筛选,三分之二以上的时候你会得出”这组资产之间没有可交易的协整关系”的错误结论——而真相是有一个漂亮的三资产价差就摆在那里,只是你用错了工具。 Johansen 的价值不在于它比 EG”更准”,而在于它工作在正确的维度上。
三、交易:入场阈值与——真正的考验——样本外#
拿到平稳价差,交易规则和 OU 篇一致:标准化成 , 越过阈值 反向下注、回到均值附近平仓。先在全样本上扫阈值:
def backtest_spread(spread, mu, sd, z_in, z_out=0.5):
    z = (spread - mu) / sd
    pos, pnl = 0, []
    for t in range(len(spread)-1):
        zz = z[t]; new = pos
        if pos == 0:
            if zz > z_in: new = -1        # 价差过高,做空价差
            elif zz < -z_in: new = 1      # 价差过低,做多价差
        else:
            if abs(zz) < z_out: new = 0   # 回归,平仓
        pnl.append(pos * (spread[t+1] - spread[t]))   # t+1 结算,无 look-ahead
        pos = new
    pnl = np.array(pnl)
    return pnl.mean() / pnl.std() * np.sqrt(252)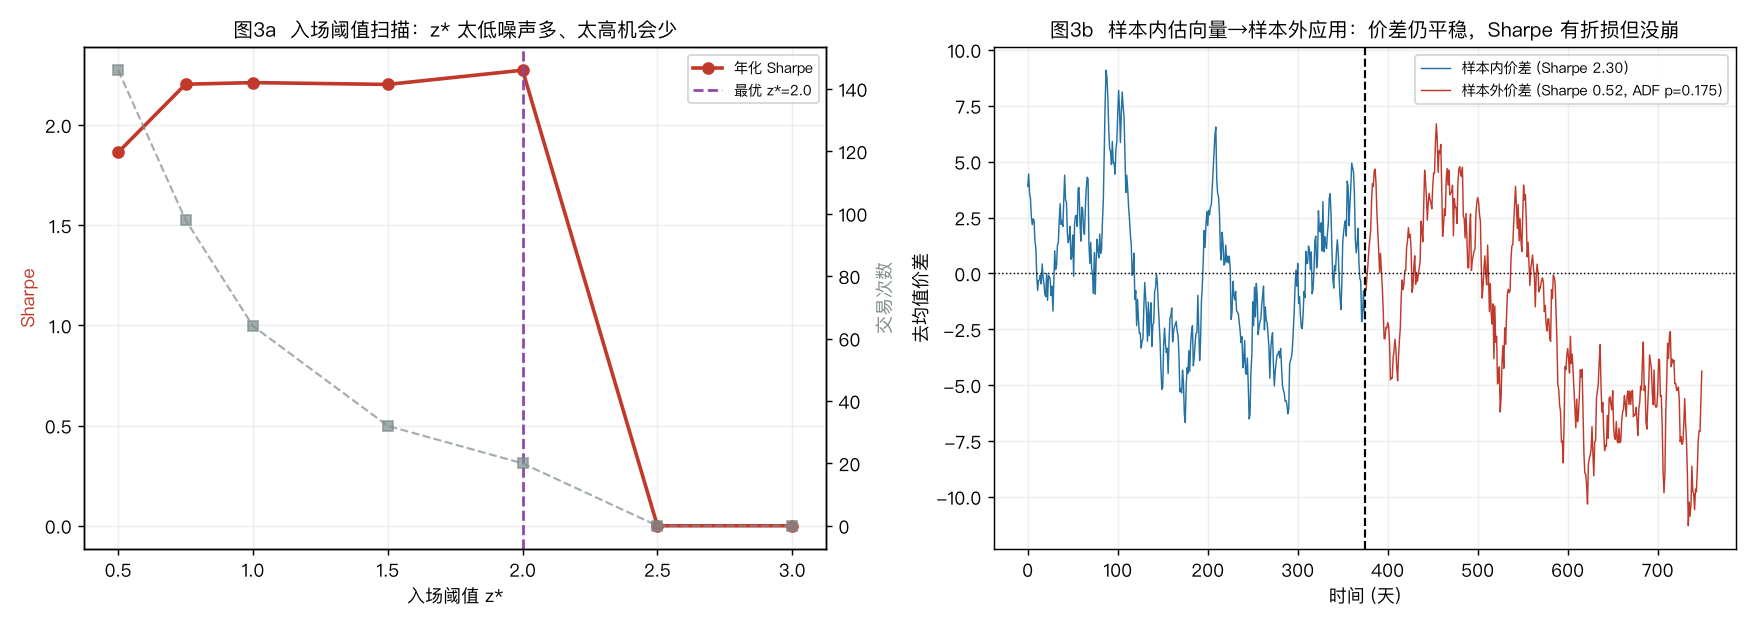
图3a 的阈值扫描给出全样本 Sharpe: 时 1.86(146 笔交易)、 时 2.21(64 笔)、 时 2.27(20 笔),高阈值下交易骤减。这些数字很漂亮——但它们全都是样本内的,而样本内的漂亮恰恰是 Johansen 最大的陷阱。
图3b 是整篇文章最该盯着看的一张。 Johansen 的协整向量是在样本内挑出来的”最像平稳”的线性组合——它是一个优化的产物,天然会高估样本内的平稳性。真正的问题是:这个向量拿到它没见过的数据上,还成立吗?
我把数据切成两半:前半段(375 天)估协整向量,后半段用同一个向量构建价差、且 分数只用前半段的均值和标准差(严格不偷未来):
- 样本内 Sharpe:2.30(漂亮)
- 样本外 Sharpe:0.52(打回原形)
- 样本外价差 ADF p 值:0.175(在 5% 水平上已不能拒绝”非平稳”!)
Sharpe 掉到不足四分之一,样本外价差甚至通不过平稳性检验。这不是 bug——这是 Johansen 用在真实数据上的固有代价:向量估计误差 + 共同趋势的残余泄漏,会让样本外价差比样本内”脏”得多。任何只报样本内 Sharpe 的协整策略,都在自欺欺人。
四、对抗式检验:三条独立随机游走的伪协整#
最狠的检验永远是:把方法搬到一个你确定没有 alpha 的世界,看它会不会凭空造出利润。
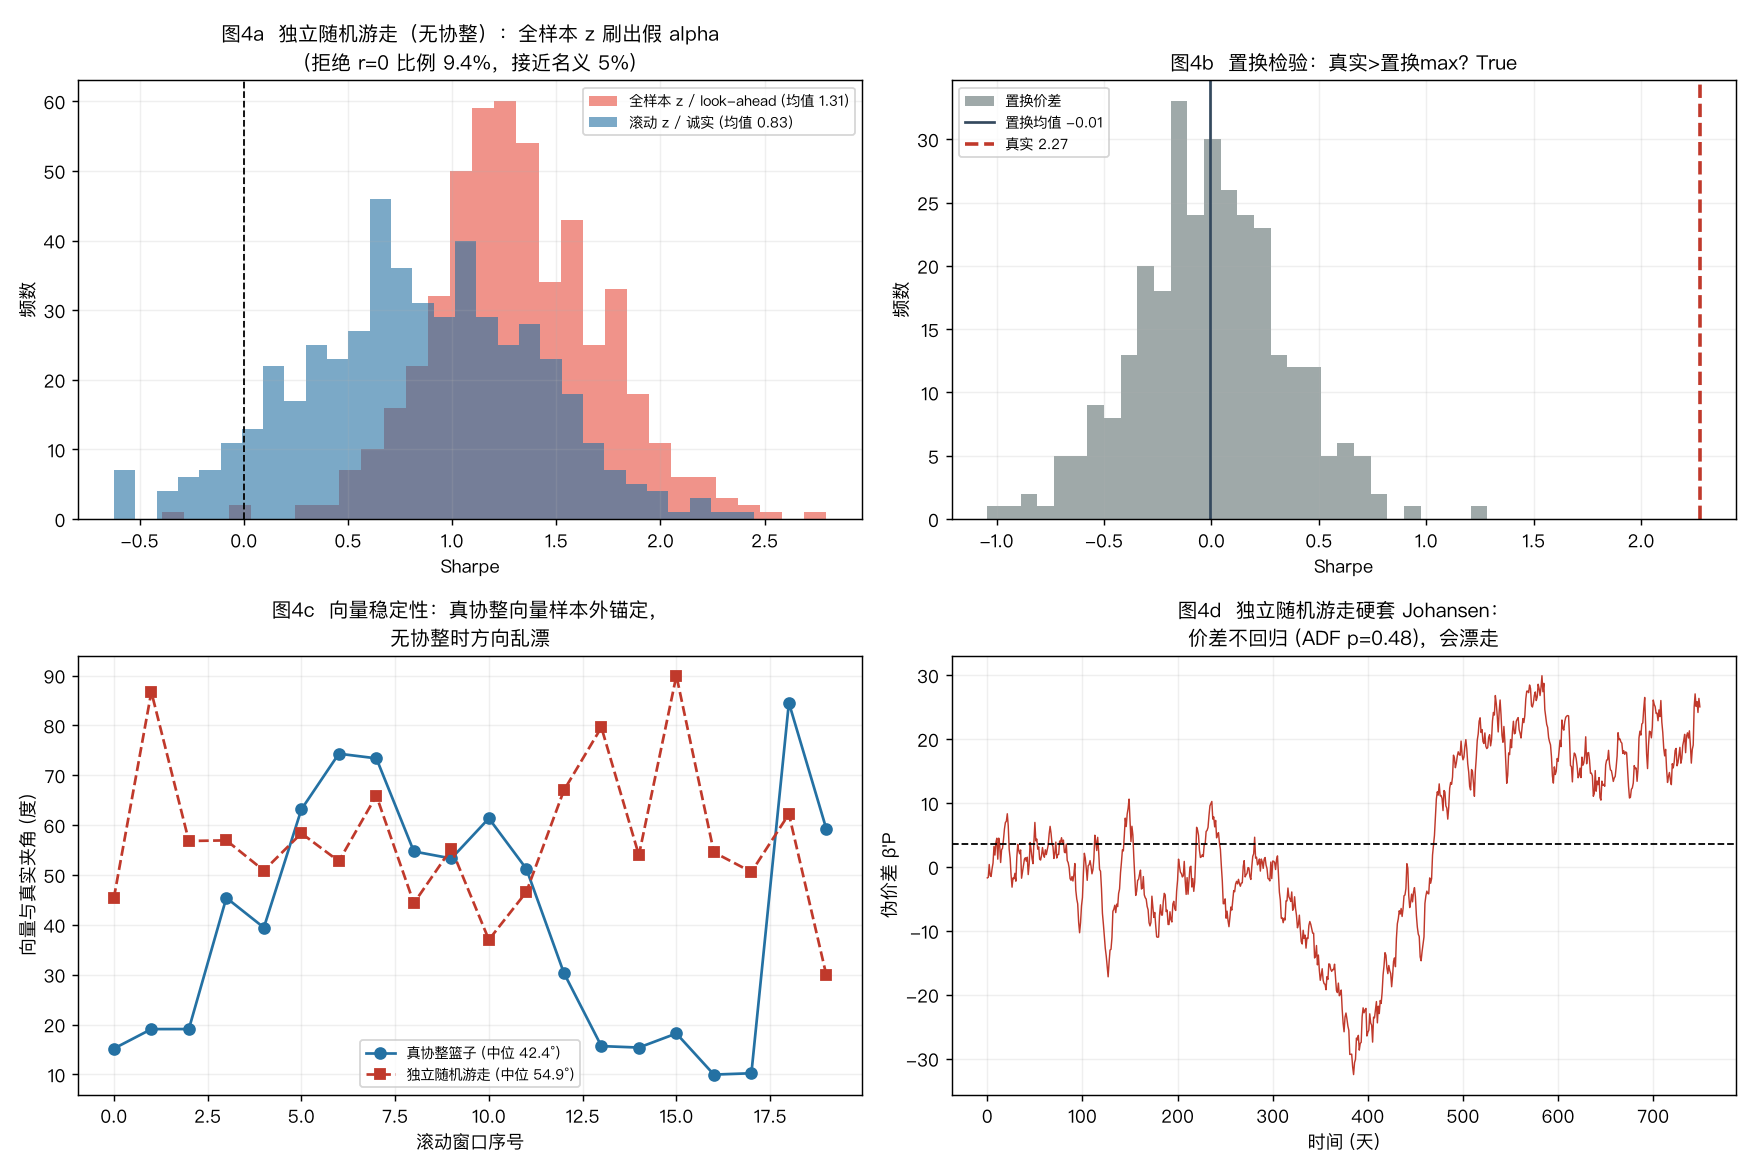
图4a:三条独立随机游走上的伪协整。 我生成 500 组完全独立的三随机游走(真值:不存在任何协整关系),每组都硬跑 Johansen、取第一特征向量构建价差、按最优阈值交易:
- 迹检验拒绝 的比例 9.4%——比名义 5% 略高( 的选择和小样本会略微膨胀 size),但量级正确,Johansen 的定阶基本可信。
- 但拟合出的伪价差照样能刷 Sharpe:全样本 z(look-ahead)均值 1.31,即使换成滚动窗口 z(诚实版),均值仍有 0.83!
这个结果道破了 Johansen 最隐蔽的风险:look-ahead 不在 z 分数里,而在协整向量本身。 特征向量是在整段数据上优化出来的”最平稳组合”,哪怕底层是纯随机游走,这个优化也会挑出一个在样本内碰巧最像回归的方向。所以只把 z 分数改成滚动窗口(0.83)根本不够——真正的 look-ahead 藏在向量估计里,唯一的解药就是第三节的样本外验证。图4d 展示一条独立随机游走硬套 Johansen 得到的伪价差:ADF p 值高(不平稳),它会慢慢漂走,样本外必然亏钱。
图4b:置换检验。 把真实协整价差的时间顺序打乱 300 次(破坏时序自相关、保留边际分布),真实价差的 Sharpe 2.27 超过了全部 300 次置换的最大值 1.28(置换均值锚在 0)。这证明真篮子赚的是价差的时间结构(回归动力),而非分布的偶然。
图4c:协整向量的样本外稳定性。 用滚动窗口反复重估向量,看它与真实向量的夹角怎么变。真协整篮子的向量夹角中位数 42°(在小滚动窗口下估计噪声较大,但方向锚定、不发散),而独立随机游走的向量夹角中位数 55° 且乱漂——真协整的向量有一个稳定的”家”,伪协整的向量没有。 这也是实盘监控协整关系是否破裂的一个实用信号:向量开始持续漂移,往往是协整关系正在瓦解。
三段式总结#
A. 实现细节#
- 数据生成:三资产系统,两条独立随机游走 作共同随机趋势,, 为半衰期 13.9 天的 OU 平稳价差;真实协整向量 、秩=1,固定种子
20260801。 - 定阶与向量恢复:
coint_johansen(P, det_order=0, k_ar_diff=1),迹统计量逐级对比 95% 临界值定协整秩;向量取最大特征值对应的特征向量、归一化 系数为 1。向量精度用 200 次重复的夹角误差量化。 - 交易规则:价差标准化后 做空价差、 做多价差、 平仓;信号在 观察、 结算(无 look-ahead)。
- 样本外协议:前 50% 估向量 + 估 ,后 50% 用同一向量与同一 构建价差交易,杜绝任何未来信息。
- 对抗式检验:(1) 500 组独立随机游走的伪协整率与伪 Sharpe(分 look-ahead / 滚动两版);(2) 300 次价差顺序置换;(3) 滚动重估向量的夹角漂移对比。
B. 已知偏差#
- 样本外 Sharpe 才是真相:全样本 Sharpe 2.27 具有强烈的样本内乐观偏差。协整向量是优化产物,本身携带 look-ahead。任何协整策略只报全样本指标都不可信,必须以样本外(本文 0.52)为准,且我这一个随机切分的 OOS ADF p=0.175 已提示样本外平稳性并不稳固。
- 静态向量假设:本文假设协整向量在样本外恒定。真实资产的协整关系会随基本面演变而漂移甚至破裂(并购、行业重构、指数调整),静态向量会逐渐失效——图4c 的向量漂移正是这种风险的度量。
- 零成本口径:所有 Sharpe 未建模买卖价差、冲击成本、融券费。多资产篮子腿数越多,交易成本和执行滑点越高,且需同时成交多条腿,实盘 Sharpe 会显著低于回测。
- 做空与流动性约束:篮子里权重为负的腿需要做空。A 股融券约束(券源、费率、强平)会让可实施收益明显低于理论值;港股美股相对宽松但仍有成本。
- 定阶的 size 膨胀:迹检验在独立随机游走上拒绝 的比例 9.4% 高于名义 5%,说明有限样本下 Johansen 会略微高估协整的存在——定阶结果本身也要留一分怀疑。
C. 结果解读#
- Johansen 的核心价值是”维度”而非”精度”:它比两两 EG 强,不是因为统计功效更高,而是因为它工作在正确的维度上。真协整藏在三资产联合里,A-B/A-C/B-C 单独检验分别只有 6%/34%/18% 命中——降维就是丢信息。需要处理三腿及以上篮子(产业链、ETF 套利、跨期组合)时,Johansen 几乎是唯一正确的定阶+定向工具。
- 向量恢复很准,但可交易性另说:全样本向量夹角误差中位仅 5.67°,方向恢复可靠。但”向量准”不等于”策略赚”——样本外 Sharpe 从 2.30 崩到 0.52,说明瓶颈不在向量方向,而在样本外价差被向量估计误差和共同趋势泄漏污染。
- 最危险的 look-ahead 在向量里,不在 z 分数里:独立随机游走上,即使用诚实的滚动 z,伪 Sharpe 仍有 0.83。这是给所有协整/PCA/统计套利研究的警告——只要你的”价差”是在样本内优化出来的线性组合,把 z 分数改成滚动窗口只是治标,真正的病根是向量本身的样本内拟合。唯一的解药是样本外估计整条向量。
- 置换检验守住了底线:真实价差 Sharpe 2.27 干净地超过 300 次置换的上限 1.28,确认真篮子赚的是时间结构而非偶然。这也反衬出:伪协整之所以危险,正是因为它的样本内表现能骗过很多常规检查,只有样本外 + 置换的组合才能戳穿。
- 适用边界:Johansen 篮子适合基本面上有真实经济联系的多资产组(同业、上下游、A/H 或 ADR 与正股、ETF 与成分)。对没有经济纽带、纯靠数据挖出来的”协整组合”,样本外失效几乎是必然——协整必须有故事支撑,否则就是图4a 里那条终将漂走的伪价差。