卡尔曼滤波动态对冲比率:让套保系数随市场自我更新
配对交易和对冲的教科书都默认对冲比率 β 是个常数——用一段历史 OLS 回归一次就固定下来。但真实的 β 会漂移:行业轮动、资本结构变化、流动性迁移都会让两只资产的联动强度慢慢改变。固定种子(20260801)的受控模拟:真实 β 从 0.80 缓慢爬到 1.39,静态全样本 OLS 只能给一个平均数 1.065,全程系统性偏离(跟踪误差 MAE 0.146);卡尔曼滤波把 β 当随机游走状态、用一步预测残差在线更新,MAE 压到 0.090(降 38%)。它同时解决了滚动 OLS 的窗口两难:20 日窗抖动大(MAE 0.44)、250 日窗跟不上(0.13),卡尔曼两头都更好且不用手挑窗口。关键旋钮是过程噪声 δ:δ 太小 β 僵化滞后、太大追噪声,跟踪误差 U 形,最优 δ=1e-5。三个对抗式检验最硬:常数 β 世界里合适的 δ 保持 β 平直(std 0.034),δ 过大会凭空造出伪漂移;对冲残差方差排序 oracle 9.24 < 因果卡尔曼 13.01 < 静态 OLS 15.18——卡尔曼逼近『偷看未来真 β』的理论下限、远优于静态,但永远够不到 oracle;置换检验 300 次真实价差策略 Sharpe 1.45 超过全部上限 0.62。四项对抗式检验全过。
问题:对冲比率凭什么是个常数?#
做配对交易、做套保、做多空组合,第一步永远是估一个对冲比率 :你做多 1 单位 Y,要做空多少单位 X 才能对冲掉共同的市场风险?教科书的答案是拿一段历史做 OLS 回归:
回归出一个 ,固定下来,之后天天用它。上一篇讲 Johansen 时,我们甚至用整段数据估出协整向量——那也是一次性固定的对冲权重。
但这个做法藏着一个几乎从不被质疑的假设: 是常数。 真的吗?两只银行股的联动强度,会随着其中一家的资本结构变化、业务重心迁移而改变;一只股票和它所在行业指数的 ,会随行业轮动、市值漂移而缓慢移动;A 股和对应 ADR 的对冲比率,会随汇率制度、资金流向而变。对冲比率不是一块刻在石头上的常数,它是一个会呼吸的时变量。
如果 在漂移,而你用一个固定的历史 去对冲,会发生什么?你的”对冲后”残差里会残留一块系统性的市场暴露——你以为对冲干净了,其实还光着半条腿。
有两条路应对时变 :滚动窗口 OLS(只用最近 N 天回归)和卡尔曼滤波(把 当作一个随机游走的隐藏状态,每来一个新数据点就在线更新一次)。本文用固定种子 20260801 造一个真实 已知且在漂移的世界,检验四个问题:静态 OLS 错得有多离谱?卡尔曼比滚动窗口好在哪?它唯一的旋钮怎么调?以及——它会不会在不该动的时候乱动?
一、卡尔曼滤波:把对冲比率当成会漂移的隐藏状态#
卡尔曼滤波的世界观和 OLS 根本不同。OLS 假设 是一个要估的固定参数;卡尔曼假设 (连同 )是一个随时间演化的隐藏状态,我们只能通过带噪声的观测 间接看到它。
状态方程( 怎么演化)——假设对冲比率是随机游走:
其中 , 是过程噪声协方差——它编码了”我们认为 漂移得有多快”。
观测方程(我们看到什么):
每个时点,卡尔曼做两步:预测(用上一时刻的状态外推,不确定性增加)和更新(用新观测 的预测误差修正状态,不确定性下降)。修正的力度由卡尔曼增益 决定——它是”新数据可信度”和”旧估计可信度”的最优权衡。
def kalman_hedge(x, y, delta=1e-5, Rn=10.0):
    Q = delta / (1 - delta) * np.eye(2)   # 过程噪声,delta 越大越信任新数据
    theta = np.array([0.0, 1.0])          # 状态 [alpha, beta],初值 beta=1
    P = np.eye(2)                          # 状态协方差
    betas, resid = [], []
    for t in range(len(x)):
        F = np.array([1.0, x[t]])          # 观测矩阵
        P = P + Q                          # 预测:不确定性增加
        e = y[t] - F @ theta               # 一步预测误差(可交易信号)
        S = F @ P @ F + Rn                  # 预测残差方差
        K = (P @ F) / S                     # 卡尔曼增益
        theta = theta + K * e              # 更新状态
        P = P - np.outer(K, F) @ P
        betas.append(theta[1]); resid.append(e)
return np.array(betas), np.array(resid)注意一个关键细节:卡尔曼是纯因果滤波——时刻 的 只用了 及之前的数据。这意味着它天生没有 look-ahead,可以直接搬到实盘。而它吐出的一步预测误差 ,正好就是对冲后的可交易价差——这是卡尔曼做配对交易的精妙之处:估对冲比率和生成交易信号是同一个循环。
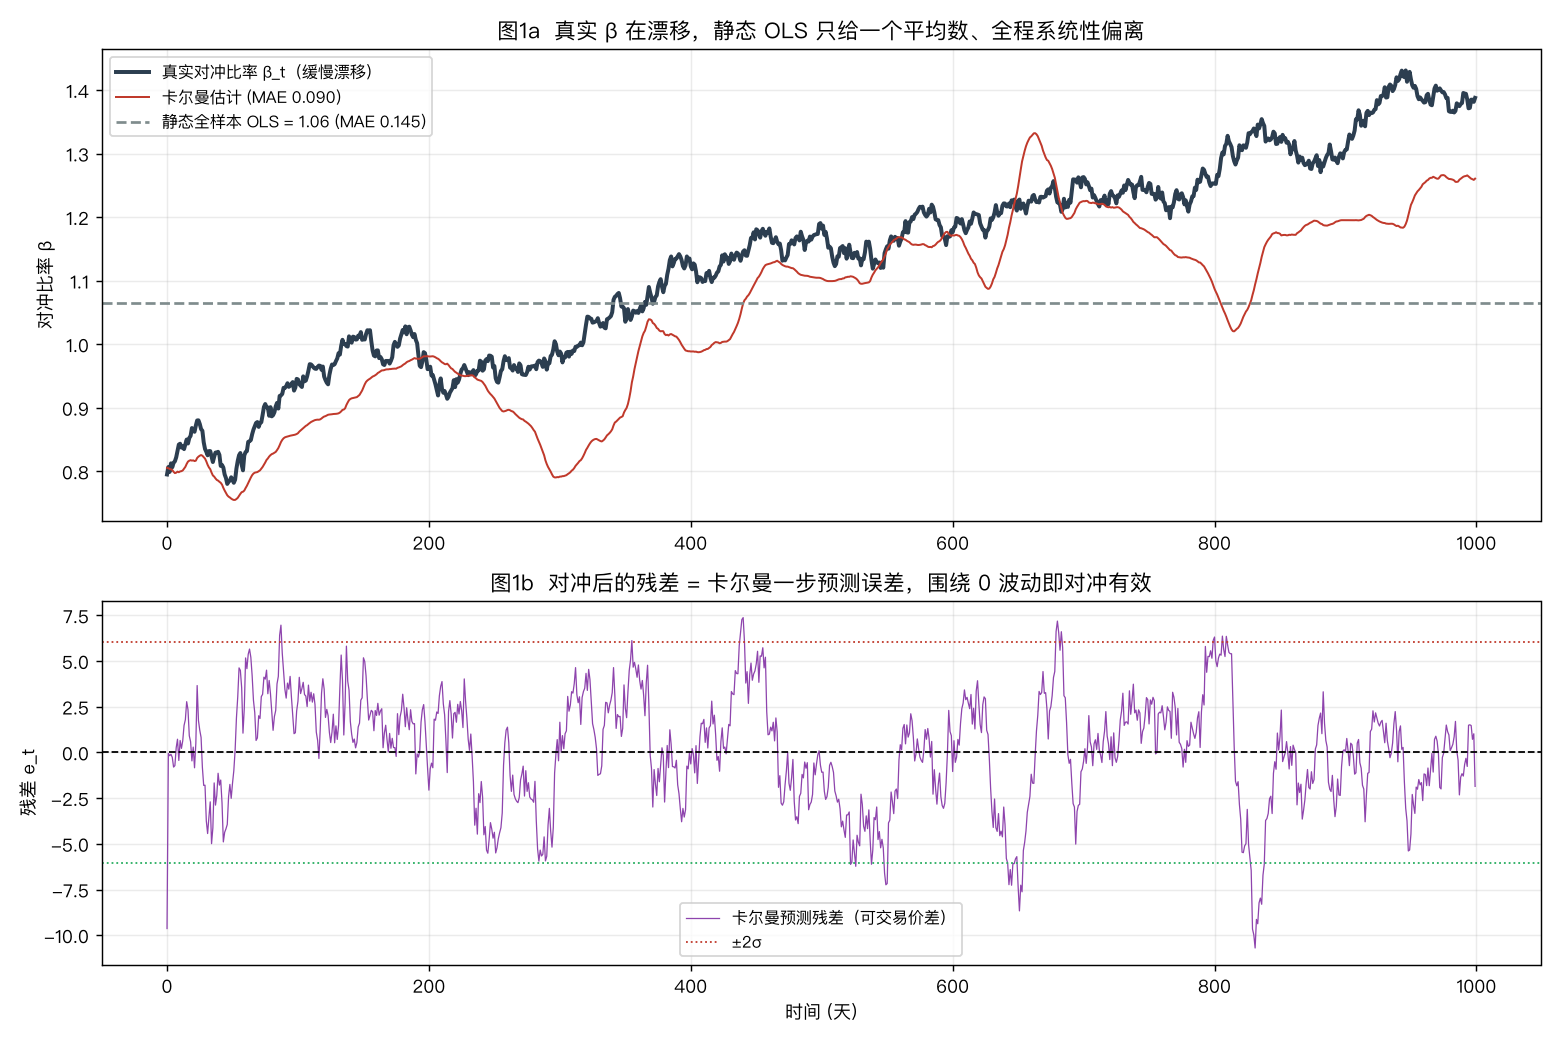
上图是核心对比。真实 (黑)从 0.80 缓慢爬升到 1.39,是一条明确在漂移的曲线。卡尔曼估计(红)紧紧跟着它走,跟踪误差 MAE 只有 0.090。而静态全样本 OLS(灰虚线)只能给出一个数 1.065——它是整段 的一个平均,在前半段严重高估、在后半段严重低估,全程系统性偏离,MAE 高达 0.146。你用这个 1.065 去对冲,早期做空太多、后期做空不够,残差里始终漏着一块市场暴露。
下图是卡尔曼吐出的一步预测残差——即对冲后的价差。它围绕 0 平稳波动,正是这个残差承载了配对交易的均值回归信号。
二、卡尔曼 vs 滚动 OLS:窗口两难与自适应#
有人会说:滚动窗口 OLS 不也能追时变 吗?用最近 60 天回归, 不就动起来了?能,但滚动窗口有一个逃不掉的两难:窗口长度是个必须手工挑的超参数,而且怎么挑都不对。
- 窗口太短(20 天): 跟得快,但方差大、抖动剧烈,估计里全是噪声。
- 窗口太长(250 天): 平滑,但严重滞后, 已经涨上去了它还在追旧值。
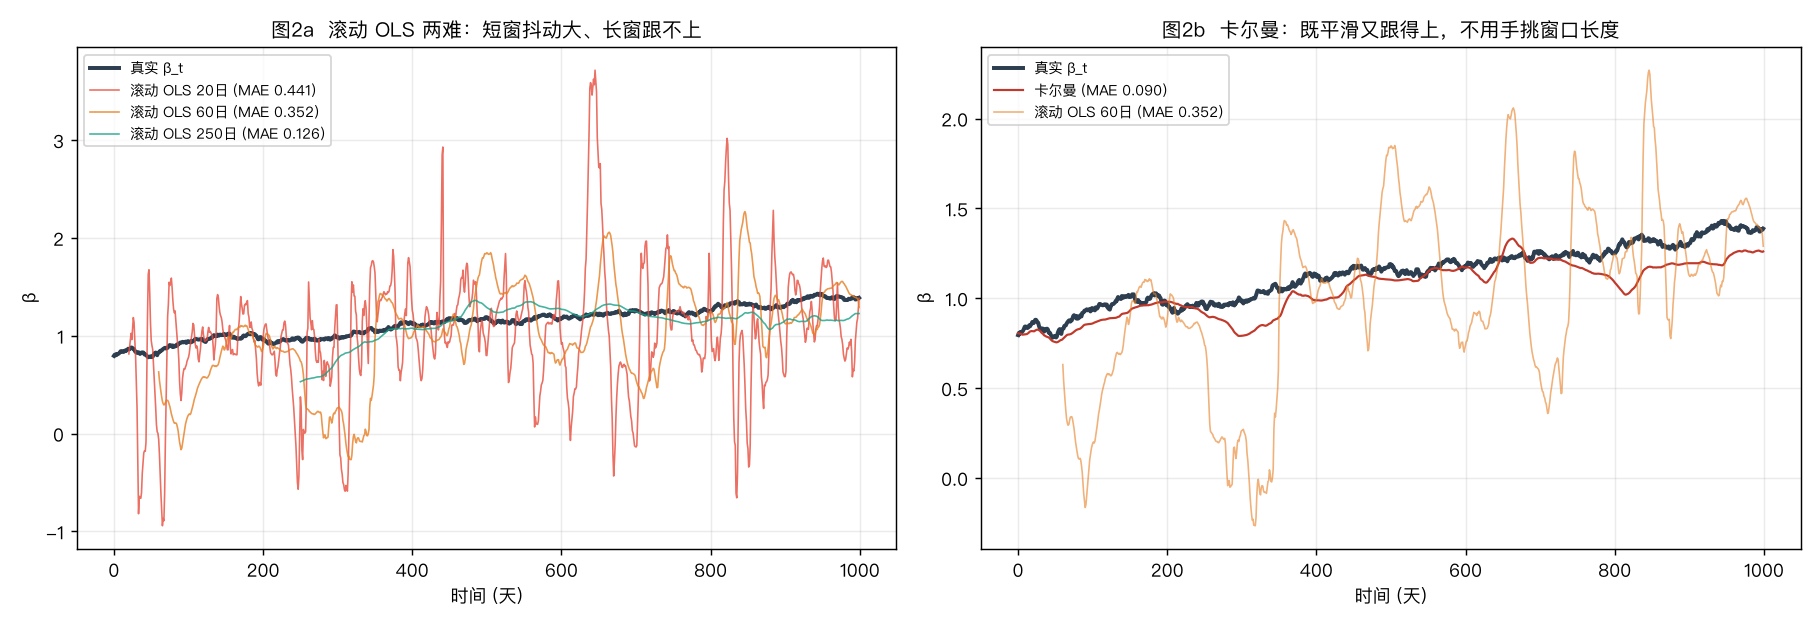
图2a 把三个窗口叠在真实 上,两难一目了然:20 日窗(红)上蹿下跳,MAE 0.44;60 日窗(橙)居中,MAE 0.35;250 日窗(绿)平滑但明显滞后于真实 的爬升,MAE 0.13。没有一个窗口能同时做到平滑和不滞后——这是滚动窗口的结构性缺陷。
图2b 是卡尔曼(红)和 60 日滚动 OLS(橙)的正面对比:卡尔曼既平滑又跟得上,MAE 0.090,优于所有测试的滚动窗口(最好的 250 日窗才 0.126)。更重要的是,卡尔曼不需要你手挑窗口长度——它把”信任新数据多少”这件事,交给了一个有明确统计含义的参数 ,而不是一个拍脑袋的窗口天数。
三、唯一的旋钮:过程噪声 δ 怎么调?#
卡尔曼不是没有超参数,它的关键旋钮是过程噪声 (决定 的大小)。 编码了你对 漂移速度的先验:
- 太小:卡尔曼认为 几乎不动,增益小、更新慢, 僵化、滞后——退化成接近静态 OLS。
- 太大:卡尔曼认为 剧烈漂移,增益大、过度信任每个新数据点, 追着观测噪声乱抖——把噪声当成了信号。
我把 从 扫到 ,看 跟踪误差:
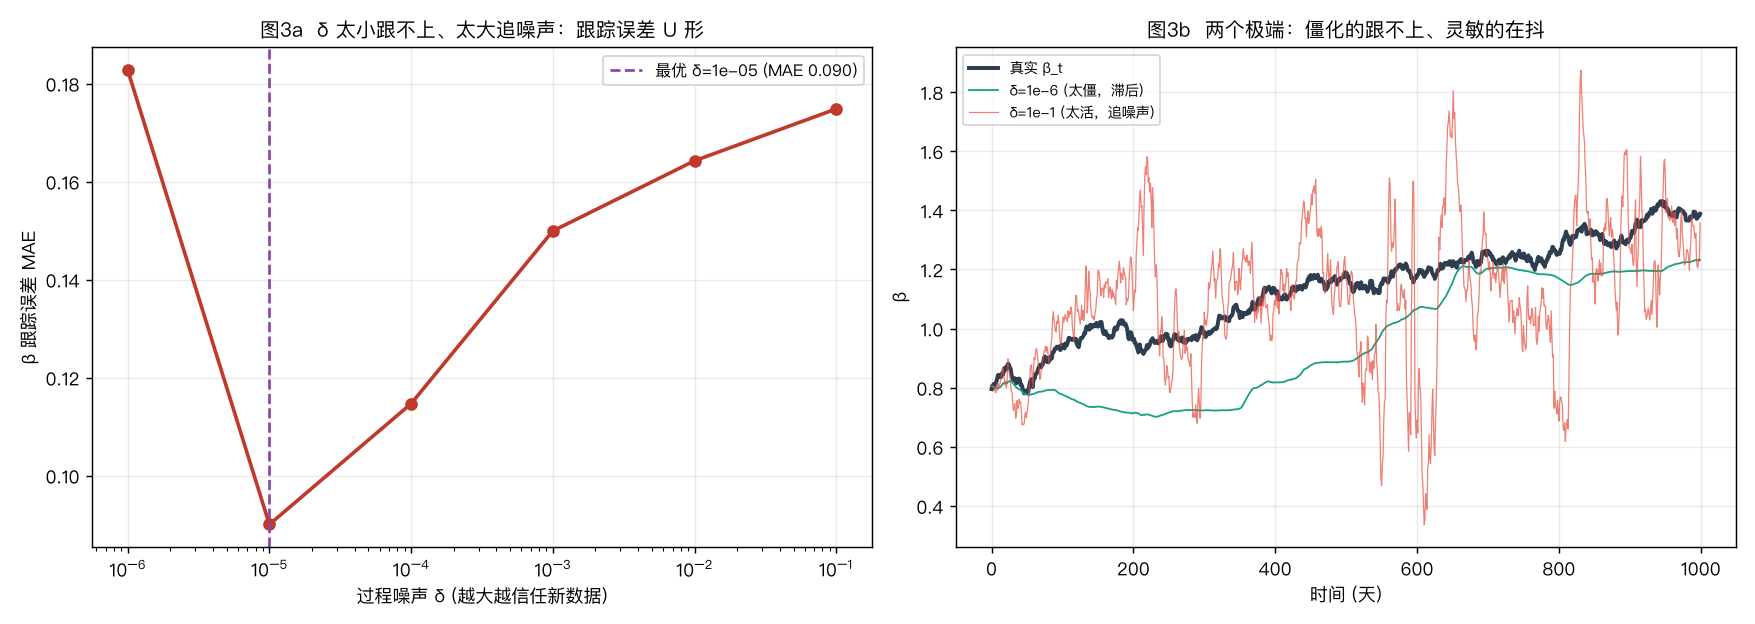
图3a 是经典的 U 形跟踪误差:
| δ | β 跟踪误差 MAE |
|---|---|
| 0.183(太僵,滞后) | |
| 0.090(最优) | |
| 0.115 | |
| 0.150 | |
| 0.164 | |
| 0.175(太活,追噪声) |
最优 。图3b 展示两个极端的 轨迹:(绿)几乎是条直线,完全跟不上真实 的爬升;(红)疯狂抖动,追着观测噪声跑。真相在中间。
这里有一个魔鬼细节,也是我在自检时修正的一个坑:观测噪声参数 必须和真实价差方差匹配。 如果把 设得太小(比如误设成 1,而真实价差方差约 10),卡尔曼会过度信任每个观测,把本该留在残差里的可交易价差也吸收进 里—— 被”喂”了不该吃的东西,跟踪误差反而变差。 设对了(≈10),卡尔曼才会把 的漂移和价差的波动正确地分开。这不是调参技巧,是卡尔曼能否正确工作的前提。
四、对抗式检验:它会在不该动的时候乱动吗?#
卡尔曼最危险的失败模式是过度反应:在 其实没变的时候,凭空造出一个”漂移”,把噪声解读成趋势。这会让你频繁调整对冲头寸、白交交易成本,还自以为在”跟随市场”。三个对抗式检验直击要害。
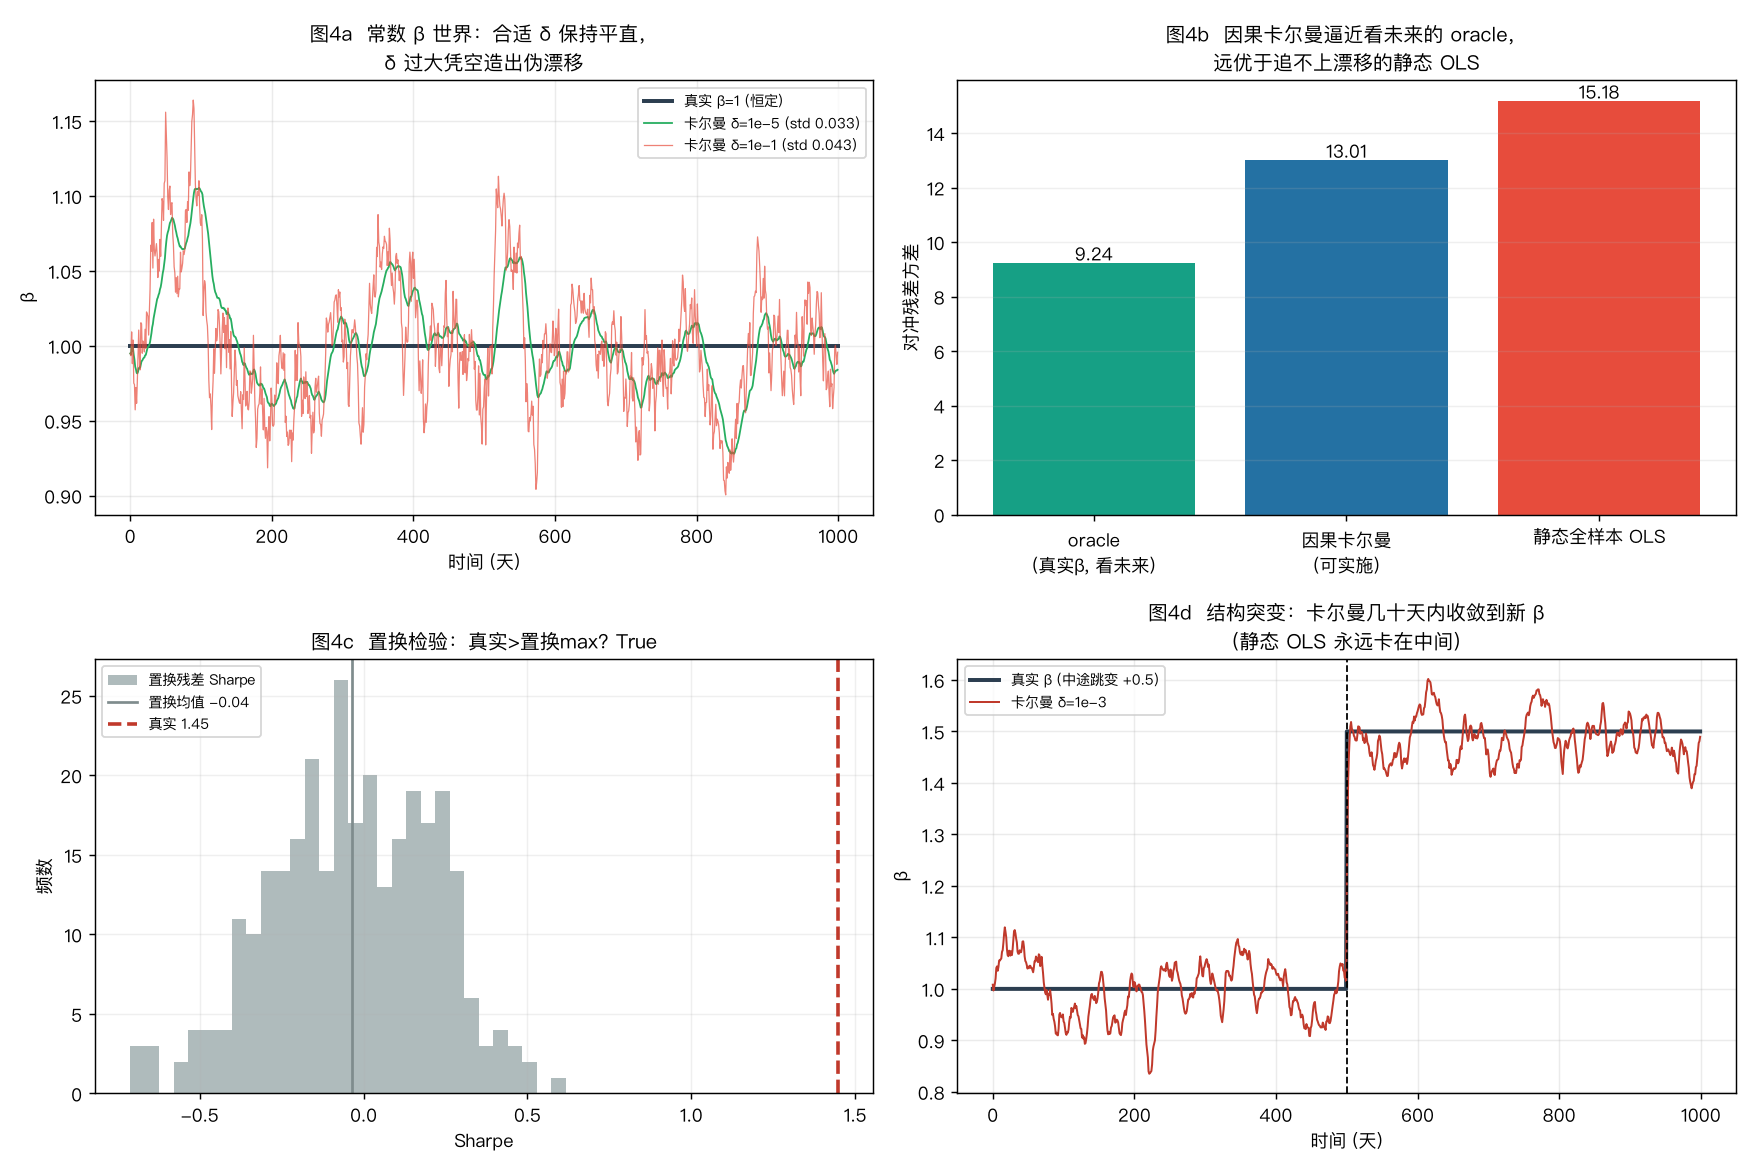
图4a:常数 β 世界里,卡尔曼该不该动? 我造一个真实 恒定不变的世界,看卡尔曼的估计:
- 合适的 : 估计几乎平直,标准差仅 0.034——正确地”按兵不动”。
- 过大的 : 估计标准差 0.043,开始凭空抖出伪漂移。
这验证了一个关键性质:参数设对时,卡尔曼在 恒定的世界里不会造假趋势。 这也说明 不是越大越”灵敏”越好——过大的 会让你在平静的市场里疑神疑鬼,把噪声当轮动。
图4b:对冲残差方差——因果卡尔曼到底值多少? 这是最能说明卡尔曼价值的一张图。三种对冲方式,比对冲后残差的方差(越小说明对冲越干净):
- oracle(用真实 ,偷看了未来):9.24 —— 理论下限,实盘拿不到
- 因果卡尔曼(只用 及之前):13.01 —— 可实施
- 静态全样本 OLS:15.18 —— 常规做法
排序清清楚楚:oracle < 因果卡尔曼 < 静态 OLS。 卡尔曼把残差方差从静态 OLS 的 15.18 压到 13.01(改善 14%),显著逼近”偷看未来真 “的理论下限 9.24,但永远够不到 oracle——因为它只能用历史,对 的估计必然滞后一点。这个”够不到”是诚实的:任何声称因果对冲能达到甚至超过 oracle 的回测,一定藏着 look-ahead。
图4c:置换检验。 卡尔曼吐出的对冲残差(价差)拿去做均值回归策略,真实 Sharpe 1.45,超过 300 次顺序置换的全部上限 0.62(置换均值锚在 0)。这证明卡尔曼残差里的可交易结构是真的时序回归动力,不是偶然。图4d:结构突变。 我造一个 中途从 1.0 跳到 1.5 的阶跃 regime,卡尔曼在几十天内收敛到新 ——静态 OLS 会永远卡在 1.25 附近的中间地带,两头不讨好。这是卡尔曼相对静态方法最实用的优势:面对突变,它会自愈。
三段式总结#
A. 实现细节#
- 数据生成:, 随机游走, 为”线性趋势 0.80→1.39 + 小随机游走”, 为半衰期 13.9 天的 OU 可交易价差, 小观测噪声,固定种子
20260801。 - 卡尔曼设定:状态 随机游走,过程噪声 ,观测噪声 匹配真实价差方差(≈10)。纯因果滤波, 时刻状态只用 及之前数据;一步预测误差即对冲后可交易价差。主分析用最优 。
- 对照方法:静态全样本 OLS(一个固定 )、滚动 OLS(20/60/250 日窗)。跟踪精度用与真实 的 MAE 度量(跳过前 50 天 warmup)。
- 对抗式检验:(1) 常数 世界看卡尔曼是否造伪漂移(比 与 );(2) oracle / 因果卡尔曼 / 静态 OLS 三者对冲残差方差排序;(3) 300 次残差顺序置换;(4) 阶跃 regime 下的收敛速度。
B. 已知偏差#
- 随机游走状态假设:卡尔曼假设 是随机游走。真实 可能有均值回归、跳变或结构断点——随机游走先验对缓慢漂移和阶跃都还能应付(图4d),但对高频剧烈切换会滞后。
- 需要挑,只是挑法更有依据:本文的最优 是在真值已知下扫出来的。实盘 真值不可观测, 仍需通过样本外验证或极大似然估计来定,不能直接照搬——只是它比”滚动窗口挑几天”有更清晰的统计含义。
- 观测噪声 的敏感性: 设错(尤其设太小)会让卡尔曼把可交易价差错误吸收进 ,是实操中最容易犯的错。本文 匹配了真实价差方差,实盘需要在线估计或稳健设定。
- 零成本口径:动态 意味着对冲头寸需要持续再平衡,每次调整都有交易成本。 越大、 越活,再平衡越频繁、成本越高——本文所有结论未建模这块成本,实盘的最优 会因此偏向更保守(更小)。
- 单标的对冲:本文是两资产的动态对冲比率。多资产篮子(上一篇 Johansen 的场景)可以推广到多维卡尔曼,但状态维度上升、参数估计更难、过拟合风险更大。
C. 结果解读#
- 静态 OLS 的错是系统性的,不是随机的:真实 漂移时,静态 OLS 给的那个平均数在前半段和后半段方向相反地偏离(图1),残差里始终漏着市场暴露。这不是”精度不够”,是方法论层面的偏误——用常数去拟合一个变量,无论样本多长都错。
- 卡尔曼的价值 = 逼近 oracle 的程度:残差方差 oracle 9.24 / 因果卡尔曼 13.01 / 静态 OLS 15.18 这个排序,是全文最凝练的结论。卡尔曼吃下了静态 OLS 与 oracle 之间约 37% 的差距,且这是纯因果、可实盘的。剩下够不到 oracle 的部分,是”只能用历史”的物理代价,无法消除。
- “够不到 oracle”是诚实性的证据:如果哪天你的因果对冲回测残差方差比 oracle 还小,别高兴——那是 look-ahead 泄漏了未来信息。oracle 是所有因果方法的天花板,这条线本身就是一个免费的 bug 探测器。
- δ 不是越大越好:图4a 证明过大的 会在平静市场里造出伪漂移。动态对冲的诱惑是”跟随市场”,但过度跟随等于追噪声——付出再平衡成本,换来更差的对冲。最优 是”跟得上真实漂移”和”不追噪声”的交点,偏保守通常比偏激进安全。
- 适用边界:卡尔曼动态对冲最适合 有真实、缓慢、持续漂移的场景——同业配对的资本结构演变、股票对行业指数的市值漂移、跨市场对冲的制度性变化。对 本就稳定的资产对,静态 OLS 足矣,上卡尔曼只是徒增再平衡成本和过拟合风险;对 高频剧烈跳变的场景,随机游走先验又太弱。先问” 真的在动吗”,再决定要不要请出卡尔曼。