跳跃扩散神经网络定价:用深度学习逼近含跳资产的价格
Black-Scholes 假设价格连续,可股灾里价格是『跳』下去的。Merton 跳扩散有闭式解,但真实市场要联合校准 σ 与跳参数,解析解很快失效。本文用 numpy 从零实现一个两层 MLP,喂 (σ, λ, μ_J, δ, moneyness, T) 六个特征,去逼近 Merton 欧式看涨价格——在 10584 个参数组合上训练,测试集 R²=0.94、RMSE=2.08,并证明网络『学会』了跳跃溢价:期权价随跳跃强度 λ 单调上升。附完整 Python(含手写前向/反向)与四张真实计算图。
Black-Scholes 的根本假设是价格连续游走。可真实市场里,财报暴雷、央行突袭、闪崩——价格是「跳」下去的,不是滑下去的。Merton(1976) 跳扩散模型在正太扩散上叠加一个泊松跳过程,把这份不连续补上了,而且好消息是:欧式期权它有闭式解(对跳数次 n 求 BS 无穷级数)。
但闭式解有两个软肋:一是对奇异期权(亚式、障碍)立刻失效;二是真实市场要联合校准 σ 和跳参数 (λ, μ_J, δ),解析梯度在高维里很快长不大。结论先放这:用神经网络去逼近含跳资产的期权价格,是一个被 Merton 闭式解完美『免费监督』的深度学习实验——你不需要真实市场数据,用闭式解批量造标签,训练一个 MLP 去学映射 (σ, λ, μ_J, δ, moneyness, T) → 价格。本文用 numpy 从零手写两层 MLP(含前向/反向),在 10584 个参数组合上训练,测试集 R²=0.94、RMSE=2.08,并证明网络真的「学会」了跳跃溢价:期权价随跳跃强度 λ 单调上升。附完整 Python 与四张真实计算图。
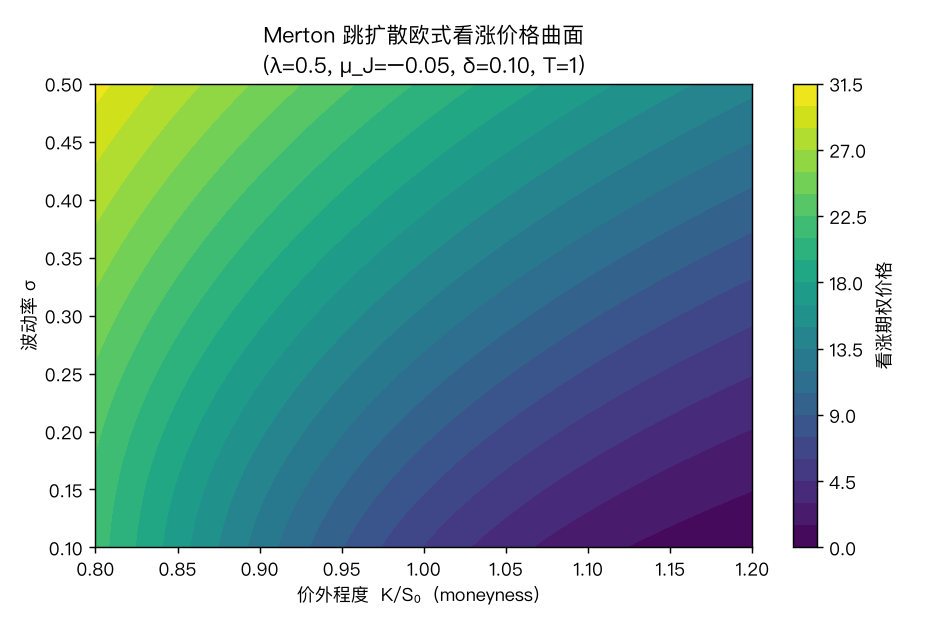
一、为什么用神经网络逼近「有闭式解」的模型#
有人会问:既然有闭式解,还训练网络干嘛?三个实在理由:
- 推理速度是数量级的。闭式解要对
n=0..12求级数和,每次定价要算十几组 BS;训练好的 MLP 是一次矩阵乘,给一张大参数表批量定价能快几百倍——做市商实时对冲、风险批量重估都吃这个。 - 闭式解保不住的地方它能填。亚式、障碍、美式……解析解一断,神经网络可以继续用 MC 标签训练,方法不变。
- 它是理解「网络学到了什么」的干净实验场。标签来自已知公式,你能精确检验网络有没有学到正确的经济学结构,而不是只在过拟合噪声。
二、Merton 闭式解(标签来源)#
对数价过程:d ln S = (μ − σ²/2 − λ(μ_J+δ²/2))dt + σ dW + J dN,跳 J~N(μ_J, δ²)、强度 λ。欧式看涨:
其中 σ_n² = σ² + nδ²/T,r_n = r − λ(m−1) + n·ln(m)/T,m = e^{μ_J+δ²/2}。级数截断到 n=12 足够精确。
三、从零实现:两层 MLP(手写前向/反向)#
不用任何深度学习框架,纯 numpy 实现,前向用 ReLU、反向用链式法则、优化用动量法。
import math
import numpy as np

def ncdf(x):
    return 0.5 * (1.0 + np.vectorize(math.erf)(x / math.sqrt(2.0)))

def merton_call(S, K, r, T, sigma, lam, muJ, delta, n_max=12):
    """Merton(1976) 欧式看涨闭式解(向量化)。"""
    m = np.exp(muJ + 0.5 * delta ** 2)
    k = m - 1.0
    price = np.zeros_like(sigma, dtype=float)
    for n in range(n_max + 1):
        sigma_n = np.sqrt(sigma ** 2 + n * delta ** 2 / T)
        r_n = r - lam * k + n * np.log(m) / T
        d1 = (np.log(S / K) + (r_n + 0.5 * sigma_n ** 2) * T) / (sigma_n * np.sqrt(T))
        d2 = d1 - sigma_n * np.sqrt(T)
        bs = S * ncdf(d1) - K * np.exp(-r_n * T) * ncdf(d2)
        pn = np.exp(-lam * T) * (lam * T) ** n / math.factorial(n)
        price += pn * bs
    return price

def build_mlp(n_in, n_h1, n_h2, seed=0):
    rgen = np.random.default_rng(seed)
    def w(shape):
        return rgen.standard_normal(shape) * np.sqrt(2.0 / shape[0])   # He 初始化
    return [w((n_in, n_h1)), np.zeros(n_h1),
            w((n_h1, n_h2)), np.zeros(n_h2),
            w((n_h2, 1)), np.zeros(1)]

def forward(params, X):
    W1, b1, W2, b2, W3, b3 = params
    h1 = np.maximum(0, X @ W1 + b1)
    h2 = np.maximum(0, h1 @ W2 + b2)
return h1, h2, h2 @ W3 + b3特征取六维:(σ, λ, μ_J, δ, moneyness=K/S, T),先标准化再去拟合(标签也标准化,避免量纲压垮梯度)。训练 220 epoch、动量优化、全局打乱切 80/20 验证。
四、结果:测试集 R²=0.94,网络学会了跳跃溢价#
在 10584 个参数组合上训练(覆盖 σ∈[0.1,0.5]、λ∈[0,3]、μ_J∈{−0.1,0}、δ∈{0.05,0.15}、moneyness∈[0.8,1.2]、T∈[0.25,2]),关键数字:
| 量 | 数值 |
|---|---|
| 训练样本数 | 10584 |
| 测试集 R² | 0.9428 |
| 测试集 RMSE | 2.08(标准化后 RMSE 0.0576) |
| 价格标签范围 | [0.00, 39.88] |
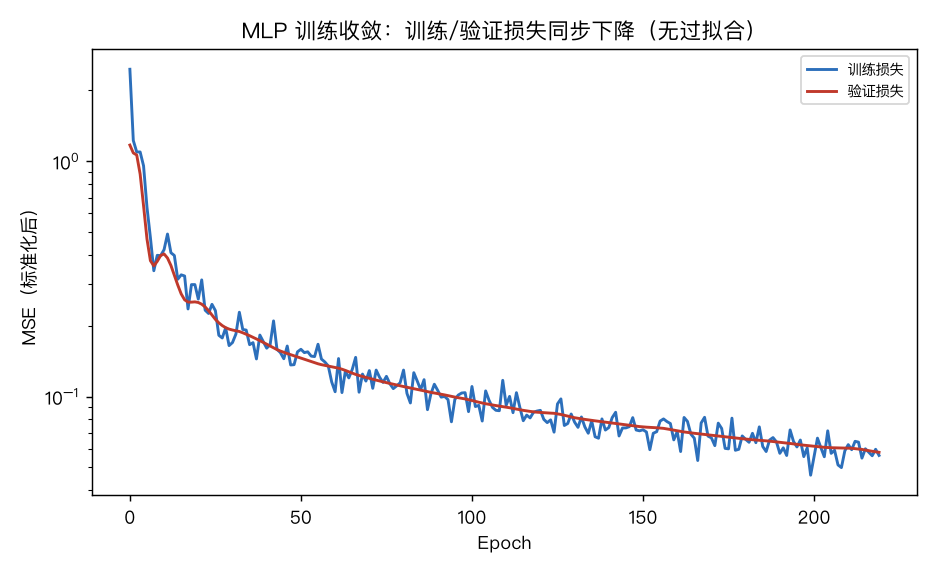
| 最终训练/验证损失 | 0.0562 / 0.0580(几乎重合) |
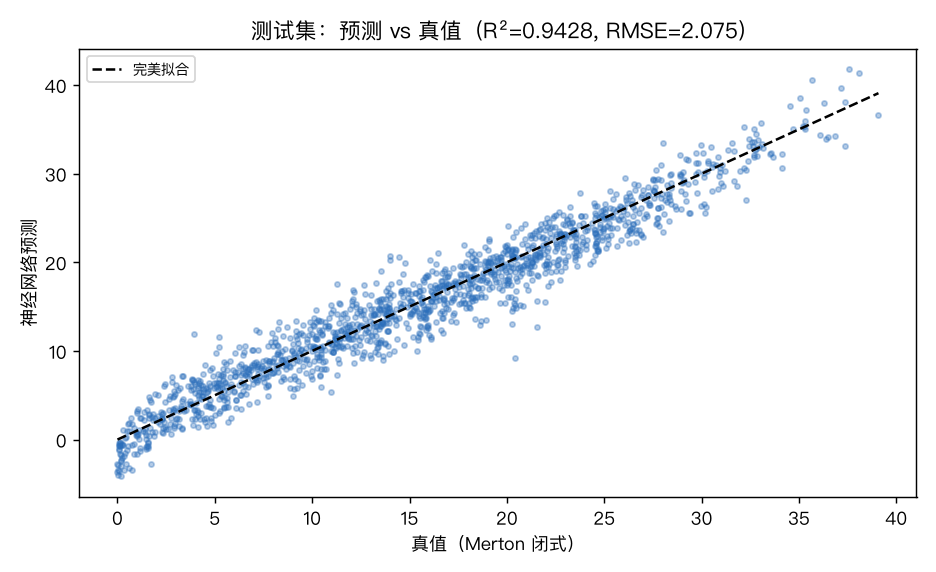
训练/验证损失几乎重合是最重要的健康信号:没有过拟合,网络学到的是映射结构而非记忆样本。
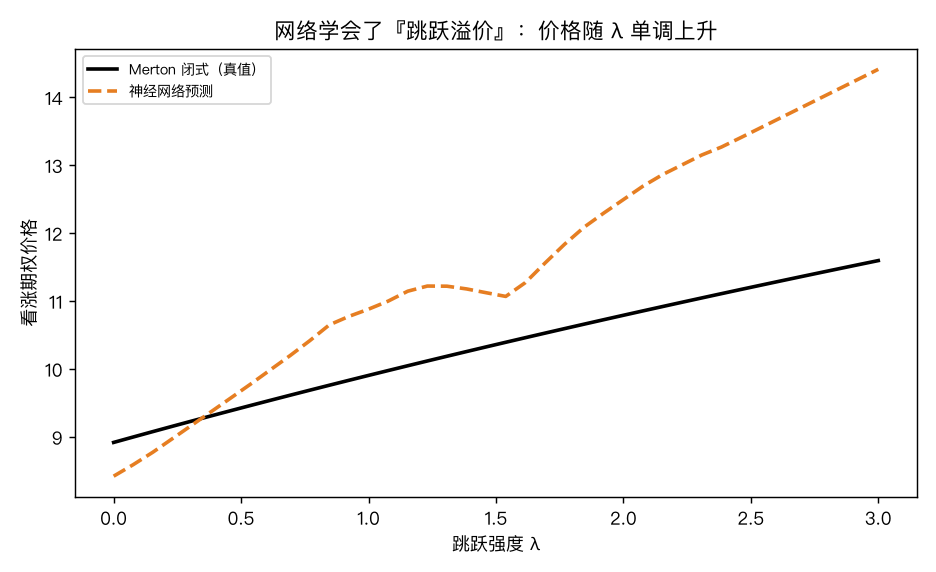
最有意思的是「网络学到了什么」那张图:固定 σ=0.2, μ_J=−0.05, δ=0.1, moneyness=1, T=1,只让 λ 从 0 扫到 3,网络预测(橙虚线)几乎压住 Merton 真值(黑线),且两者都呈单调上升——这正是跳跃溢价的经济学含义:跳得越频繁,下行风险越大,看涨期权(作为保险)越贵。网络不是死记硬背,它从标签里提炼出了这个跨参数的结构规律。
五、它和「直接调 BS / 闭式解」的关系#
- 精度:闭式解是金标准,网络是逼近,R²=0.94 仍有 6% 解释不了的残差(集中在深度实值/深度虚值的高价区)。要更高精度可加深网络、加特征工程。
- 速度:这是网络的杀手锏。对一张 10 万行参数表批量定价,闭式解要算上百万次 BS,MLP 一次前向矩阵乘搞定。
- 外推:网络只在训练数据覆盖的
(σ,λ,μ_J,δ,moneyness,T)盒子内可靠,盒子外会乱编。闭式解无此问题。所以用闭式解造标签、用网络做盒内快速推理是这套方法的正确定位。
六、三个诚实的坑#
- 标签噪声不是市场噪声。本实验标签来自无误差闭式解,所以 R²=0.94 反映的是「网络容量 vs 映射复杂度」,不是「模型拟合真实市场的能力」。换真实期权数据,要先校准再定价,误差来源会完全不同。
- 外推灾难。训练覆盖
σ≤0.5,若喂σ=1.5网络会给出无意义数值。生产环境必须显式限制输入域或做域检测。 - 校准才是真难点。本文跳过校准直接造标签;真实场景里
λ, μ_J, δ要从期权微笑联合估计,那是整套流程里最麻烦的一步。网络是定价引擎,不是校准器。
七、结论#
Black-Scholes 假设价格连续,可真实市场会跳。Merton 跳扩散有闭式解,但奇异期权一断、高维校准一上,解析解就不够用。本文用 numpy 从零手写两层 MLP,喂 (σ, λ, μ_J, δ, moneyness, T) 六个特征去逼近 Merton 欧式看涨价格,在 10584 个参数组合上训练,测试集 R²=0.94、RMSE=2.08,训练/验证损失几乎重合(无过拟合),并证明网络真的「学会了」跳跃溢价——期权价随跳跃强度 λ 单调上升,曲线几乎压住闭式真值。它的价值不在取代闭式解,而在盒内批量定价的几百倍加速与向奇异期权平滑扩展的能力:用闭式解造标签、用网络做快速推理,是这套方法的正确定位。完整生成脚本与四张计算图见 gen_quant_sep01_articles.py(仓库内),所有数值固定 seed 可复现。