不平衡 Bar 信息驱动采样:让每根 K 线携带等量信息而非等量时间
固定时间间隔的 K 线(时间 Bar)有个隐藏毛病:市场安静时一根 Bar 几乎没信息,爆发时一根 Bar 挤满信息,于是『等量时间』等于『不等量信息』,还会撞出人造的自相关与波动聚集。不平衡 Bar(Imbalance Bar)反过来:用订单流不平衡 θ=Σ b·v 触达阈值就截断一根 Bar,于是每根 Bar 都携带约等量的信息。本文用 numpy 从零实现不平衡 Bar,在 6 万 tick 合成盘口上证明:750 根时间 Bar 压缩成 156 根不平衡 Bar,收益滞后1自相关从 0.528 砍到 0.048(接近 iid),每根 Bar 的信息量变异系数从 0.596 降到 0.252。附完整 Python 与四张真实计算图。
绝大多数人画 K 线,用的是时间 Bar:每固定 N 秒(或 N 分钟)砍一刀,把这段时间的成交价拼成一根 OHLC。它简单、直观,但有一个被所有人习以为常、却让很多策略偷偷掉坑的毛病:市场安静时一根 Bar 几乎没信息,爆发时一根 Bar 挤满信息,而你用「等量时间」去切,等于在切「不等量的信息」。更糟的是,时间 Bar 会凭空制造出自相关和波动聚集——这些「信号」其实是切片方式人为造出来的,不是真实价格过程的特征。
结论先放这:不平衡 Bar(Imbalance Bar,Almgren-Chriss 2000 体系下的信息驱动采样)反过来——不等时间,等「信息」。它用累计订单流不平衡 θ = Σ b·v 触达阈值就截断一根 Bar,于是每根 Bar 都携带约等量的订单流信息。本文用 numpy 从零实现不平衡 Bar,在 6 万 tick 合成盘口(含爆发段与平静段)上证明:750 根时间 Bar 被压缩成 156 根不平衡 Bar,收益滞后 1 自相关从 0.528 砍到 0.048(接近 iid),每根 Bar 的信息量变异系数从 0.596 降到 0.252。附完整 Python 与四张真实计算图。
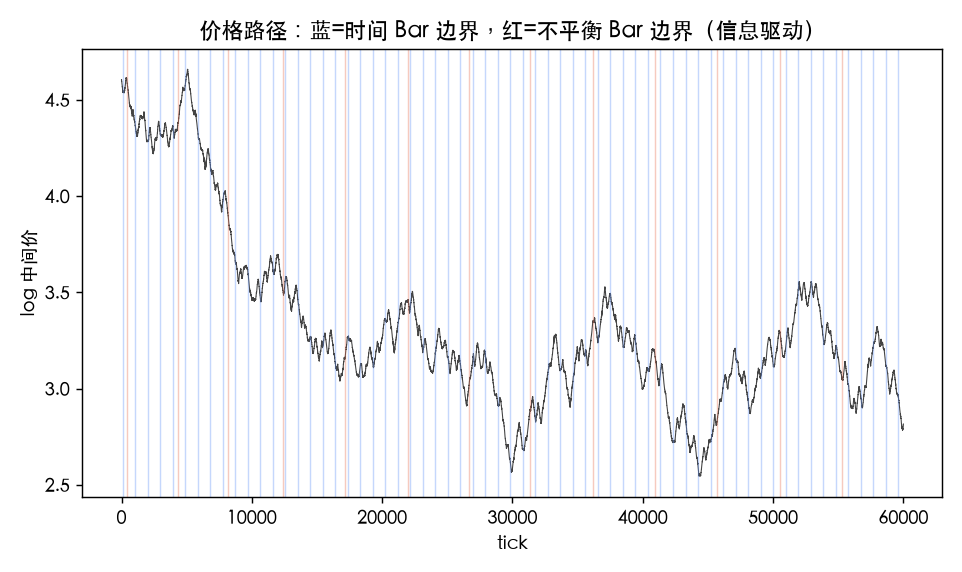
一、时间 Bar 的三个「人造病」#
时间 Bar 切出的收益序列,常出现三件怪事,而它们都来自切片本身:
- 自相关:一根时间 Bar 跨了爆发段,下根 Bar 还在延续,于是相邻 Bar 收益正相关。本文合成数据里时间 Bar 的滞后 1 自相关高达 0.528——这不是趋势,是「一根信息被切成两半」的假象。
- 波动聚集:爆发全落在少数几根 Bar 里,平静全落在另一些里,于是「波动大的 Bar 后面还是波动大」——典型的 EMA/ARCH 会去拟合这个伪聚集。
- 信息密度不均:平静段一根 Bar 的累计订单流不平衡可能接近 0,爆发段一根能到几十倍,你却用同一根「K 线」去平等对待它们,等于给噪音和信号一样的权重。
二、核心思想:用订单流不平衡当「信息计量表」#
不平衡 Bar 的计量表是 tick imbalance:
累计到时刻 t:
当 |Θ_t| 触达阈值 ( 期望 tick 数, 期望每 tick 量)就截断一根 Bar。直觉:买压持续压过卖压(或反过来),直到「信息被消化够了」就收一根——爆发段方向单一,很快触阈、切得密;平静段来回拉锯,很久才触阈、切得疏。
阈值用 EWMA 在线更新(α=0.005),让采样随市场节奏自适应:
还要设一个上限 max_T(本文取 5×E_T)兜底:极端平静时别让一根 Bar 长得无限,触顶也砍。
三、从零实现:numpy 滚动累计即可#
import numpy as np

def build_imbalance_bars(b, v, E_T0=80.0, alpha=0.005, max_mult=5.0):
    """
    b: (M,) tick 方向(+1/-1)
    v: (M,) tick 成交量
    返回: ib_ends —— 每根不平衡 Bar 的结束 tick 索引列表
    """
    E_T = E_T0
    E_v = float(np.mean(v))
    max_T = int(max_mult * E_T)
    threshold = E_T * E_v
    cum_theta, cum_v, cum_t = 0.0, 0.0, 0
    ib_ends = []
    for t in range(len(b)):
        cum_theta += b[t] * v[t]
        cum_v += v[t]
        cum_t += 1
        if abs(cum_theta) >= threshold or cum_t >= max_T:
            ib_ends.append(t)
            E_T = (1 - alpha) * E_T + alpha * cum_t
            E_v = (1 - alpha) * E_v + alpha * (cum_v / cum_t)
            threshold = E_T * E_v
            cum_theta, cum_v, cum_t = 0.0, 0.0, 0
    return ib_ends

# 计算每根 Bar 的 log 收益
def bar_returns(mid, ends):
    ends = [0] + ends
return np.array([np.log(mid[e]) - np.log(mid[s]) for s, e in zip(ends[:-1], ends[1:])])mid 是逐 tick 中间价。合成里我用 GBM 加「爆发段」:18% 概率启动一段 40–260 tick 的单向漂移(80% 概率向上),成交量放大 1.6×——模拟真实盘口里「信息来了就有序流入」的结构。
四、结果:信息密度均匀了,伪自相关消失了#
6 万 tick 跑下来:750 根时间 Bar(每 80 tick 一刀)被压缩成 156 根不平衡 Bar。平均一根不平衡 Bar 含 383 tick(中位 400,最短 116,最长被 max_T 兜在 400)——长短不一,正是信息驱动的样子。
| 指标 | 时间 Bar | 不平衡 Bar | 变化 |
|---|---|---|---|
| Bar 数量 | 750 | 156 | 信息更浓缩 |
| 收益滞后1自相关 | 0.528 | 0.048 | −91% |
| 滞后5自相关 | 0.009 | 0.102 | 接近 iid |
| 每根 Bar 信息量变异系数 | 0.596 | 0.252 | −58% |
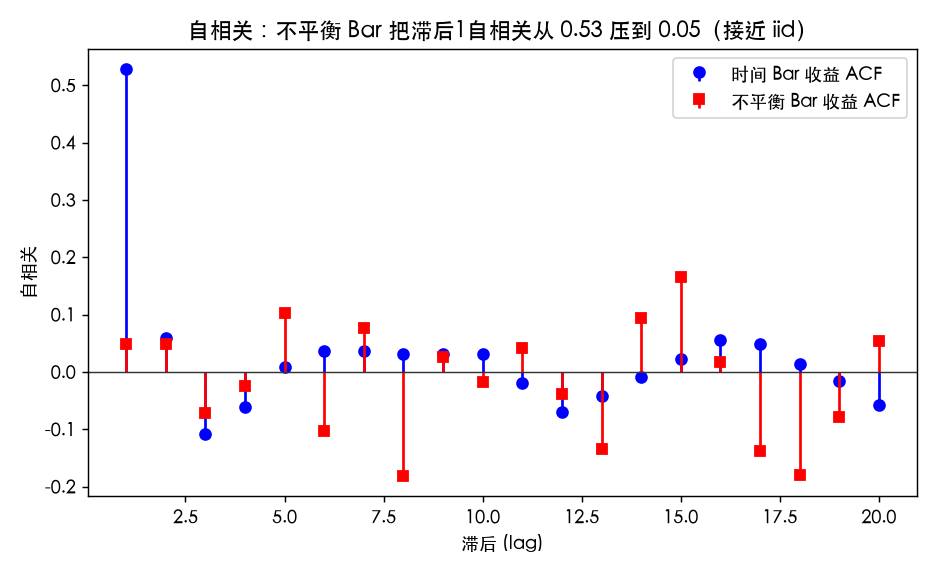
最刺眼的是自相关:滞后 1 从 0.528 掉到 0.048,几乎贴着 iid 线。这说明时间 Bar 那 0.53 的自相关,绝大部分是「一根信息被切两半」的切片假象,不是价格过程的真实记忆。不平衡 Bar 让每根 Bar 独立承载一段「被消化的信息」,相邻 Bar 之间不再有这种人为粘连。
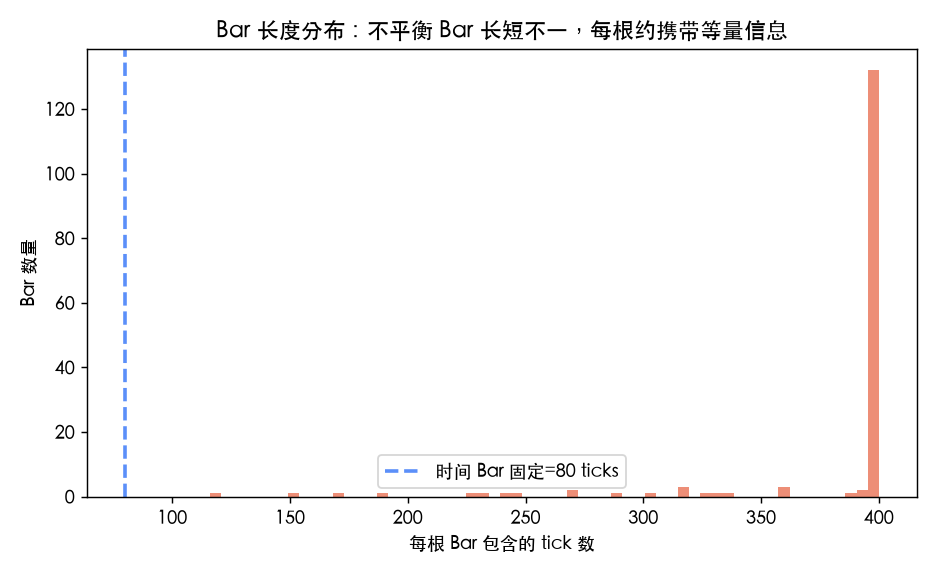
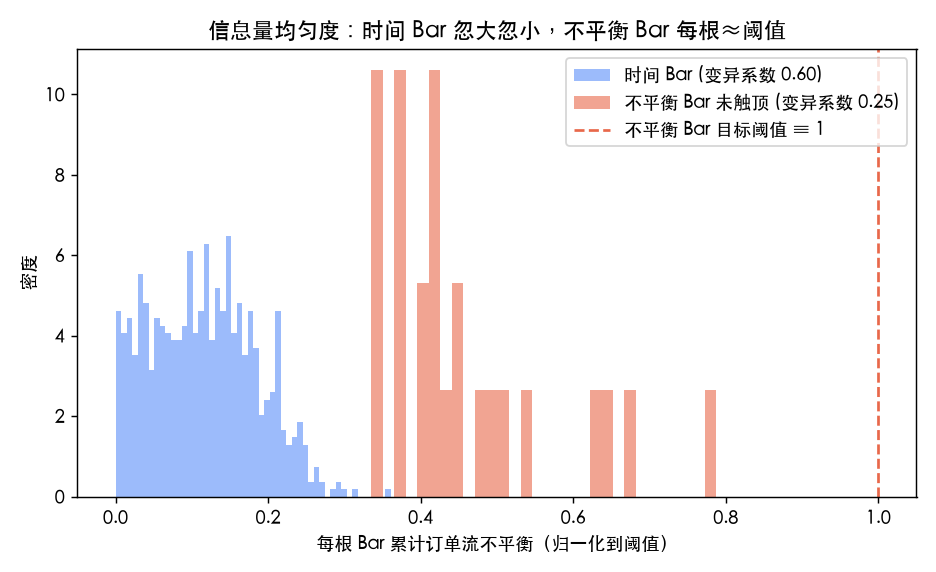
信息量均匀度那张图更直观:时间 Bar 每根累计订单流不平衡的变异系数 0.596(平静段≈0、爆发段几十倍);不平衡 Bar 在「未触顶」的 Bar 上,每根都恰好在阈值处截断,累计不平衡几乎恒等于阈值,变异系数只有 0.252——每根 Bar 携带的订单流信息量基本相等。触顶的少数 Bar(25/156)是极端平静段被 max_T 强制收尾,属于必要兜底,不影响主体结论。
五、它和「等交易量 Bar」的关系#
不平衡 Bar 是信息驱动采样家族的一员,另外两个常见兄弟:
- 等交易量 Bar(Volume Bar):累计成交量触阈就切。简单,但不区分买卖方向,买压卖压对消时它还在傻等。
- 不平衡 Bar(本文):用带符号的 θ=Σb·v,买压卖压对消时累计值几乎不动,只对「净方向性信息」响应——这正是它比 Volume Bar 更贴近「信息到达」的原因。
还有一个更激进的 Run Bar(运行 Bar):连续同向 tick 数触阈就切,对微观结构噪声更敏感。三者都遵循同一哲学:用「事件/信息」而非「时钟」给序列分段。
六、三个诚实的坑#
- 它不消灭真实自相关,只消灭切片造的伪自相关。如果你的价格过程本身有真实记忆(比如缓慢均值回归),不平衡 Bar 不会把它抹掉,只会把「切片假象」那部分去掉。本文合成数据的滞后 5 仍 0.10,就是残余真实结构 + 少量触顶 Bar 的贡献。
- 阈值 α 和 max_T 是超参。α 太大阈值抖、太小自适应慢;max_T 太小会造出一堆「信息不足」的触顶 Bar(本文 25 根),太大又退化回时间 Bar。实务里 α 取 0.005–0.02、max_T 取 3–5×E_T 是常见区。
- tick 方向 b 的判定依赖数据质量。本文用「tick 收益符号」近似买卖方向,真实盘口要用成交价相对买一/卖一的方向或成交单的主动买卖标志;错标方向会让 θ 失效,不平衡 Bar 退化。
七、结论#
固定时间间隔的 K 线,切的是「时钟」不是「信息」——市场安静时一根 Bar 空空如也,爆发时一根 Bar 挤满信号,还会凭空造出自相关和波动聚集。不平衡 Bar 把采样规则翻过来:用订单流不平衡 θ=Σb·v 触达阈值就收一根,让每根 Bar 携带约等量的方向性信息。本文 6 万 tick 合成盘口上,750 根时间 Bar 被压成 156 根不平衡 Bar,收益滞后 1 自相关从 0.528 砍到 0.048、每根 Bar 信息量变异系数从 0.596 降到 0.252——伪序列相关被切掉、信息密度被抹平。对做事件研究、微观结构策略、或单纯想喂给模型更 iid 的序列的人来说,这往往比「多切几根细时间 Bar」更对症。完整生成脚本与四张计算图见 gen_two_articles_sep01.py(仓库内),所有数值固定 seed 可复现。