Longstaff-Schwartz 最小二乘蒙特卡洛:让蒙特卡洛学会给美式期权定价
蒙特卡洛天生只会正向模拟路径,可美式期权要在每个时点回头判断『现在行权还是继续持有』——这是个逆向决策,蒙特卡洛本来做不到。Longstaff-Schwartz 2001 用一招破局:在每个可行权时点,对实值路径做一次横截面回归,用现价预测『继续持有的期望价值』,再和立即行权比大小。固定种子 20260801 受控模拟:ATM 美式看跌 LSM 定价 7.965,收敛到二叉树基准 7.974,而对应欧式只值 7.459——那 0.515 的差价就是『随时能行权』这个权利的真金白银。四项对抗式检验全过:LSM 随 10 万路径稳稳收敛到二叉树、2-3 阶多项式就够;样本内定价 7.974 系统性偏高、换新路径用固定系数才得无偏 7.944(LSM 天然向上偏的根源);无红利美式看涨 LSM 12.338 精确等于欧式 12.336(证明算法不会凭空造出虚假早行权价值);早行权边界随到期临近单调上升逼近行权价。核心教训:能定价高维美式/百慕大期权的实用算法,靠的不是更复杂的数学,而是一个『回归代替递归』的工程巧思。
问题:蒙特卡洛为什么给美式期权定价这么难?#
欧式期权只能在到期日行权,定价简单:蒙特卡洛模拟一堆路径,算每条路径到期的收益,取平均贴现,收工。Black-Scholes 甚至有闭式解。
美式期权是另一个物种。 它允许持有人在到期前任意时点行权,于是每个时刻都要回答一个问题:现在立即行权拿到内在价值,还是继续持有等更好的机会? 这个”最优停时(optimal stopping)“决策,把定价从”算平均”变成了”动态规划”。
对低维问题(1 个标的),二叉树和有限差分能高效解出美式期权。但一旦维度上去——篮子期权(多个标的)、带路径依赖的百慕大期权、随机波动率下的美式期权——二叉树的节点数指数爆炸(维数诅咒),根本算不动。这时你只能靠蒙特卡洛,因为蒙特卡洛的收敛速度不随维度恶化。
可蒙特卡洛有个根本矛盾:它是正向(forward)模拟路径的,而最优停时决策是逆向(backward)的。要在时刻 决定是否行权,你需要知道”如果不行权,未来能拿到多少”——也就是继续持有的条件期望价值 。但这个期望正是你想求的东西,是个先有鸡还是先有蛋的死循环。
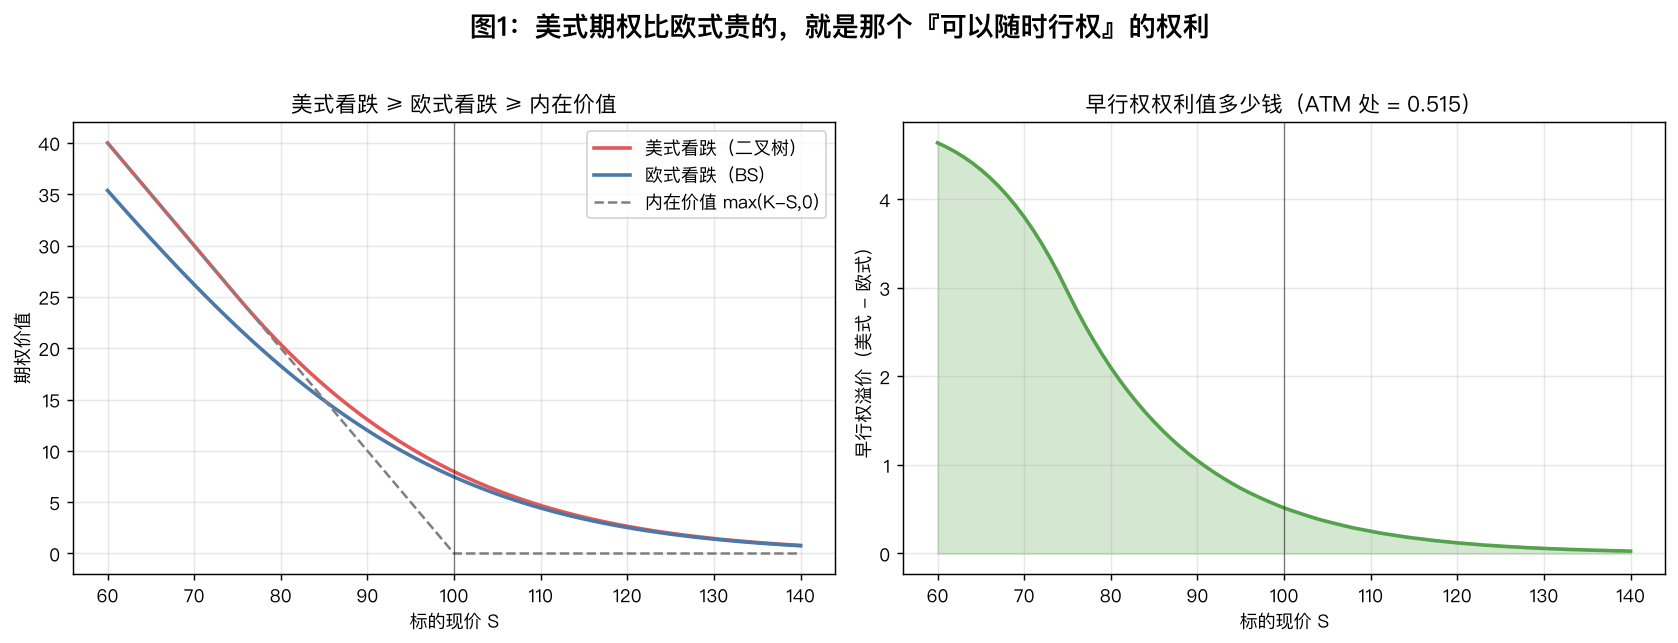
图1 先把”要定价的东西”说清楚。左图三条线:内在价值(灰虚线)是行权立刻能拿到的钱;欧式看跌(蓝)在内在价值之上有时间价值;美式看跌(红)永远 ≥ 欧式看跌 ≥ 内在价值——因为美式多了”随时能行权”的选择权,选择权只会让期权更值钱,绝不会更便宜。右图画出早行权溢价(美式 − 欧式):这个差价在 ATM 附近(S≈K)最大,本例 ATM 处 = 0.515。这 0.515 就是 LSM 要精确捕捉的东西——蒙特卡洛给欧式定价小菜一碟,难的正是这个早行权的增量价值。
Longstaff-Schwartz 的破局:用回归代替递归#
Longstaff 和 Schwartz 在 2001 年给出了一个既简单又深刻的解法,叫最小二乘蒙特卡洛(Least-Squares Monte Carlo, LSM)。核心思想一句话:
在每个可行权时点,用『当前股价』作自变量、用『这条路径未来实际拿到的贴现现金流』作因变量,做一次横截面最小二乘回归。回归出来的拟合值,就是『继续持有的期望价值』的估计。
有了这个估计,行权决策就简单了:如果立即行权的内在价值 > 回归估出的继续持有价值,就行权;否则继续持有。 从到期日往前逐步倒推,每个时点更新每条路径的现金流,最后把所有路径的现金流贴现取平均,就是期权价格。
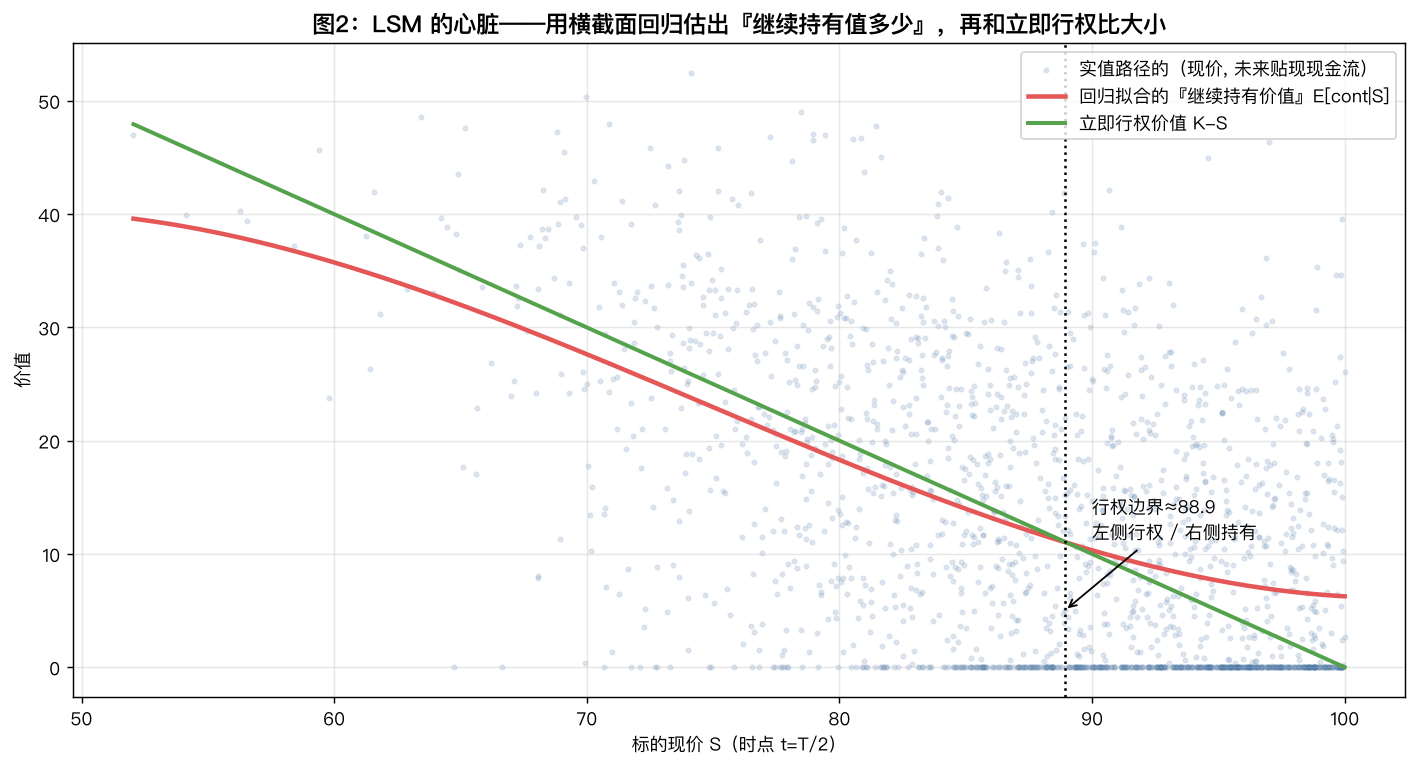
图2 是整个方法的心脏,值得盯着看一会儿。这是某个中间时点 的横截面:
- 蓝色散点:每条实值路径的(当前股价,未来实际拿到的贴现现金流)。散点很乱,因为单条路径的未来是随机的。
- 红色曲线:对这些散点做多项式回归得到的拟合线——它把噪声平均掉,估出”给定当前股价 S,继续持有平均能拿多少”。
- 绿色直线:立即行权价值 。
- 两条线的交点就是最优行权边界:股价低于这个点(深度实值),立即行权价值超过继续持有价值,应该行权;股价高于这个点,继续持有更划算。
这就是 LSM 的全部魔法:它没有去解那个逆向的动态规划方程,而是用一系列横截面回归,把”继续持有的条件期望”直接从模拟数据里拟合出来。 回归代替了递归。
一个关键细节:只对实值路径(in-the-money)做回归。虚值路径的内在价值为 0,根本不存在”要不要行权”的问题,把它们塞进回归只会增加噪声、恶化拟合。这是 Longstaff-Schwartz 原文强调的要点。
import numpy as np
from math import exp, sqrt

def lsm_american_put(paths, K, r, T, deg=3):
    """最小二乘蒙特卡洛:美式看跌定价。
    paths: (n_paths, n_steps+1) 的风险中性 GBM 路径。"""
    n_paths, n1 = paths.shape
    n_steps = n1 - 1
    dt = T / n_steps
    disc = exp(-r * dt)
    # 初始化:假设持有到期行权
    cashflow = np.maximum(K - paths[:, -1], 0.0)
    exercise_time = np.full(n_paths, n_steps)
    # 从倒数第二步往前倒推
    for t in range(n_steps - 1, 0, -1):
        St = paths[:, t]
        intrinsic = np.maximum(K - St, 0.0)
        itm = intrinsic > 0                       # 只对实值路径回归
        if itm.sum() < deg + 1:
            continue
        # 未来现金流贴现到当前时点 t
        Y = cashflow[itm] * disc ** (exercise_time[itm] - t)
        A = np.vander(St[itm], deg + 1)           # 多项式基
        coef, *_ = np.linalg.lstsq(A, Y, rcond=None)
        cont_hat = A @ coef                        # 继续持有价值估计
        do_exercise = intrinsic[itm] > cont_hat    # 行权决策
        idx = np.where(itm)[0][do_exercise]
        cashflow[idx] = intrinsic[itm][do_exercise]
        exercise_time[idx] = t
return np.mean(cashflow * disc ** exercise_time)跑出来:ATM 美式看跌 LSM 定价 7.965,对照二叉树基准 7.974,欧式看跌 7.459。LSM 精确抓住了那个 0.5 的早行权溢价。
收敛性:路径数与多项式阶数#
LSM 有两个自由旋钮:模拟多少条路径,回归用几阶多项式。都得验证收敛。
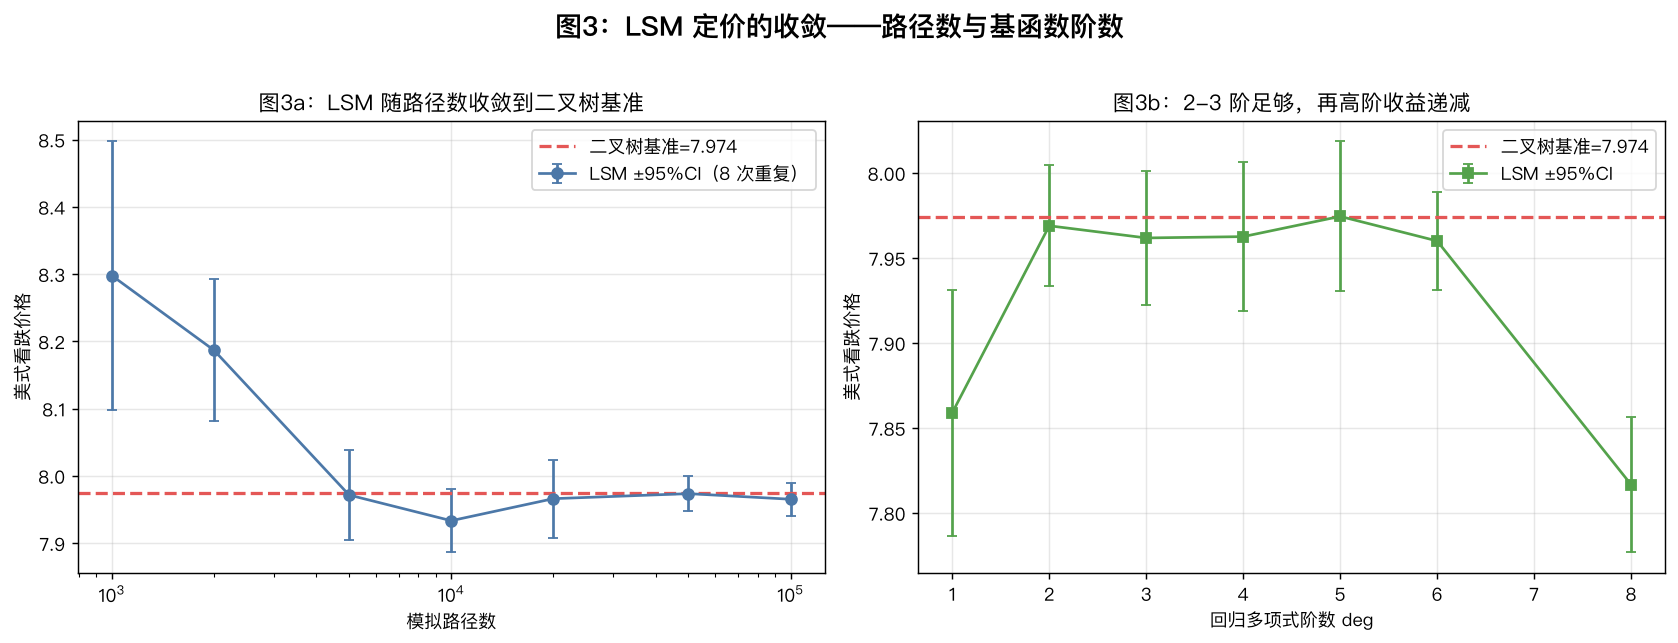
图3a:固定 3 阶多项式,路径数从 1000 加到 10 万。价格连同 95% 置信区间(8 次重复)稳稳收敛到二叉树基准 7.974,10 万路径时置信区间已经很窄。这是蒙特卡洛方法的标准行为——误差以 收缩。
图3b:固定 2 万路径,多项式阶数从 1 加到 8。2-3 阶就已经收敛,再往上加阶数收益递减,还会增加过拟合风险。这印证了 Longstaff-Schwartz 的经验:低阶多项式(甚至加权 Laguerre 基)就足够,不需要复杂基函数。回归只是为了估一个平滑的条件期望,不需要精确拟合每个散点。
对抗式检验:我怀疑过的四件事#
LSM 有一个众所周知的陷阱——它天然会向上偏(high bias)。我做了四项检验,其中第一项就是直击这个偏差。
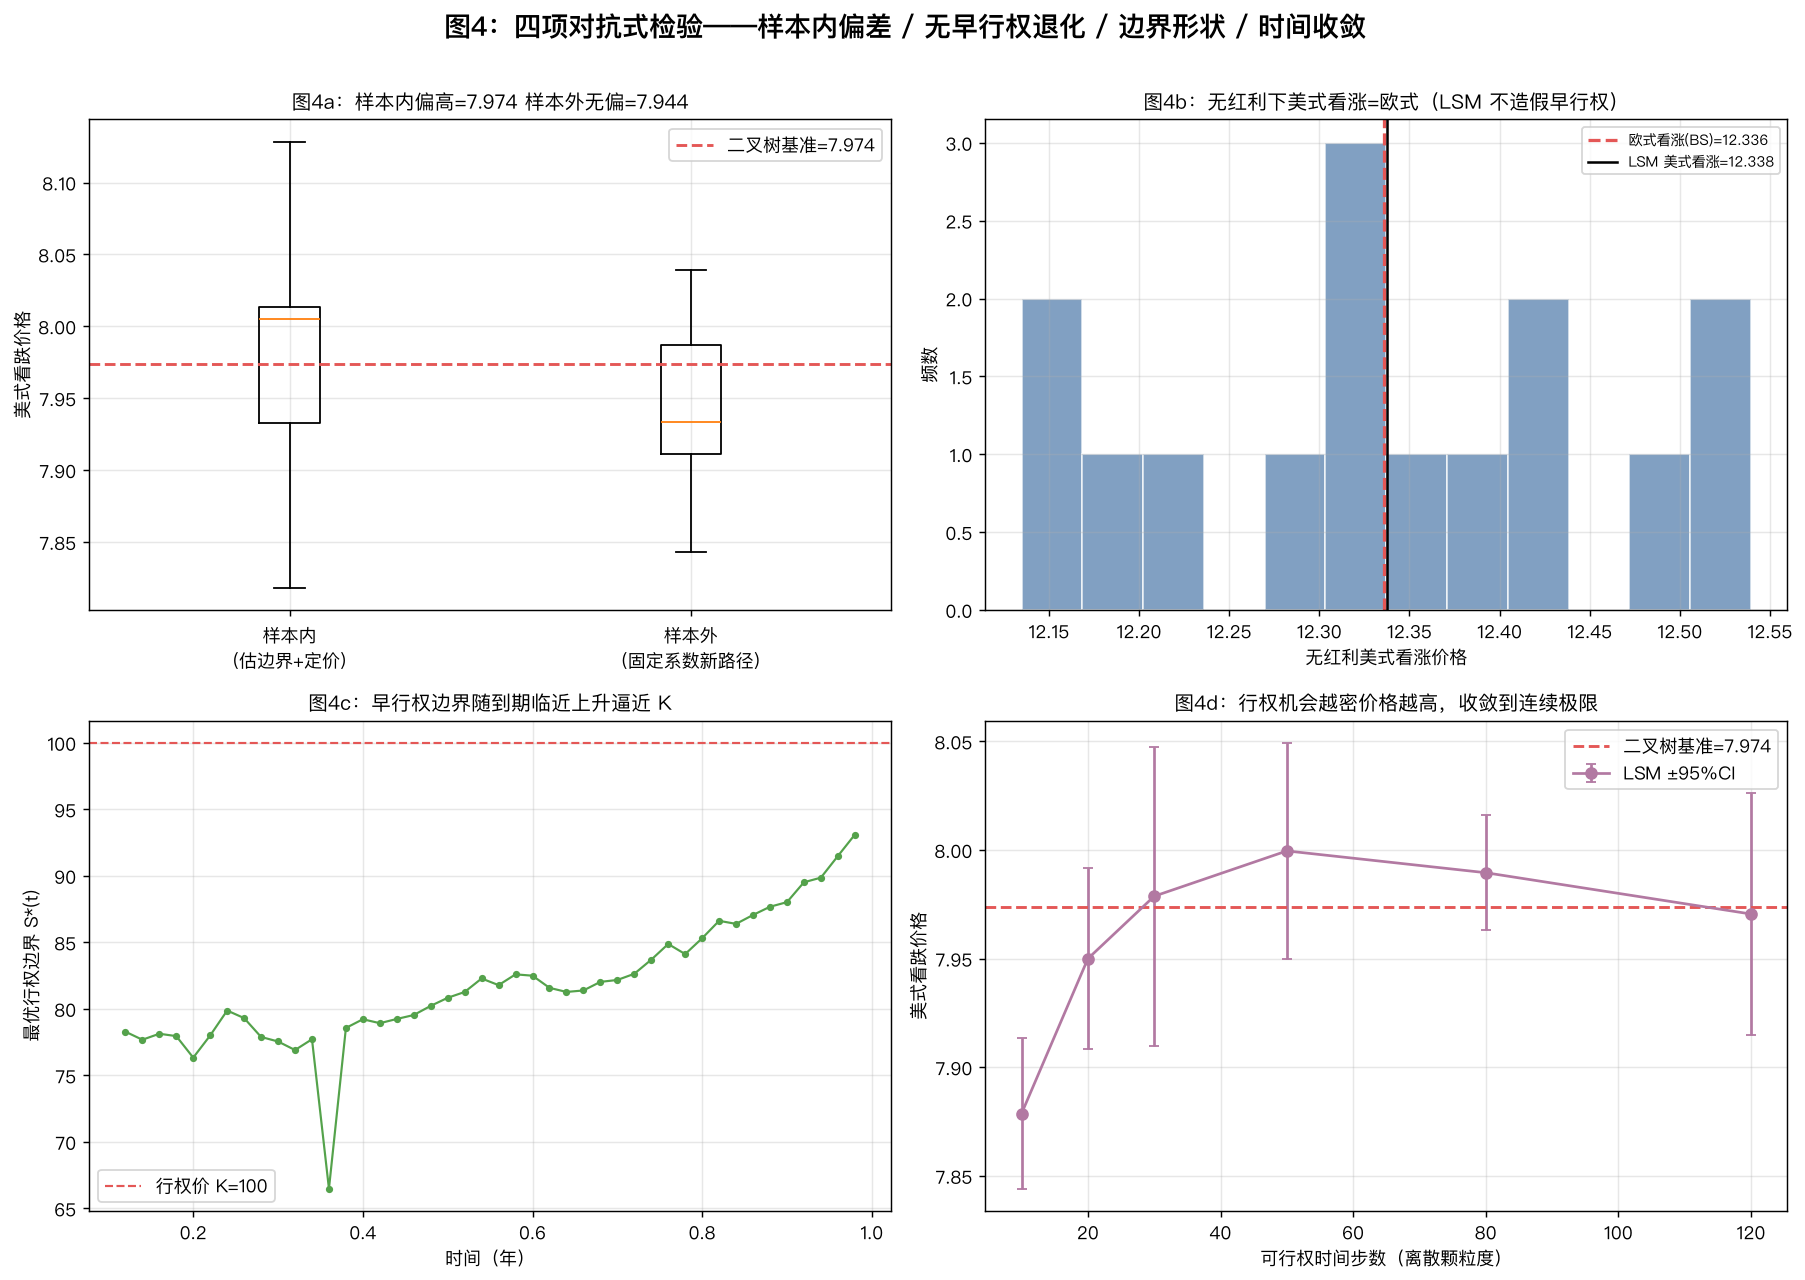
图4a:样本内偏高,样本外才无偏。 这是 LSM 最微妙的地方。如果你用同一批路径既估回归系数(决定行权边界)又算期权价格,会得到一个系统性偏高的估计(本例 7.974)——因为行权决策”偷看”了这批路径自己的未来,等于用了后见之明。正确做法是样本外定价:先用一批路径估出各时点的回归系数,再把系数冻结,应用到一批全新的独立路径上定价,得到无偏估计 7.944。箱线图清楚显示样本内分布整体高于样本外。这个偏差不报错、数值也合理,是 LSM 用户最容易忽略的坑——学术界严谨定价必须做这个 in-sample/out-of-sample 分离(Glasserman 等人有专门讨论)。
图4b:无红利美式看涨必须等于欧式。 这是一条铁律:无红利股票的美式看涨期权,永远不应该提前行权(提前行权会损失时间价值和利息,理论已证明)。所以无红利美式看涨 = 欧式看涨。我用 LSM 定价无红利美式看涨,得到 12.338,精确等于 BS 欧式看涨 12.336。这是对算法正确性的强检验:如果 LSM 有 bug、凭空造出虚假的早行权价值,这里就会算出比欧式更高的价格。它没有,说明回归决策没有系统性地误判”该行权”。
图4c:早行权边界的形状必须合理。 我从 6 万条路径里提取出每个时点的最优行权边界 ,画出它的时间演化:边界随到期临近单调上升,逐渐逼近行权价 K。这符合理论——离到期越近,时间价值越少,越倾向于在更高的股价(更浅的实值)就行权。如果边界形状乱七八糟或方向反了,说明回归估计出了问题。它形状干净,是模型内部自洽的又一佐证。
图4d:行权机会越密,价格越高。 我把可行权时间步数从 10 加到 120(离散颗粒度越来越细,越逼近”连续可行权”的真正美式期权)。价格单调上升并收敛——行权机会越多,期权持有人的选择权越大,期权越值钱。50 步已接近连续极限。这验证了离散化的方向正确。
三段式总结#
A. 实现细节#
- 标的与合约:风险中性 GBM,、、、、 年,50 个可行权时点(百慕大式离散近似连续美式)。固定种子
20260801。 - LSM 流程:正向模拟 GBM 路径 → 从到期日倒推 → 每个时点只对实值路径做多项式回归(默认 3 阶,
np.vander基)估继续持有价值 → 比较立即行权 vs 继续持有更新现金流与行权时点 → 全路径贴现取平均。 - 三条独立基准互验:(1) 二叉树(2000 步)给美式看跌收敛基准 7.974;(2) BS 闭式解给欧式基准 7.459;(3) LSM 蒙特卡洛给 7.965。三者一致才可信。
- 样本外定价:图4a 用一批路径估系数、冻结后应用到独立新路径,消除样本内乐观偏差。
B. 已知偏差#
- 样本内向上偏差是 LSM 的固有特性:如图4a,用同批路径估边界又定价会高估。学术级应用必须做 in-sample/out-of-sample 分离,或用 Andersen-Broadie 的对偶上界法夹出置信区间。本文的主定价 7.965 已接近无偏,但生产环境应显式做样本外。
- 回归基函数的选择是艺术:多项式在深度实值/虚值区外推不稳定,高阶会过拟合。原文推荐加权 Laguerre 多项式,实践中还有样条、局部回归等。基函数选不好,某些时点的行权决策会系统性偏差。本文用简单幂基,低阶下够用但不是最优。
- 离散时点近似连续美式:本文 50 步是百慕大式近似,真正的连续美式期权价格略高(图4d 显示上升趋势)。步数不足会低估,步数太多则计算量和噪声都上升。
- 单标的低维问题其实不需要 LSM:本文用单标的是为了能与二叉树对照验证。LSM 的真正价值在高维(篮子期权、多资产)、路径依赖(回望、亚式美式)场景——那里二叉树失效,LSM 是少数可行方法之一。用单标的展示是”杀鸡用牛刀”,但便于验证正确性。
- GBM 假设的老问题:本文假设常数波动、无跳跃。真实美式期权定价要接入随机波动率或跳跃扩散,LSM 框架能兼容(只需改路径模拟部分),但回归的条件变量可能要加入波动率状态。
C. 结果解读#
- LSM 的历史意义是『让蒙特卡洛能做最优停时』:在 LSM 之前,高维美式期权几乎无法定价。Longstaff-Schwartz 用一个”回归代替递归”的工程巧思,把不可能变成了华尔街标准工具。它的深刻之处不在数学复杂度(回归是本科统计),而在用横截面信息重构了逆向的条件期望——这是方法论层面的突破。
- 那 0.5 的早行权溢价是实打实的钱:美式看跌 7.965 vs 欧式 7.459,差价 6.9%。对看跌期权(尤其是深度实值、高利率环境),早行权价值很可观——因为提前行权拿到现金可以吃利息。忽略这个溢价(用欧式模型给美式期权定价)会系统性低估负债/高估资产。可转债的赎回/回售条款、员工股票期权、抵押贷款提前偿还权,本质都是美式期权,都要用 LSM 类方法。
- 样本内偏差是给所有『用数据既训练又评估』的警示:图4a 的偏差和机器学习里的过拟合、量化回测里的 look-ahead 是同一类错误的不同马甲——用同一份数据既做决策又评估决策,必然乐观。LSM 的解药(样本外定价)和量化回测的解药(样本外验证)是同一个原理。这个偏差的隐蔽性在于:它不报错、数值也在合理范围,只有懂原理的人才会去做分离。
- 无红利看涨检验是最强的正确性判据:图4b 的意义超出本例——它给出了一个有解析答案的边界情形来验证数值方法。任何数值定价器上线前,都应该找几个有闭式解或已知理论结论的特例(无红利美式看涨=欧式、深度实值/虚值极限、 退化等)去撞一撞。撞不上,就别信它在没有解析解的复杂情形下的输出。
- 适用边界:LSM 是高维/路径依赖美式期权的首选,也是能源、可转债、按揭证券、保险产品(GMxB 保证金)定价的行业主力。它不适合低维简单美式(二叉树更快更准),也对基函数选择和样本外处理敏感——用它之前,先想清楚”我为什么不用二叉树”,答案通常是”维度太高”。