宏观因子映射:把资产收益拆解到增长与通胀两轴
「我持有 6 类资产,够分散了吧」——这是资产配置里最贵的一句错话。25 年月频实测:一个名义上持有 6 类资产、单资产最大权重仅 35% 的组合,权重 HHI 只有 0.235 看着很分散,但因子方差分解摊开来,51.8% 的波动全部来自同一个增长因子、通胀因子只占 3.5%——它不是分散组合,是加了债券装饰的股票。真正的诊断工具是把每个资产回归到「增长意外/通胀意外」两轴:股票 (+2.96, -1.29)、黄金 (+0.04, +2.39)、大宗商品 (+2.02, +2.99)、国债 (-0.70, -1.52),这张地图立刻告诉你谁和谁其实是同一笔押注。四象限矩阵给出残酷事实:没有任何资产在四个象限都活着——股票在滞胀 -35.9%、大宗商品在通缩衰退 -37.7%、黄金在金发姑娘 -19.9%。按因子暴露而非资产名称配权后,通胀敞口从 -0.0138 压到 +0.0003、最差象限从 -24.5% 收敛到 -3.6%、四象限极差从 61.0pp 砍到 15.6pp、Sharpe 从 0.64 升到 1.00,样本外 (后 15 年持有前 10 年估的权重) Sharpe 0.82 vs 60/40 的 0.41。三盆冷水:beta 在漂(黄金增长 beta 信噪比仅 0.51)、因子平衡砍右尾也砍左尾、两因子解释力有天花板(R² 最高 0.66)(中阶)
“我持有股票、信用债、国债、大宗商品、黄金、现金六类资产,单一资产最大权重才 35%,够分散了吧?”
这句话是资产配置里最贵的错觉。我拿一个正是这样构造的组合做实测:权重赫芬达尔指数(HHI)只有 0.235,从权重表上看确实分散。但把它的收益回归到宏观因子上,51.8% 的波动来自同一个增长因子,通胀因子只占 3.5%。
它不是分散组合。它是一个加了债券装饰的股票。
结论先放这:分散度不是资产种类数,是因子暴露的均衡度。 判断标准只有一个——把组合收益回归到”增长意外/通胀意外”两轴,看方差怎么分。本文用 25 年月频合成数据(增长/通胀两个持续性状态因子,月频自相关分别 0.814 / 0.846,相关系数 -0.05)跑完整流程:按因子暴露而非资产名称重新配权后,通胀敞口从 -0.0138 压到 +0.0003、最差象限收益从 -24.5% 收敛到 -3.6%、Sharpe 从 0.64 升到 1.00。所有数字均由下文 Python 真实计算,非占位图。
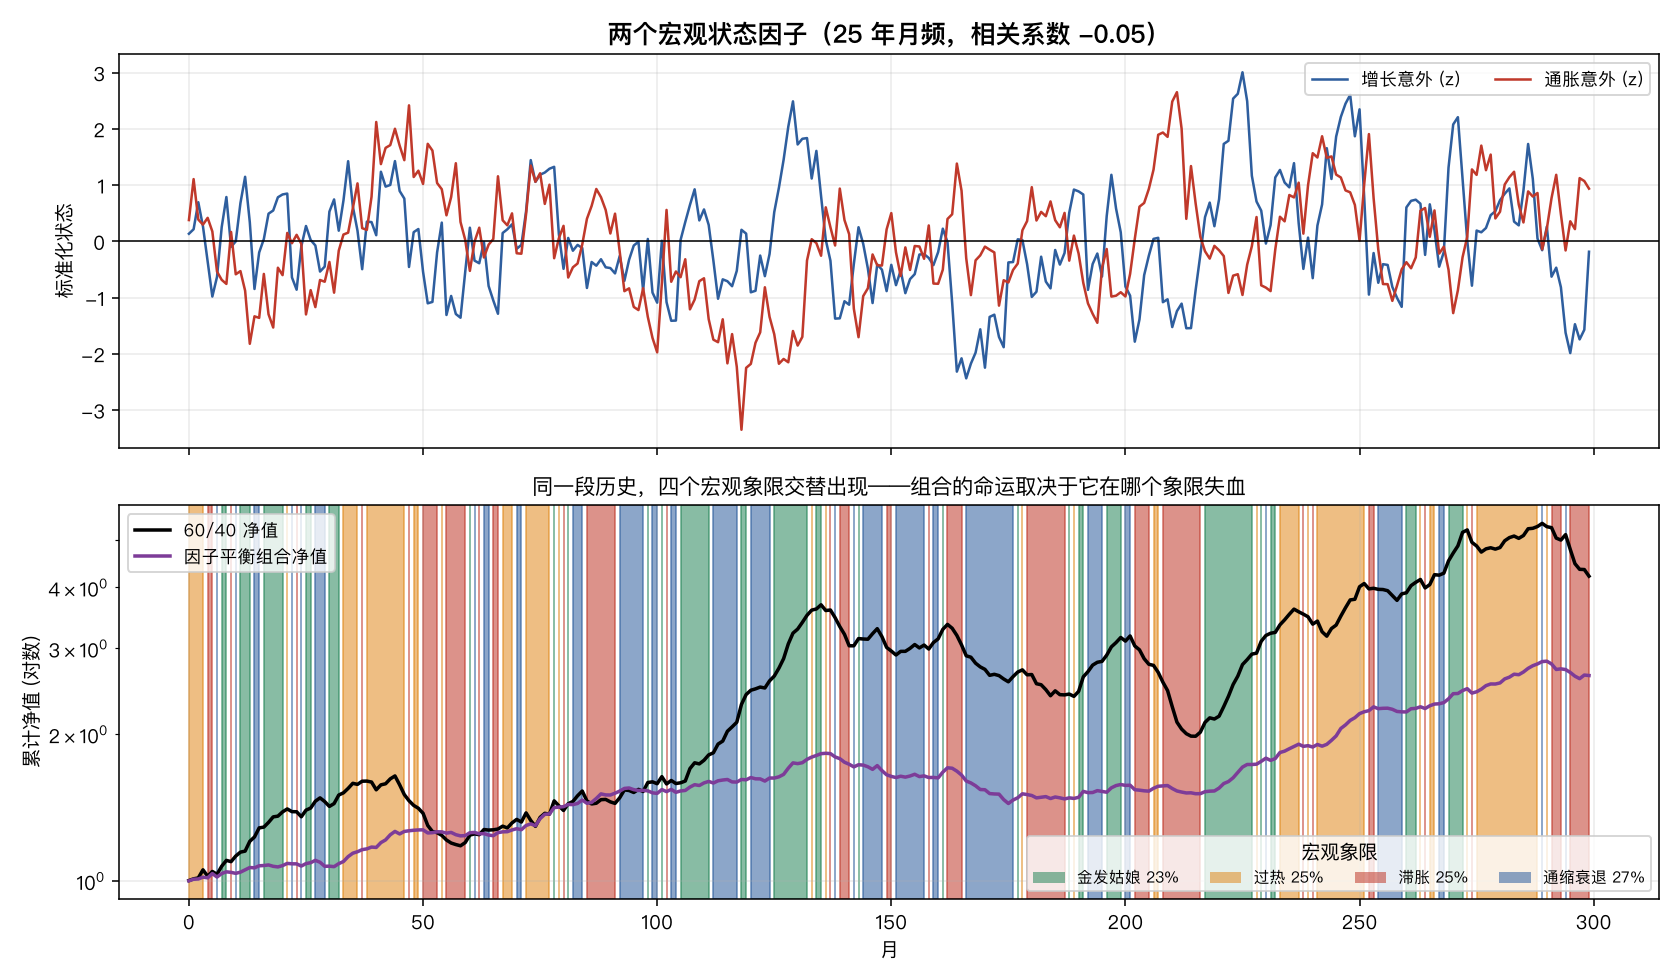
一、为什么是「增长」和「通胀」这两轴#
这个框架的思想源头是桥水的”全天候”:资产价格反映的是对未来现金流的贴现,而两件事决定这个贴现——经济增长(决定现金流)和通货膨胀(决定贴现率与货币的实际购买力)。
关键在”意外”两个字。已经被市场预期到的增长和通胀,早已定价在资产里。驱动收益的是预期之外的部分。所以两个因子的正确定义是:
- 增长意外:实际经济活动相对预期的偏离
- 通胀意外:实际通胀相对预期的偏离
实务中的常见代理变量:增长意外用花旗经济意外指数、PMI 变化、股债相对表现;通胀意外用盈亏平衡通胀率(BEI)变化、TIPS 与名义债的相对表现、大宗商品指数。本文用 OU 过程直接合成两个标准化状态因子,避开代理变量选择这个(真实且严重的)问题——第八节会把它作为一盆冷水单独说。
二、因子映射:一个 OLS 就够了#
映射本身简单到令人怀疑:
X = np.column_stack([np.ones(M), g_z, i_z])       # 常数 + 增长 + 通胀
b = np.linalg.inv(X.T @ X) @ X.T @ asset_returns # b = [alpha, beta_g, beta_i]七类资产的估计结果(beta 已乘 100,读作”每 1 个标准差的因子意外,带来多少百分点的月度收益”):
| 资产 | 增长 beta | 通胀 beta | 增长 t 值 | 通胀 t 值 | R² |
|---|---|---|---|---|---|
| 股票 | +2.96 | -1.29 | 16.6 | -7.2 | 0.535 |
| 信用债 | +0.89 | -1.08 | 10.8 | -13.1 | 0.505 |
| 国债 | -0.70 | -1.52 | -10.2 | -22.2 | 0.659 |
| 通胀挂钩债 | -0.53 | +0.91 | -8.2 | 14.2 | 0.487 |
| 大宗商品 | +2.02 | +2.99 | 8.0 | 11.9 | 0.396 |
| 黄金 | +0.04 | +2.39 | 0.2 | 10.1 | 0.256 |
| 现金 | +0.12 | +0.01 | 10.4 | 0.6 | 0.267 |
估计精度很好(增长 beta 平均绝对误差 0.0012、通胀 0.0006,相对真值都在 5% 以内)。把它画到平面上,整个资产宇宙的结构一目了然:
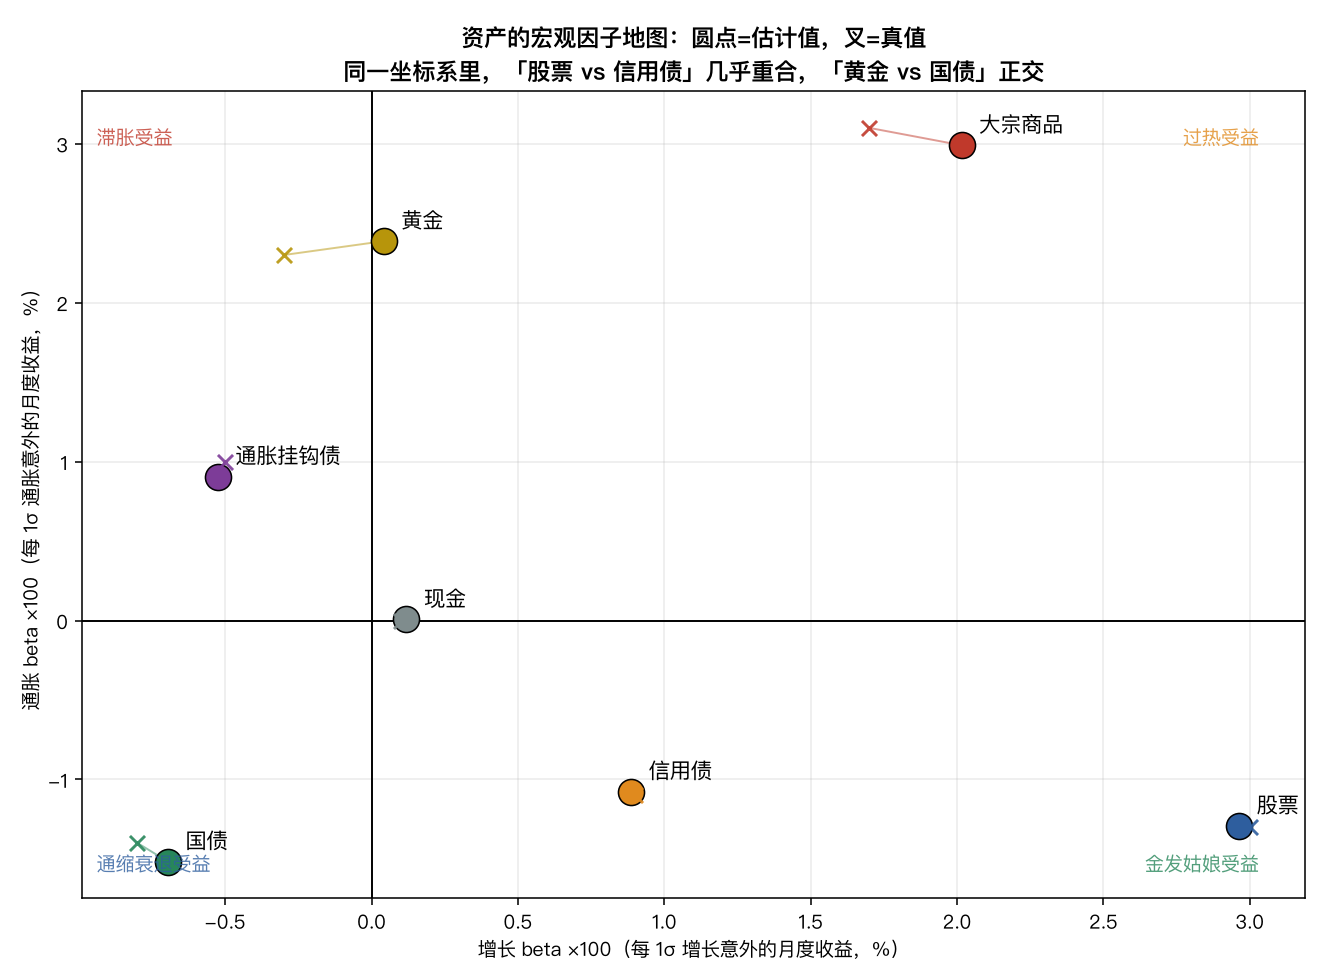
三个立刻能用的读点:
- 股票和信用债在同一个象限、方向几乎重合。 你以为在做”股债配置”,实际上信用债的增长 beta(+0.89)就是一个缩水版股票。真正对冲股票的是国债(-0.70),不是信用债。
- 黄金的增长 beta 在统计上不存在(t = 0.2)。 它是一个近乎纯粹的通胀对冲工具。这个”不显著”本身就是最有价值的信息——它说明黄金和股票的相关性来源不是增长,配在一起能真正降低增长集中度。
- 大宗商品同时正暴露于增长和通胀。 它在”过热”象限是王者,但在通缩衰退里会双杀。
三、四象限:没有任何资产在四个格子里都活着#
把连续的两轴离散化成四个宏观象限,是这个框架最直观的表达:
QUAD = np.where((g_z >= 0) & (i_z <  0), 0,   # 金发姑娘:增长↑ 通胀↓
        np.where((g_z >= 0) & (i_z >= 0), 1,  # 过热:    增长↑ 通胀↑
        np.where((g_z <  0) & (i_z >= 0), 2,  # 滞胀:    增长↓ 通胀↑
3)))# 通缩衰退:增长↓ 通胀↓四个象限在 25 年里的占比相当均衡(23.3% / 24.7% / 24.7% / 27.3%),这也是 OU 过程该有的性质。各资产的象限内年化收益:
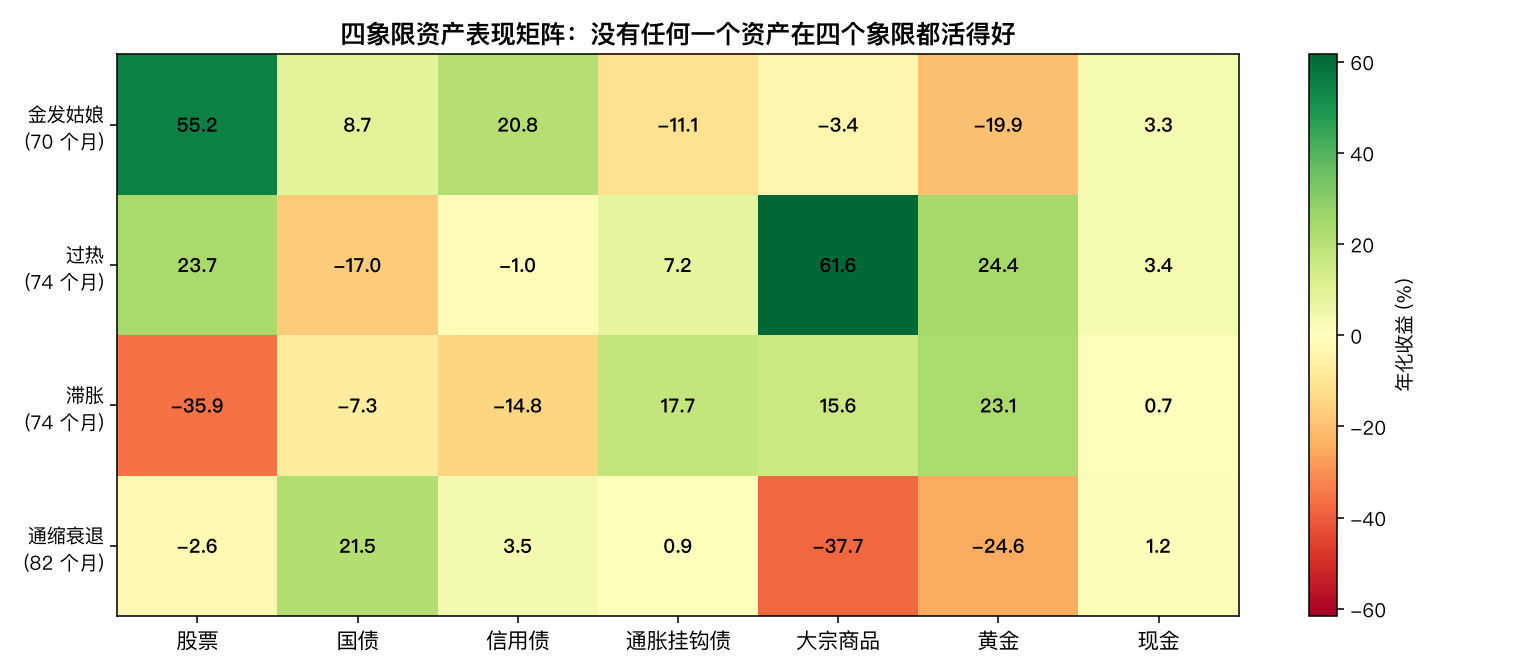
| 资产 | 金发姑娘 (70月) | 过热 (74月) | 滞胀 (74月) | 通缩衰退 (82月) |
|---|---|---|---|---|
| 股票 | +55.2% | +23.7% | -35.9% | -2.7% |
| 国债 | +8.7% | -17.0% | -7.3% | +21.5% |
| 信用债 | +20.8% | -1.1% | -14.9% | +3.5% |
| 通胀挂钩债 | -11.1% | +7.3% | +17.7% | +0.9% |
| 大宗商品 | -3.4% | +61.6% | +15.6% | -37.7% |
| 黄金 | -19.9% | +24.4% | +23.1% | -24.6% |
| 现金 | +3.3% | +3.4% | +0.7% | +1.2% |
(象限内年化收益的绝对值偏大,因为样本按状态筛选后是”极端月份”的年化外推,不代表可实现的长期收益。看的是相对排序,不是绝对水平。)
这张表是整个框架的心脏:
- 每个象限都有赢家,但每个赢家在别的象限都要挨打。 股票在金发姑娘 +55.2%,在滞胀 -35.9%;大宗商品在过热 +61.6%,在通缩衰退 -37.7%;黄金在滞胀 +23.1%,在金发姑娘 -19.9%。
- 只有现金四格全正,但代价是四格都只有 1%~3%。风险平价的哲学正是从这里出来的:不预测象限,而是让组合在四个象限都不死。
- 滞胀是最难的象限。 只有通胀挂钩债和黄金是正的,传统 60/40 的两条腿在这里同时受伤。
四、核心实验:名义分散 vs 因子分散#
现在做本文最重要的对照。构造四个组合:
w_6040  = {"股票": 0.60, "国债": 0.40}
w_naive = {"股票": 0.35, "信用债": 0.25, "大宗商品": 0.15,
           "国债": 0.15, "黄金": 0.05, "现金": 0.05}   # 6 类资产,看起来很分散
w_eq    = 等权 1/7
w_fb = 按因子暴露求解(下面展开)w_naive 是重点:它持有 6 类资产、单资产最高 35%、权重 HHI 仅 0.235。任何只看权重表的人都会说它分散。
因子平衡组合的求解思路是在满仓约束下,逼近指定的因子暴露:
B = np.array([[beta_g[a] for a in assets],       # 2 x n 因子载荷矩阵
              [beta_i[a] for a in assets]])
A = np.vstack([B, np.ones(n)])                   # 加满仓约束行
t = np.array([target_g, target_i, 1.0])
W = np.diag([1.0, 1.0, 50.0])                    # 满仓约束加大权重
Q = A.T @ W @ A + ridge * np.eye(n)              # ridge 防止极端权重
w = np.linalg.solve(Q, A.T @ W @ t)
w = np.clip(w, -0.35, 1.0); w = w / w.sum()目标设为”增长敞口 = 60/40 的一半,通胀敞口 = 0”。ridge 项不是装饰——没有它,二元约束下 7 个自由度会解出极端的多空对冲,样本外必然崩。
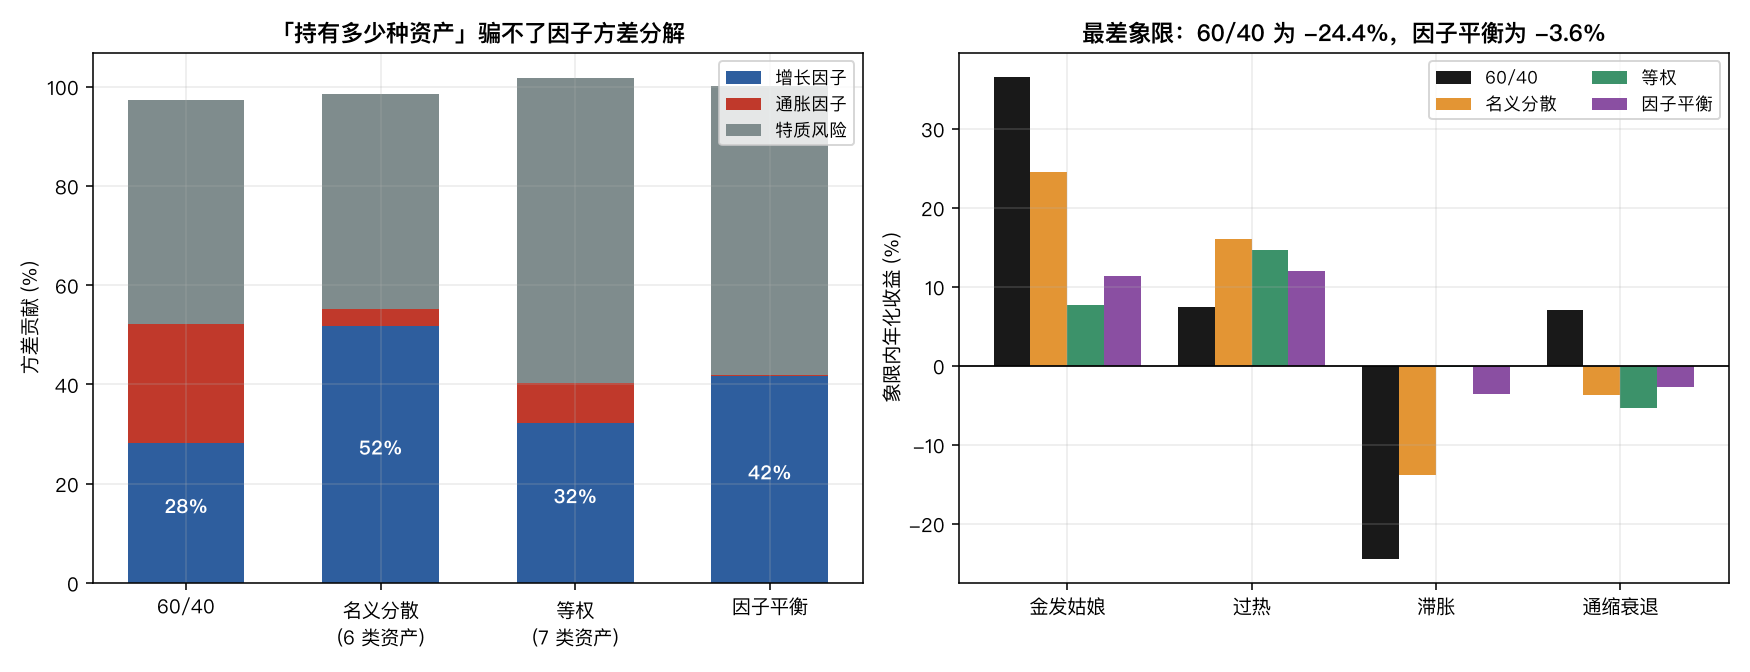
结果:
| 组合 | 增长方差占比 | 通胀方差占比 | 特质占比 | 增长 beta | 通胀 beta | 年化 | 波动 | Sharpe | 最大回撤 |
|---|---|---|---|---|---|---|---|---|---|
| 60/40 | 28.2% | 24.0% | 45.1% | +0.0150 | -0.0138 | 6.25% | 9.78% | 0.64 | -46.3% |
| 名义分散 (6 类) | 51.8% | 3.5% | 43.3% | +0.0146 | -0.0038 | 5.27% | 7.05% | 0.75 | -44.3% |
| 等权 (7 类) | 32.2% | 8.1% | 61.5% | +0.0069 | +0.0034 | 3.88% | 4.19% | 0.93 | -22.8% |
| 因子平衡 | 41.8% | 0.1% | 58.4% | +0.0074 | +0.0003 | 3.97% | 3.96% | 1.00 | -21.1% |
关键对照写清楚:
名义分散组合的权重 HHI 是 0.235(看着分散),但因子集中度 HHI 是 0.470(实际集中)——整整翻了一倍。 它多持有的那 4 类资产,大部分只是在重复押注同一个增长因子。这就是”因子拥挤”:你以为在买不同的东西,其实在反复买同一个风险。
而按象限拆开看,差别更刺眼:
| 组合 | 金发姑娘 | 过热 | 滞胀 | 通缩衰退 | 四象限极差 |
|---|---|---|---|---|---|
| 60/40 | +36.6% | +7.4% | -24.5% | +7.0% | 61.0pp |
| 名义分散 | +24.5% | +16.1% | -13.8% | -3.7% | 38.3pp |
| 等权 | +7.6% | +14.6% | -0.1% | -5.4% | 20.0pp |
| 因子平衡 | +11.4% | +12.0% | -3.6% | -2.8% | 15.6pp |
60/40 在滞胀里 -24.5%,因子平衡只有 -3.6%;四象限极差从 61.0 个百分点压缩到 15.6 个百分点。这才是资产配置真正该优化的东西——不是提高平均收益,是缩小”命运的方差”。
代价也必须说清楚:因子平衡在金发姑娘象限只有 +11.4%,而 60/40 有 +36.6%。它砍掉的不只是左尾,右尾也一起砍了。 这不是免费午餐,这是一次明确的偏好选择:你愿不愿意用”最好的年份少赚 25 个百分点”,换”最差的年份少亏 21 个百分点”。
五、样本外检验:这套东西经得住吗#
上面所有结果都用了全样本估的 beta——这是标准的样本内偏差。做个诚实的检验:用前 10 年估 beta 求权重,后 15 年持有不变。
SPLIT = 12 * 10
Bin = 用 RET[:SPLIT] 估计的因子载荷矩阵
w_fb_oos = solve_factor_balanced(target_g_in, 0.0)   # 只用前 10 年信息
oos = 后 15 年的实际表现| 组合(后 15 年) | 年化 | 波动 | Sharpe | 实现增长 beta | 实现通胀 beta |
|---|---|---|---|---|---|
| 因子平衡(前 10 年估权重) | 3.28% | 3.99% | 0.82 | +0.0070 | +0.0003 |
| 名义分散 | 3.89% | 7.78% | 0.50 | +0.0152 | -0.0035 |
| 60/40 | 4.28% | 10.43% | 0.41 | +0.0160 | -0.0127 |
两个要点:
- 样本外 Sharpe 0.82,是 60/40 的两倍。 从样本内 1.00 衰减到 0.82,衰减幅度可接受——因为这套方法没有”优化收益”,只是”配平风险”,参数少、过拟合空间小。
- 通胀 beta 目标真的实现了。 用前 10 年数据算出的权重,在后 15 年跑出 +0.0003 的实现通胀暴露,几乎正中靶心。因子暴露这个目标,比收益目标稳定得多——这才是这套框架能用的根本原因。
顺带说一句:本文合成数据里 beta 是常数,所以样本外稳定性被高估了。真实世界的 beta 会漂,下一节就是这盆冷水。
六、beta 稳定性:黄金的增长 beta 基本是噪声#
滚动 60 个月重估 beta,看它们有多稳:
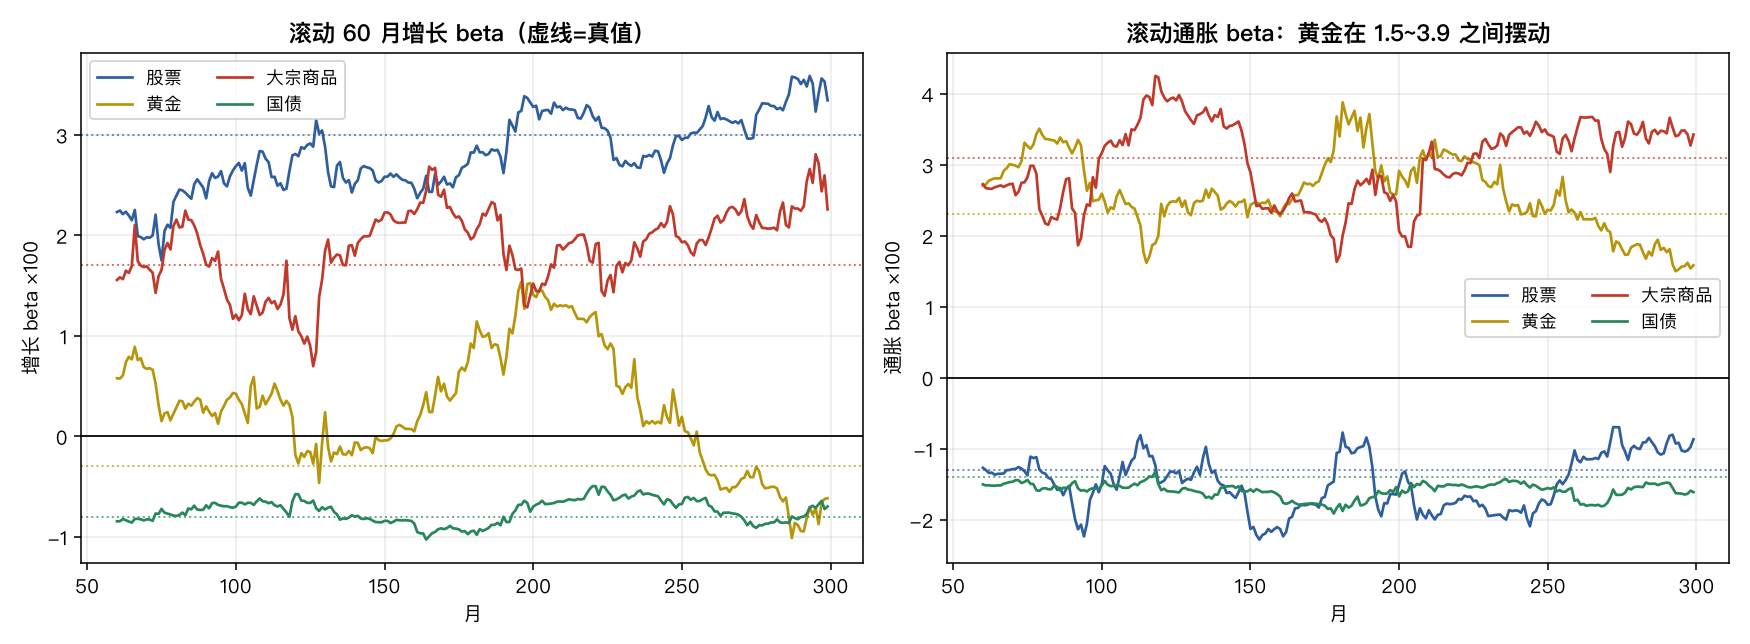
用”信噪比” = |真实 beta| / 滚动估计标准差 来量化:
| 资产 | 增长 beta 信噪比 | 通胀 beta 信噪比 |
|---|---|---|
| 国债 | 6.96 | 12.93 |
| 股票 | 7.90 | 3.38 |
| 大宗商品 | 4.43 | 5.48 |
| 黄金 | 0.51 | 4.48 |
黄金的增长 beta 信噪比只有 0.51——估计噪声是真实信号的两倍。 任何基于”黄金当前的增长 beta 是多少”做的择时判断,本质上是在读随机数。
这个结果的实践含义很具体:
- 强信噪比的暴露(国债通胀 beta 12.93、股票增长 beta 7.90)可以直接用于配权。
- 弱信噪比的暴露(黄金增长 beta 0.51)应当直接约束为零,而不是用滚动估计值。硬要估它,只会把噪声灌进优化器,被
np.linalg.solve忠实放大成极端权重。 - 这也解释了为什么第四节的 ridge 项必不可少:它在数学上就是”我不完全相信这些 beta”的显式表达。
三盆冷水#
第一,真实世界的 beta 不只是有噪声,它会真的变号。 本文合成数据里 beta 是常数,所以滚动估计的波动纯粹是估计误差。真实市场不是这样:股债相关性在 2000-2020 年是稳定负的(债券对冲股票),2022 年通胀冲击下变成正的,60/40 单年吃了双杀。股债负相关是一个通胀 regime 的产物,不是资产的物理属性。 用 2010 年代数据估出来的 beta 矩阵配权,在 2022 年会失效——不是因为方法错,是因为输入变了。任何严肃的实现都必须包含 beta 的 regime 检测或至少是滚动再校准。
第二,因子平衡不是收益增强,它是风险重新分配。 本文因子平衡组合年化 3.97%,低于 60/40 的 6.25%。Sharpe 更高(1.00 vs 0.64)不假,但如果你的负债端需要 6% 的名义回报,Sharpe 1.00 的 4% 组合帮不了你——你需要对它加杠杆,而加杠杆会引入本文完全没建模的东西:融资成本、追保风险、以及”波动率目标策略在真正的危机里被迫在最低点减仓”这个众所周知的问题。风险平价基金在 2020 年 3 月和 2022 年的表现,本质上都是这个坑。
第三,两因子模型的解释力有天花板,而残差不是白噪声。 本文单资产 R² 最高只有 0.659(国债)、最低 0.256(黄金),组合层面 R² 也就 0.39~0.57。剩下 40%~75% 的方差被归入”特质”,但它们里面藏着真实的风险来源:流动性冲击、信用利差、汇率、地缘政治。2008 年不是一次”增长意外向下”事件那么简单,它同时是一次流动性枯竭。把三维世界压成两维,压掉的那一维往往在最关键的时刻回来找你。 实务中通常需要至少加第三轴(流动性/风险偏好),代价是估计难度陡增。
落地清单#
- 先做诊断,再谈优化。 把现有组合回归到两轴上,看方差分解。如果某个因子占比超过 50%,你没有分散,你有一个伪装。
- 权重 HHI 和因子 HHI 一起看。 两者差距越大,“名义分散”的幻觉越严重(本文案例:0.235 vs 0.470)。
- 弱信噪比的 beta 直接约束为零,不要拿滚动估计值喂优化器。判断线:|beta| / 滚动 std < 1 就当它不存在。
- 优化目标是”最差象限”和”四象限极差”,不是 Sharpe。 后者会被样本期内恰好走强的因子误导。
- 求解一定要加 ridge 或权重上下限。 二元约束 + 七个自由度,不加约束必出极端多空解。
- beta 矩阵至少年度再校准,通胀 regime 切换时立即重估。
这套框架的价值不在于它能多赚钱——它多半会让你少赚。它的价值在于你终于知道自己在赌什么了。而在资产配置里,“知道自己在赌什么”这件事,本身就值一大笔钱。