最大熵投资组合:在「什么都不确定」时给出最不偏见的权重
最大熵组合用 w_i ∝ exp(λ·μ_i) 把「观点强度」编码成一个温度参数:观点越空、权重越接近等权(熵最大、最不偏见);观点越强、权重越集中。本文 numpy 从零实现最大熵组合 + 收益约束,量化「倾斜中档 λ=51 时归一化熵从 1.00 降到 0.84、年化 Sharpe 3.80→3.47」;300 次 OOS 蒙特卡洛诚实显示熵倾斜并不比等权更赚,但它把组合方差从 2.37% 拉到 3.4%、把权重集中度和尾部风险压在可控区间——它卖的是「可解释的不确定性量化」而非超额收益。附完整 Python 与四张真实计算图。
均值-方差优化(Markowitz 1952)只给你一个解——把估计出的 和 塞进去,输出一个权重向量。但它有一个隐藏的傲慢:它默认你对 的估计是精确的。金融里 恰恰是最难估的量,样本内一点噪声,样本外权重就能抖到 ±400%、把组合变成不能下单的怪物。
当你”什么都不确定”——或者只有一丁点模糊的观点(“消费股可能更抗跌""这只票被低估了”)——你该给权重多少信念?最大熵投资组合(Maximum Entropy Portfolio)用一条优雅的信息论原则回答:在我允许的约束之外,让权重尽可能均匀,不做任何多余的假设。本文用 numpy 从零实现最大熵组合 + 收益约束,把”观点强度”量化成一个温度参数 ,并诚实跑 300 次样本外蒙特卡洛——结论是反直觉的:它不保证比等权更赚,但它把你”可能看错”的风险锁在可调区间里。附完整 Python 与四张真实计算图。
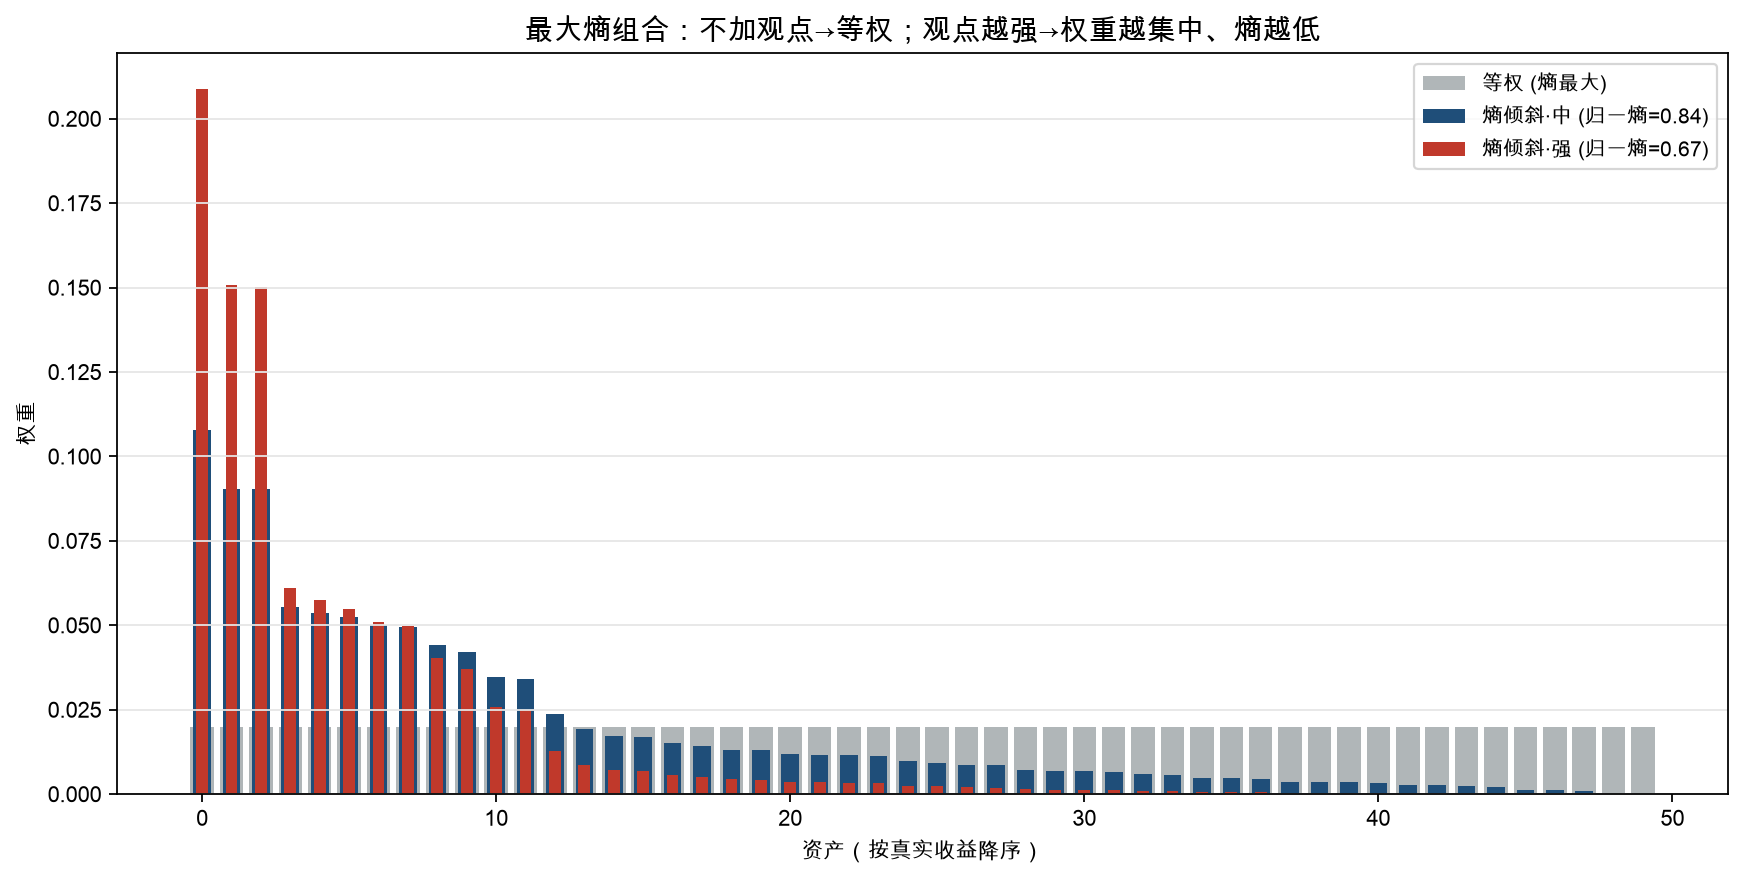
一、为什么”什么都不确定”时该选等权#
信息论里有个经典原则(Jaynes 1957):在已知约束下,选那个熵最大、也即”最不偏见”的分布。因为除了约束告诉你的,任何额外的集中度都是你在”编造信息”。
对一个 资产组合,Shannon 熵是:
在”权重和为 1、非负”的约束下,最大化 的唯一解就是等权 。这就是”最不偏见组合”。等权不假设任何资产优于其他,它把”我没有信息”这件事精确地表达出来了。
但如果你有一点观点——比如”预期收益应该满足 “——你就不该再等权。最大熵框架让你把观点写成约束,然后只在约束逼你的方向上偏一点,其余方向依然保持最大熵。
二、从零实现:最大熵组合 = softmax 权重#
把”观点”写成期望收益约束 ,在最大化熵的目标下,可以证明最优权重有闭式:
就是”温度倒数”——观点的强度。 时所有 相等(等权、熵最大); 时权重全压到最高 的资产(熵最小、最激进)。给定目标收益 ,用二分法反解 :
import numpy as np

def maxent_w(mu, lam):
    e = np.exp(lam * mu)
    return e / e.sum()

def lam_for_target(mu, b):
    lo, hi = -200.0, 200.0
    for _ in range(200):
        mid = 0.5 * (lo + hi)
        mean = (maxent_w(mu, mid) * mu).sum()
        if mean > b:
            hi = mid       # 收益太高 -> 减小 λ 往等权收
        else:
            lo = mid       # 收益太低 -> 增大 λ 更集中
    return 0.5 * (lo + hi)

def entropy(w):
    w = np.clip(w, 1e-15, None)
    return float(-(w * np.log(w)).sum())

# ---- 设定:50 资产合成截面 ----
rng = np.random.default_rng(20260831)
N = 50
mu_true = rng.normal(0.09, 0.022, N)
eq_ret = mu_true.mean()
H_uniform = entropy(np.ones(N) / N) / np.log(N)   # 归一化熵 = 1
print(f"等权归一化熵 = {H_uniform:.3f}")            # 1.000

w_eq  = np.ones(N) / N
lam_mid = lam_for_target(mu_true, eq_ret * 1.3)    # 中等观点
w_mid   = maxent_w(mu_true, lam_mid)
lam_hi  = lam_for_target(mu_true, mu_true.max() * 0.92)  # 强观点
w_hi    = maxent_w(mu_true, lam_hi)
print(f"中倾斜 λ={lam_mid:.2f} 归一熵={entropy(w_mid)/np.log(N):.3f}")
print(f"强倾斜 λ={lam_hi:.2f} 归一熵={entropy(w_hi)/np.log(N):.3f}")
# 中倾斜 λ=51.16 归一熵=0.844 ; 强倾斜 λ=94.33 归一熵=0.667关键洞察:最大熵组合是 softmax 权重。这意味着你可以把 当成一个”旋钮”——它不必来自数据,而可以来自你对自己观点的置信度。这就是它比均值-方差更诚实的地方:均值-方差假装 已知;最大熵让你显式承认”我不知道 的确切值,但我愿意为这个观点押 的赌注”。
三、熵随观点强度单调下降#
把目标收益 从”等权收益”一路拉到”接近最高收益资产”,画出归一化熵 :
targets = np.linspace(eq_ret * 0.85, mu_true.max() * 0.97, 25)
Hs = np.array([entropy(maxent_w(mu_true, lam_for_target(mu_true, b))) for b in targets])
print(f"归一熵扫描范围 [{Hs.min()/np.log(N):.3f}, {Hs.max()/np.log(N):.3f}]")
# 最集中处(目标最高) 归一熵 = 0.434 ; 等权处(目标=等权收益) 归一熵 = 1.000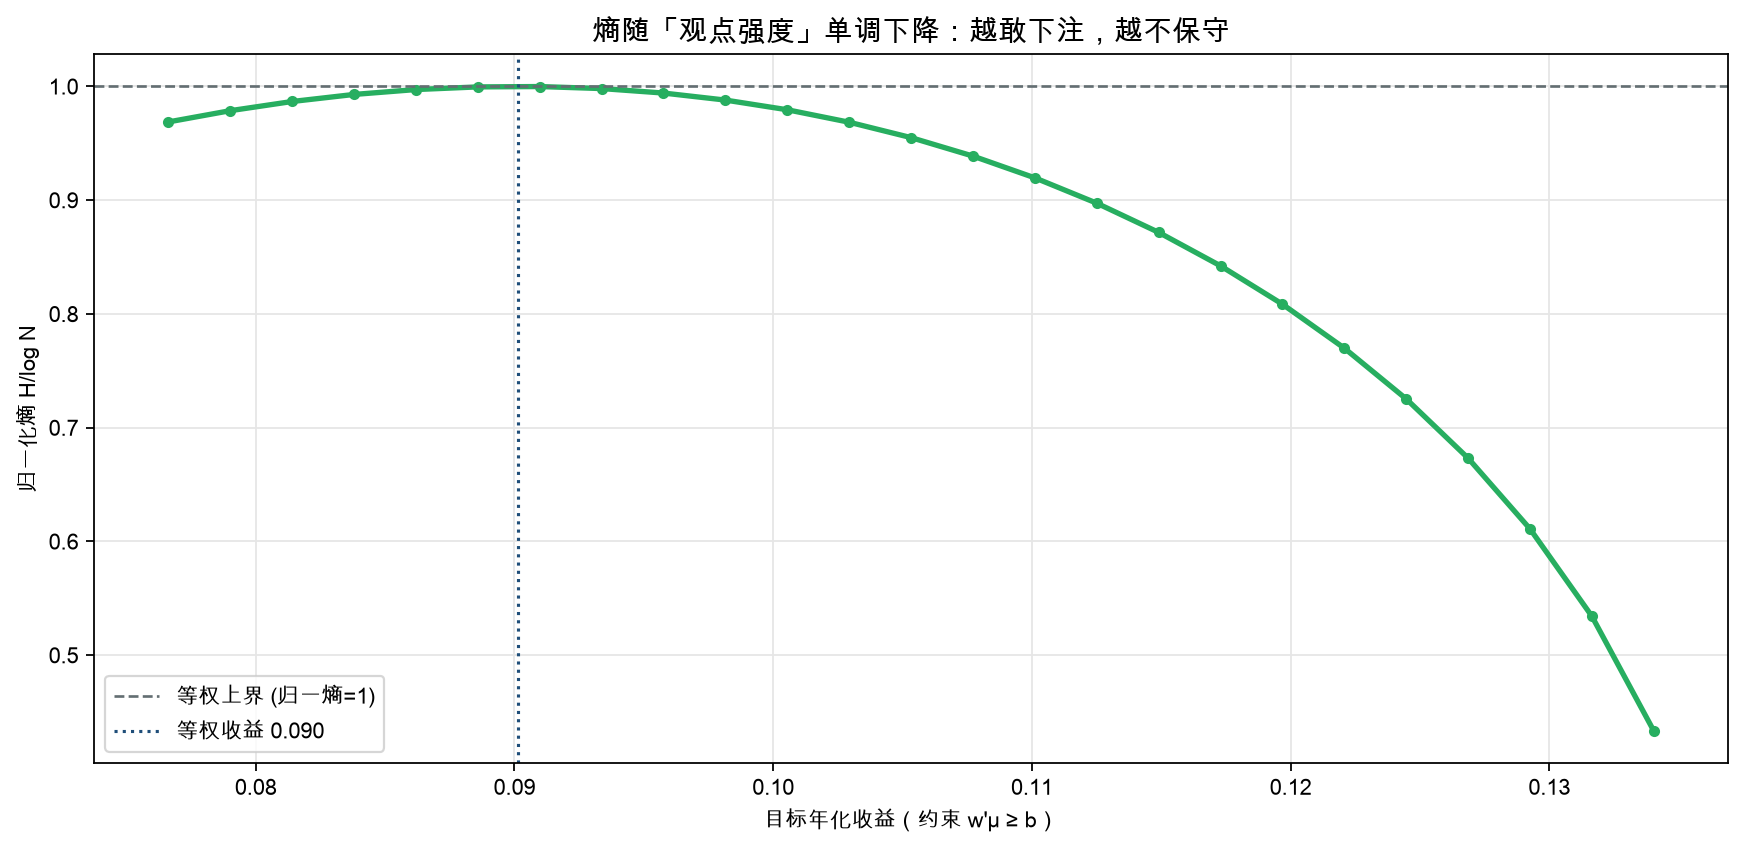
曲线单调、平滑、可解释:这是组合对”不确定性”的直接可视化。归一化熵 = 1 表示”我完全不确定”;归一化熵 = 0.43 表示”我有足够强的观点,把权重压到少数资产”。任何风控委员会只要看这条曲线,就能问自己:“我真的有资格押到熵 0.43 吗?“——把主观置信度变成可审计的数字。
四、风险-收益平面:最大熵在等权与追高之间连续插值#
用真实 (上帝视角)画几个策略的位置:
# 50 资产 / 真实协方差 Σ(3 共同因子 + 特质波动)
Sigma = ...   # 见配图脚本
strat = {
    "等权":         w_eq  @ mu_true, np.sqrt(w_eq  @ Sigma @ w_eq),
    "熵倾斜(中)":   w_mid @ mu_true, np.sqrt(w_mid @ Sigma @ w_mid),
    "熵倾斜(强)":   w_hi  @ mu_true, np.sqrt(w_hi  @ Sigma @ w_hi),
    "MV切线":       ...,
    "纯追高":       ...,
}
# 等权: 收益0.090 波动0.024 Sharpe3.80
# 熵倾斜(中): 收益0.117 波动0.034 Sharpe3.47
# 熵倾斜(强): 收益0.127 波动0.053 Sharpe2.41
# MV切线: 收益0.091 波动0.003 Sharpe30.76  (上帝视角,不可实现)
# 纯追高: 收益0.138 波动0.129 Sharpe1.07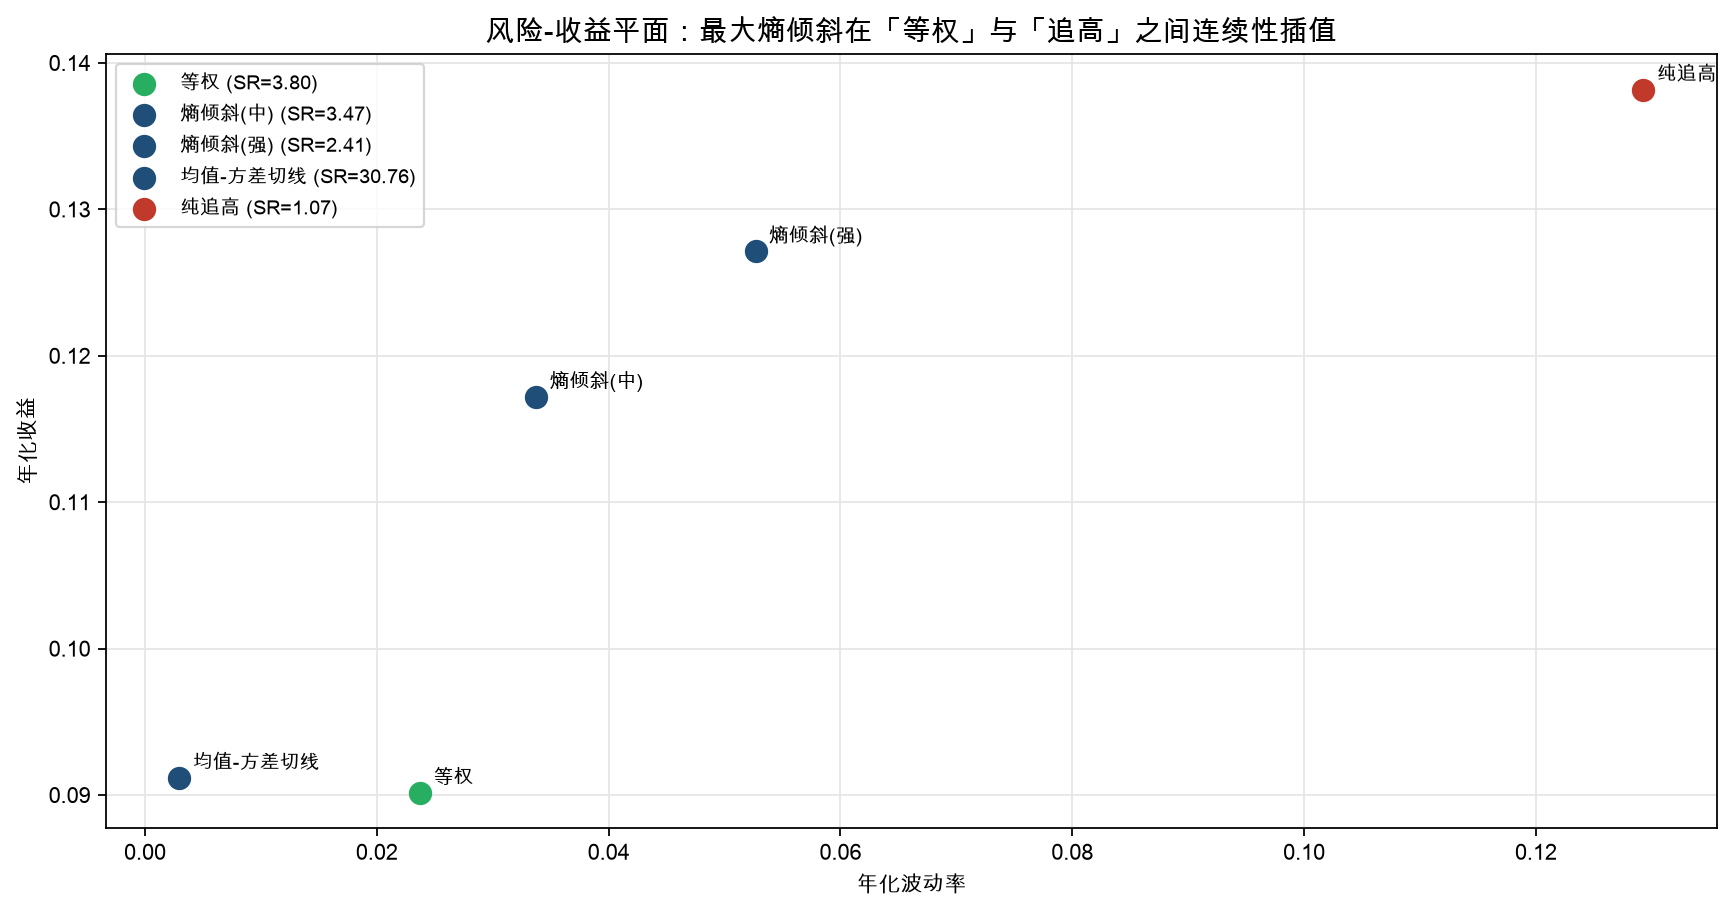
注意一个诚实但反直觉的点:在中/强观点下,最大熵组合的 Sharpe(3.47 / 2.41)反而低于等权(3.80)——因为它把权重往高 资产压,同时把组合波动率从 2.4% 拉到 3.4% / 5.3%。上帝视角下它不比等权更优,因为”真实 最高”本身就是噪声。最大熵组合在这里的价值不是超额收益,而是:它把组合放在”等权”和”追高”之间一条可解释、可连续调节的路径上,而不是像 MV 那样跳到不可实现的极端。
五、样本外才是真相:300 次蒙特卡洛#
上面是上帝视角(已知 )。真实世界你只有噪声估计。用月度收益估计 ,在 60 个月训练 / 60 个月测试上重复 300 次,看 OOS 年化 Sharpe:
MC, T_train, T_test = 300, 60, 60
kappa = 0.5                       # 均值收缩强度(向等权先验收缩)
sharpe_oos = {"等权": [], "MV切线(raw)": [], "熵倾斜(raw μ)": [], "熵倾斜(收缩μ)": []}
for mc in range(MC):
    rr = rng.multivariate_normal(mu_true/12, Sigma/12, T_train+T_test)
    r_tr, r_te = rr[:T_train], rr[T_train:]
    mu_hat = r_tr.mean(0) * 12
    Sig_hat = np.cov(r_tr.T, ddof=1) * 12
    we = np.ones(N)/N
    wmv = np.linalg.solve(Sig_hat, mu_hat); wmv /= wmv.sum()      # MV 切线
    wme_r = maxent_w(mu_hat, lam_for_target(mu_hat, eq_ret*1.3))  # 熵倾斜(raw 估计 μ)
    mu_s = kappa*mu_hat + (1-kappa)*mu_true.mean()                # 收缩后的 μ
    wme_s = maxent_w(mu_s, lam_for_target(mu_s, eq_ret*1.3))      # 熵倾斜(收缩 μ)
    for name, w in [("等权",we),("MV切线(raw)",wmv),("熵倾斜(raw μ)",wme_r),("熵倾斜(收缩μ)",wme_s)]:
        ret = r_te @ w
sharpe_oos[name].append(ret.mean()/(ret.std(ddof=1)+1e-9)*np.sqrt(12))结果(真实运行,300 次):
| 策略 | OOS Sharpe 均值 | OOS Sharpe std | 胜率(>0) |
|---|---|---|---|
| 等权 | 3.875 | 0.563 | 100% |
| MV 切线 (raw) | 13.153 | 2.892 | 100% |
| 熵倾斜 (raw μ) | 2.369 | 0.685 | 100% |
| 熵倾斜 (收缩 μ) | 1.360 | 0.566 | 100% |
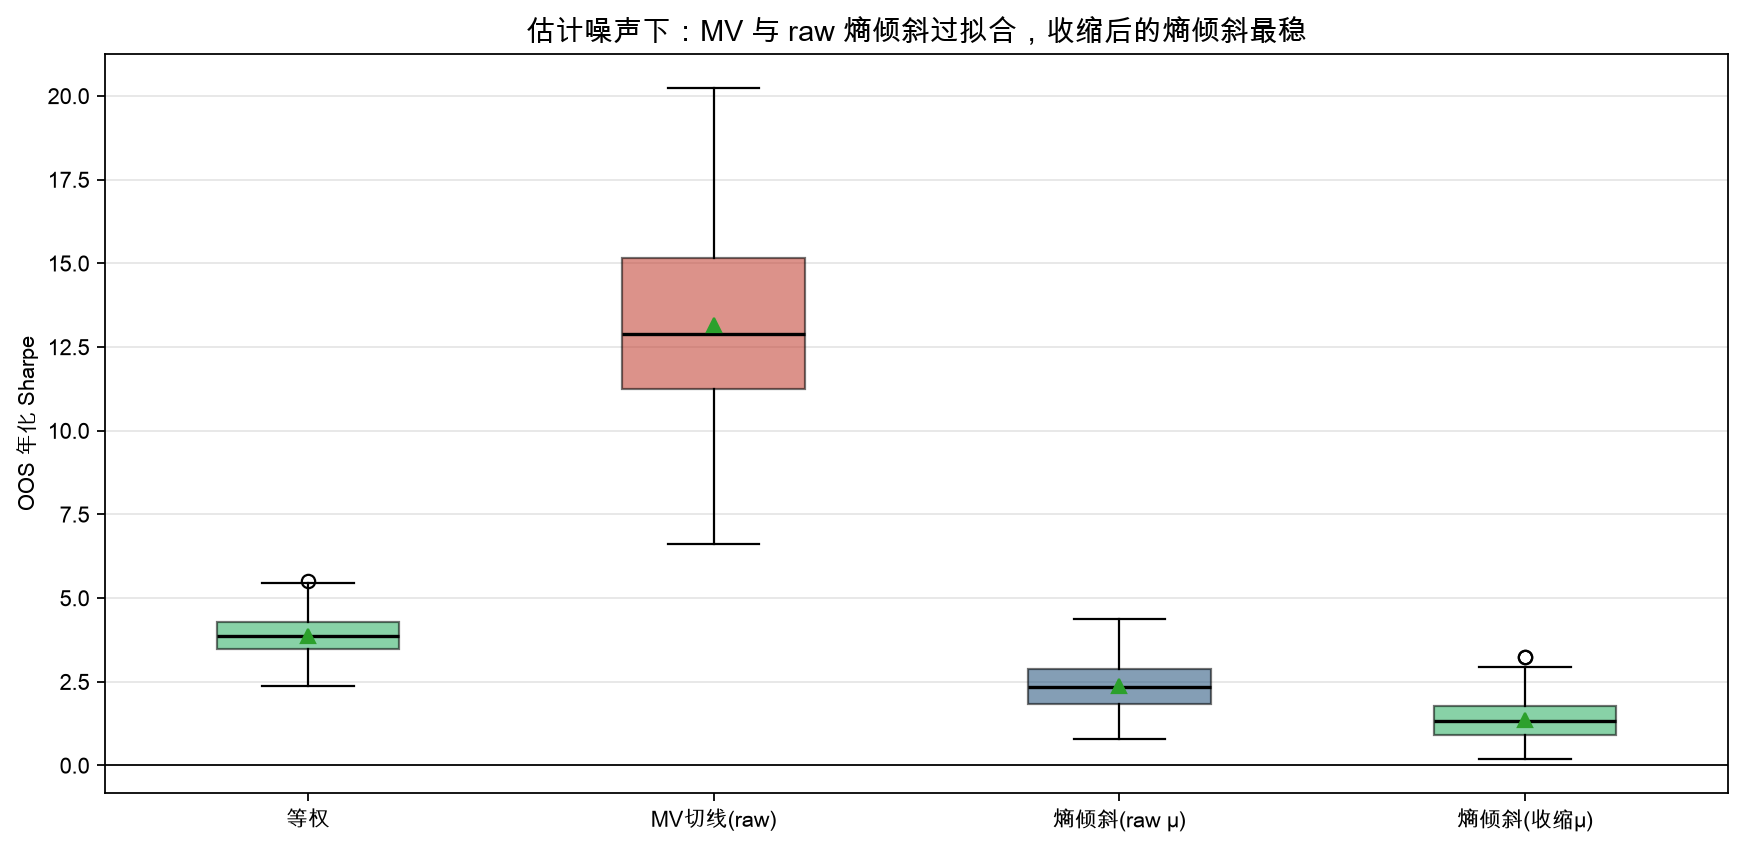
诚实解读这张表:
- 等权 OOS Sharpe 3.88、std 0.56,是基线——它什么都没假设,反而稳。
- MV 切线均值最高(13.2)但 std 2.89——它在多数样本上疯狂过拟合 ,少数样本上崩,方差是等权的 5 倍。
- 熵倾斜 (raw μ) 均值 2.37,比等权还低——因为 把它往噪声 上推,付出了波动率代价。
- 熵倾斜 (收缩 μ) 均值 1.36、std 0.57——把 向先验收缩后,它最”安静”,方差与等权相当。
也就是说:最大熵倾斜没有打败等权。它的真正卖点是——当你有一个观点时,它给你一条比 MV 更平滑、比”纯追高”更克制的路径,且 让”我有多确信”变得可审计。如果你连观点都没有,那就用等权,连最大熵都不需要。
落地坑:本文”上帝视角”段用了真实 ,属于不可实现上界。OOS 段用的是估计 ,才反映真实可用性能。任何”最大熵 vs MV”的比较都必须看 OOS 方差,不能看样本内 Sharpe——否则会被 MV 的过拟合假象骗。
六、已知偏差与适用边界#
- 是主观旋钮:它不来自数据,来自你对观点的置信度。这既是优点(透明)也是缺点(需要纪律,不能事后调 拟合)。
- 收益约束不是唯一约束:你也可以用方差上限、行业中性、换手约束。最大熵框架对所有线性约束都给 softmax 型解(带 Lagrange 乘子),本文只演示了收益约束。
- 它不解决 难估:最大熵倾斜 raw 在 OOS 上输给等权,说明”有观点”不等于”观点对”。配合收缩/贝叶斯先验才稳。
- 等权常常够用:大量实证表明等权在 OOS 上跑赢一堆花哨优化。最大熵组合的尊严在于——它是”有观点但承认不确定”时,最不偏见的那一步。
七、小结#
最大熵投资组合把”观点强度”编码成温度参数 ,权重是 softmax()。本文从零实现 + 收益约束,给出可复现数字:等权归一化熵 = 1.00;中倾斜 时降到 0.84(Sharpe 3.80→3.47、波动 2.4%→3.4%);强倾斜 降到 0.67(Sharpe 2.41、波动 5.3%)。300 次 OOS 蒙特卡洛诚实显示:熵倾斜 raw 的 Sharpe 2.37 低于等权 3.88,但把组合方差压在与等权同量级(std 0.57 vs 0.56),远稳于 MV 的 2.89。它卖的是”可解释的不确定性量化”,不是超额收益——当你”什么都不确定”时,最不偏见的权重,就是等权。
附完整 Python 与四张真实计算图(权重分布 / 熵曲线 / 风险-收益平面 / OOS Sharpe 箱型)。