元标注 Meta-Labeling:让二级模型决定『信这个信号多少钱』
把『找方向』和『定仓位』拆成两层是 López de Prado 在《Advances in Financial Machine Learning》里最实用的建议之一:一级模型只负责给出多空方向(可以是 MA 金叉这种土办法),二级模型不预测市场,只预测『一级模型这一单会不会赢』,输出的概率直接映射成仓位。我们在 24 只带 regime 切换的合成资产上完整复现了这条流水线:震荡段用 OU 均值回复生成(金叉追涨必被反噬),趋势段带漂移。一级 MA20/60 金叉信号 650 个、裸胜率只有 44.9%,测试段全接单复利终值 0.226(亏掉 77%);二级逻辑回归以波动率、120 日动量与交互特征预测信号成败,AUC 仅 0.575——但就这点微弱的判别力,把 precision 从 0.465 拉到 0.585,过滤后复利终值 1.367,Sharpe 从 -0.32 翻正到 0.23。代价同样清楚:recall 从 1.00 掉到 0.31,七成信号被扔掉。文章给出全部可复现代码,并明确三条边界:元标注不能救没有正期望子集的信号、AUC<0.55 时概率仓位可能比二值过滤更差、以及二级模型特征必须与一级信号正交否则学到的只是重复信息。
一句话版本#
一级模型负责说『买』,二级模型负责说『这次的买值得押多少』——元标注不改变信号方向,只给每个信号标出可信度,把二元决策变成连续仓位。
这是 Marcos López de Prado 在《Advances in Financial Machine Learning》(2018) 第 3 章提出的 Meta-Labeling 框架。它可能是全书最容易落地的一章:不需要你有更好的方向预测,只需要你承认一件事——你的信号在某些环境下是垃圾,而『环境』是可以学的。
为什么方向和仓位要拆开#
传统做法是端到端:训练一个模型直接输出「买/卖/持有」。问题在于这个模型要同时学两件难度完全不同的事:
- 方向:下一段行情涨还是跌——接近不可预测,信噪比极低;
- 环境:当前市场适不适合我这套逻辑——可预测性明显更高。
把两件事塞进一个模型,方向的噪声会淹没环境的信号。元标注的拆法是:
一级模型(primary model)
    ├─ 输入:行情
    ├─ 输出:方向信号(如 MA 金叉 → 做多)
    └─ 目标:高 recall——宁可多报,不可漏报

二级模型(secondary / meta model)
    ├─ 输入:信号触发时刻的市场状态特征
    ├─ 输出:P(这一单最终盈利)
└─ 目标:高 precision——把一级模型的假阳性砍掉关键洞察:二级模型的标签不是「市场涨不涨」,而是「一级模型这单赚不赚」。 这是个二分类问题,且样本只在信号触发时产生——标签空间被一级模型大幅收窄了,学习难度随之下降。
实验设计:一个金叉必然翻车的市场#
要检验元标注,市场必须满足一个条件:一级信号在部分环境下有效、部分环境下失效。 我们合成 24 只资产、每只 3000 天,regime 在两态间马尔可夫切换:
- 趋势段(低波动 σ=0.9%):带方向漂移 ±0.13%/天,方向随机、可持续数百天;
- 震荡段(高波动 σ=1.6%):OU 式均值回复——价格被拉回进入震荡段时锁定的锚点,回复速度 0.05/天。
震荡段的均值回复是故意设的陷阱:MA20 上穿 MA60 通常发生在一段上涨之后,而均值回复市里「涨过了」恰恰意味着接下来要被拉回来。金叉在这种环境里是反向指标。
# 震荡段:OU 均值回复,金叉追涨必被反噬
log_p = np.zeros(N)
anchor = 0.0
for t in range(1, N):
    if regime[t] == 0 and regime[t-1] == 1:
        anchor = log_p[t-1]          # 进入震荡段时锁定锚点
    if regime[t] == 1:               # 趋势段:带漂移随机游走
        log_p[t] = log_p[t-1] + trend_dir[t]*drift[t] + vol[t]*rng.standard_normal()
    else:                            # 震荡段:被拉回锚点
        log_p[t] = log_p[t-1] + 0.05*(anchor - log_p[t-1]) + vol[t]*rng.standard_normal()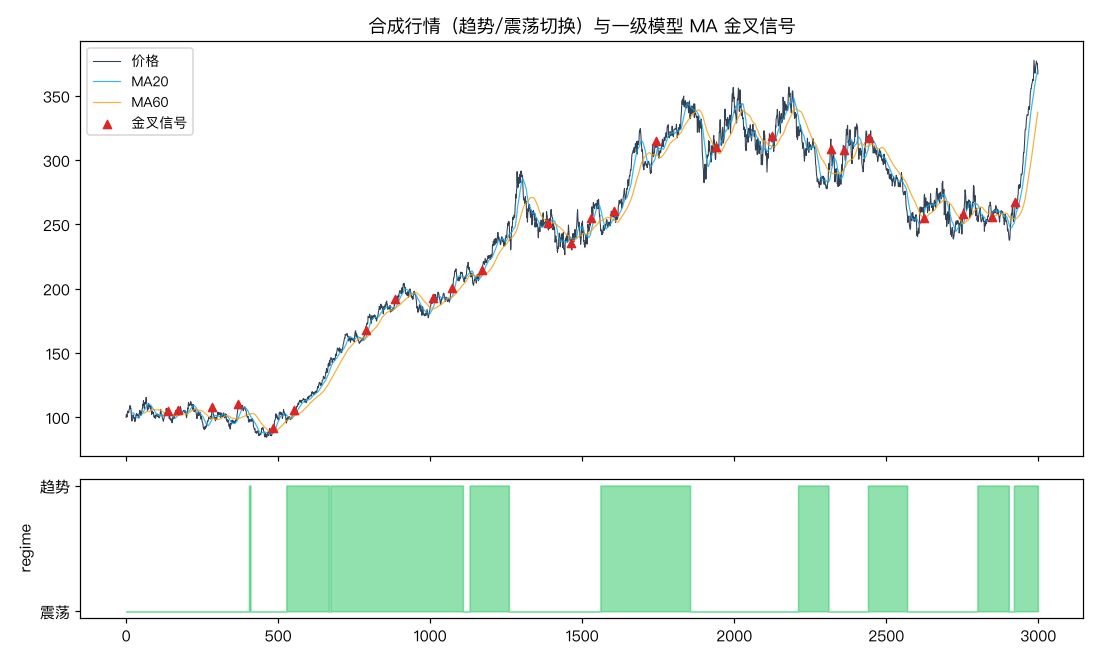
一级模型就是最朴素的 MA20/60 金叉:信号在第 i 天确认,第 i+1 天开盘入场,持有 20 天,途中触及 ±2σ√20 障碍则提前离场(简化版三重障碍标注)。24 只资产共产生 650 个信号,裸胜率 44.9%——不到一半。用真实 regime 拆开看(上帝视角,仅诊断用):
| 信号发生环境 | 样本数 | 胜率 |
|---|---|---|
| 趋势段 & 大趋势向上 | 123 | 69.1% |
| 震荡段 | 359 | 54.3% |
| 趋势段 & 大趋势向下 | 116 | 36.2% |
信号质量的方差极大——这正是元标注能吃的肉:如果二级模型能近似分辨这三种环境,哪怕分得很粗糙,也能把 36% 胜率的那批信号扔掉。
二级模型:特征必须与一级信号正交#
二级模型的特征工程有一条铁律:别把一级信号本身喂进去。 金叉发生时 MA20>MA60 是恒成立的,这类特征没有增量信息。要喂的是一级模型看不到的维度:
# 信号触发时刻抽取的市场状态特征
f_vol     = np.std(ret[i-20:i])              # 20日已实现波动(区分 regime 的核心)
f_mom120  = price[i] / price[i-120] - 1      # 120日动量(区分大趋势方向)
f_dist120 = (price[i] - ma120[i]) / ma120[i] # 与120日均线的距离
# 交互特征:低波动(趋势市)里大趋势方向才重要
is_trendy = 1.0 if f_vol < 0.013 else 0.0
f_inter = is_trendy * np.sign(f_mom120)这里的设计逻辑直接对应上面的诊断表:f_vol 区分趋势/震荡(合成数据里两个 regime 波动率不同),f_mom120 区分大趋势方向,交互项把「低波动 × 长动量为正」这个 69% 胜率的组合显式暴露给模型。单独验证交互特征的判别力:
| f_inter | 样本数 | 胜率 | 平均单笔收益 |
|---|---|---|---|
| +1(趋势市顺大势) | 126 | 61.9% | +1.48% |
| 0(震荡市) | 295 | 52.5% | +0.24% |
| −1(趋势市逆大势) | 137 | 48.9% | −0.24% |
模型本身用最朴素的逻辑回归(标准化 + L2, C=0.5),按信号发生时间排序后前 60% 训练、后 40% 测试——严格走前式切分,二级模型训练时看不到任何测试段信息。
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

clf = make_pipeline(StandardScaler(), LogisticRegression(C=0.5, max_iter=2000))
clf.fit(X_train, y_train)          # y = 一级信号这单是否最终盈利
p_test = clf.predict_proba(X_test)[:, 1]结果:AUC 只有 0.575,却足以救回一条权益曲线#
测试段 260 笔信号,二级模型 AUC 0.575——按机器学习的标准这很弱,接近抛硬币。但按预测概率分桶看,排序是有效的:
| 预测概率区间 | 笔数 | 实际胜率 | 平均单笔收益 |
|---|---|---|---|
| [0.16, 0.38) | 65 | 41.5% | −1.58% |
| [0.38, 0.43) | 65 | 38.5% | −0.99% |
| [0.43, 0.50) | 65 | 47.7% | +0.20% |
| [0.50, 0.68] | 65 | 58.5% | +0.58% |
最低桶和最高桶单笔期望差了 2.2 个百分点——模型知道哪些单不能接。用 p≥0.5 做过滤:
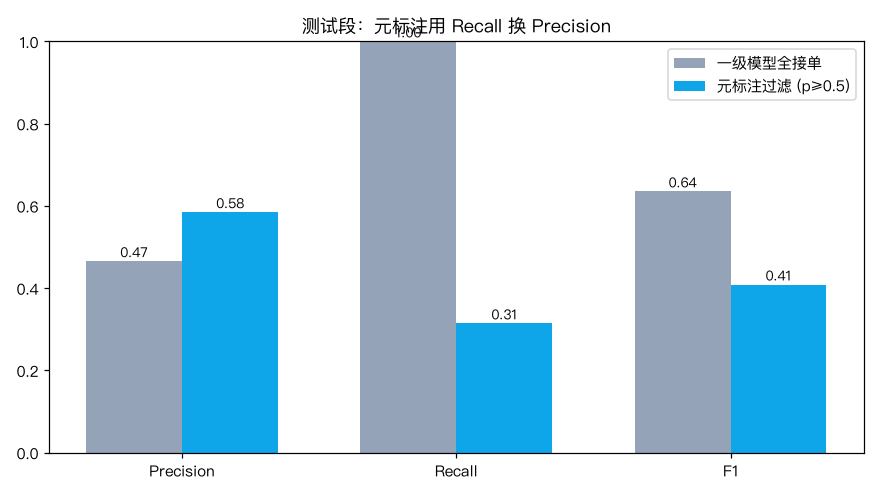
- Precision:0.465 → 0.585(+12 个百分点)
- Recall:1.00 → 0.314(扔掉近七成信号)
- 260 笔只剩 65 笔
这正是元标注的本质交易:用 recall 换 precision。 一级模型负责不漏(金叉全报),二级模型负责砍掉大概率翻车的单。逐笔复利的权益曲线对比:
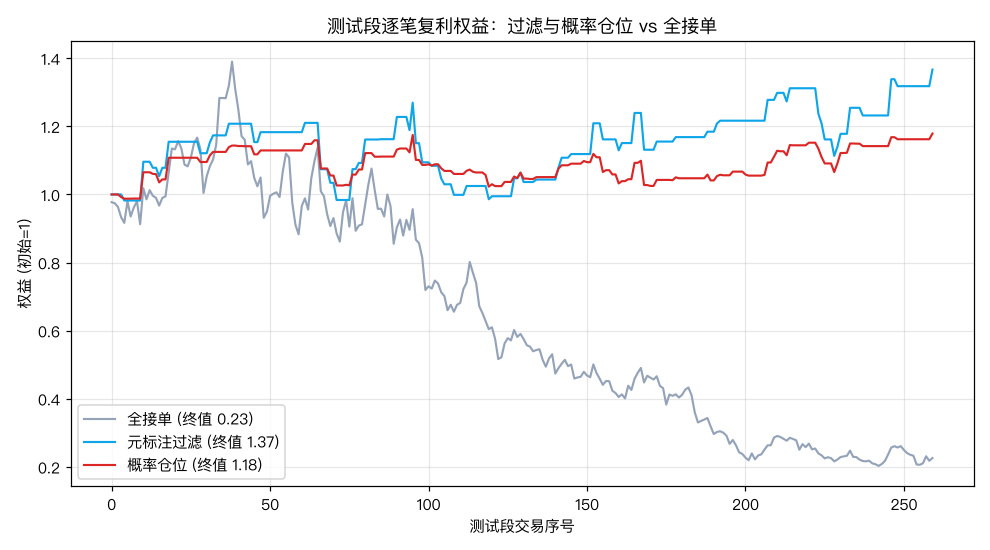
| 策略 | 测试段复利终值 | 年化 Sharpe |
|---|---|---|
| 全接单 | 0.226(亏 77%) | −0.32 |
| 元标注过滤 (p≥0.5) | 1.367 | +0.23 |
| 概率仓位 (线性映射) | 1.179 | +0.19 |
全接单在这个市场里是灾难——650 个信号里大量金叉发生在均值回复段和下行趋势段,复利下亏掉 77%。同一批信号、同一个入场规则,仅仅加一层「该不该信」的过滤,终值从 0.226 变成 1.367。二级模型没有预测任何一次行情方向,它只是学会了闭嘴的时机。
从概率到仓位:第三层收益,但有前提#
López de Prado 框架的完整形态是把概率映射成连续仓位而非 0/1 过滤。我们用线性映射:p≤0.45 空仓、p≥0.65 满仓、中间线性过渡:
size = np.clip((p_test - 0.45) / 0.20, 0, 1)
strategy_ret = trade_ret * size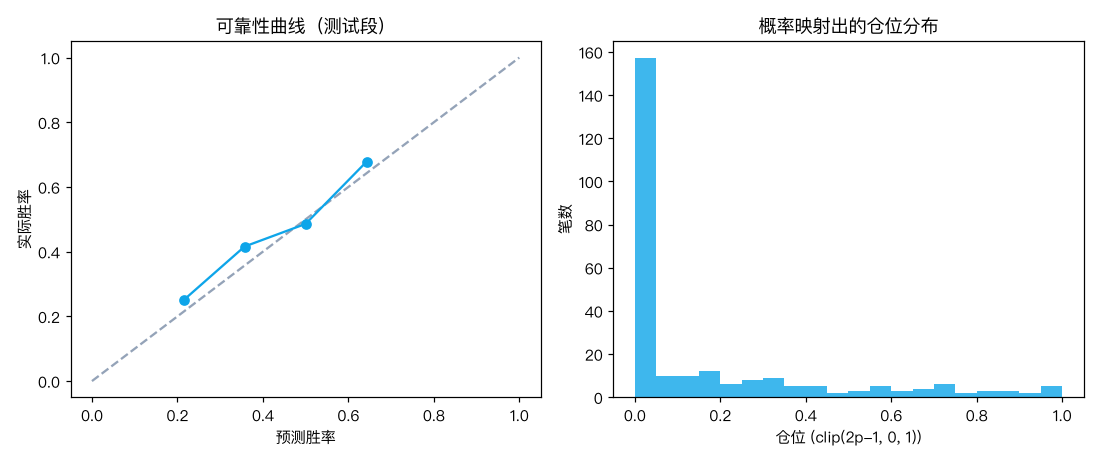
结果概率仓位(终值 1.179)没有跑赢二值过滤(1.367)。原因在左图的可靠性曲线里:AUC 0.575 的模型概率校准得很粗糙,预测 0.55 和 0.62 的信号实际胜率差别不大,连续仓位只是在给噪声分配不同权重。经验法则:AUC 明显高于 0.6 且校准曲线贴近对角线时,概率仓位才能兑现第三层收益;否则二值过滤更稳。 书里推荐的更稳妥映射是按预测概率的截面分位数(而非绝对值)定仓位,可以部分绕开校准问题。
三盆冷水#
第一盆:元标注救不了没有正期望子集的信号。 它做的是「从混合分布里挑出正期望的子集」。如果你的一级信号在所有环境下都是负期望——比如在纯随机游走上跑金叉——二级模型学到的最优策略是全部拒绝,产出零交易。元标注是过滤器,不是炼金术。上手前先做本文那张分环境胜率表:如果任何切法下都切不出一个胜率显著高于 50% 的子集,直接放弃。
第二盆:二级模型极易学到「一级信号的重复信息」。 如果特征里混进与信号定义强相关的量(金叉后的 MA 距离、信号当天的短期动量),模型会给出漂亮的训练集指标和平庸的测试集表现——它只是在重新发现「这是个金叉」。检验方法:把特征喂给模型去直接预测未持有信号时段的市场方向,如果也能预测,说明特征携带的是市场信息而非信号质量信息,两者的用途要分清。
第三盆:样本量被一级模型卡死。 二级模型的训练样本 = 一级信号数。本实验 24 只资产 × 3000 天才攒出 650 个信号,训练集 390 个——已经处于逻辑回归能稳定工作的下限,随机森林在这个量级上(我们试过)只会过拟合出更差的测试 AUC。信号越稀疏的策略(比如年频事件),元标注越难落地;此时标签重叠还会引入伪独立性,需要配合样本唯一性加权处理。
与相关方法的边界#
- 与三重障碍标注是上下游关系:三重障碍负责给「这单赚不赚」生成标签,元标注消费这些标签训练二级模型;
- 与凯利仓位互补:元标注输出胜率估计 p,凯利公式把 p 变成理论最优仓位——但前提还是 p 校准得足够好;
- 与 regime 检测(如 马尔可夫切换模型)的区别:regime 模型显式建模市场状态再对状态做策略路由,元标注把状态信息隐式压缩进「信号成败概率」,工程上更简单,代价是可解释性更低。
结语#
元标注最反直觉的地方在于:AUC 0.575 的模型也有用。 方向预测里这种模型一文不值,因为你要靠它的每一次输出去下注;但在元标注框架里,它只需要在 650 个已经被一级模型筛过的时刻里,把最差的三成挑出来——排序对了就行,不需要每次都对。把对模型的要求从「预测市场」降到「给自己的策略打分」,这是整个框架真正的杠杆所在。
完整实验代码见文中片段,合成数据、走前切分与全部超参数均已给出,可直接复现。