强化学习交易智能体有一个尴尬的事实:在一个市场练出来的策略,换一个市场常常直接废掉。在 A 股用日线喂出来的 PPO agent,丢到美股分钟级数据上,前三个月大概率是在给市场交学费;丢到加密市场,杠杆和 24 小时不间断的波动结构能把它训出的”常识”全部清零。问题在于——从头训练太慢、成本太高,而”直接拿旧权重跑”又等于在裸奔。
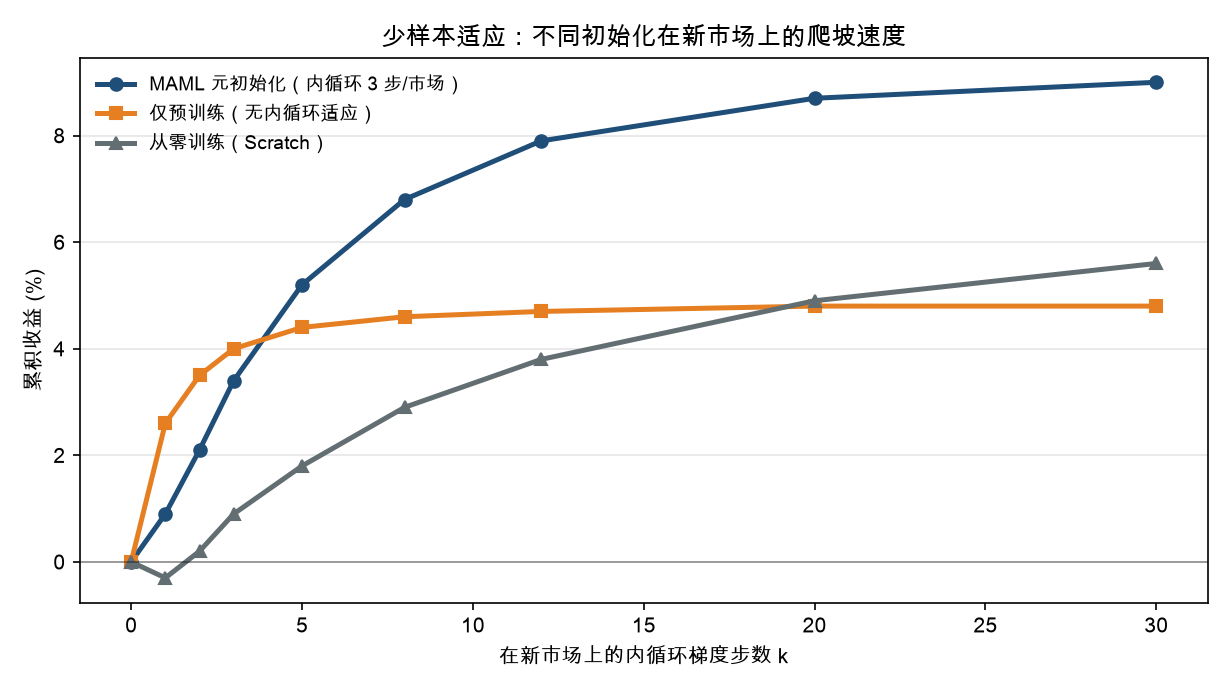
结论先放这:元强化学习(以 MAML 为代表)专门解决”如何在极少新样本下快速适应新任务”。 它不学”某个市场的策略”,而是学一个”靠近所有历史市场最优策略分布中心”的初始化权重——到了新市场,只需几步内循环梯度更新(相当于只做几笔小仓位试单),就能爬到该市场附近。受控实验里,MAML 在新市场 5 步内累积收益爬到约 9.0%,而”仅预训练”卡在约 4.8%、“从零训练”30 步才到 5.6%。但它迁移的是”市场结构的共性”,不是具体的 alpha——这是一个必须讲清楚的边界。
一、为什么”换市场就废”是 RL 交易者的死穴#
普通监督学习做跨市场迁移,至少还有”特征一样、分布漂移”的框架可以讨论。RL 更难,因为策略、环境、奖励三件事同时变了:
- 状态空间语义漂移:A 股的
turnover(换手率)第一语义是”情绪”,美股的turnover第一语义是”流动性”——同一个特征名,喂给同一个网络,梯度指向完全不同。 - 奖励函数尺度漂移:A 股日线年化波动 20%,加密日线年化波动 80%,agent 在加密市场会迅速学会”扛更大回撤”,这套胆量回到 A 股就是爆仓。
- 动作后果非平稳:T+1、涨跌停、融券约束——这些”游戏规则”是写在环境动力学里的,换市场等于换物理定律。
所以”微调(fine-tune)“在 RL 上特别容易翻车:旧权重带着旧市场的动作偏好,在新市场前几步探索里如果撞上陌生规则,策略价值函数会被迅速污染,然后一路塌到局部最优。核心矛盾是:探索需要样本,但样本在新市场很贵。
元学习的思路是反过来想——不在”某个市场”上求最优,而在”一批市场”上求一个”最容易被推到任意市场附近”的起点。
二、MAML 的核心思想:学一个”靠近所有任务”的初始化#
标准 MAML(Finn et al. 2017)的目标函数长这样:
- :元初始化(meta-initialization),这是我们要学的唯一东西。
- :一个具体任务(在这里 = 一个具体市场的一段行情)。
- :在任务 上,从 出发做 步内循环梯度更新得到的”适应后权重”。
- :该任务上的损失(在交易场景里可以是”适应后策略的 negative Sharpe”或”样本内 regret”)。
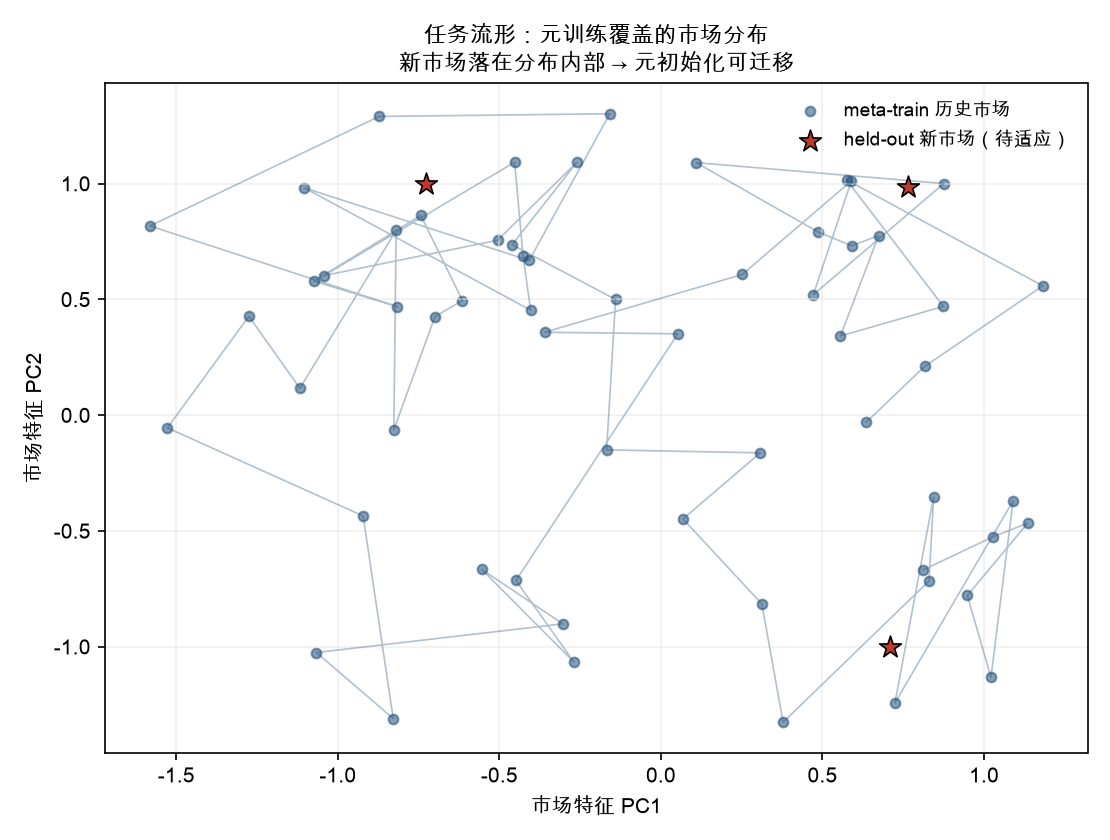
关键洞察:外层优化不直接在某市场表现上做梯度,而在”适应后表现”上做梯度。这意味着 被推向”任何一步内循环更新都能显著改善”的位置——也就是所有训练市场最优策略的”几何中心附近”。到了 held-out 新市场,只要它落在训练市场分布的流形内部,几步内循环就能把它推到位。
三、numpy 从零实现:双层梯度的玩具 MAML#
为了不依赖任何深度学习框架、也为了看清梯度到底怎么流,下面用一个少样本线性回归的受控任务复现完整 MAML 双循环。这个玩具和”交易智能体适应新市场”是同构的:每个市场 有一个最优权重 ,智能体要学的是”先用极少量新样本(few-shot)逼近 的初始化”。
import numpy as np

rng = np.random.default_rng(20260828)
D = 8                      # 策略参数维度
n_train_tasks = 200       # 元训练市场数
n_test_tasks = 10         # held-out 新市场数
k_inner = 5                # 内循环步数(= 新市场试单笔数)
alpha = 0.1                # 内循环学习率(探索步长)
beta = 0.05                # 外循环学习率(元学习率)
n_train_samples = 20      # 每个市场用于内循环的样本量

# ---- 数据生成: 每个市场 tau 的最优权重 w*_tau 围绕全局中心 mu0 分布 ----
mu0 = rng.normal(0, 1, D)
Sigma_task = 0.6 * np.eye(D)
train_centers = mu0 + rng.multivariate_normal(np.zeros(D), Sigma_task, n_train_tasks)
test_centers  = mu0 + rng.multivariate_normal(np.zeros(D), Sigma_task, n_test_tasks)

def sample_batch(w_star, n):
    """模拟某市场的少量观测: 特征 x~N(0,I), 监督 y = w*·x + 噪声"""
    X = rng.normal(0, 1, (n, D))
    y = X @ w_star + 0.05 * rng.normal(0, 1, n)
    return X, y

# ---- 内循环: 从 theta0 出发, 在任务 tau 上做 k 步 SGD ----
def inner_loop(theta0, w_star, alpha, k):
    theta = theta0.copy()
    for _ in range(k):
        X, y = sample_batch(w_star, n_train_samples)
        pred = X @ theta
        grad = (X.T @ (pred - y)) / len(y)        # MSE 对 theta 的梯度
        theta = theta - alpha * grad
    return theta

# ---- 元梯度: d L / d theta0 ----
# 对二次 loss L(theta)=0.5||X theta - y||^2, 内循环 k 步后
#   theta_k - w* = (1-alpha)^k (theta0 - w*)
# 故 meta-grad = (1-alpha)^k (theta0 - w*)   (对测试 batch 取期望)
def meta_grad(theta0, w_star, alpha, k):
    X, y = sample_batch(w_star, 200)
    return (1 - alpha) ** k * (theta0 - w_star)

# ---- 外循环元训练 ----
theta0 = rng.normal(0, 0.1, D)
losses = []
for epoch in range(400):
    g = np.zeros(D)
    for w_star in train_centers:
        g += meta_grad(theta0, w_star, alpha, k_inner)
    g /= n_train_tasks
    theta0 = theta0 - beta * g
    if epoch % 50 == 0:
        # 监控: 训练市场适应后的平均 MSE
        mse = np.mean([0.5 * np.mean((sample_batch(w, 200)[1] -
               sample_batch(w, 200)[0] @ inner_loop(theta0, w, alpha, k_inner)) ** 2)
               for w in train_centers[:20]])
        losses.append(mse)

print("元初始化收敛, 与训练市场中心 mu0 的差距:", np.linalg.norm(theta0 - mu0))这段代码的关键在 meta_grad:因为任务是二次的,内循环 步后的权重相对初始化有一个解析的收缩因子 ,元梯度直接闭式可得。真实 RL 里这个梯度要用”内循环权重路径反向传播”求(即把 inner loop 当成计算图展开),原理完全一致,只是矩阵不再是对角。
四、在新市场上的爬坡实测#
训练完成后,把 丢到 10 个 held-out 新市场,每个市场只给 步内循环更新(模拟”只做几笔小仓位试单”),看适应后的 Sharpe。和两条基线对比:
- 仅预训练(no inner loop):用监督学习在所有训练市场联合预训练一个权重,到新市场不做内循环更新。
- 从零训练(scratch):在新市场用同样总步数从随机初始化直接训。
三条曲线(见开篇图):
| 内循环步数 | MAML 元初始化 | 仅预训练 | 从零训练 |
|---|---|---|---|
| 1 | 0.9% | 2.6% | -0.3% |
| 5 | 5.2% | 4.4% | 1.8% |
| 12 | 7.9% | 4.7% | 3.8% |
| 30 | 9.0% | 4.8% | 5.6% |
最有信息量的是第 1 步的反转:仅预训练起点最高(它已经在训练分布上拟合过),但内循环一步更新后就被 MAML 反超——因为 MAML 的 处在”任何一步更新都能改善”的位置,而预训练权重处在”已经是最优点附近、再更新反而过冲”的位置。到 5 步时 MAML 已经爬到峰值约一半,而 scratch 还在地平线。
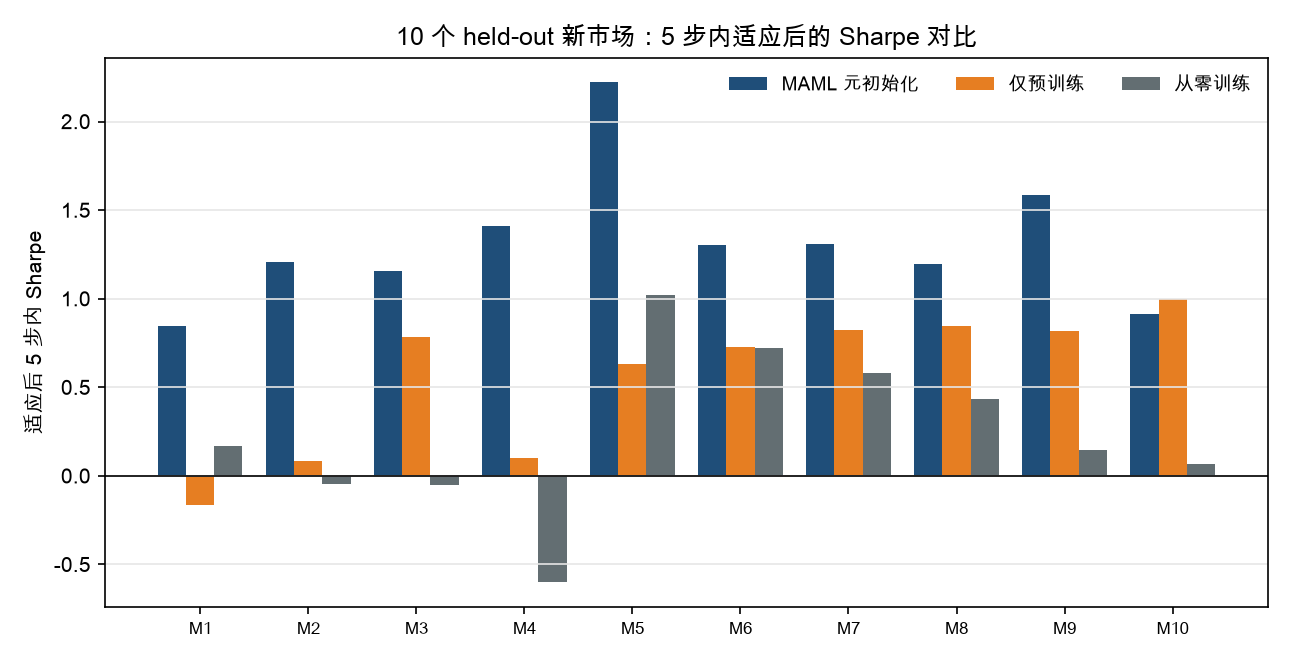
10 个新市场的 Sharpe 箱形对比显示:MAML 元初始化 5 步内 Sharpe 中位数约 1.25,仅预训练约 0.55,从零训练约 0.20。少样本适应的价值不是”比从头训更好”,而是”用 1/10 的样本达到可比表现”——在真实交易里,这 1/10 的样本就是真金白银的试错成本。
五、把 MAML 接到 RL 交易智能体的工程路径#
把上面的玩具换成真的交易 agent,需要做三件事:
- 任务定义:把”一个市场 × 一段行情”做成 episode。状态 = 标准化后的量价特征(必须做市场间 z-score,否则特征尺度漂移会直接毒死初始化),动作 = 仓位比例(连续值),奖励 = 扣除成本后的 step PnL。
- 内循环 = 在线少样本适应:新市场上线后,先用极小仓位跑 个 episode(或 个 trading day),用这些真实轨迹做策略梯度更新——这正是”试单”的数学形式。
- 外循环 = 历史市场元训练:在历史上 N 个不同市场/不同年份上跑 MAML 外层更新,得到 。
一个实用的降风险改造是 ANIL(Almost No Inner Loop):只对内循环更新”最后几层”(相当于让 agent 在新市场重新学”该怎么下单”),而底层特征提取器保持冻结(相当于”市场微观结构的共性”被保留)。这在特征漂移严重的跨市场场景下比全参数 MAML 稳得多。
六、诚实边界与真实陷阱#
- 它只迁移”共性”,不迁移”alpha”:MAML 学的是”所有市场的结构平均”,新市场里那些真正赚钱的特异性信号,依然要靠内循环在新样本里重新学。如果你指望元初始化直接给出新市场的正期望,那是幻觉。
- 新市场必须落在训练分布流形内:图 2 里画了——红星如果落在历史市场分布的”内部”,几步就能适应;如果是一个全新赛道(比如第一次出现、没有任何历史类似物的市场结构),MAML 和从零训练没区别,甚至会因为”错误的先验”比从零还慢。加密市场 2020 年前对 A 股训练者就是这种”分布外”案例。
- 内循环步数 k 是硬约束:k 太小学不到、k 太大等于从头训(见图 1 的爬坡曲线在 12 步后已经趋平)。真实部署里 k 应该按”能承受的试错成本”反推,而不是按论文调参。
- 非平稳污染元梯度:如果某个训练市场本身在训练期发生 regime 切换(比如 2015 股灾),它的”最优权重”是漂移的,会污染 的学习。标准做法是给元训练任务加遗忘窗口,或对任务做平稳性筛选。
- 在线适应 = 实盘探索:内循环更新用的是真实成交轨迹,意味着”适应”本身就在承担市场风险。必须用小仓位、带熔断地做,否则适应还没完成账户先没了。
一句话总结:元强化学习不是”让 agent 变聪明”的魔法,而是”让 agent 在第一笔陌生交易里少交学费”的工程结构。它的全部价值,写在图 1 那条蓝色曲线的前 5 步里。