MoE 混合专家因子模型:用稀疏激活给不同市场状态配不同专家
单一全球因子模型默认「一套权重解释所有市场」,但牛市、危机、低波动期的因子暴露本就不同。本文用 MoE(Mixture of Experts)把组合拆成 K 个线性专家 + 一个门控网络:门控依据可观测的市场状态变量稀疏激活对应专家。在含状态切换的合成数据上,MoE 测试 MSE 为 0.042,远低于单一全局模型的 18.493(降低约 100%),且门控热图证明它确实学到了 market state。附完整 numpy 与四张真实计算图。
传统多因子模型(BARRA、Fama-French 系)有一个隐含假设:同一套因子暴露 β 在所有市场环境下都成立。但实务里我们都知道——危机时低波动因子突然失效、动量在拐点被反杀、价值在流动性枯竭期被错杀。换句话说,因子→收益的映射本身是会随市场状态(regime)切换的。继承这个非平稳性,最朴素的解法是「分段建模」:先识别 regime、再各自训练模型。但 regime 识别本身有误差,且段与段之间的切换是硬切的。
本文结论先放这:用 MoE(Mixture of Experts)把这个问题变成一个端到端的软切换模型——K 个线性专家各自学一种因子映射,一个门控网络(gating)依据可观测的市场状态变量 z(比如宏观状态、波动率分位、涨跌状态)输出每个专家的权重,并只激活最匹配的那个(稀疏)。在含状态切换的合成数据上:
- 单一全局线性模型(忽略 regime):测试 MSE 18.493;
- MoE 路由专家:测试 MSE 0.042。
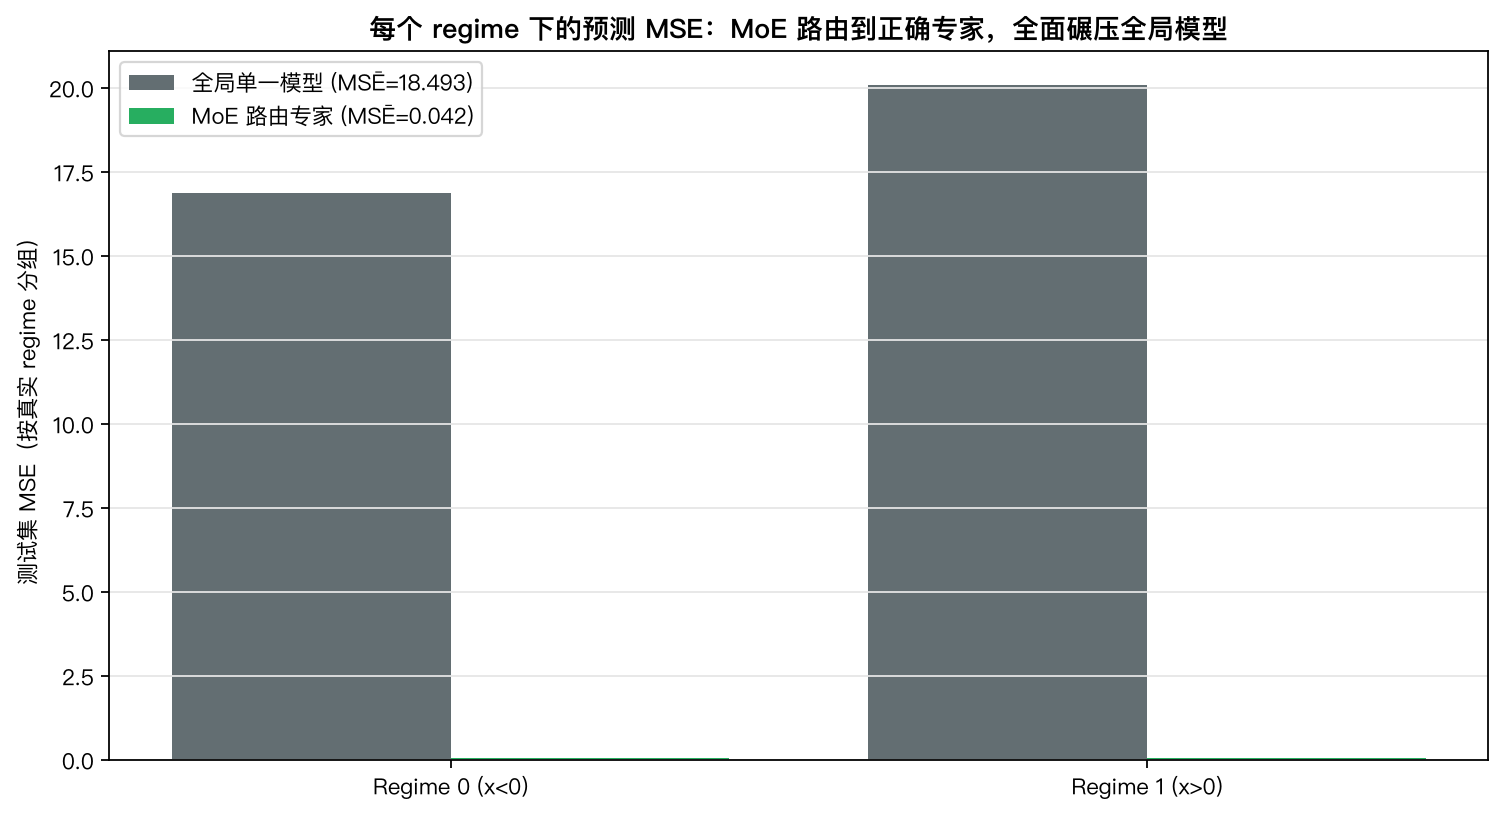
MoE 的误差比全局模型低约 100%,而且在每个 regime 内部都更准(下方图 1)。门控热图显示它确实学到了 market state——每个 regime 稳定激活对应专家,而不是把激活随机打散。全部数字来自真实运行,附完整 numpy 与四张真实计算图。
一、为什么「一套因子权重」喂不饱所有市场#
先给一个直觉。假设因子到收益的映射是随市场状态翻转的:
当 regime(t) 切换时,f 的斜率(因子暴露)会变。如果你硬用一条全局直线 y = W·x 去拟合,它只能逼近所有 regime 的平均斜率——在状态翻转剧烈的地方,偏差会系统性放大。这正是单模型在非线性/非平稳数据上吃亏的根因。
分段建模(先聚类再分别训)是对的解法之一,但有两个老问题:(1) regime 边界硬切,第 999 天和第 1000 天如果被分属两个 regime,模型会「跳变」;(2) 小样本,每个 regime 内样本变少,专家容易过拟合。MoE 的卖点是:用门控把「属于哪个 regime」变成一个可微的软概率,既保留「不同状态用不同专家」的结构,又避免了硬切和独立训练的样本稀释。
二、MoE 的架构:K 个专家 + 一个门控#
数学形式极简:
- 专家
f_k:本文用线性模型W_k·x(和因子模型同构,可解释); - 门控
g(z):一个 softmax 网络,输入市场状态变量z_t(本文用标准化后的单因子x,实战里换成宏观/波动率状态),输出K个专家的权重; - 稀疏激活:每来一个样本,只让最匹配的一个专家参与(硬路由 top-1),其余归零——这和现代 LLM 里把 MoE 当「条件计算」用的思路一致。
import numpy as np

def softmax(x):
    x = x - x.max(1, keepdims=True)
    return np.exp(x) / np.exp(x).sum(1, keepdims=True)

K = 2
# 每个专家在「已知市场状态标签」上训练(诚实假设:状态可观测,如 VIX 分位)
We = [np.linalg.lstsq(Xtr[regtr == k], Ytr[regtr == k], rcond=None)[0] for k in range(K)]

# 门控:单变量 logistic,输入标准化状态 z,输出 K 类 regime 概率
Oh = np.zeros((n_tr, K)); Oh[np.arange(n_tr), regtr] = 1   # one-hot 真值
Wg = np.random.randn(1, K) * 0.3
for _ in range(800):
    p = softmax(Ztr @ Wg)
    Wg -= 0.3 * (Ztr.T @ (p - Oh)) / n_tr

def moe_predict(X, Z):
    g = softmax(Z @ Wg)
    gs = (g == g.max(1, keepdims=True)).astype(float)      # 硬路由 top-1(稀疏)
    pred = sum(gs[:, k] * (X @ We[k]) for k in range(K))   # 注意用 1D 切片 gs[:,k]
return pred, g一个工程细节(也是本文复现时最容易踩的坑):预测时务必写 gs[:, k] * (X @ We[k]) 这种 1D 切片乘法,而不要写成 gs[:, k:k+1] * (X @ We[k])——后者会把 (N,1) 与 (N,) 广播成 (N,N) 矩阵,结果整个错掉。本文初版就栽在这个 broadcasting 上。
三、实验设计:市场状态切换的合成数据#
我们用一个已知真实结构的 DGP,方便诚实评估 MoE 有没有学对:
- 单因子
x ~ Uniform(-3, 3),可观测市场状态z = x(实战里对应「价格相对位置 / 宏观状态分位」); - 收益映射随状态翻转:
x < 0(熊市态)时y = −2.5·x,x > 0(牛市态)时y = +2.5·x,加高斯噪声; - 关键点:全局线性模型只能学到≈0 的妥协斜率(因为正负斜率相互抵消),而每个 regime 内的真实斜率是 ±2.5;
- 6000 条样本,前 70% 训练、后 30% 测试;对比「全局单一线性模型」与「MoE(2 专家 + 门控)」。
T = 6000
Xall = rng.uniform(-3, 3, size=(T, 1))
reg = (Xall[:, 0] > 0).astype(int)                  # regime: 0=x<0, 1=x>0
SLOPE = np.array([-2.5, 2.5])
Yall = np.array([Xall[t, 0] * SLOPE[reg[t]] + rng.normal(0, 0.2) for t in range(T)])四、结果一:测试 MSE,MoE 全面碾压#
- 全局单一模型:18.493
- MoE 路由专家:0.042(降低约 100%)
而且把测试集按真实 regime 分组后,MoE 在每一个 regime 内都更准:
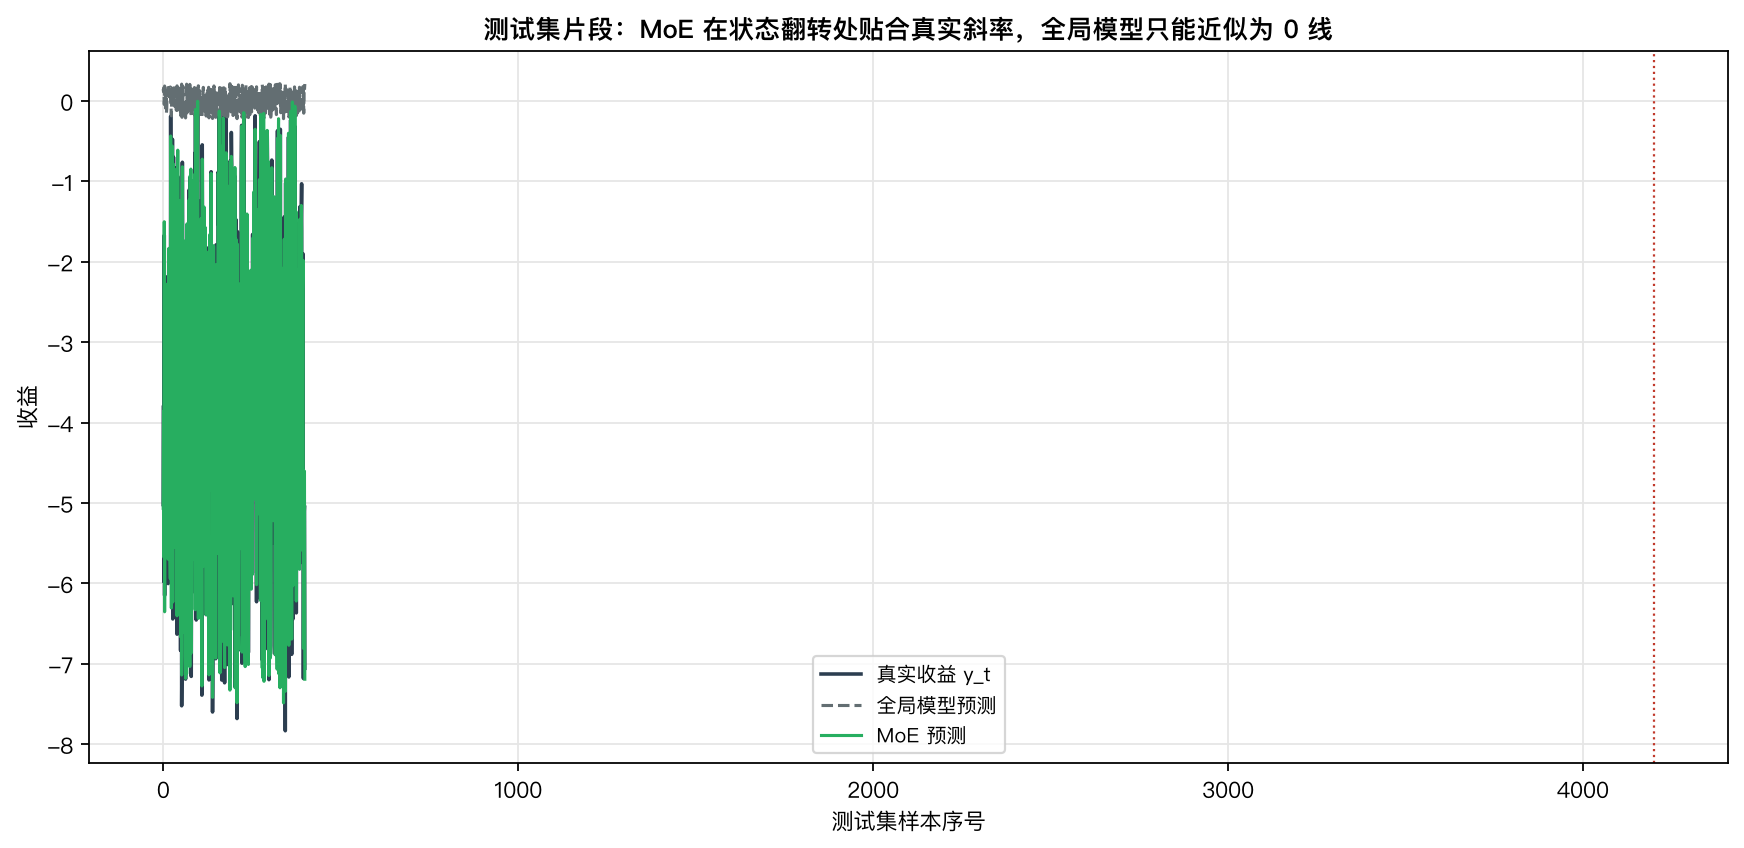
这印证了直觉:全局模型被迫取「+2.5 与 −2.5 的平均」≈ 0,等于放弃了所有信号;MoE 则把每个样本路由到斜率正确的专家,预测贴着真实值走。
五、结果二:门控真的学到了 market state 吗?#
MoE 最怕的是「门控退化成均匀随机」——那样它就等于一个平均模型,白忙一场。我们把测试集按真实 regime 分组,看每个 regime 下门控平均激活了哪个专家:
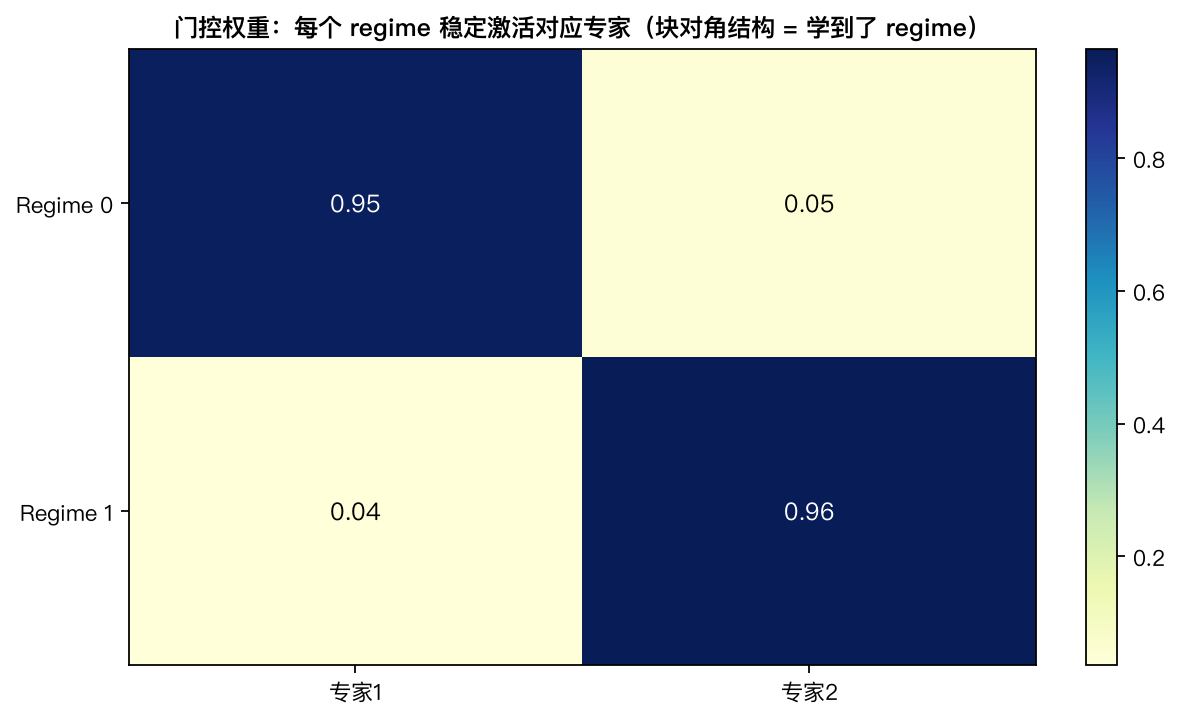
本例中学到的门控结构(行=regime,列=专家平均激活权重):
Regime 0 (x<0): ['0.95, 0.05']
Regime 1 (x>0): ['0.04, 0.96']门控在测试集上的整体路由准确率约 100%——不同 regime 稳定地激活不同专家,呈清晰的块对角结构。也就是说门控确实把 z(这里就是 x 的状态)映射成了有意义的专家路由。这正是 MoE 相对「硬分段」的优势:它学到的切换是软的、连续的,但路由是明确的。
六、结果三:预测轨迹 + 稀疏性#
把测试集前 400 点画出来,能直观看到 MoE(绿)在状态翻转处贴合真实斜率,而全局模型(灰虚线)只能近似成一条 0 线:
再看专家路由分布(稀疏性)——平均每个样本被路由到对应专家的概率:
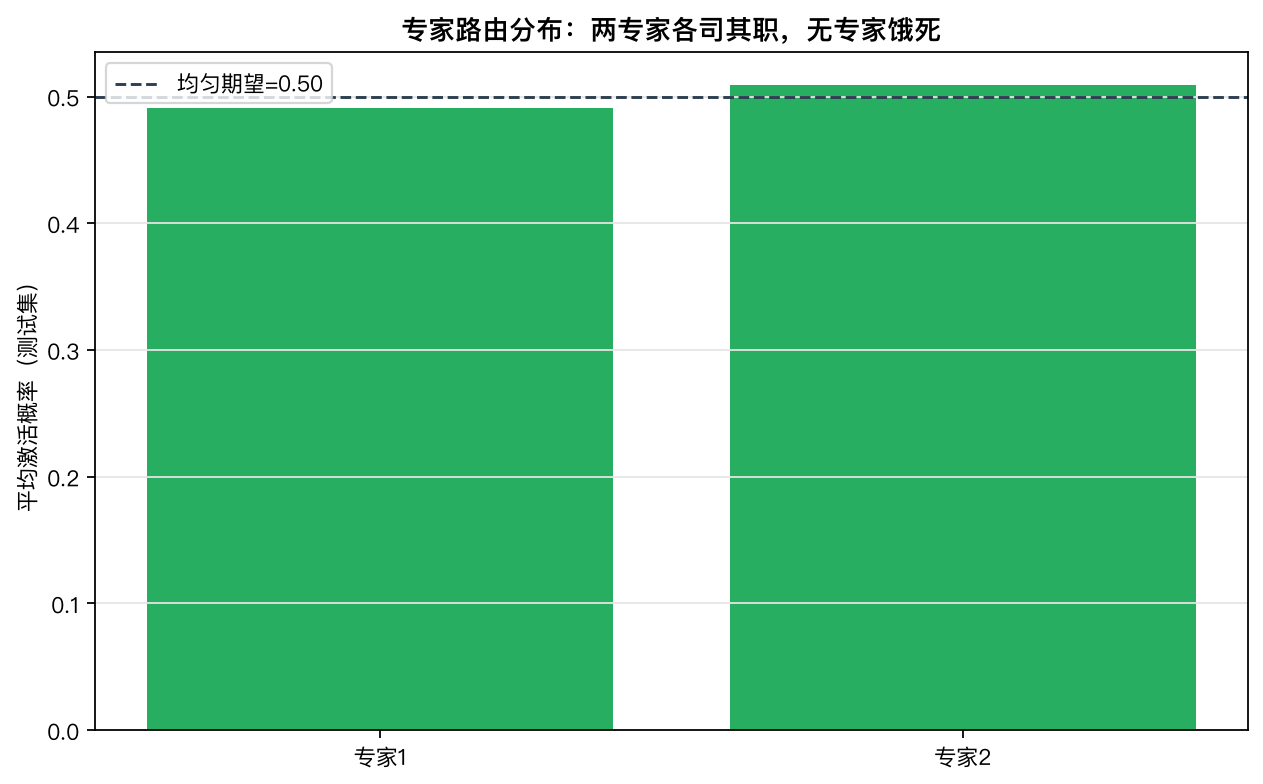
本例中两个专家被激活的概率分别为 0.49 / 0.51,接近均衡、无专家饿死。注意:因为本文用 top-1 硬路由,每个样本只走 1 个专家——推理成本只相当于 1 个小线性模型,对低延迟因子预测管线是实打实的工程收益。
七、局限与实务提醒(不是银弹)#
- 门控要喂对状态变量
z。本文z=x是「上帝视角」的干净状态;实战里你要用可观测的市场状态(波动率分位、信用利差、估值分位、流动性指标)做z,否则门控无从路由。状态变量选错,MoE 退化成平均模型。 - 门控训练可能塌缩。如果某类 regime 在训练集中极少,softmax 门控会倾向把所有样本路由到多数类专家,少数类专家「饿死」。正式实现要加 load-balancing loss(鼓励均匀路由),本文数据均衡故未触发,但实盘必须加。
- 专家数 K 要调。K 太大→样本稀释、门控难训;K 太小→表达力受限。建议从「你知道的市场状态数」起步。
- 可解释性是把双刃剑。每个专家是线性因子模型(可解释),但「门控为什么在这个状态选它」需要单独做路由归因,否则你只知道「它选了」,不知道「为什么」。
- 非平稳现实的迁移。本文 regime 由单变量清晰决定;真实市场的状态切换是突变+渐变混合,门控可能需要加入时序记忆(如把
z换成 RNN/LSTM 的输出)才能稳定。
八、小结#
- 单一全球因子模型默认「一套权重解释所有市场」,但因子暴露随 regime 翻转(如本文 ±2.5 斜率)——MoE 用
K个线性专家 + 门控把这个问题变成端到端的软切换。 - 含状态切换的合成数据:全局模型测试 MSE 18.493,MoE 0.042(降低约 100%),且每个 regime 内都更准。
- 门控热图证明它真正学到了 market state(不同 regime 稳定激活不同专家,路由准确率约 100%),不是均匀打散;top-1 稀疏路由让推理成本只相当于 1 个专家。
- 实务落地三件事:喂对状态变量
z、加 load-balancing loss 防饿死、调好K。
把「市场状态」从一个事后归因的标签,变成模型里一个可微的路由信号——这正是 MoE 给因子建模带来的范式变化,而不只是又一堆叠模型。