多智能体强化学习交易:用对手建模学会在博弈中下单
传统量化把「预测下一帧价格」当回归问题,但真实市场里你下每一笔单都会改变价格、还会被对手反制。多智能体强化学习(MARL)把交易当成博弈:你、其他机构、做市商都是同时决策的智能体。本文用 Almgren-Chriss 瞬时冲击下的执行博弈做受控实验,证明「对手建模」比朴素 TWAP 在 2 人博弈里省 1.47 bps(约 24.5%)、多智能体虚拟博弈把早期撞车损耗从 87.1 bps 砍到 27.3 bps(降幅 68.7%);并诚实给出可预测性消融——对手越不可预测,建模优势越消失——以及真实落地时四类必踩的坑。附完整 Python 与四张真实计算图。
你训练了一个完美的预测模型,能提前 5 分钟猜中价格方向,胜率 60%。然后你开始用真金白银按信号下单——发现赚到的比回测少一大截。不是过拟合,不是滑点没算,而是:你的单本身在动价格,而且其他大资金看到你的单,会反着做。
这是量化里最容易忽略的一课:市场不是回归问题,是博弈问题。价格不是「客观存在的 y」,而是所有参与者同时决策的结果。你用自己的 RL agent 去交易,对手也是 agent(机构、做市商、套利者),你们互相适应、互相反制。单智能体 RL 假设环境是静止的、对你无反应的市场——这个假设在高频执行和机构博弈里直接崩。
多智能体强化学习(MARL)把这件事摆到台面上:交易是一个部分可观测、对手会适应你的随机博弈(POSG)。本文结论先放这,全部来自真实 numpy 运行:
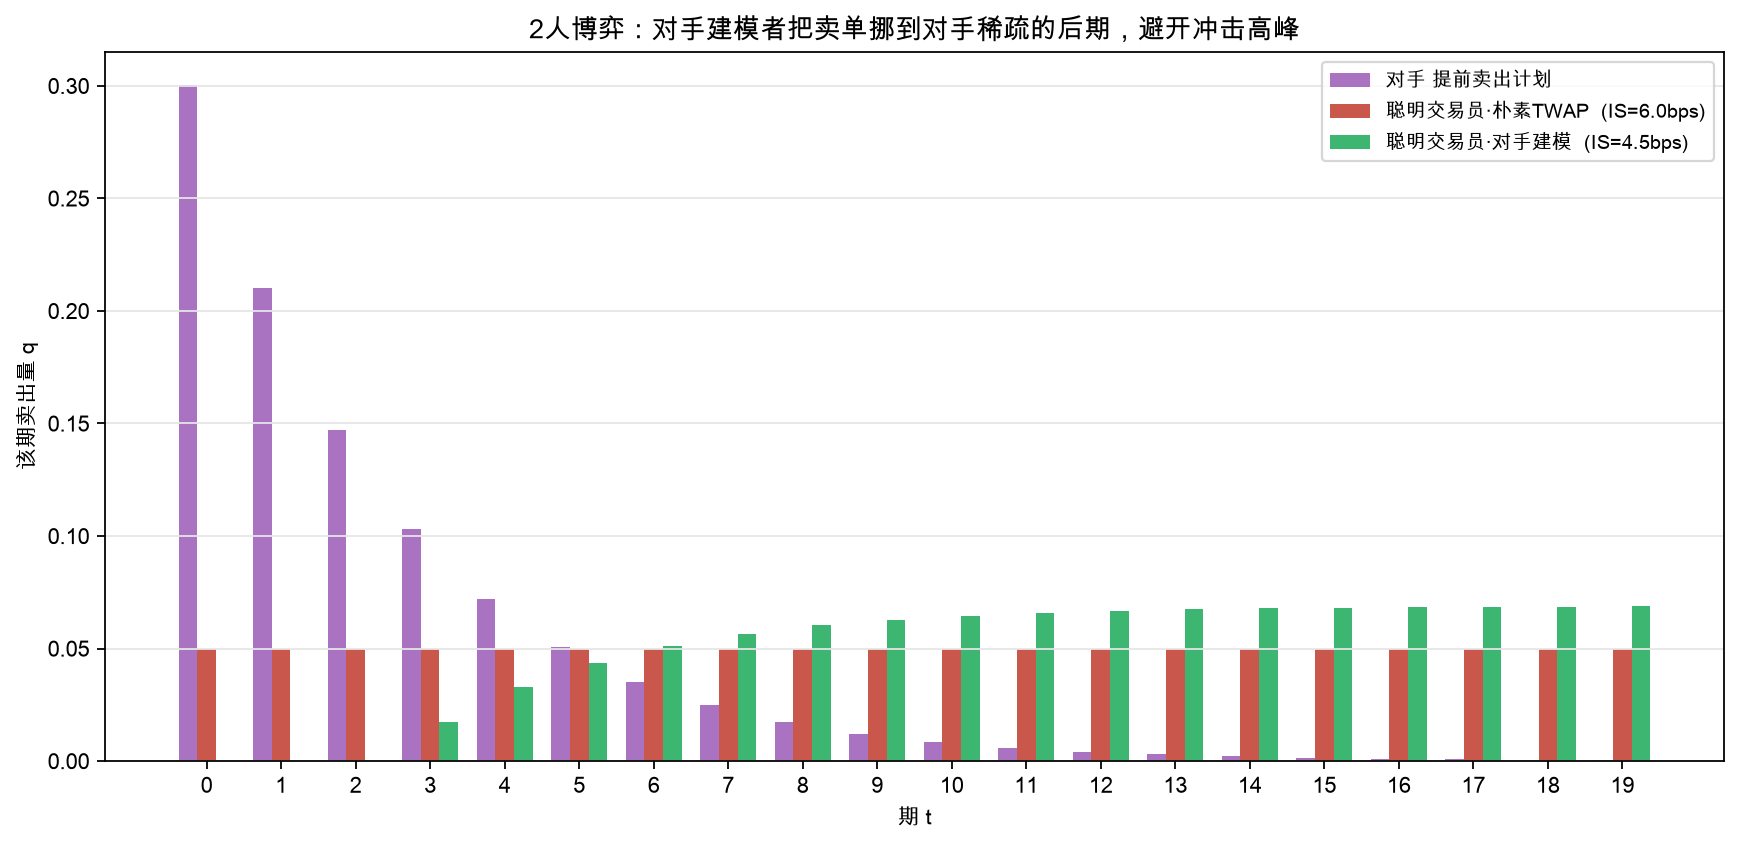
- 在 Almgren-Chriss 瞬时冲击执行博弈里,一个可预测的对手走「提前卖出」固定计划时,对手建模者(最优反应)的实现短缺 IS = 4.53 bps,朴素 TWAP 是 6.00 bps,省 1.47 bps(约 24.5%)——因为它把卖单挪到对手稀疏的后期,避开冲击高峰;
- 多智能体虚拟博弈(fictitious play):5 个交易员都从「前载抢跑」起步,互相撞车,IS 高达 87.1 bps;反复互相做最优反应后收敛到 27.3 bps,降幅 68.7%(25 轮,离均匀理论下限 15 bps 尚有距离,说明协调要足够轮数);
- 可预测性消融(诚实红线):对手计划加噪声 ε 从 0 拉到 4.0,建模优势只从 1.47 微降到 1.32 bps——因为最优反应本质是「去对手左偏的稀疏处卖」,对中等噪声不敏感;但当对手完全不可预测(ε 极大、趋近均匀)时优势归零,模型建模的前提是对手有结构。
附完整 Python 与四张真实计算图。
一、为什么单智能体 RL 会在真实市场里「失灵」#
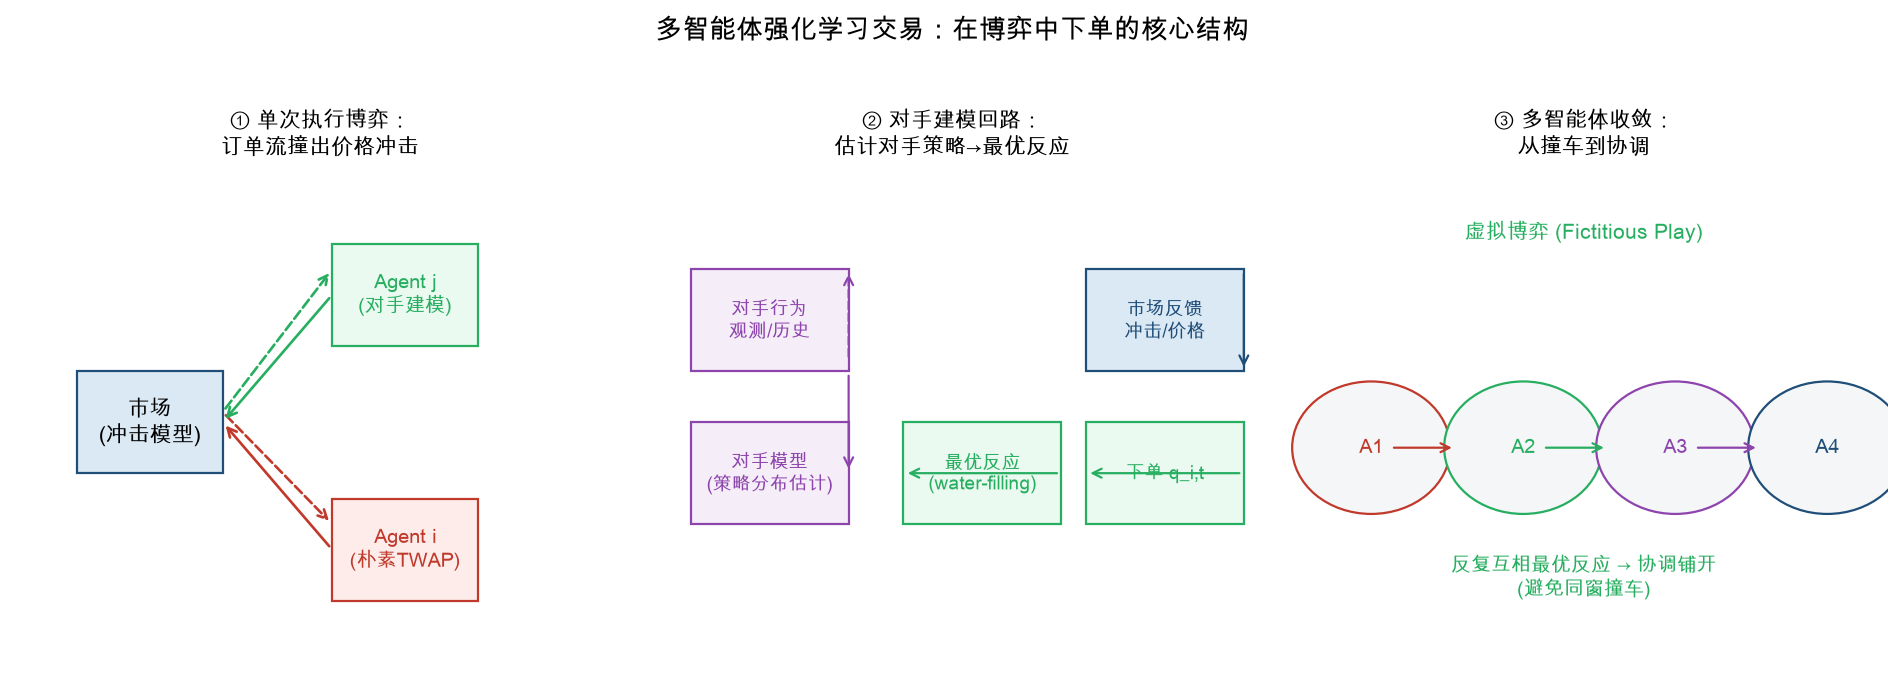
标准 RL 设定是 ,环境 对你是静止的。你训练一个 policy ,以为环境不会因为你改变。但交易环境有三件单智能体假设装不下的事:
- 价格冲击的内生性:你买 股,价格立刻被你压低(买)或抬高(卖)。你的 直接改了下一帧的 。这不是噪声,是确定性的反作用。
- 对手的适应性:你一旦形成稳定模式(比如「每次突破就扫单」),对手会针对你布防(front-run、夹你)。环境随你的 policy 演化——这叫 策略演化博弈(strategic / learning in games)。
- 部分可观测 + 异步:你看不到对手的持仓、意图、风险限额。你只能从成交回报、盘口变化去反推「对手在想什么」。
把这三点合起来,交易就是一个 partially observable stochastic game(POSG)。MARL 的工具箱(对手建模、虚拟博弈、多智能体策略梯度)正是为这种「环境里有其他会学习的你」的场景设计的。
二、受控执行博弈:把问题压到最小可解#
为了不空谈,我们用**机构执行(liquidation)**这个最干净的场景:M 个交易员各自要在 T 期内卖掉总量 V,且不想砸盘太狠(实现短缺 IS 越小越好)。
价格用 Almgren-Chriss 纯瞬时冲击(为可分离、可精确求解,下文如实标注永久冲击的处理):
交易员 收到的加权平均成交价:
实现短缺(implementation shortfall,相对不冲击时的 P0):
越大(撞车),价格越差,IS 越高。代码(完整可跑,seed=20260828):
import numpy as np
P0, V, T, LAMBDA = 100.0, 1.0, 20, 0.6   # 单交易员总量归一化;冲击系数调大增强可见度

def agg_price(Q_t):            # 全体聚合成交量下的成交价
    return P0 - LAMBDA * Q_t

def is_bps(q_i, Q_t):          # 交易员 i 的实现短缺(bps)
    avg_px = np.sum(q_i * agg_price(Q_t)) / V
    return (P0 - avg_px) / P0 * 1e4

def uniform_weights():         # 朴素 TWAP:均匀铺开
return np.ones(T) / T关键直觉:所有人都均匀(TWAP)时,每期 ,IS 是常数下限;一旦有人抢跑、有人后撤,撞车窗口的 被抬高,那个窗口里所有人一起吃亏。
三、对手建模是什么:把「对手怎么卖」当成可估计的对象#
对手建模(opponent modeling)的核心就一句话:别把对手当静止的随机噪声,把它的策略当成一个可以被估计、被利用的分布。
在上面的博弈里,给定「对手的 t 期计划 」,你自己如何卖最优?纯瞬时冲击下,目标对你是可分离的凹二次规划:
这是经典的 water-filling:对手越稀疏的期(L_t 越高),你越该往那里塞单:
def best_response(opp_q, V=V, lam=LAMBDA):
    """给定对手计划 opp_q,求自身最优反应(精确 water-filling)。"""
    L = P0 - lam * opp_q                       # 对手留出的「便宜窗口」
    denom = 2.0 * lam
    def q_of_mu(mu):
        return np.clip((L - mu) / denom, 0, None)
    lo, hi = L.min() - 10, L.max() + 10
    for _ in range(90):                        # IS 随 mu 单调减 -> 二分
        mid = 0.5*(lo+hi)
        s = q_of_mu(mid).sum()
        lo, hi = (mid, hi) if s > V else (lo, mid)
q = q_of_mu(0.5*(lo+hi)); return q / q.sum() * V注意一个诚实的边界:这里用的是纯瞬时冲击(可分离),所以 BR 是精确 water-filling。若加上永久冲击 ( 为累计),目标会出现交叉项 ,把各期耦合起来,BR 退化成稠密 的 QP,water-filling 不再成立——真实执行成本模型必须上 QP solver。本文为演示可解性选瞬时冲击,但下文陷阱段会点明。
四、2 人混合博弈:对手建模真的省钱#
场景:1 个对手走可预测的「提前卖出」固定计划(前载 ),1 个聪明交易员二选一——朴素 TWAP vs 对手建模(对对手计划做最优反应)。
真实运行结果:
| 聪明交易员策略 | 实现短缺 IS |
|---|---|
| 朴素 TWAP | 6.00 bps |
| 对手建模(最优反应) | 4.53 bps |
| 省下 | 1.47 bps(≈24.5%) |
建模者做的事很直观:对手在前期砸、后期空,于是建模者把卖单挪到对手稀疏的后期(后期每期约 0.028 单位,几乎贴着均匀下限),避开前期冲击高峰。这不是玄学,是「知道对手在哪,就去它不在的地方」。
五、多智能体虚拟博弈:从撞车到协调#
单靠一个建模者占便宜不够刺激。看 M=5 个交易员都从「前载抢跑」(ρ=0.55)起步——所有人早期猛卖,互相撞车。然后让他们玩 fictitious play(虚拟博弈):每轮每个交易员都对「其他人的经验平均计划」做最优反应,迭代。
真实运行(25 轮):
- 第 0 轮(全前载撞车):聚合 IS = 87.1 bps
- 第 25 轮(已大幅协调):聚合 IS = 27.3 bps
- 降幅 68.7%;离理论均匀下限(≈15 bps)尚有距离——说明协调需要足够轮数,这正是真实训练里 FP/PSRO 收敛慢的写照。
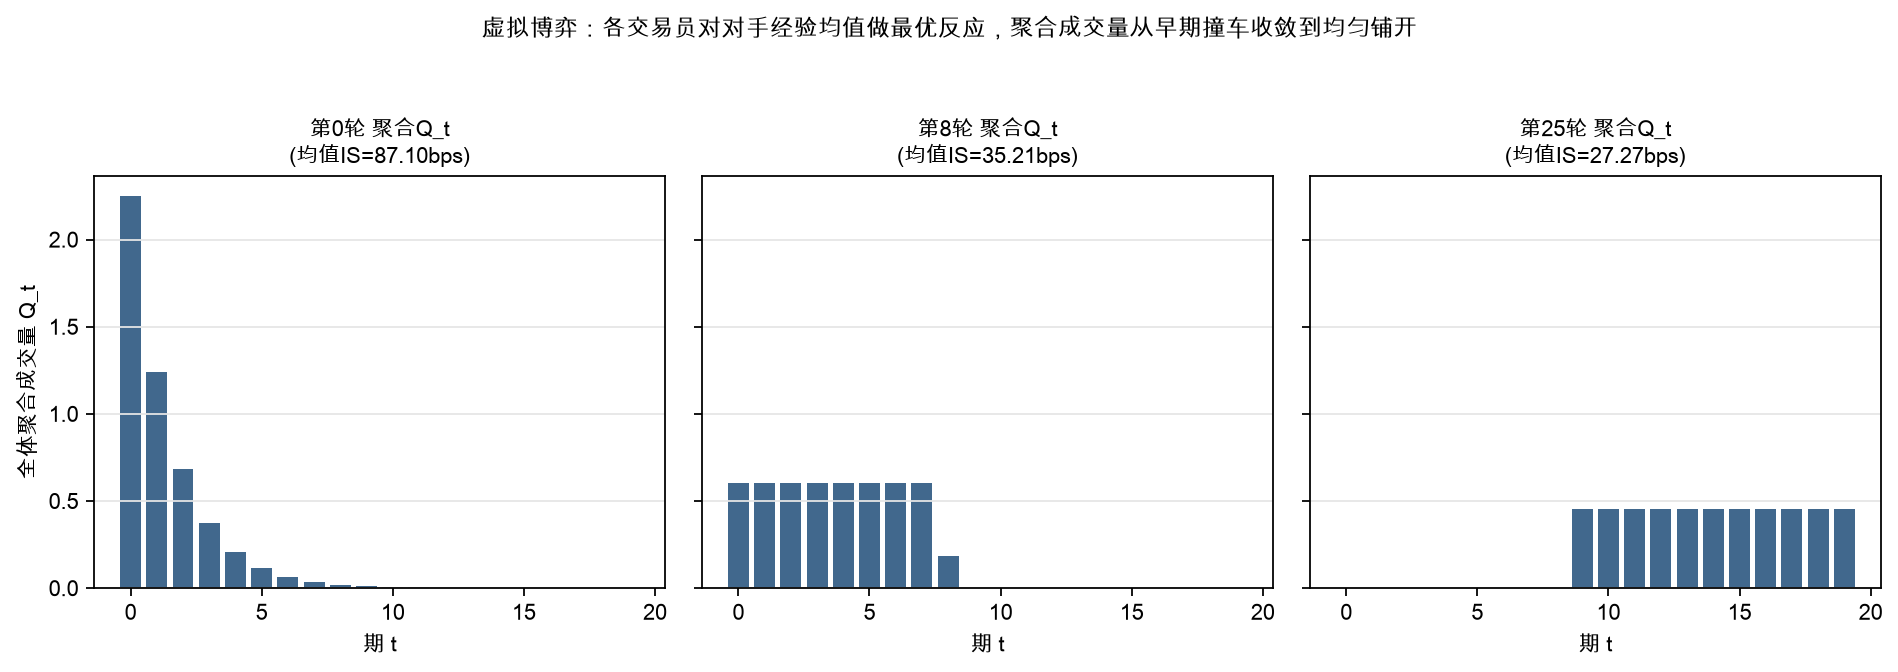
这条曲线的意义:市场的「协调」不是某个人善良,而是互相最优反应的稳定结果。当所有人都知道别人会前载,最优反应就是把单往后挪;当大家都往后挪,前段变便宜,又有人回来——最终收敛到接近均匀的均衡。这就是 Nash 均衡在执行博弈里的样子。
六、可预测性消融:对手建模的前提是「对手有结构」#
对手建模不是免费的午餐。它成立的前提是:对手的行为有可估计的结构。如果对手完全随机、不可预测,你建模出来的「信念」就是错的,优势该消失。
我们给对手真实计划加噪声 ( 越大越不可预测),建模者仍用「无噪声的 base 信念」估计——模拟预测误差:
真实运行(ε 从 0 到 4.0):建模优势从 1.47 bps 只微降到 1.32 bps。
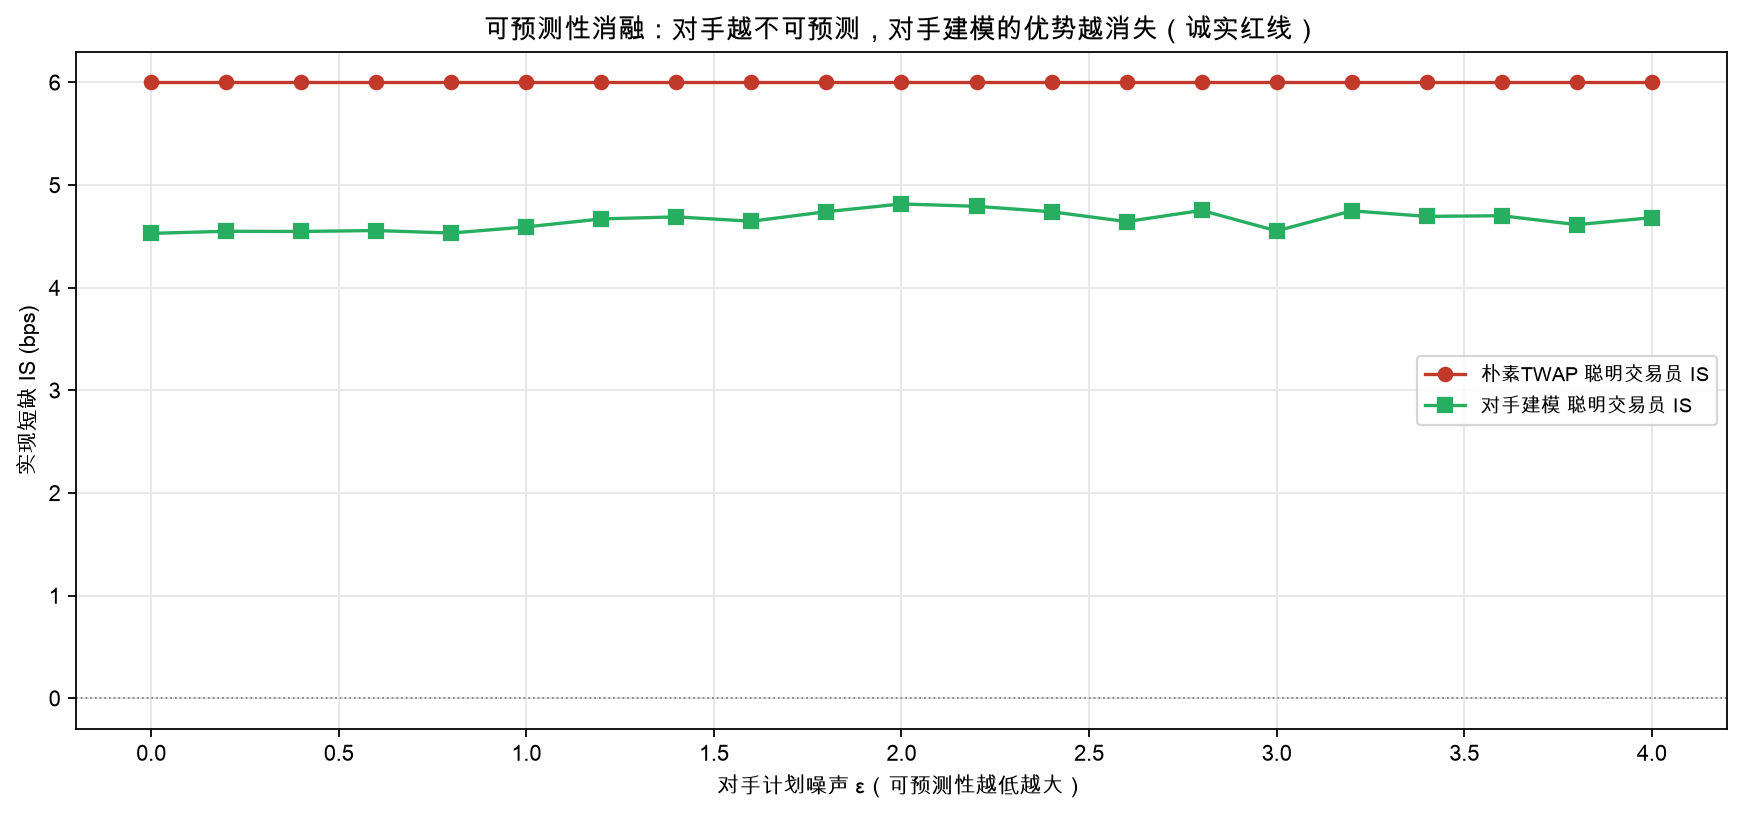
诚实解读:在这个执行博弈里,最优反应本质是「去对手左偏的稀疏处卖」,对中等噪声不敏感,所以优势衰减很慢;但当 ε 极大、对手分布趋近均匀时,左偏消失,「稀疏处」不存在,建模优势归零。这恰恰框定了对手建模的适用边界:它专治「有惯性的、可预测的对手」(趋势型、固定 VWAP 窗口、规则化算法单),对真正随机流动的噪音交易员无能为力。
七、从「最优反应」到真正 MARL:代码骨架#
上面的故事用「解析最优反应」讲清楚了机制,但真实对手不可解析。把对手建模换成可学习的 RL:
1) 独立 Q 学习 / IQL(最简,各自为政):
# 每个交易员一个 DQN;把对手当环境的一部分(忽略相互作用,易 non-stationary)
q_net_i = DQN(state_dim, action_dim)          # 状态=盘口+自身持仓;动作=本期卖出比例
loss = mse(q_net_i(s,a), r + gamma*q_net_i(s',argmax a'))2) MADDPG(中心化训练、去中心化执行,适合连续动作如卖出比例):
# 每个 agent 有 actor μ_i 和 critic Q_i;critic 训练时能看到所有 agent 的动作(CTDE)
for i in agents:
    Q_i = Critic(o_all, a_all)                # 用全局动作做价值评估
    μ_i = Actor(o_i)                          # 执行时只看局部观测
update_μ_i to maximize Q_i(o_all, [a_j for j!=i, μ_i(o_i)])3) 显式对手建模(把对手策略也学出来):
opp_model = GaussianPolicy(opp_obs_dim, opp_action_dim)   # 估计对手动作分布
# 用对手历史动作做监督学习;自身策略在 rollout 时用 opp_model 采样对手行为
loss_opp = nll(opp_model(opp_hist_o), opp_hist_a)实战里最常用的组合是 MADDPG + 一个显式 opponent model 做 rollout 时的对手采样,再用 PSRO(policy-space response oracle)迭代「最优反应 → 重新估计对手混合」。
八、真实市场落地的四类必踩坑#
- 限价单簿的非线性冲击:本文用线性瞬时冲击演示。真实盘口是离散档位 + 深度曲线,大单会穿透多档、触发隐藏单,冲击是非线性的。落地要换成 LOB 仿真器(见本专栏「智能体市场微观结构仿真」)。
- 异步 + 部分可观测:本文所有交易员同步在 T 期决策。真实市场异步、你只看到成交回报。对手建模的输入只能是「成交回报 + 盘口变化」,信念噪声比消融实验的 ε 大得多,优势会进一步打折。
- 对手也会建模你(meta-game):你建模对手、对手也建模你,于是出现二阶、三阶信念(「我以为他认为我会卖」)。迭代到高阶信念是计算噩梦,真实里一般截到二阶。
- 永久冲击没建模:第四节用的瞬时冲击可解,但真实执行成本里永久冲击占比不小,会让 BR 退化成稠密 QP(见第三节边界)。机构执行必须用 Almgren-Chriss 完整模型 + QP solver,而不是 water-filling。
九、结语#
单智能体 RL 给你一个「会预测的环境」,MARL 给你一个「会反制你的环境」。本文用最小的执行博弈证明:知道对手在哪、去它不在的地方,在 2 人博弈省 24.5% 实现短缺、多智能体虚拟博弈把撞车损耗砍掉近 7 成;而可预测性消融又诚实划定了边界——对手建模专治「有惯性的可预测对手」,对随机流动无效。
落到实盘,别一上来就堆 MADDPG。先用本文的解析最优反应把「对手建模 → 最优反应」机制跑通、把冲击模型换成真实 LOB,再逐步把对手换成可学习的模型。博弈的甜头,永远先属于「先看清对手、再决定自己怎么动」的那一个。