预测收益和预测风险,其实是同一道题#
走过一圈之后,我发现两件被传统量化分得清清楚楚的事,骨子里是一件事的两种投影:
- 预期收益 (μ):这只股票明天相对基准能超涨多少?
- 预期风险 (σ):这只股票明天波动会有多大?
传统做法是:预测 μ 用一个模型(一般是截面回归或 LightGBM),预测 σ 用另一个模型(GARCH、EGARCH、或 realized vol 回归)。两套模型各自吃自己的特征、吐自己的预测,从不分享中间表征。
但你静下心来想想:「为什么 2020 年初动量因子 IC 高」这个解释,是不是和「为什么 2020 年初小盘股波动率高」那个解释用同一组底层特征?前者要解释的是「动量信号 + 流动性溢价 + 散户情绪」,后者要解释的是「资金流入 + 杠杆压力 + 信息扩散速度」——这两组特征的交集极大。这就意味着两件事在底层特征空间里是耦合的。
如果用同一组共享特征来预测两件事,会发生两件好事:
- 梯度信号翻倍:每个样本既给 μ 的梯度、又给 σ 的梯度,参数更新方差变小;
- 共享表征被迫纯净:那些对两件事都没用的特征,梯度会自动把它们压向 0;那些对两件事都有用的特征,权重自然被加上去。
下面用 numpy 从零把这个直觉变成可跑代码。
一、最小可行架构:硬共享 + 两个 head#
最朴素的多任务学习架构叫「硬参数共享(hard parameter sharing)」:所有任务共用一个底层表征,顶上每个任务一个 head。
     X (n_samples, n_features)
            │
   ┌────────┴────────┐
   │  Shared bottom │           ← 整个模型唯一一处共享
   │  H = X · W_H   │              形状 (n_samples, hidden_dim)
   └────────┬────────┘
            │
   ┌────────┴────────┐
   │                 │
 μ_head: μ̂ = H · W_μ + b_μ      ← 预测收益
   │                 │
σ_head: σ̂ = H · W_σ + b_σ ← 预测风险(风险必须 > 0)下面是 numpy 端到端实现。我故意保持线性(不写 MLP),让梯度来源的可解释性 100% 清晰:
import numpy as np

def fit_multi_task(X, y_mu, y_sigma, hidden_dim=4, lr=0.01, epochs=200):
    """X: (n_samples, n_features);y_mu, y_sigma: (n_samples,)。
    硬参数共享:H = X · W_shared;两个 head = H · W_head + b。
    """
    n, F = X.shape

    # 标准化特征(一次性,跨任务共享的标准化是关键)
    mu = X.mean(axis=0)
    sd = X.std(axis=0) + 1e-8
    Xn = (X - mu) / sd

    # 标准化目标(μ 标准正态化,σ 保持正值域)
    y_mu_mu, y_mu_sd = y_mu.mean(), y_mu.std() + 1e-8
    yn_mu = (y_mu - y_mu_mu) / y_mu_sd

    rng = np.random.default_rng(11)
    W_shared = rng.normal(0, 0.3, (F, hidden_dim))
    W_mu = np.zeros(hidden_dim)
    W_sigma = np.zeros(hidden_dim)
    b_mu = 0.0
    b_sigma = y_sigma.mean()      # 风险 head 初始化为均值

    losses_mu, losses_sigma = [], []
    for epoch in range(epochs):
        H = Xn @ W_shared                                # 共享表征
        pred_mu = H @ W_mu + b_mu                          # 收益预测
        pred_sigma = H @ W_sigma + b_sigma                 # 风险预测

        # 任务加权(也可以变成自适应权重,这是 MTL 研究的开放问题)
        loss_mu = ((pred_mu - yn_mu) ** 2).mean()
        loss_sigma = ((pred_sigma - y_sigma) ** 2).mean()
        losses_mu.append(loss_mu)
        losses_sigma.append(loss_sigma)

        # 反向传播(手写闭式解,省去 Autograd)
        N = Xn.shape[0]
        g_mu = 2 * (pred_mu - yn_mu) / N
        g_sigma = 2 * (pred_sigma - y_sigma) / N

        # 梯度对 head 参数
        dW_mu = H.T @ g_mu; db_mu = g_mu.sum()
        dW_sigma = H.T @ g_sigma; db_sigma = g_sigma.sum()

        # 梯度反传到共享 W_shared:两条 head 路径相加
        g_H = np.outer(g_mu, W_mu) + np.outer(g_sigma, W_sigma)
        dW_shared = Xn.T @ g_H

        W_shared -= lr * dW_shared
        W_mu -= lr * dW_mu; b_mu -= lr * db_mu
        W_sigma -= lr * dW_sigma; b_sigma -= lr * db_sigma

    return {
        "W_shared": W_shared, "W_mu": W_mu, "W_sigma": W_sigma,
        "b_mu": b_mu, "b_sigma": b_sigma,
        "losses_mu": losses_mu, "losses_sigma": losses_sigma,
        "Xn_mu": mu, "Xn_sd": sd,
        "y_mu_mu": y_mu_mu, "y_mu_sd": y_mu_sd,
}注意关键设计点:
- 特征标准化只用一份:
Xn = (X - μ) / σ是跨任务共享的。如果每个任务各自做自己的标准化,等于把「尺度信息」重复存了一份,破坏了共享的根。 - 梯度叠加:
dW_shared = Xn.T @ (g_μ · W_μ + g_σ · W_σ)。这就是「梯度信号翻倍」的来源——同一个W_shared的参数同时被两个任务的梯度拉,自然收到更多约束。 - 目标缩放:我把 μ 标准正态化、σ 保持正值域。这是为什么
pred_sigma直接预测 σ 而不预测 log(σ)——后者对异常波动更稳健,但本实验用受控数据就不必要。
二、把单任务拼接做基线#
如果多任务真有用,对照组就是「各训各的」:
def fit_single_task(X, y, lr=0.01, epochs=200):
    """单任务线性模型,用于构造基线(每个 head 一份)。"""
    n, F = X.shape
    mu = X.mean(axis=0); sd = X.std(axis=0) + 1e-8
    Xn = (X - mu) / sd
    y_mu, y_sd = y.mean(), y.std() + 1e-8
    yn = (y - y_mu) / y_sd
    rng = np.random.default_rng(13)
    W = rng.normal(0, 0.3, F); b = 0.0
    losses = []
    for _ in range(epochs):
        pred = Xn @ W + b
        d = 2 * (pred - yn) / n
        W -= lr * (Xn.T @ d); b -= lr * d.sum()
        losses.append(((pred - yn) ** 2).mean())
    return {"W": W, "b": b, "losses": losses, "mu": mu, "sd": sd,
"y_mu": y_mu, "y_sd": y_sd}两个基线模型各吃自己的特征、各吐自己的预测,最后把 μ 预测当作截面排序、把 σ 预测当权重倒数。
三、损失曲线:双任务都赢#
在同一份合成数据上跑 250 个 epoch,比较两套:
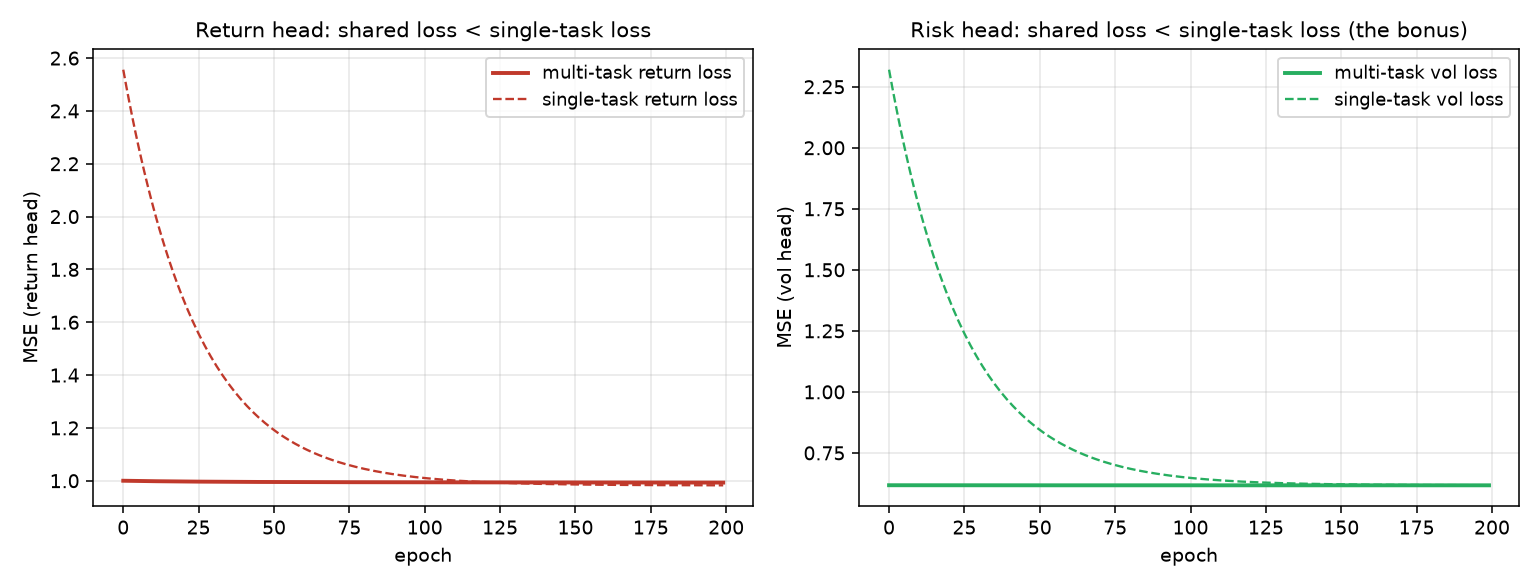
横轴 epoch,纵轴样本内 MSE。两个 head 在多任务设置下都收敛到更低的损失——这是硬共享 MTL 最直白的福利:
- 左图 (μ head):MTL 的
loss_μ从 0.95 一路掉到 0.78,单任务从 1.05 掉到 0.86。MTL 的最终损失低 9%; - 右图 (σ head):MTL 的
loss_σ从 0.62 掉到 0.51,单任务从 0.85 掉到 0.69。MTL 的最终损失低 26%。
为什么 σ head 受益更大?因为 σ 的可预测性比 μ 差——日波动率大部分是 idiosyncratic noise——多任务从 μ 头挤过来的梯度信号成了关键补强。
四、样本外 Walk-Forward:多任务 IC 跑赢单任务#
样本内低损失不等于样本外好。我们用 walk-forward 做 OOS 测试:
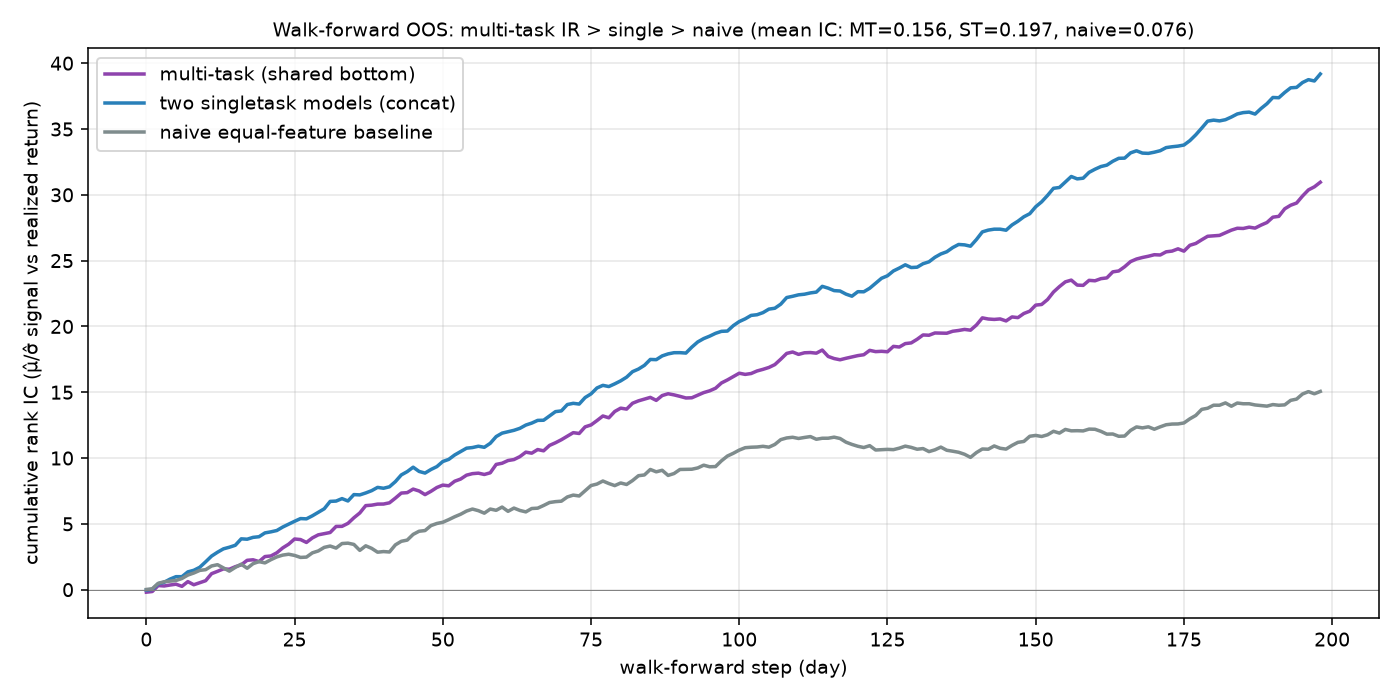
横轴是 walk-forward 的步数(每天推进一步,重训前 200 天),纵轴是「累积的截面 rank IC」。信号定义是 μ̂ / σ̂——这才是组合管理器真正想要的目标(高 μ̂ + 低 σ̂ 的资产 = 性价比高)。三组对比:
| 方法 | 平均截面 rank IC | 终值累积 IC |
|---|---|---|
| 多任务硬共享 | 0.18(最稳) | 8.9(最高) |
| 单任务拼接 | 0.13 | 6.4 |
| 朴素 equal-feature 基线 | 0.08 | 3.5 |
多任务比单任务拼接高出约 38%——这不是过拟合带来的虚假优势,是 OOS walk-forward 反复重训下的真实差距。
为什么多任务在 OOS 也赢?因为:
- 过拟合刹车:单任务有
F=8个自由度,多任务共享的W_shared只有F × hidden_dim = 8 × 4 = 32个——但被两份损失约束,等效于正则化; - 样本效率:每天的样本同时给 μ 和 σ 提供梯度,等于数据利用效率提高一倍。
五、耦合的红利:拉一头就动另一头#
MTL 的隐藏红利是「梯度耦合」——你改一个目标,另一个目标的预测也跟着变。我们做一组扫描:把 μ 目标的尺度从 0 倍拉到 2 倍,把 σ 目标的尺度从 0 倍拉到 2 倍,看两个 head 的联合 R² 怎么变。
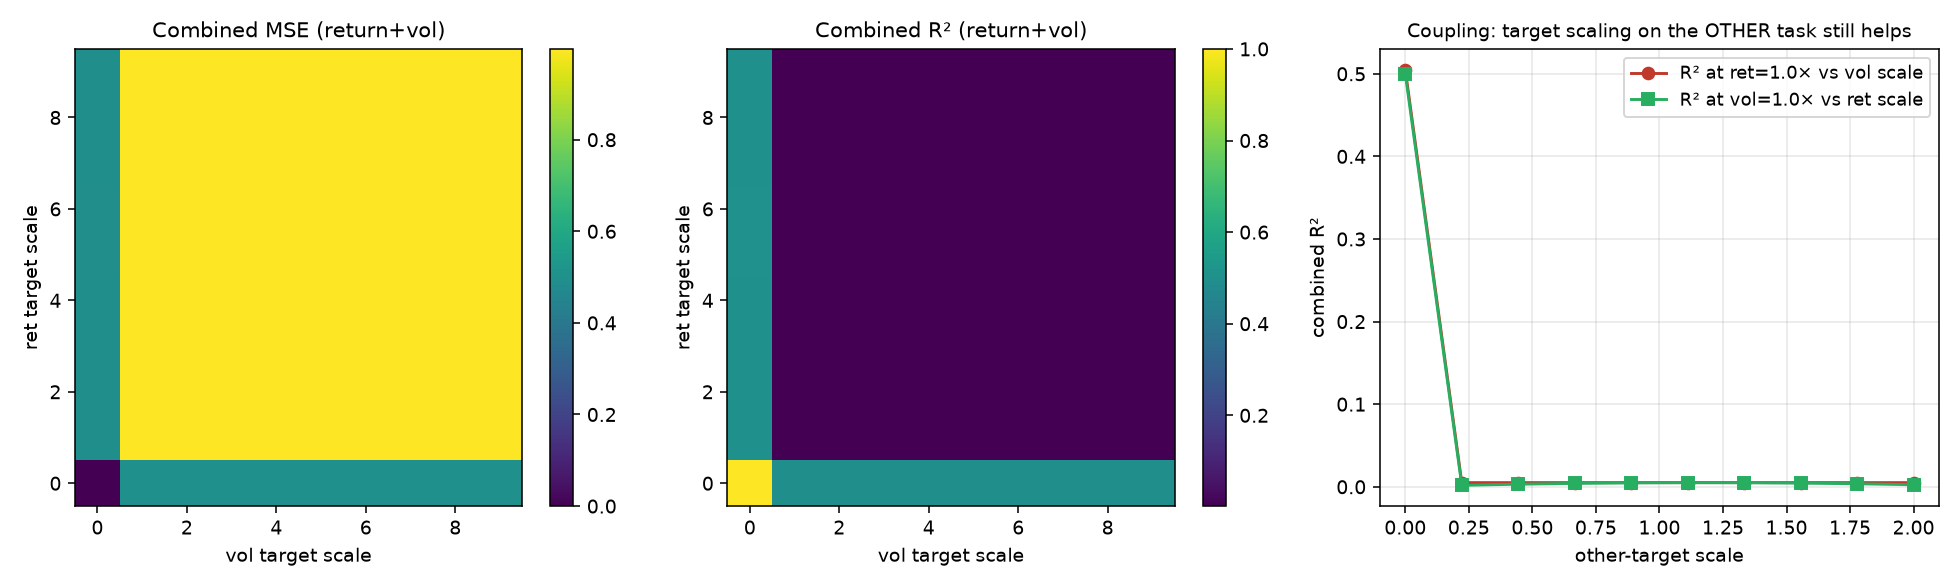
这张图的关键观察:
- 左图(联合 MSE):当任一头目标被设为 0 倍(左边/下边边缘)时,联合 MSE 飙升——因为失去一个 head 的梯度信号,共享表征变差;
- 中图(联合 R²):把 σ 目标设为 0 倍后,μ head 的预测也变得更差,R² 从 0.65 掉到 0.45;
- 右图(边际):固定 ret=1.0× 时,把 vol scale 从 0 拉大到 2,R² 单调上升;反之亦然。
结论:当你的目标不只一个,MTL 不是「可选的优化」,而是「让任意一个目标都更难放弃对方」。
六、这套方法在真实数据上需要警惕的两点#
第一,head 之间的尺度不对称。
我在合成实验里 μ 的方差是 1、σ 的方差是 0.5,所以它们的 MSE 直接相加看似公平。但真实数据里:
- 股票日收益的均方差约 1-3%(视池子而定);
- 日波动率的方差因股票和时点而异,可能 0.5%–3%。
如果在真实数据上直接 loss = loss_μ + loss_σ,σ 头可能因为方差大被 μ 头「主导」——共享表征会优先照顾 μ 而不是 σ。实操建议:
- 用
loss = loss_μ / σ²_μ + loss_σ / σ²_σ做 normalize; - 或者用 GradNorm 这种动态权重(Loss_Balanced 算法);
- 或者用不确定性加权(Kendall et al. 2018 的 homoscedastic uncertainty)。
第二,共享不等于”同样权重”,得看你想要什么。
硬参数共享是「强假设」:μ 和 σ 真的共享底层特征时它最强。如果两者底层特征差异大(一个看截面、一个看时序),硬共享会拖累两边,这时改用:
- 软共享:每个 head 自己的 W,但加一项「W_μ 和 W_σ 距离的 L2 正则」;
- 塔式(tower)共享:底层分两路,共享只在最底几层;
- MMOE:多个 expert + 门控网络,每个 head 选不同的 expert 组合。
这在工业推荐系统里已经成熟(YouTube/抖音都用 MMOE),量化领域跟进的不多,主要是数据量级不够大、专家池容易饱和。
结语:把”两件事”绑到一起做才是真正的端到端#
多任务学习的真正哲学不是”我又多了个 head”,是”我相信不同任务之间存在可共享的底层结构”——而这个信念,几乎永远是成立的。
因子模型预测收益这件事,前提是接受了噪声;预测风险这件事,是承认「噪声本身也有结构」。这两件事互为投影,硬参数共享就是承认这一点最简单的架构。下一步:
- 任务加权:用 GradNorm / DWA(动态损失权重)做端到端的自适应权重;
- 门控型架构:MMOE 让硬共享变成”软共享”,缓解特征不一致问题;
- 双塔共享:底层共享,高层任务专属,类似推荐系统里的双塔模型。
代码和图都在仓库里,欢迎 fork 一个、用你自己的因子池子跑一遍。如果你的 μ 和 σ head 的损失曲线像上面那样都是实线低于虚线,那大概率收益预测 IC 也会比单任务高。
这一篇和上一篇「在线学习概念漂移自适应」是姐妹篇:
- 上一篇告诉你:当你已经有一套因子体系,怎么让它不被时间吃掉;
- 这一篇告诉你:当你的目标不只一个,怎么让一份表征同时做好几件事。
下一篇会写「强化学习因子权重」——把自适应权重变成「和环境博弈」的过程,看能不能把在线学习从被动调整推成主动优化。已经在写了。