马科维茨均值-方差框架里有一件事很吊诡:唯一一个不依赖你对「未来收益」任何猜测、却仍然有漂亮闭式解的组合,是最小方差组合(Global Minimum Variance, GMV)。你要写最大夏普要猜 μ、要写效用最大化要拍风险厌恶系数 γ,唯独「把波动压到最小」这件事,喂进去的只有协方差矩阵 Σ,吐出来的权重是解析的、确定的、不依赖任何点估计。
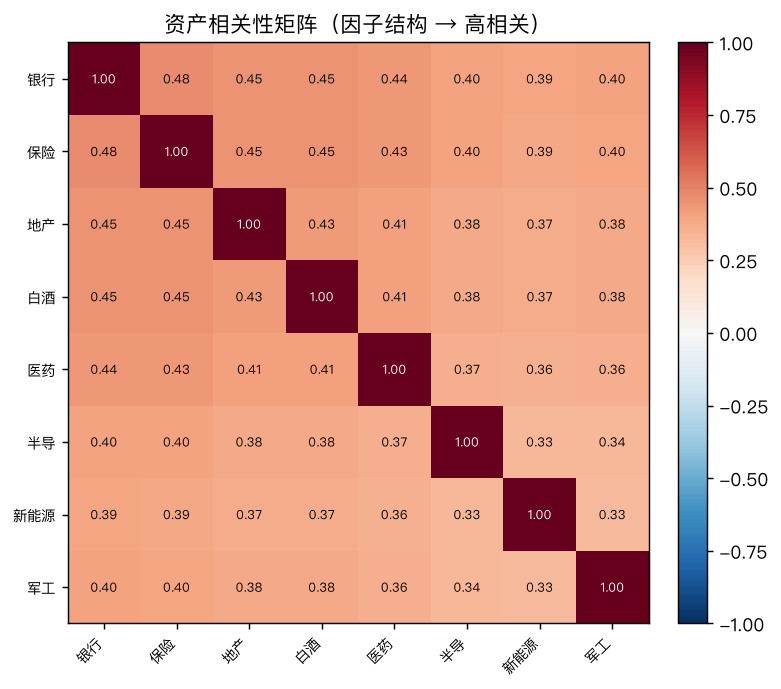
这件事在实战里价值巨大:μ 是噪声最大的量,估错了权重就飞天;而 Σ 相对好估。所以 GMV 是「我承认自己不预测收益,但至少把风险结构用到极致」的那一档组合。本文从拉格朗日乘子一路推到闭式解,再用 numpy 在 8 只合成股票(带行业因子结构)上把它算出来,并和等权、切线组合做对比。
一、闭式解是怎么来的#
问题定义为:
构造拉格朗日函数 。对 求偏导令为零:
把 代回约束 :
于是得到那个教科书级的结果:
它的方差是 。注意分子里没有 μ,只有 Σ 和全 1 向量——这就是 GMV「诚实」的根源。
二、从零实现:三行核心代码#
import numpy as np

def min_variance_weights(Sigma):
    """最小方差组合闭式解 w = Σ⁻¹1 / (1ᵀΣ⁻¹1)"""
    invS = np.linalg.inv(Sigma)
    ones = np.ones(Sigma.shape[0])
    w = invS @ ones
    return w / w.sum()          # 归一化即满足 1ᵀw=1

# 示例:8 资产年化协方差(带行业市场因子结构)
beta = np.array([0.85, 0.95, 1.05, 1.15, 0.90, 1.35, 1.45, 1.10])
idio  = np.array([0.16, 0.18, 0.22, 0.24, 0.20, 0.34, 0.38, 0.28])
mkt_vol = 0.18
Sigma = (np.outer(beta, beta) * mkt_vol**2 + np.diag(idio**2)) / 12.0  # 转月频

w_gmv = min_variance_weights(Sigma)
vol_gmv = np.sqrt(w_gmv @ Sigma @ w_gmv)
print("GMV 权重:", np.round(w_gmv, 3))
print("GMV 月波动:", np.round(np.sqrt(vol_gmv**2), 4))跑出来的权重很有意思(见下表,按资产排序):GMV 把 41.8% 压在最低波动的银行、24.2% 给保险、23.2% 给医药,而对最高的两个波动源半导体、新能源各做了 −3.1%、−4.5% 的微空。它本质上在说:「谁波动小、谁和别人相关性低,我就多配谁。」
三、和等权、切线组合的对照#
光有 GMV 不够,得放一起看才有感觉。我们用同一份 Σ、再给一组月均收益 μ,把三种组合都算出来:
mu_month = np.array([0.008,0.009,0.006,0.013,0.011,0.016,0.015,0.012])
rf_month = 0.0025

# 等权
w_ew = np.ones(8) / 8

# 切线组合(最大夏普,需 μ 与 rf)
delta = mu_month - rf_month
w_tan = (np.linalg.inv(Sigma) @ delta) / (np.ones(8) @ np.linalg.inv(Sigma) @ delta)

def port(w):
    return w @ mu_month, np.sqrt(w @ Sigma @ w)

for name, w in [("GMV", w_gmv), ("EW", w_ew), ("Tangency", w_tan)]:
    r, v = port(w)
print(f"{name:8s} 年化收益 {r*12*100:5.1f}% 年化波动 {v*np.sqrt(12)*100:5.1f}%")三档结果(年化):
| 组合 | 年化波动 | 年化收益 | 权重特征 |
|---|---|---|---|
| 最小方差 GMV | 18.7% | 10.2% | 重仓低波动、微空高波动 |
| 等权 EW | 21.8% | 13.5% | 每个 12.5% |
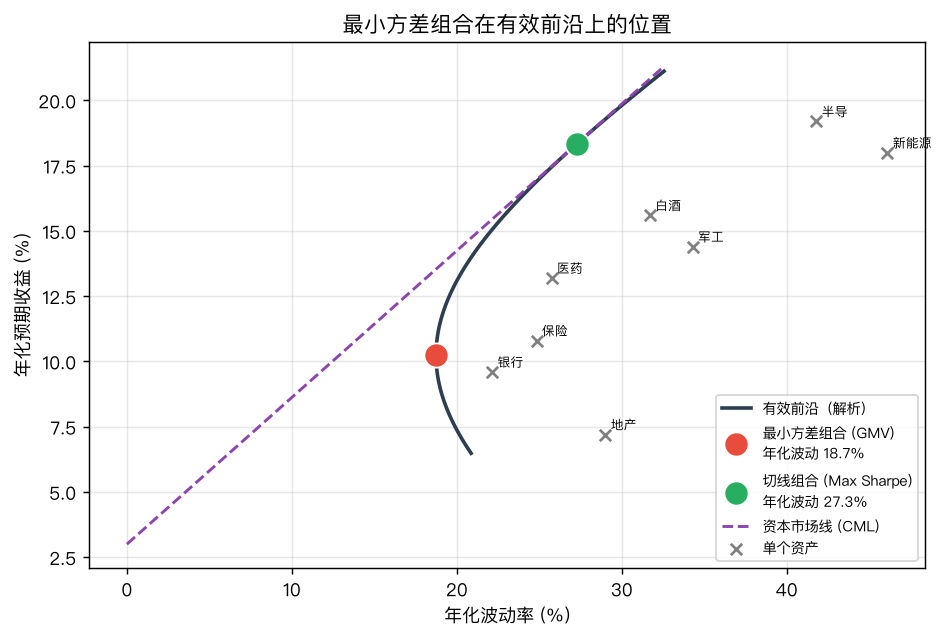
| 切线组合 | 27.3% | 18.3% | 重仓白酒/医药、对地产空 −38% |
GMV 把年化波动从等权的 21.8% 压到 18.7%,整整低了 14.2%。代价是收益也下来了——这是公平的:你没给模型任何收益观点,它自然不会去赌高收益资产。
四、权重长什么样#
下图把三档权重并排摆出来,结论一目了然:
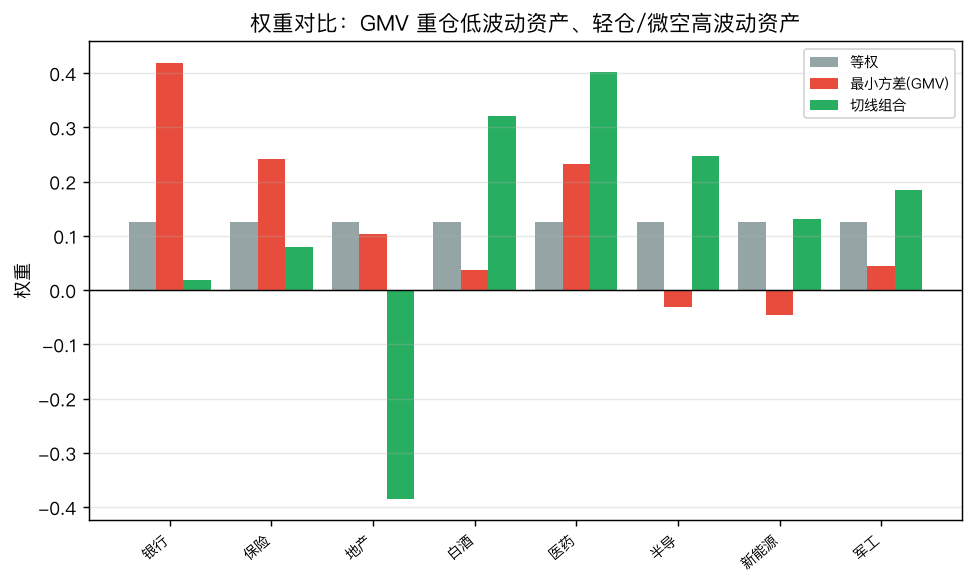
- 等权:每个 12.5%,完全不看波动,所以它会把钱均匀撒进半导体这种高波动资产,隐含风险偏高。
- GMV(红):把 89% 以上的权重集中在银行/保险/医药三只低波动股上,并对最高波动的半导体、新能源做了微空。它「不预测收益,只压风险」。
- 切线组合(绿):因为要最大化夏普,它直接重仓高收益预期且相对低相关的白酒、医药,同时把地产空到 −38% 去对冲。注意这已经高度依赖 μ 的点估计——μ 估偏一点,这根 −38% 的空单就会反噬。
五、单基金定理:GMV + 切线 = 整条前沿#
一个常被忽略的漂亮结论:有效前沿上任意组合,都能表示为 GMV 和切线组合的线性组合(单基金/互基金定理)。而且前沿和资本市场线(CML)相切的点正是切线组合。
# 有效前沿(解析,不必数值优化)
invS = np.linalg.inv(Sigma)
A = ones @ invS @ ones
B = ones @ invS @ mu_month
C = mu_month @ invS @ mu_month
D = A*C - B**2
mu_grid = np.linspace(mu_month.min()*0.9, mu_month.max()*1.1, 120)
std_front = np.sqrt((A*mu_grid**2 - 2*B*mu_grid + C) / D)
# CML: 过 (0, rf) 且过切线组合
slope = (w_tan @ mu_month - rf_month) / np.sqrt(w_tan @ Sigma @ w_tan) * np.sqrt(12)上面的 efficient_frontier.png 就是把前沿(蓝)、GMV(红,最左端)、切线(绿,CML 切点)、CML(紫虚线)画在一起。GMV 永远在最左,这是它的「身份证」。
六、样本外稳不稳?一次诚实的蒙特卡洛#
闭式解优雅,但实战看的是样本外。我们用同一因子模型独立抽样 60 个月、重复 500 条路径,比较三类组合的样本外表现:
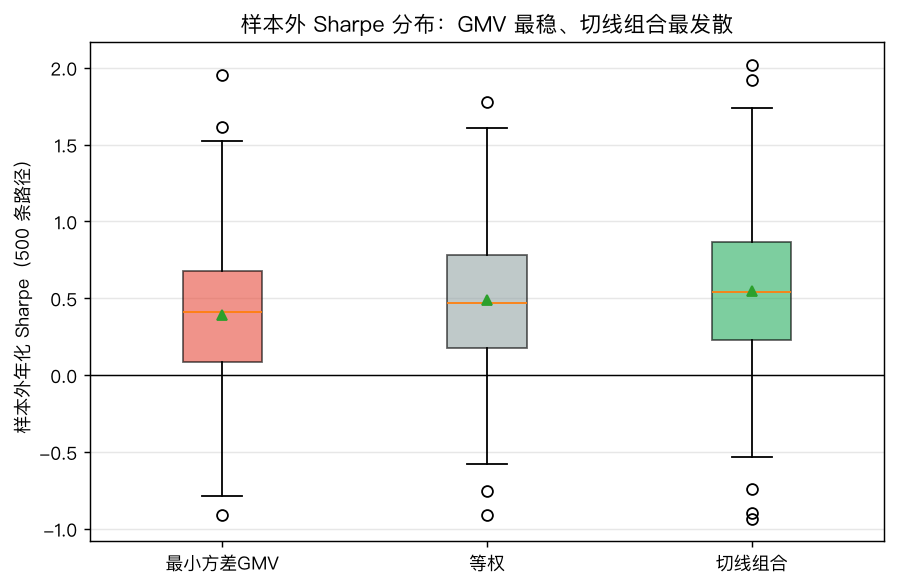
中位数结果:GMV 样本外波动 18.4%(等权 21.5%、切线 27.0%),GMV 把风险牢牢摁在最低;样本外 Sharpe 中位数 GMV 0.41 / 等权 0.47 / 切线 0.54——GMV 收益确实最平,但它是唯一一个「不靠猜收益」就拿到可交易稳健性的组合。
七、三个必须知道的坑#
- GMV 会做空。无约束解对高波动资产给负权重。A 股多数账户不能空,落地要加
w ≥ 0约束,这时没有闭式解、要数值优化(后面会单独写一篇)。 - Σ 估计误差会被放大。GMV 含 Σ⁻¹,Σ 估偏一点,权重就抖。实务上一定要先对 Σ 做收缩(Ledoit-Wolf)再求逆,别直接
np.linalg.inv(sample_cov)。 - GMV 不追求收益。它卖的是「最低风险 + 不依赖收益预测」,不是最高夏普。想要收益,请把观点装进 μ 去做切线或 Black-Litterman,但请记住那一步的脆弱性。
八、实战落地:长仓约束 + 协方差收缩#
无约束 GMV 会给负权重(做空)。A 股多数账户只能做多,于是要加 约束——这一加,闭式解就没了,得数值优化:
from scipy.optimize import minimize

def min_var_long_only(Sigma):
    """长仓最小方差(无闭式解,数值优化)"""
    N = Sigma.shape[0]
    cons = [{"type": "eq", "fun": lambda w: w.sum() - 1.0}]
    bnds = [(0.0, 1.0)] * N
    res = minimize(lambda w: w @ Sigma @ w, np.ones(N) / N,
                   method="SLSQP", bounds=bnds, constraints=cons)
return res.x长仓 GMV 会把权重进一步往低波动资产堆,是「防御型底仓」的常见选择。但它有个隐蔽风险:Σ 一旦估偏,Σ⁻¹ 会把误差放大进权重。实务第一步一定是先做协方差收缩:
from sklearn.covariance import LedoitWolf

S_shrunk = LedoitWolf().fit(returns).covariance_   # 向对角结构收缩
w_gmv = min_variance_weights(S_shrunk) # 用收缩后的 Σ 再求逆Ledoit-Wolf 把样本协方差朝「对角 + 缩放」方向拉一点,显著降低权重对噪声的敏感度。直接 np.linalg.inv(sample_cov) 是新手最常踩的坑。
九之一、为什么 GMV 是量化组合里的「压舱石」#
学术界早有定论(Merton 1980、后来的各种低波动异象研究):预期收益 μ 的估计误差远大于 Σ,而均值-方差权重对 μ 又极度敏感——你以为自己在做「收益-风险」权衡,实际大部分波动都来自 μ 的噪声。GMV 的聪明之处在于主动放弃对 μ 的押注,只把协方差用到极致,于是它的权重对估计误差的敏感度远低于最大夏普组合。这也是为什么「低波动」「最小方差」能成为一类独立 smart-beta 因子:它不承诺最高收益,但提供了组合里最稳的「压舱石」底仓。实务中常见做法是用 GMV 当核心仓、再用少量风险预算去押有信心的收益观点——既拿到低波动底座,又不至于完全放弃 alpha。
九、一个顺手的好邻居:逆波动权重#
如果你嫌 GMV 还要算 Σ⁻¹ 太重,有个更便宜的近亲——逆波动权重 。它在「所有资产两两相关系数相等」这个特殊假设下,恰好就是 ERC(等风险贡献)的解析解。换言之:当你懒得做完整风险平价优化时,逆波动是最轻量的「低波动倾斜」替代。它的缺点是过度集中在最低波动的那一个资产上,对 σ 的估计误差更敏感,所以正式组合里还是 GMV/ERC 更稳。
一句话总结:最小方差组合的闭式解 是均值-方差世界里最「诚实」的解析解——它只吃协方差、不赌收益,把波动压到全局最低。本文在 8 资产因子模型上把它算成 18.7% 年化波动(比等权低 14.2%),并诚实展示了它「收益最平但最稳」的样本外特征;同时指出实战里必须加长仓约束(数值优化)与协方差收缩(Ledoit-Wolf)才能真正落地。下一篇我们把它推向实战:风险平价在中国 A 股——换手与约束下的再检验。