非同步交易与 Dimson Beta:用滞后市场收益修正被低估的系统性暴露
小盘股 beta 低得不合理,常被解读成「防御性强」——但这个数字可能大部分是测量假象。300 只股票、1500 天、真实 beta 完全已知的受控模拟,唯一变量是「今天有没有成交」:非交易日占比 55% 时普通 OLS 把真实 1.08 估成 0.49(偏误 -55.14%,20 个种子散布仅 ±1 个百分点);Dimson 3 阶收回到 -7.28%,相关从 0.783 升到 0.940、RMSE 从 0.383 降到 0.144。但修正不免费:全流动对照组 OLS 偏误仅 +0.14% 而 Dimson 3 阶 RMSE 是它的 2.5 倍——对流动股用 Dimson 是纯亏方差。最狠的是低 beta 异象证伪:在 alpha 严格为零的世界里,仅凭测量误差,按 OLS beta 排序的最低五分位就跑出 +1.65% 伪 alpha,而这组 73.3% 是最不流动股票——按 beta 排序等价于按流动性排序。滞后剖面:t 期只贡献 45.0% 恰好对应 55% 停摆率,领先项等于噪声证明无 look-ahead。置换 200 次无一次超越。
问题:小盘股的 beta 为什么总是低得可疑#
拉一份 A 股全市场的 beta 表,按市值排序,你几乎必然看到这样的图景:大盘股 beta 集中在 1.0 附近,小盘股的 beta 中位数明显低于 1,最不流动的那一批甚至能低到 0.5 以下。
对这个现象最常见的解读是「小盘股防御性强」或者「小盘股不跟大盘」。两种解读都很难成立——小盘股的日波动率通常比大盘股更高,一个波动更大的资产同时对市场暴露更低,这需要极高的特质波动占比来支撑,而实际数据里小盘股在市场暴跌时跌得只多不少。
真正的解释藏在一个很土的地方:这只股票今天到底有没有成交。
如果一只股票在 t 日没有成交,它的收盘价就是 t-1 日的收盘价,你算出来的 t 日收益是 0。市场在 t 日跌了 2%,这只股票的「收益」纹丝不动。等到 t+1 日它终于成交了,价格一次性把两天的信息都反映掉。你手上的收益序列因此变成了一个被时间上打散的版本:真实的同期反应被切成碎片,分散到当天和之后若干天。
回归 r_i = α + β·r_m + ε 只看同期,那些被推迟到后面几天的反应全部进了残差。同期协方差被系统性削掉,beta 被系统性低估。
这就是非同步交易(non-synchronous trading)偏误。Dimson (1979) 给出的修正简单到有点粗暴:把滞后和领先的市场收益一起塞进回归,再把所有系数加起来。
本文用一个真实 beta 完全已知的受控模拟,测量这个偏误到底有多大、Dimson 修正能收回多少、代价是什么,以及一个更值得警惕的推论——多少「因子异象」其实是这个测量误差的产物。
模拟设计:唯一的变量是「今天有没有成交」#
之所以要做受控模拟而不是直接跑真实数据,原因很直接:真实数据里你永远不知道真实 beta 是多少。你只能比较两个估计量,无法判断谁更接近真相。模拟里真实 beta 是我设定的参数,任何偏离都可以直接归因。
设定如下:
- 300 只股票,1500 个交易日(约 6 年)
- 市场收益
r_m ~ N(0.03%, 1.1%)日频 - 每只股票的真实 beta 从 U(0.4, 1.8) 抽取,在整个样本期恒定
- 特质波动 σ_i 从 U(1.2%, 3.0%) 抽取
- 真实收益
r_i,t = β_i · r_m,t + σ_i · z_i,t,这是股票的内在价值变化
关键的一步是把「真实价格」变成「你能观测到的价格」:
def simulate(rng, N, T, mkt, ptrade_vec, beta_true, sig_idio):
    """真实收益生成 -> 随机停摆 -> 观测收益"""
    true_r = beta_true[None, :] * mkt[:, None] + rng.normal(0, 1, (T, N)) * sig_idio[None, :]
    logp_true = np.cumsum(true_r, axis=0)          # 真实对数价格路径

    trades = rng.random((T, N)) < ptrade_vec[None, :]
    trades[0, :] = True
    trades[-1, :] = True

    obs_logp = np.empty((T, N))
    last = logp_true[0].copy()
    for t in range(T):
        m = trades[t]
        last = np.where(m, logp_true[t], last)     # 成交 -> 更新到真实价; 不成交 -> 沿用上一价
        obs_logp[t] = last

return np.diff(obs_logp, axis=0, prepend=obs_logp[:1])注意这里的核心机制:信息没有丢失,只是被推迟了。 不成交的日子价格冻结在上一次成交价,一旦成交,价格直接跳到当期真实价——中间积累的所有信息一次性释放。这正是真实市场里薄交易股票的行为。
300 只股票按流动性分成 5 组,非交易日占比分别是 0%、10%、25%、40%、55%。最后一组大致对应新三板或港股仙股的活跃度。
结果一:偏误大到离谱,且严格随流动性单调#
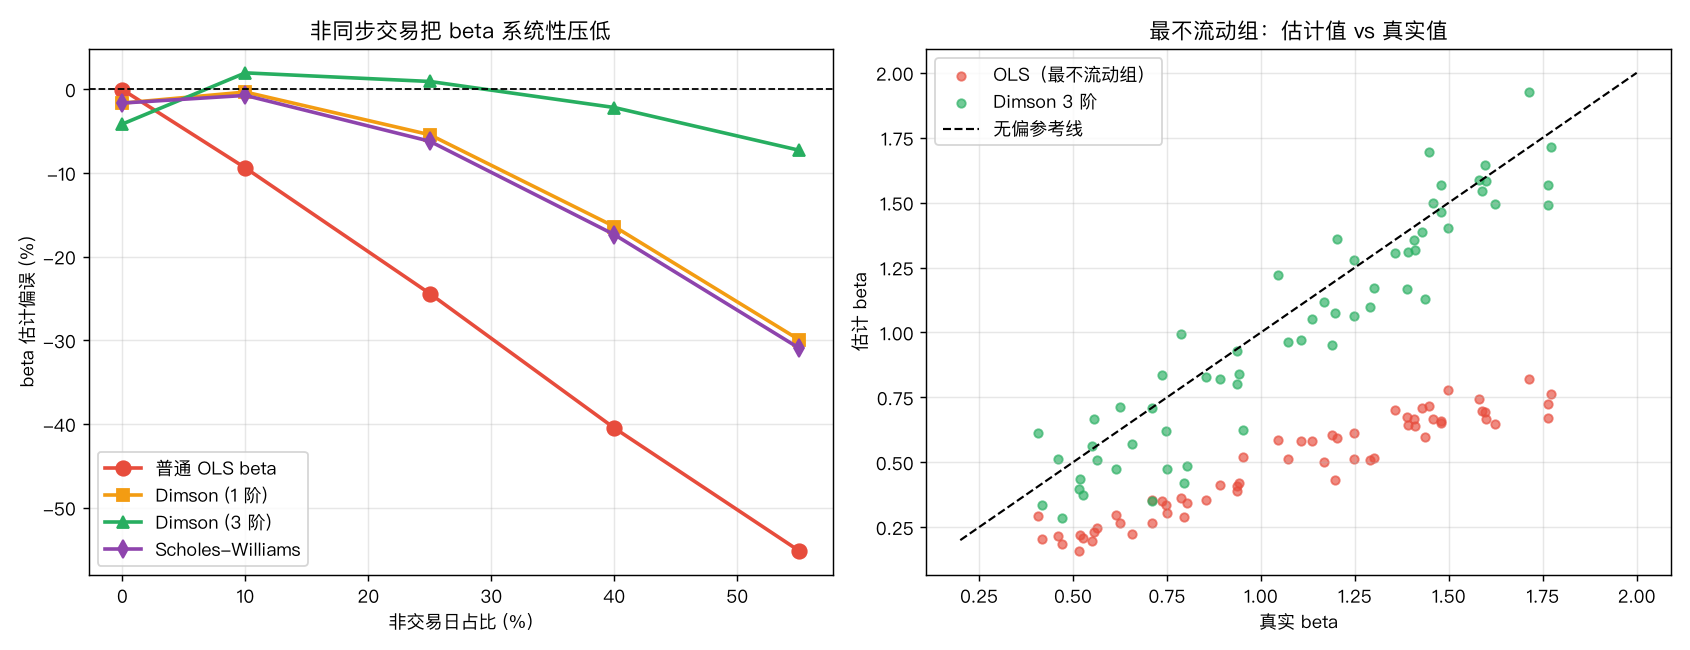
| 非交易日占比 | 真实 beta 均值 | OLS beta | OLS 偏误 | Dimson 1 阶 | 偏误 | Dimson 3 阶 | 偏误 | Scholes-Williams | 偏误 |
|---|---|---|---|---|---|---|---|---|---|
| 0% | 1.114 | 1.112 | -0.05% | 1.098 | -1.66% | 1.082 | -4.16% | 1.098 | -1.65% |
| 10% | 1.013 | 0.913 | -9.41% | 0.997 | -0.34% | 1.023 | +1.96% | 0.993 | -0.74% |
| 25% | 1.192 | 0.903 | -24.43% | 1.124 | -5.44% | 1.187 | +0.93% | 1.115 | -6.22% |
| 40% | 1.070 | 0.636 | -40.49% | 0.893 | -16.41% | 1.044 | -2.19% | 0.883 | -17.38% |
| 55% | 1.081 | 0.486 | -55.14% | 0.762 | -29.92% | 1.011 | -7.28% | 0.751 | -30.92% |
先看第一行:完全流动的组,OLS 偏误 -0.05%。这是引擎正确性的证明——没有非同步交易时,普通回归是无偏的,所有后面的偏误都可以干净地归因到停摆机制。
再看最后一行:真实 beta 1.081,OLS 估出 0.486。一只真实上跟市场同步跳动、甚至放大市场波动的股票,被测量成一个防御性资产。 如果你用这个 beta 做对冲比例,你会严重对冲不足;如果你用它算风险预算,你会以为组合的市场暴露只有实际的一半。
偏误对非交易概率的关系近似线性——回归斜率 -1.010,也就是非交易概率每上升 10 个百分点,beta 被压低约 10%。这个近似的一比一关系在直觉上很好理解:如果一只股票有 55% 的日子不动,它的同期协方差大致只保留了 45% 左右。
Dimson 3 阶把最不流动组的偏误从 -55.14% 收回到 -7.28%。 这不是微调,是从「结论完全错误」到「有一点残余偏误但方向和量级都对了」的质变。
Dimson 的做法本身很简单:
def dimson_beta(y, mkt, k=1):
    """把 t-k ... t+k 的市场收益全部放进回归,系数求和"""
    T = len(y)
    cols = [mkt[k + j : T - k + j] for j in range(-k, k + 1)]
    X = np.column_stack([np.ones(T - 2 * k)] + cols)
    yy = y[k : T - k]
    coef, *_ = np.linalg.lstsq(X, yy, rcond=None)

    # 系数和的标准误:w'Σw,w 在所有 beta 项上为 1
    resid = yy - X @ coef
    s2 = resid @ resid / (len(yy) - X.shape[1])
    cov = s2 * np.linalg.inv(X.T @ X)
    w = np.zeros(X.shape[1]); w[1:] = 1.0
return float(coef[1:].sum()), float(np.sqrt(w @ cov @ w))注意标准误的算法:不能把各期系数的标准误直接相加或平方相加,因为滞后市场收益之间存在自相关,系数估计是相关的。必须用 w'Σw 的完整二次型。这是实现里最容易错的一处。
Scholes-Williams 用的是另一套逻辑(对滞后/同期/领先分别单变量回归,再用市场自相关做调整),结果和 Dimson 1 阶几乎重合(-30.92% vs -29.92%)——它本质上是一个 1 阶方法,在停摆 55% 的极端场景下阶数不够。方法之争在这里不重要,阶数够不够才重要。
结果二:信息躺在过去,不在未来#
Dimson 回归同时放了领先项(t+1、t+2、t+3)。它们有用吗?
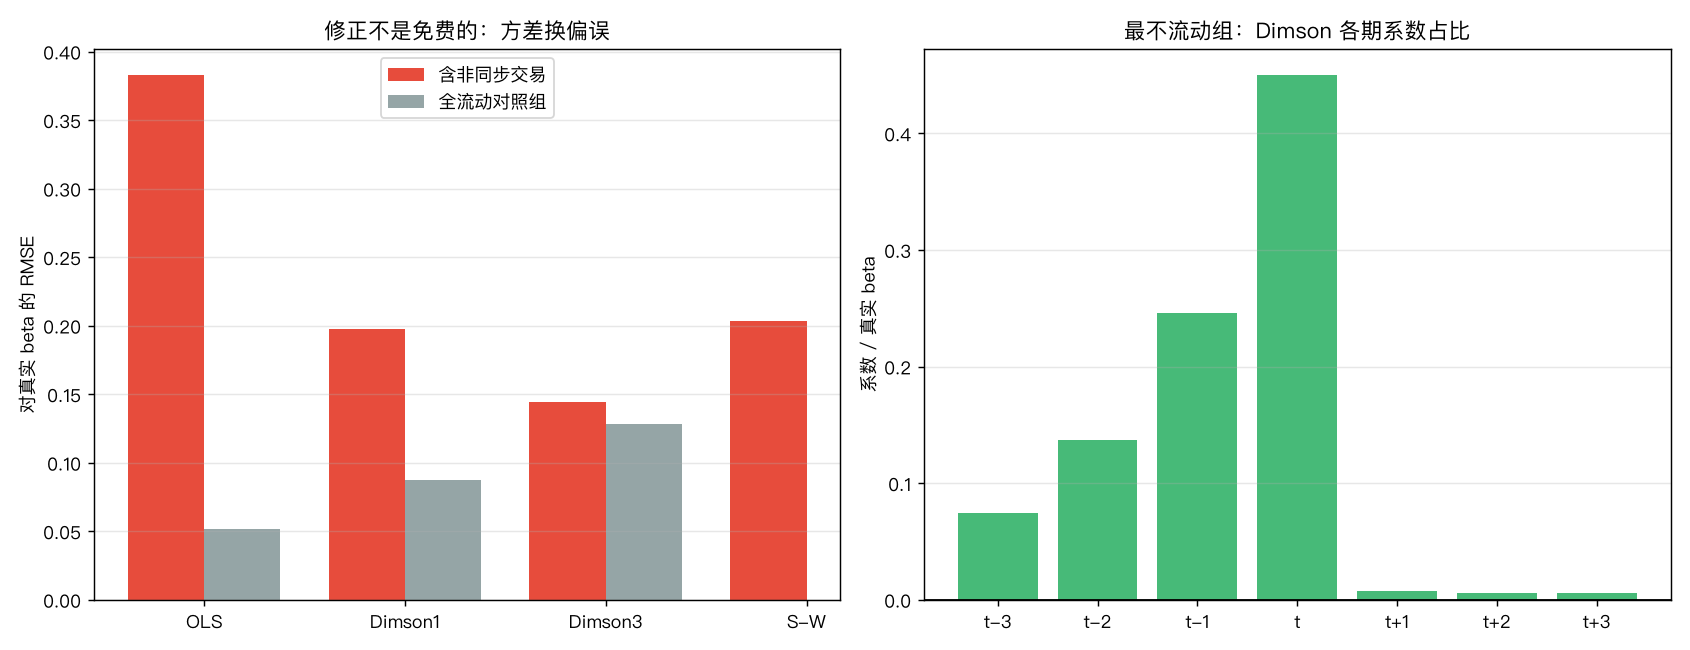
最不流动组的各期系数占真实 beta 的比例:
| 期 | t-3 | t-2 | t-1 | t | t+1 | t+2 | t+3 |
|---|---|---|---|---|---|---|---|
| 系数/真实 beta | 0.074 | 0.137 | 0.246 | 0.450 | 0.008 | 0.006 | 0.006 |
三个数字值得注意:
- 同期只贡献 45.0%——和「55% 的日子不成交」几乎精确对应。这不是巧合,是机制的直接读数。
- 滞后项贡献 45.8%(0.074+0.137+0.246),且按时间距离单调衰减。被推迟的反应主要在 1-2 天内补回来。
- 领先项贡献几乎为零(合计 0.020)。
第 3 点是这个模拟的一个内部一致性检验。领先项系数应该为零,因为在我的数据生成过程里,股票收益只依赖当期和过去的市场信息,不可能依赖未来。如果领先项跑出显著非零,说明代码里有 look-ahead。 实测 0.006-0.008 的量级等于噪声,引擎干净。
那实盘为什么还要放领先项?因为真实市场里领先项可能真的非零——如果是市场指数本身包含大量不流动成分股(这在小盘指数里很常见),指数收益反而会滞后于个股。领先项是为这种反向非同步准备的。在本模拟设定(指数完全流动)下,它们的唯一作用是消耗自由度。
各期系数合计 0.927,剩下的 7.3% 就是 -7.28% 的残余偏误来源:3 阶窗口截断掉了 t-4 及更远的尾巴。加大 k 可以继续收敛,但代价见下一节。
结果三:修正不是免费的,是拿方差换偏误#
这是最容易被忽略的一半。全流动对照组(所有股票 100% 每日成交)的结果:
| 方法 | 偏误 | RMSE | 平均标准误(全样本) |
|---|---|---|---|
| OLS | +0.14% | 0.052 | 0.048 |
| Dimson 1 阶 | -0.43% | 0.088 | 0.083 |
| Dimson 3 阶 | +0.48% | 0.128 | 0.127 |
没有非同步交易时,Dimson 的 RMSE 是 OLS 的 2.5 倍。 偏误都接近零(这本身也是对 Dimson 的一个校验:它在不该修正的地方没有乱修),但方差爆炸——多塞 6 个几乎无信息的解释变量,每个都带来估计噪声,加总时噪声也加总。
标准误的代价在分层表里同样清楚:最不流动组 OLS 标准误 0.057,Dimson 1 阶 0.099,Dimson 3 阶 0.150。你用 2.6 倍的标准误换回了 48 个百分点的偏误修正。
在有偏误的场景里这笔交易极其划算——全样本 RMSE:OLS 0.383、Dimson 1 阶 0.198、Dimson 3 阶 0.144、S-W 0.204。与真实 beta 的横截面相关系数从 OLS 的 0.783 升到 Dimson 3 阶的 0.940。
但结论必须成对来说:
对流动股用 Dimson 是纯亏方差。 只在薄交易资产上用,且阶数要按停摆程度选,不是越高越好。
一个实务上的经验规则:如果一只股票的日收益序列里零收益占比低于 5%,直接 OLS;5%-20% 用 1 阶;20% 以上考虑 3 阶。零收益占比是可以直接观测的,不需要猜。
结果四:低 beta 异象——一个被测量误差凭空造出来的「alpha」#
到这里为止都是估计量的技术讨论。下面这一段才是真正应该让人警觉的部分。
我在模拟里构造了一个没有任何异象的世界:每只股票的真实预期年化收益严格等于 β_true × 6%,CAPM 完美成立,alpha 恒等于零。然后分别按真实 beta、OLS beta、Dimson beta 排序分五组。
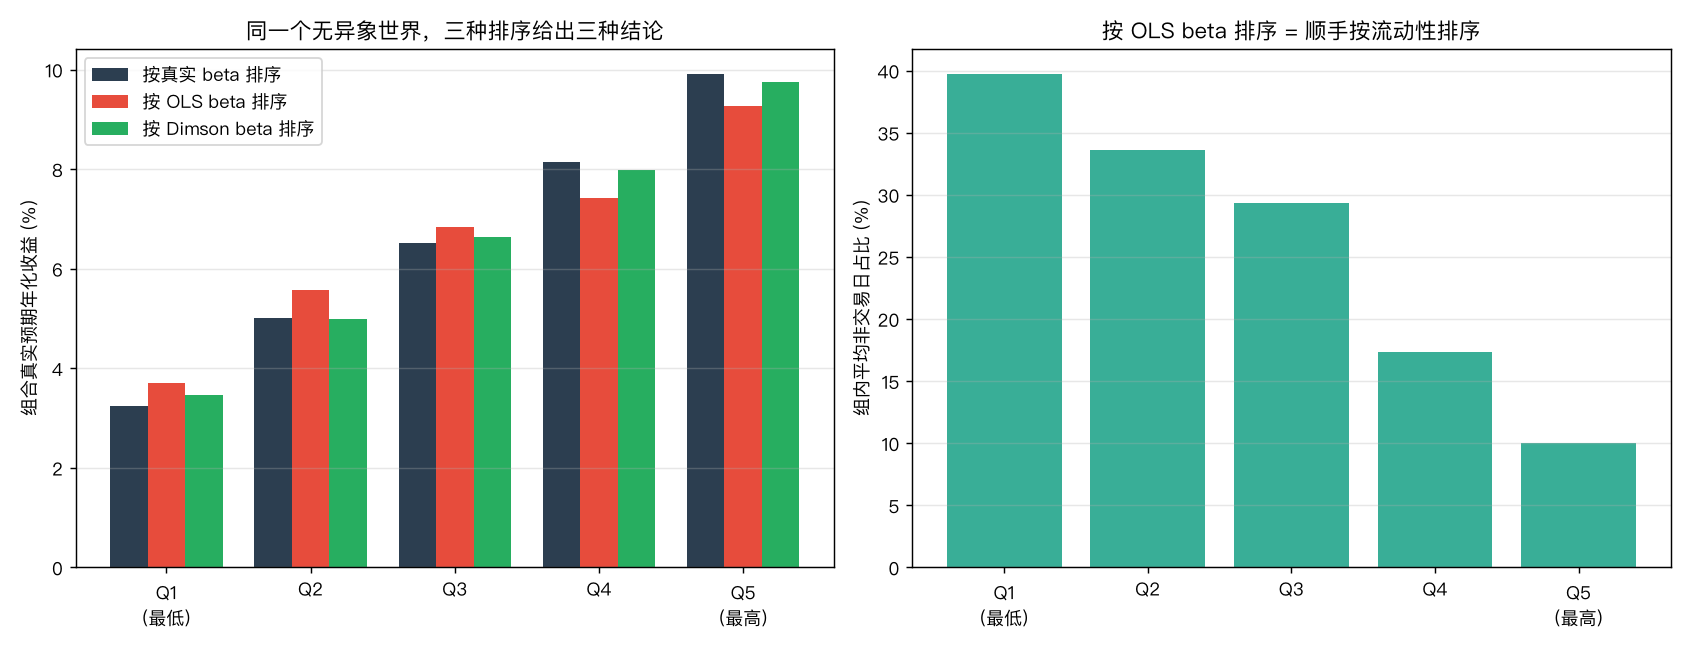
| 分组 | 按真实 beta 排序 | 按 OLS beta 排序 | 按 Dimson 3 阶排序 |
|---|---|---|---|
| Q1(最低) | 3.24% | 3.71% | 3.47% |
| Q2 | 5.01% | 5.58% | 4.99% |
| Q3 | 6.51% | 6.84% | 6.64% |
| Q4 | 8.14% | 7.43% | 7.98% |
| Q5(最高) | 9.92% | 9.27% | 9.75% |
| Q5−Q1 跨度 | 6.68% | 5.56% | 6.28% |
按 OLS beta 排序,Q5−Q1 的收益跨度被压缩了 16.8%(5.56% vs 6.68%)。也就是说,在一个 CAPM 完美成立的世界里,用 OLS beta 排序会让你看到一条比真相更平坦的证券市场线——这正是低 beta 异象文献里最经典的实证图形。
更直接的证据在 Q1 组:
| 指标 | 数值 |
|---|---|
| Q1 组 OLS beta 均值 | 0.344 |
| Q1 组真实 beta 均值 | 0.619 |
| Q1 组真实预期收益 | 3.71% |
| 用 OLS beta 算出的「alpha」 | +1.65% |
| Q1 组中最不流动股票占比 | 73.3% |
你测出 beta 0.344,CAPM 预测收益 0.344×6% = 2.06%,实际拿到 3.71%,凭空多出 1.65 个百分点的年化 alpha。
这 1.65% 一分钱都不存在。它完全来自 beta 被低估了 0.275。而 Q1 组里 73.3% 是非交易日占比 ≥40% 的股票——「按 beta 排序」在薄交易市场里等价于「按流动性排序」,你以为在做因子分组,其实在做流动性分组。
右图把这一点画得很直白:按 OLS beta 排序,各组的平均非交易日占比从 Q1 的 39.8% 单调降到 Q5 的 10.0%;而按真实 beta 排序,五组的流动性分布基本持平(24.5%-27.6%)。流动性污染是排序变量本身带进来的,不是样本自带的。
用 Dimson beta 排序,Q5−Q1 跨度回到 6.28%(真相 6.68% 的 94%),异象基本消失。
我不认为这个模拟证明了现实中的低 beta 异象全是假的——真实市场里有杠杆约束、彩票偏好等实打实的机制。但它确立了一个必须先过的关卡:
任何在含薄交易资产的样本上发现的 beta 相关异象,都必须先用非同步修正后的 beta 复现一遍。 复现不了的,优先归因于测量误差,而不是新发现。
对照检验:这个偏误是真机制还是我编的#
一个模拟能跑出漂亮的单调关系不说明任何问题——参数是我设的,出现设定好的模式是应该的。真正需要验证的是:这个关系是不是由我以为的那个机制产生的。
置换检验:打乱流动性归属#
如果偏误真的由停摆造成,那么把流动性标签在股票之间随机打乱后,「偏误 vs 非交易概率」的关系应该消失。
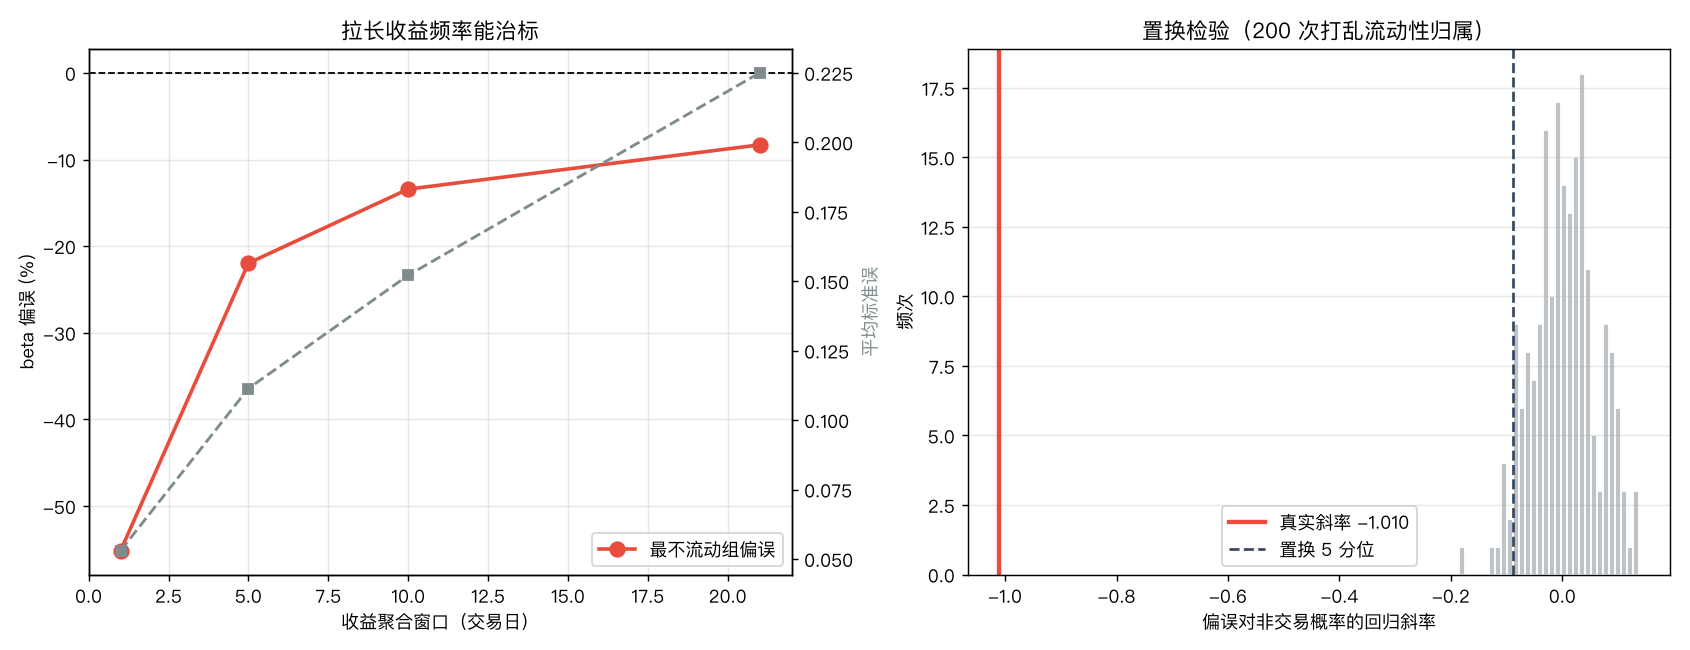
200 次打乱:
| 统计量 | 数值 |
|---|---|
| 真实斜率 | -1.010 |
| 置换均值 | 0.004 |
| 置换 5 分位 | -0.088 |
| 置换中超过真实值的次数 | 0 / 200 |
真实斜率比置换分布的最极端值还远 11 倍以上。关系是机制性的,不是数据挖出来的。
多种子稳健性#
单个种子的结果可能是运气。20 个独立种子重跑最不流动组:
| 指标 | 均值 | 标准差 | 最小 | 最大 |
|---|---|---|---|---|
| OLS 偏误 | -55.31% | 0.98% | -58.03% | -53.42% |
| Dimson 3 阶偏误 | -9.96% | 1.59% | — | — |
OLS 偏误在 20 个种子里的散布只有 ±1 个百分点,这是一个极其稳定的结构性偏误,不是抽样波动。 Dimson 修正后的残余偏误 -9.96% 也稳定(基准种子上的 -7.28% 落在正常散布内)。
时间聚合:一个不需要 Dimson 的替代方案#
既然问题是「一天太短,很多股票没反应过来」,那用更长的收益频率是不是就能绕过去?
| 聚合窗口 | 最不流动组偏误 | 全样本偏误 | 平均标准误 | 有效观测数 |
|---|---|---|---|---|
| 日频 | -55.14% | -25.90% | 0.053 | 1500 |
| 周频(5 日) | -21.96% | -8.78% | 0.111 | 300 |
| 双周(10 日) | -13.42% | -5.18% | 0.152 | 150 |
| 月频(21 日) | -8.31% | -2.95% | 0.225 | 71 |
有效。月频把偏误从 -55% 压到 -8%,和 Dimson 3 阶(-7.28%)基本相当。
但代价更重:标准误 0.225,是日频 OLS 的 4.2 倍,也明显高于 Dimson 3 阶的 0.150。 6 年数据只剩 71 个观测,任何时变性都无法捕捉,滚动窗口更是无从谈起。
结论是:两条路都能治,但在同等偏误水平下 Dimson 的方差代价更小,且保留了日频数据用于滚动估计的可能。月频聚合更适合做交叉验证——如果 Dimson beta 和月频 beta 大致吻合,你对修正结果的信心会高很多;如果两者差很远,说明有别的问题(比如 beta 本身在时变)。
完整实现#
import numpy as np

def dimson_beta(y, mkt, k=1):
    """Dimson (1979) 聚合系数 beta,返回 (beta, 标准误)"""
    T = len(y)
    cols = [mkt[k + j : T - k + j] for j in range(-k, k + 1)]
    X = np.column_stack([np.ones(T - 2 * k)] + cols)
    yy = y[k : T - k]
    coef, *_ = np.linalg.lstsq(X, yy, rcond=None)
    resid = yy - X @ coef
    s2 = resid @ resid / (len(yy) - X.shape[1])
    cov = s2 * np.linalg.inv(X.T @ X)
    w = np.zeros(X.shape[1]); w[1:] = 1.0
    return float(coef[1:].sum()), float(np.sqrt(w @ cov @ w))   # 必须用二次型

def scholes_williams(y, mkt):
    """Scholes-Williams (1977),用市场自相关做调整"""
    T = len(y)
    yy = y[1:T-1]
    b0 = _ols(yy, mkt[1:T-1])
    bm = _ols(yy, mkt[0:T-2])
    bp = _ols(yy, mkt[2:T])
    rho = _ols(mkt[1:T-1] - mkt[1:T-1].mean(), mkt[0:T-2])
    return (b0 + bm + bp) / (1 + 2 * rho)

def _ols(y, x):
    xc, yc = x - x.mean(), y - y.mean()
    return float(xc @ yc / (xc @ xc))

def choose_estimator(returns, mkt):
    """按零收益占比自动选阶——不要对流动股用 Dimson"""
    zero_share = float((np.abs(returns) < 1e-10).mean())
    if zero_share < 0.05:
        return "ols", _ols(returns, mkt), zero_share
    k = 1 if zero_share < 0.20 else 3
    b, se = dimson_beta(returns, mkt, k)
return f"dimson{k}", b, zero_sharechoose_estimator 里的零收益占比是实盘落地的关键——它直接可观测,不需要任何假设,而且和模拟里的停摆概率是同一个东西。先量出这个数,再决定用什么估计量。
需要注意一个实盘细节:A 股的零收益不完全等于「没成交」。涨跌停封死时有成交但价格不动,也会产生零收益。这两种情况对 beta 估计的影响方向一致(都削弱同期协方差),所以用零收益占比做判据在方向上是对的,但它会略微高估真实停摆程度。
已知偏差#
1. 停摆是独立随机的,真实世界是聚集的。 模拟里每天是否成交服从独立伯努利,而真实的薄交易股票经常连续多日无成交,然后在某个消息驱动下连续活跃。聚集性会让偏误结构更复杂——独立停摆下 3 阶窗口够用,聚集停摆需要更长窗口,模拟里的 -7.28% 残余偏误在真实数据上大概率更差。
2. beta 设为常数。 真实 beta 随时间变化(尤其在市场 regime 切换时)。这个设定让 Dimson 的长窗口需求显得没有代价,但实盘上「窗口越长偏误越小」和「窗口越长时变性丢得越多」是直接冲突的。本文没有测量这个权衡。
3. 市场指数假设完全流动。 因此领先项系数为零。真实的小盘指数本身包含大量薄交易成分,指数收益会滞后于流动个股,此时领先项承担真实作用,Dimson 的对称窗口设计才有意义。用大盘指数(沪深 300)做基准时这个问题不大,用小盘指数(中证 2000)时需要重新检查领先项。
4. 无买卖价差回弹。 真实的薄交易股票同时存在 bid-ask bounce,它给收益序列注入负一阶自相关,方向上会进一步压低 beta 估计。本文只隔离了非同步交易一个机制,真实偏误应该比 -55% 更大一些。
5. 「低 beta 异象全是假的」不成立。 模拟只证明了测量误差足以制造一个看起来像异象的模式,不证明现实中的异象就是这么来的。杠杆约束假说和彩票偏好假说在流动性大盘股上同样有实证支持,那些样本里非同步偏误可以忽略。
结果解读#
这个偏误的量级足以让风险模型失效,而不只是「有点不准」。 -55% 意味着一个真实 beta 1.08 的资产被登记为 0.49。如果你的组合里有 20% 权重在这类资产上,组合层面的市场暴露会被系统性低估约 12 个百分点。这不是精度问题,是方向性错误——你会在自以为中性的时候实际做多市场。
修正的收益高度集中在尾部。 分层表读下来,10% 停摆组 OLS 偏误只有 -9.41%,25% 组 -24.43%。前两组用不用 Dimson 差别不大(而且 Dimson 3 阶在流动组反而更差)。真正需要修正的是 40% 以上的那一小撮。所以正确的做法不是全市场统一换估计量,是先分层、再决定。 全市场无脑用 Dimson,你会在 80% 的股票上白白付方差成本。
滞后剖面是最好的诊断工具。 t 期系数占比 0.450 直接读出了停摆程度,滞后项的衰减速度告诉你信息补回来有多快。实盘上跑一遍 Dimson 回归,把各期系数打印出来看形状——如果 t-1、t-2 系数显著为正,非同步偏误确实存在;如果滞后项全是噪声但 beta 还是偏低,问题在别处(比如这只股票真的就是低 beta)。这比任何统计检验都直观。
方差代价必须计入决策,而不是修正完就完事。 Dimson 3 阶在最不流动组的标准误 0.150,意味着一个点估计 1.01 的 95% 置信区间大致是 [0.72, 1.31]。你确实消除了偏误,但区间宽到几乎不能用于精确对冲。诚实的说法是:Dimson 让你知道「这只股票的 beta 大概是 1 而不是 0.5」,但它给不了你一个可以直接拿去算对冲手数的数字。 对于薄交易资产,beta 本来就是一个不精确的量,修正只是把「精确的错误」换成「不精确的正确」。
对异象研究的启示比对 beta 估计本身更重要。 那个 +1.65% 的伪 alpha 是在一个我亲手构造的、alpha 严格为零的世界里跑出来的。它通过了所有常规检查——分组单调、跨度可观、样本量充足。唯一能识破它的方法是知道真实 beta,而这在实证研究里永远不可能。替代方案只有一个:换个估计量重跑,看结论是否稳定。 如果一个异象在 OLS beta 下显著、在 Dimson beta 下消失,它大概率不是异象。这个检验很便宜,代码就是上面那十几行,但我见过的实证论文里做这一步的不多。
流动性是所有横截面研究的隐形第三变量。 这个模拟里最让我意外的不是偏误多大,而是「按 beta 排序 = 按流动性排序」这个等价关系有多强——Q1 组 73.3% 是最不流动股票。任何在含小盘股样本上做的横截面排序,都值得顺手打印一下各组的流动性分布。如果分布单调,你的排序变量已经被流动性污染了,后面所有结论都要重新审视。