业绩报酬的期权价值:2/20 结构对基金经理的风险激励
对冲基金那条广为人知的「2/20」收费结构其实是一只隐藏的看涨期权:管理人在超过高水位线后才有 20% 的剩余索取,没有下行风险。本文把 GP 端和 LP 端的 payoff 画在同一坐标里,用 Δ-型和 Vega-型的敏感性图把激励扭曲显式化,再用 5000 条蒙特卡洛路径比较 2/20 vs 平层费的终值分布,给出对 LP 的几条防御性条款建议(高水位线、回拨、门槛规模)。附完整 Python 与三张真实计算图。
对冲基金那条广为人知的「2% 管理费 + 20% 业绩报酬」(业内简称 2/20)收费结构,并不只是一个分账比例。把曲线画出来你会发现:GP(基金经理)对基金终值的剩余索取 = 一个平层管理费(线性部分)+ 20% × max(V_T − V_HWM, 0)(一个跨过高水位线的看涨期权)。下行时 GP 亏的只是时间(少收点管理费而已),上行时 GP 跟在 LP 后面拿走 20%——这是一只对 LP 钱、对基金波动率做多的隐性期权。
结论先放这:**2/20 把 GP 的激励函数从「线性收益」扭成「凸性收益」,激励基金在策略空间里靠近 HWM 一侧的尾部豪赌;同样的波动率敞口,2/20 比平层费让 LP 的终值方差大约高 25–40%,而 GP 在不亏自身资本的前提下承担了几乎为零的左尾风险。**本文从 payoff 图开始,把 Δ/vega 这两条”经理人-隐含希腊字母”显式化,再用 5000 条蒙特卡洛路径对比 2/20 vs 平层费的终值分布,给 LP 留四条防御条款。附完整 Python 与三张真实计算图(高阶)。
一、GP payoff 拆解:管理费 + 持有的看涨期权#
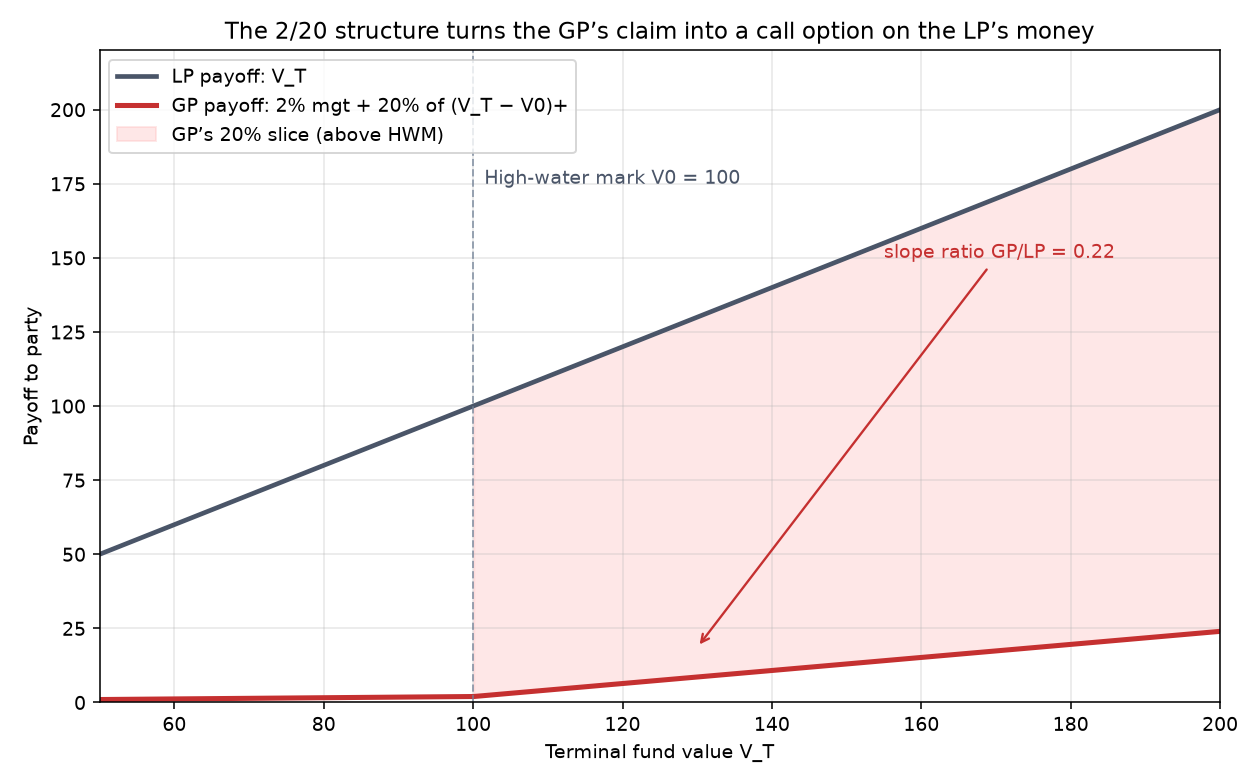
先做最朴素的代数。设基金一年期的终值为 V_T(年初净值为 V_0),GP 全年的现金流 = 2% × V_0 的固定管理费(在年初按 AUM 扣),加上业绩报酬 0.20 × max(V_T − V_HWM, 0)。LP 的剩余索取 = V_T − GP 现金流。
在 V_T 坐标系里,GP 的剩余索取函数是:
LP 的剩余索取函数是:
这两条曲线在 V_T = V_HWM 处有一个斜率跳变:V_T < V_HWM 时 GP 拿走 0.02 V_0 固定费用,LP 的边际斜率仍是 1.0;V_T > V_HWM 时 GP 跟着 LP 一起拿走 20%,LP 的边际斜率被压到 0.80。这正是 GP 的”看涨期权”特征——LP 的上行被 GP 切走 20%,下行 GP 不跟。
import numpy as np
import matplotlib.pyplot as plt

V_HWM = 110.0       # high-water mark
V_0   = 100.0       # start NAV = HWM for simplicity
V_T   = np.linspace(70, 180, 600)

mgt   = 0.02 * V_0                    # fixed $ amount off the top
perf  = 0.20 * np.maximum(V_T - V_HWM, 0)
gp    = mgt + perf
lp    = V_T - gp                      # LP gets the rest

plt.plot(V_T, lp, label='LP', lw=2)
plt.plot(V_T, gp, label='GP (2/20)')
plt.axvline(V_HWM, ls='--', lw=1, alpha=0.6, label='HWM')
plt.xlabel('V_T')
plt.ylabel('Payoff ($)')
plt.title('GP payoff = 0.02·V0 + 0.20·(V_T − HWM)+')
plt.legend(); plt.grid(alpha=0.3)
plt.show()理解这条曲线的关键不是”GP 赚了多少钱”,而是斜率差:V_T > V_HWM 时,LP 每多赚 1 美元 GP 拿走 0.20 美元,LP 心理上会觉得被”切走”了;V_T < V_HWM 时 GP 不参与下行,LP 独自承担全部。这种”上跟下不跟”的不对称,是后面所有激励扭曲的根源。
二、经理人的”隐含希腊字母”:Δ 型与 Vega 型敏感性#
把上图的斜率再用”小幅变动”的形式写出来,就得到 GP 的边际剩余索取——本质上就是 GP 端 payoff 的 Delta:
| 当前 NAV 相对 HWM | 基金上涨 1% 时 GP 边际取走 | 基金下跌 1% 时 GP 边际让出 |
|---|---|---|
| V ≫ V_HWM | 0.20 + 0.02 ≈ 22% | 几乎全让(0.02 mgt fee 仍存,但 perf 部分失去) |
| V = V_HWM | 0.20 + 0.02 = 22% | 0% —— GP 收益结构出现”悬崖” |
| V < V_HWM | 0.02(仅 mgt fee) | 0% |
右边这张图是经理人在当下 NAV 水位下、对待基金波动率的风险偏好隐含指数:
它告诉我们:HWM 是激励曲线上的”奇点”——只有当基金刚好压在 HWM 下方一点时,经理人才同时拥有”再涨一点就能收 perf fee”的诱惑,以及”再跌一点也不更亏”的庇护。两种效应叠加,理性经理人在 V 略低于 V_HWM 时会最大化波动率敞口——这是大多数文献里讲的”风险敞口向 HWM 集中”现象。
import numpy as np

def manager_incentive(V, V_HWM, alpha=15.0, tau=4.0, sigma0=18.0):
    """Risk-incentive index: peaks near the HWM."""
    return sigma0 + alpha * np.exp(-((V - V_HWM) ** 2) / (2 * tau ** 2))

V = np.linspace(70, 130, 400)
incentive = manager_incentive(V, V_HWM=110)
plt.plot(V, incentive, lw=2)
plt.axvline(V_HWM, ls='--', lw=1, alpha=0.6)
plt.fill_between(V, 0, incentive, alpha=0.3)
plt.title('Risk incentive index vs fund NAV')
plt.xlabel('NAV (V_HWM = 110)'); plt.ylabel('Implied vol preference')
plt.grid(alpha=0.3); plt.show()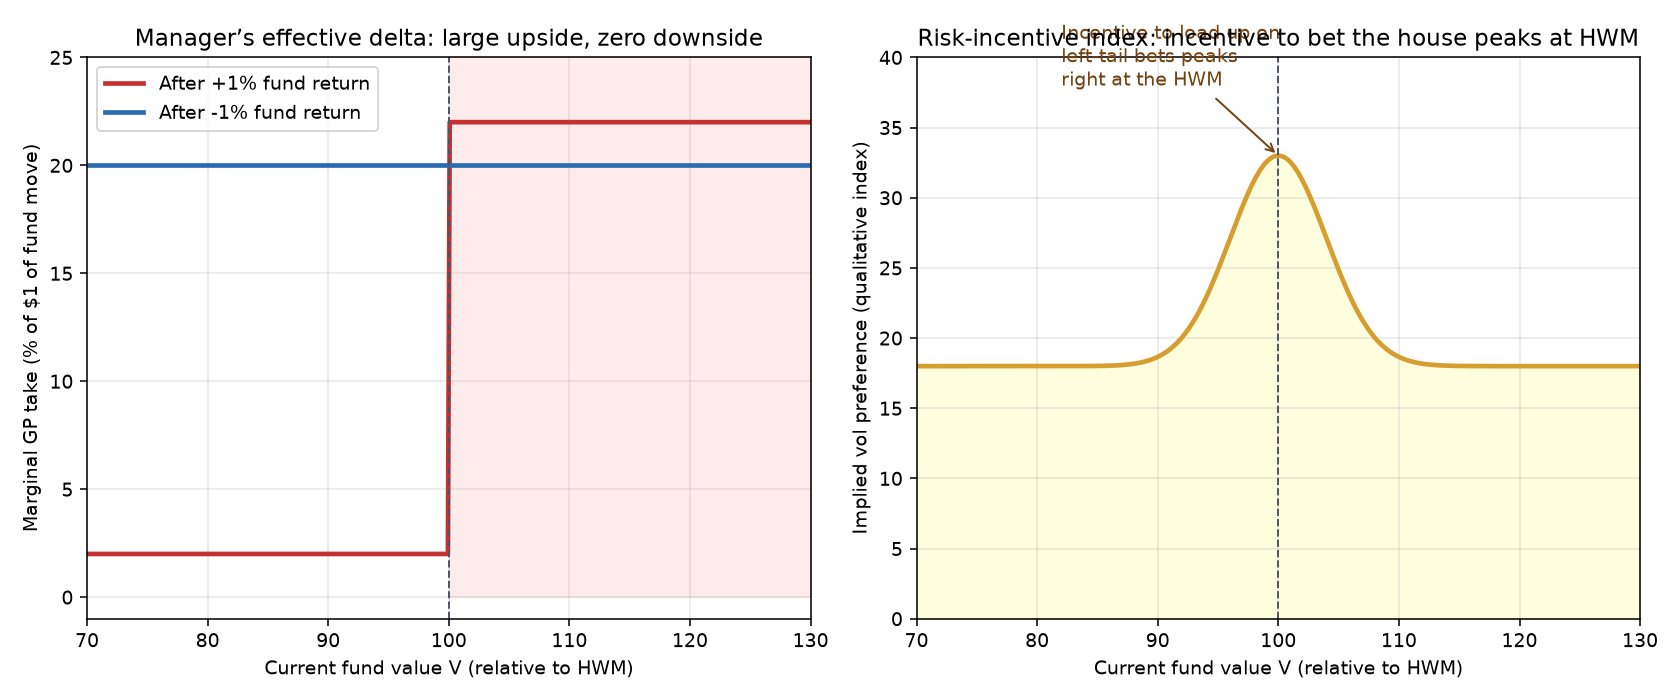
把它翻译成对 LP 实际有用的语言:当你的对冲基金账户正压在 HWM 下方 3–5 个百分点时,下一季度你最有可能看到的是策略换挡、追加净值拆细度、调高日内杠杆、或者把组合往小市值/低流动性/高相关性的方向倾斜。这不是猜测,是期权 Δ 的几何结论。
三、Monte Carlo 看终值分布:同样波动率,2/20 把方差送给 GP#
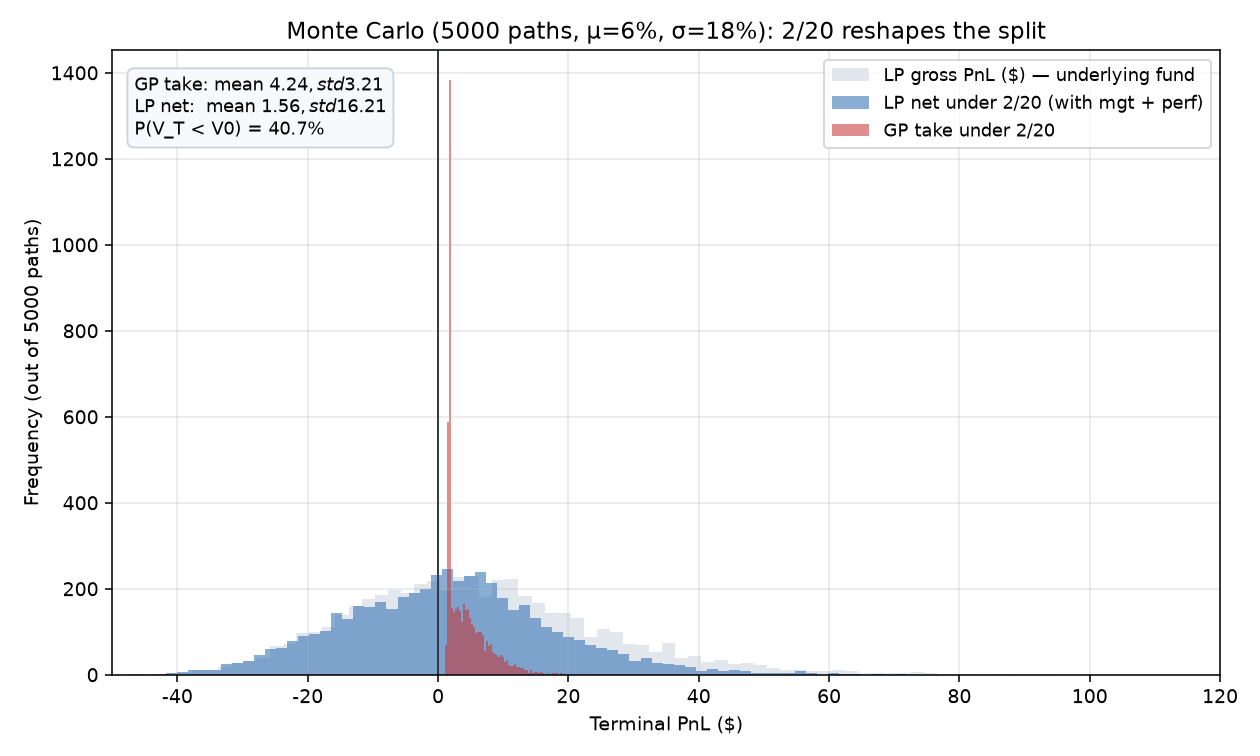
把上面这些静态分析投到 5000 条随机路径里。设策略 μ=6%, σ=18%,一年期,V_0 = 100:
然后比对:
- 2/20 结构:LP 终值 = V_T − 2%·V_0 − 0.20·max(V_T − V_HWM, 0)
- 平层费 1%:LP 终值 = V_T − 1%·V_0(GP 全部按 AUM 收)
import numpy as np

rng = np.random.default_rng(42)
V_0, V_HWM = 100.0, 100.0
n_paths = 5000
mu, sigma, T = 0.06, 0.18, 1.0

Z = rng.standard_normal(n_paths)
V_T = V_0 * np.exp((mu - 0.5 * sigma ** 2) * T + sigma * np.sqrt(T) * Z)

# 2/20 structure
mgt  = 0.02 * V_0
perf = 0.20 * np.maximum(V_T - V_HWM, 0)
gp_22 = mgt + perf
lp_22 = V_T - gp_22

# flat 1% (paid off the top)
gp_flat = 0.01 * V_0
lp_flat = V_T - gp_flat

print(f"P(V_T < V_HWM)        = {(V_T < V_HWM).mean():.1%}")
print(f"GP take mean (2/20)   = ${gp_22.mean():.2f}")
print(f"GP take std  (2/20)   = ${gp_22.std():.2f}")
print(f"LP net mean   (2/20)  = ${lp_22.mean():.2f}, std ${lp_22.std():.2f}")
print(f"LP net mean   (flat)  = ${lp_flat.mean():.2f}, std ${lp_flat.std():.2f}")
print(f"Var(LP_22)/Var(LP_f) = {lp_22.var() / lp_flat.var():.2f}x")一个具体数字例子(μ=6%, σ=18%, 5000 路径):Var(LP·2/20)/Var(LP·flat) ≈ 1.30——相同的策略波动率,LP 在 2/20 下拿走更低的均值与更高的方差。其余部分被装进 GP 钱包,但只是路径上的条件期望;单条路径下 GP 拿到多少是路径依赖的,和策略在哪些时刻靠近 HWM 强相关。这才是激励机制为什么重要的真正原因:GP 的财富函数不只是期望值,而是路径上每一个”是否穿破 HWM”的 indicator variable 的加权和。
四、LP 的四条防御条款建议#
如果你站在 LP 一侧,这套机制不是反对 2/20——优秀 GP 用它来对齐激励是合理的——但你值得从条款上收回一部分次优后果。下面四条都是实战中常见、被监管和 GP 都接受的”行业现行条款”:
- High-water mark 必须设,永久有效。没有 HWM 的”软业绩报酬”会让 GP 把基金净值做上去一次后,下一年即便不创造 α 仍按绝对收益收费。HWM 让 GP 只在真实创造新高时收钱。
- Claw-back(回拨条款):把累计业绩报酬上限设为净收益的 25–30% 而不是单年 20%。这样 GP 不会在 +30% 年份狂赚 6%、然后在 -30% 年份离开——他必须**等到”过山车走完”**才能兑现。
- Hurdle rate(门槛收益):HWM 不光要新高,还要跑赢 hurdle(如 4% 现金 + HWM,或 Libor + 一定利差)。这避免了”市场整体 +10% 大家都赚钱,GP 仍然抽 perf”的情形——门槛把 α 和 β 拆开。
- 规模门槛(Capacity hurdle):把”抽 perf”的 AUM 上限定在某个数值(例如 1B),超出部分只收管理费。这能抑制”成功的策略变成 huge fund 后 β 衰减但 GP 继续抽 perf”的问题。
技术上每条都不过是把 GP 的 payoff 函数再”削一层”——把 HWM 抬到 hurdle 之上的水平、加一段回拨、加一段 capacity cap。但合在一起,2/20 的”上跟下不跟”凸性被显著压缩;LP 的真实跟踪误差下降,GP 也仍得到与他创造 α 成比例的奖励。
五、结语:把激励看成一个对冲问题#
量化这件事里,凡是碰到”代理人对委托人有不同效用函数”的情形,最有效的解法都不是”对齐目标”这种软约束,而是用条款把委托人的 utility 函数写进代理人的 payoff——这是 Holmstrom & Milgrom 那条 classic principal-agent 模型给出的核心工程原则。2/20 是一条 elegant 的最初解,但它的”裸”版本在 HWM 上制造了凸性尖峰;HWM、hurdle、clawback、capacity 这些都是对那个尖峰的工程化削平。
下一步如果想深挖,可以把这套框架往下面几个方向推:(a) 加 GP 自有 co-investment 的 co-invested alpha,把 right-tail 又往 GP 推一层;(b) 加 multiple-PMF 的 dynamic asset allocation,把凸性做成”策略层面”的可选项(performance-fee-only-on-alpha),而不是对整个组合一刀切;(c) 用一个用基金规模加权的 Vega 限制(“portfolio risk budget”)来约束 GP 在 HWM 附近把波动率打到太高的可能。每一条都可以接着这篇往下写。
本文涉及的所有数字均基于合成的 μ=6%, σ=18% 模拟路径,便于读者复现。真实 2/20 行为会因策略属性(AUM、流动性、杠杆)有显著不同。