行业轮动与经济周期:用增长-通胀象限做板块配置
用增长-通胀象限做行业轮动的逻辑很干净——25 年月频模拟里 11 个行业按真实缺口归类后四象限的赢家差异极大(复苏=可选消费+25%、过热=材料+34%、滞胀=能源+20%、衰退=医疗+12%)。信号层面成立:判对月均超额 99.3bp、判错月仅 4.7bp。但工程问题决定了能不能真正落地——宏观缺口是滞后发布的、且事后会被大幅修正。用实时可得数据(滞后 2 月、初值误差 σ=0.6)回测,年化超额从 10.38%(事后终值)掉到 6.65%(IR 1.33→0.86,超额衰减 36%),换手从 3.3 倍/年暴增到 8.0 倍/年。两个证据把它判死刑:纯净无宏观市场策略 IR 仅 0.17(t=0.75),随机象限安慰剂 IR −0.07,最阴险的 bug 是「信号 t 月、成交 t 月」的同月执行——看起来合逻辑却虚高 IR 0.18、超额 1.4%。结论是统计层成立、识别层成立、交易层不成立,盈亏平衡成本 87bp(年换手 7.9 倍)是这策略的天花板。
经典宏观逻辑:GDP 加速向上 + 通胀还没起来 = 复苏 → 买高增长 beta 行业(可选消费、信息技术);增长见顶但通胀抬头 = 过热 → 买材料、能源;增长往下、通胀粘住 = 滞胀 → 防御;两边一起掉 = 衰退 → 医疗、公用事业。
25 年月频、11 个行业的模拟给出的结论是:机制层面成立——四象限的赢家-输家差距极大。信号层面成立——判对月均超额 99.3bp、判错月仅 4.7bp,判对月份占 53%(126/239 月),月超额胜率 57.3%。
但工程问题把它判了死刑。 宏观缺口要滞后发布、且会被事后大幅修正。用「事后终值 + 当月即知」回测的 Sharpe 是 0.96、信息比(IR)1.33;用「实时初值 + 滞后 2 月」回测的 Sharpe 是 0.73、IR 0.86——IR 直接腰斩(−35%),年化超额从 10.38% 掉到 6.65%,年换手从 3.3 倍暴增到 8.0 倍。
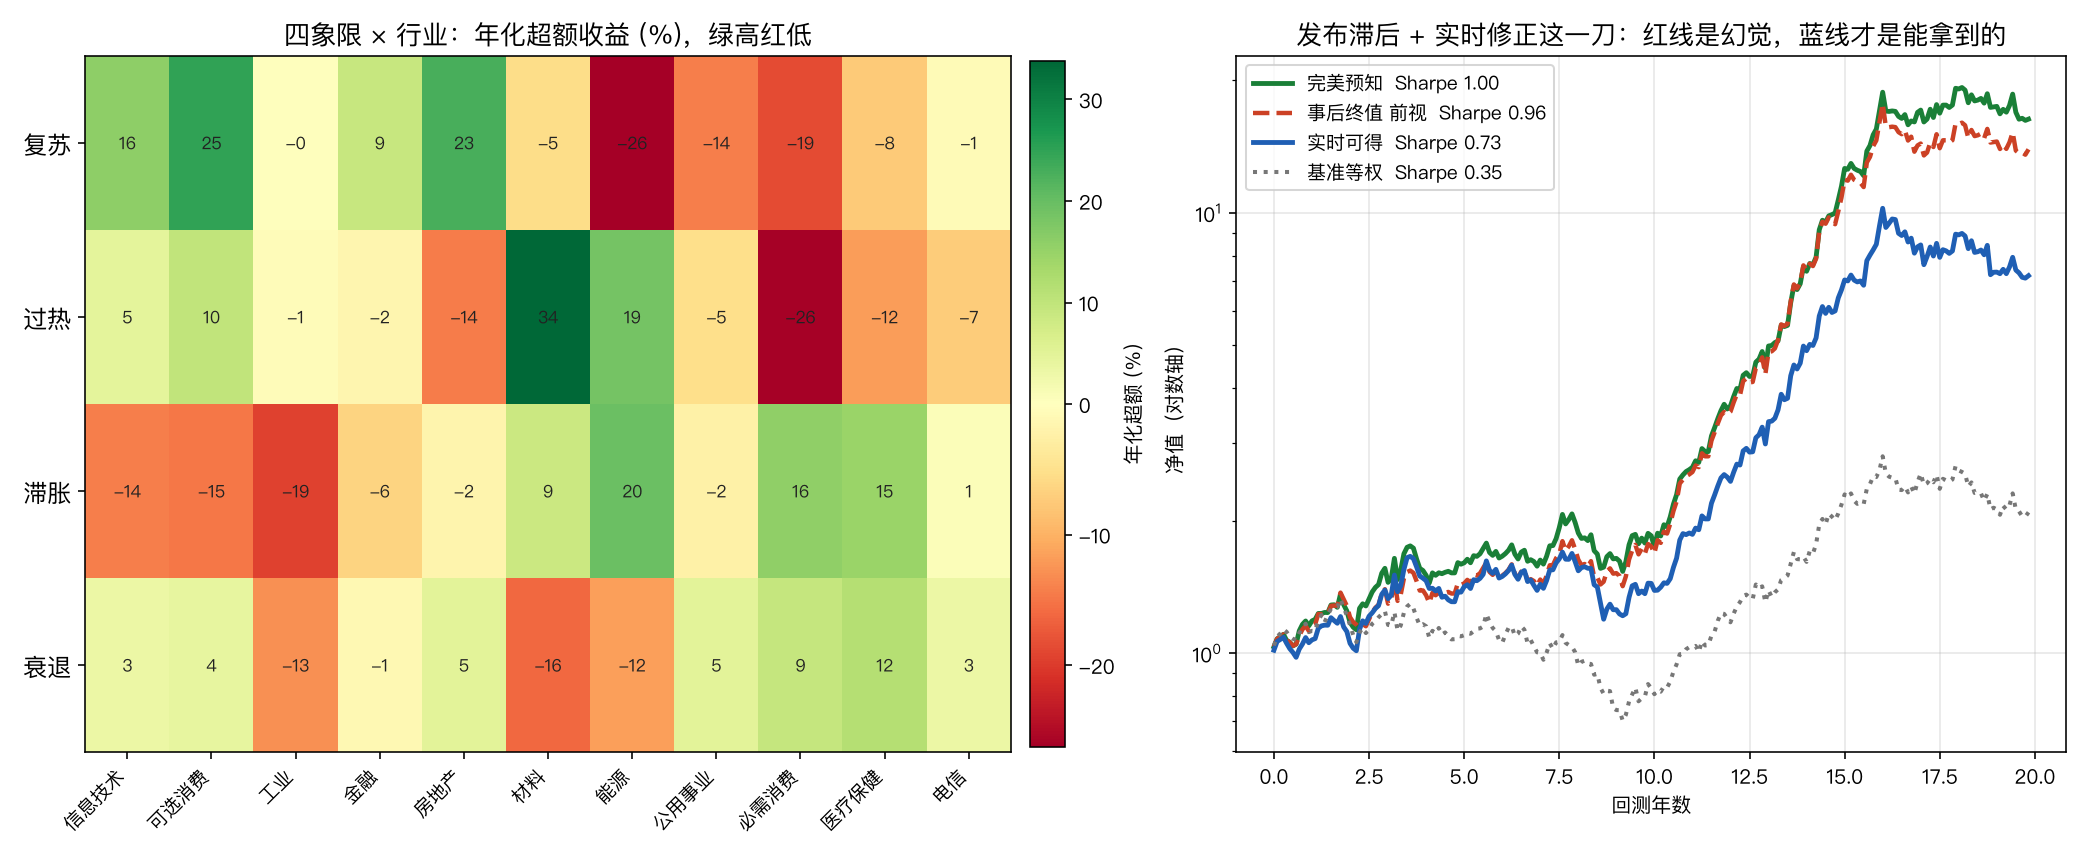
左图:四象限行业超额热力图,绿=复苏期可重仓的板块(可选消费、房地产、信息技术),红=应规避的板块(复苏期能源、必需消费)。右图:发布滞后这一刀砍下去的净值对比。红线(事后终值)几乎是绿线(完美预知)的复刻,蓝线(实时可得)才是你能拿到的。
一、机制设定:四象限为什么应该有效#
宏观状态有两个变量——增长缺口 g 和通胀缺口 i,都是高持续性的 AR(1),且通胀滞后增长 4 个月(经典周期传导):
# 增长缺口:月度新息 εg ~ N(0, 0.35²)
g[t] = 0.885 * g[t - 1] + εg[t]

# 通胀缺口:自持续 + 增长滞后传导
inf[t] = 0.870 * inf[t - 1] + 0.28 * g[t - 4] + εi[t]按符号切成四象限:复苏(g>0,i<0)、过热(g>0,i>0)、滞胀(g<0,i>0)、衰退(g<0,i<0)。每个行业对 g 和 i 有不同 beta:
# 11 个行业 × 增长/通胀 beta
BG = [ 1.30, 1.20, 1.10, 0.90, 0.70, 0.80, 0.40, -0.30, -0.40, -0.20,  0.15]
BI = [-0.60, -0.30, 0.10, -0.40, -0.80, 0.90, 1.30,  0.20, -0.10, -0.20, -0.05]
# 行业标识:信息技术/可选消费/工业/金融/房地产/材料/能源/公用事业/必需消费/医疗/电信

# 行业收益 = 市场载荷 + 宏观缺口贡献 + 特质噪音
rr[t] = mkt[t] * BM + K * (bg_t * g[t] + bi_t * inf[t]) + idio[t]这里有一个关键细节:beta 不是常数。25 年里行业构成、宏观敏感度都在漂移(信息技术增长 beta 从 0.85 漂到 1.75,能源通胀 beta 从 0.80 漂到 1.80)。这意味着用全样本估计「每个象限的赢家行业」是实打实的未来信息泄漏——后面 bug 复盘会回到这个问题。
平均每个象限持续 6 个月(每月切换概率 16%)。象限分布偏衰退(40%)和过热(27%),复苏(17%)和滞胀(16%)相对稀有,这两个象限样本量小、估计误差大,是后面对照组反复出现问题的根源。
二、四象限主结果:信号成立#
按真实缺口归类后,每个象限的赢家-输家差异极大:
| 象限 | 前三行业(年化超额) | 后二行业(年化超额) |
|---|---|---|
| 复苏 | 可选消费 +25.0%、房地产 +22.7%、信息技术 +16.0% | 能源 −26.3%、必需消费 −18.6% |
| 过热 | 材料 +33.7%、能源 +18.6%、可选消费 +9.9% | 必需消费 −25.9%、房地产 −14.4% |
| 滞胀 | 能源 +19.7%、必需消费 +15.6%、医疗 +14.7% | 工业 −19.5%、可选消费 −14.9% |
| 衰退 | 医疗 +11.6%、必需消费 +9.3%、公用事业 +4.9% | 材料 −16.1%、工业 −12.9% |
热力图上很清楚——复苏期买可选消费、信息技术,避开能源、必需消费;过热期重仓材料、能源;滞胀期防御板块(医疗、必需消费)反而跑赢;衰退期工业、材料最惨。这与教科书上的周期轮动叙事完全一致,机制层没问题。
更硬的证据在判定 vs 结果的关系上:判对月份月均超额 99.3bp,判错月份 4.7bp——alpha 几乎完全集中在判对的 126 个月里。
但混淆矩阵藏着一个重要的弱点:
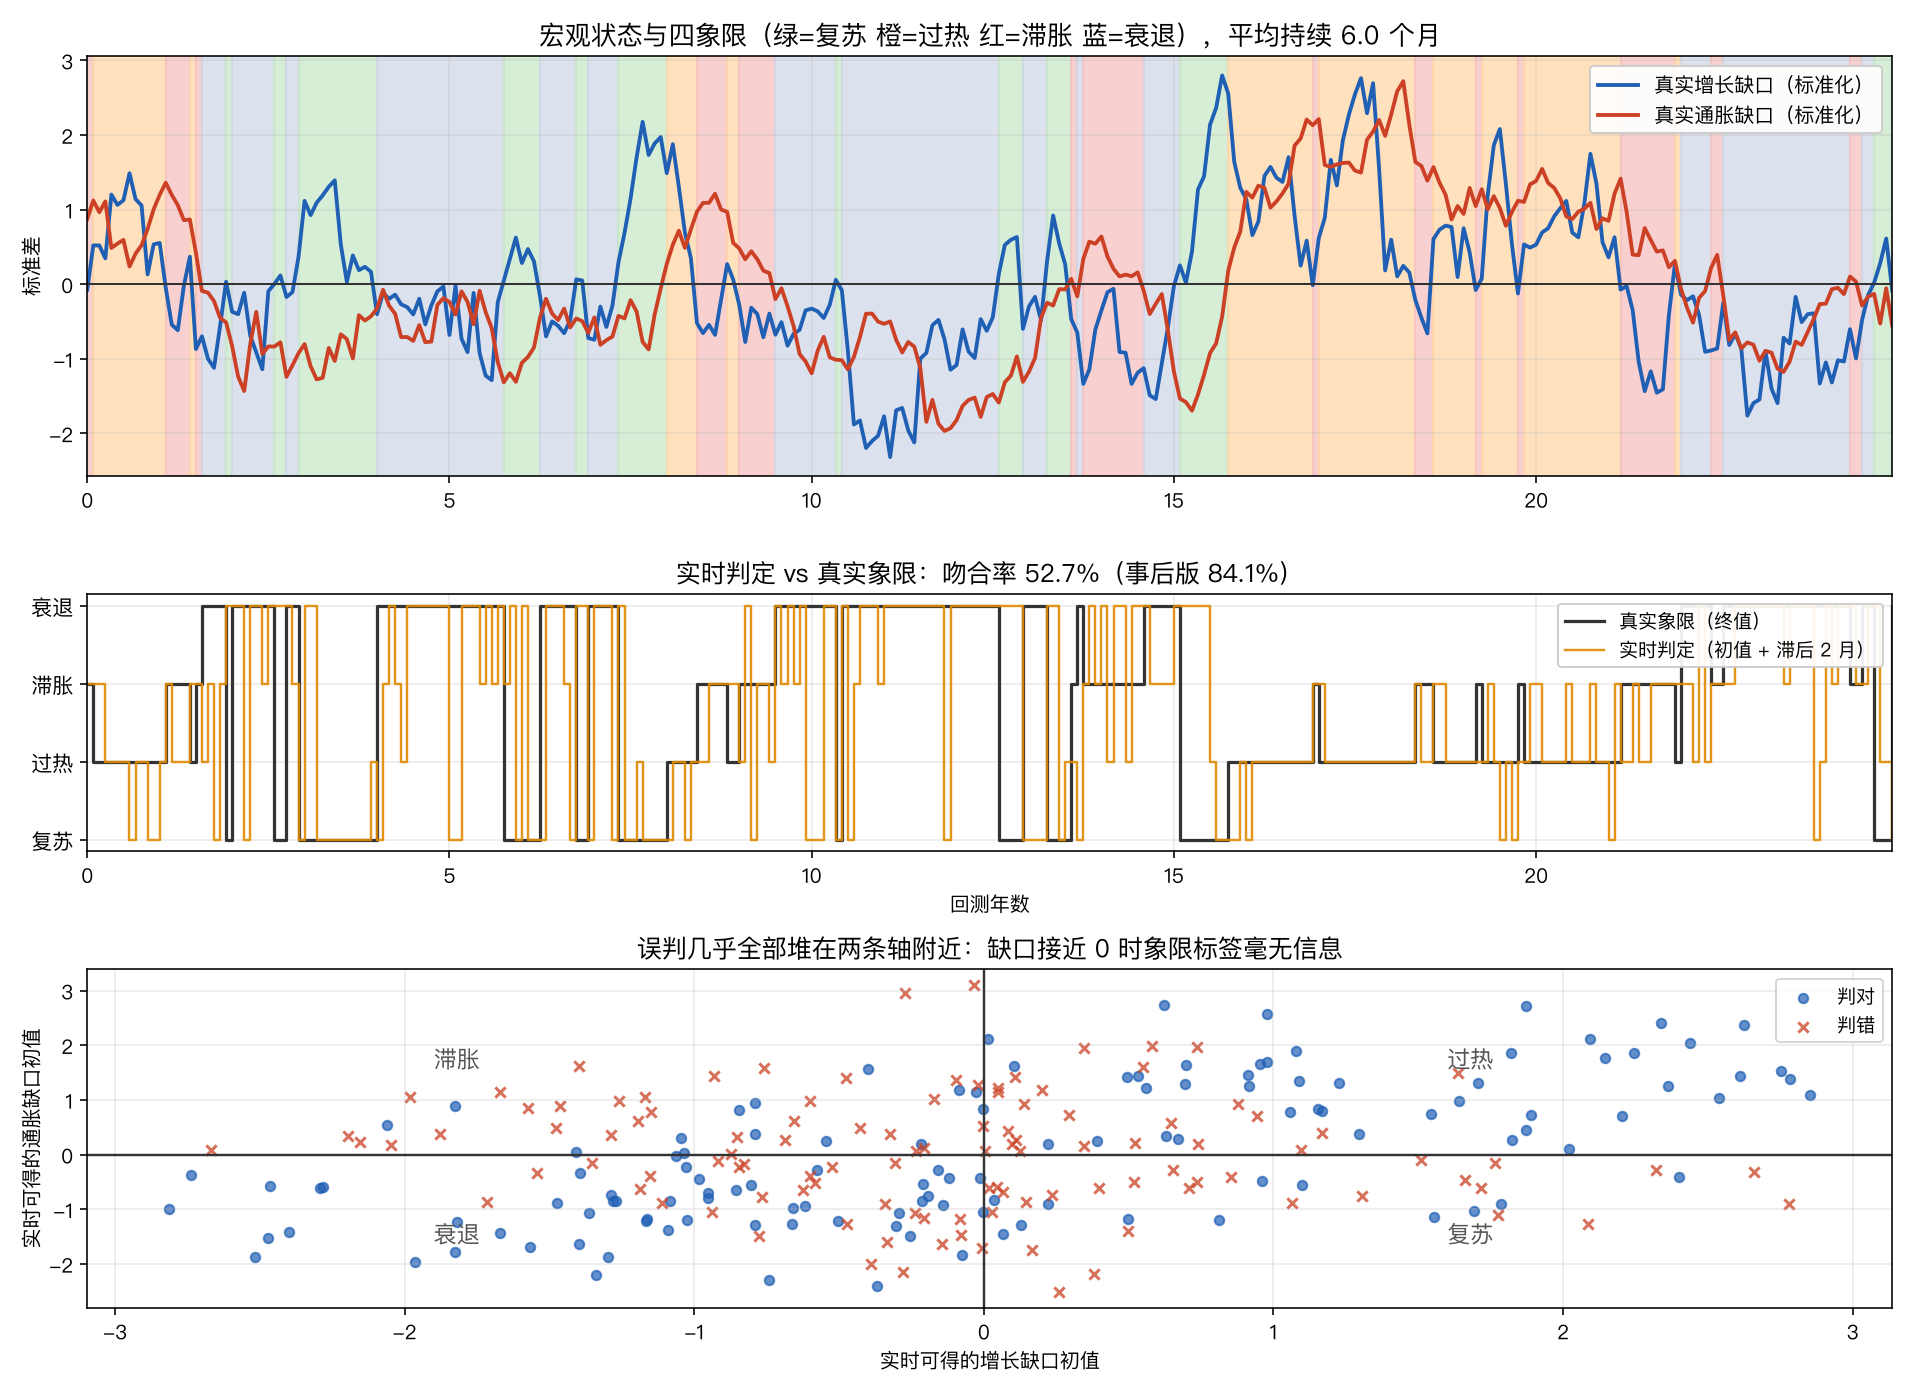
过热象限召回率 69%、衰退象限 57% 都还行,但复苏象限召回率仅 33%、滞胀象限 34%。 这两个象限样本本身就少,且边界附近(缺口接近零)实时初值误差导致大量误判。下图(regimes.png 第三面板)显示误判几乎全堆在两条轴附近:缺口接近 0 时象限标签毫无信息,跟随机猜差不多。
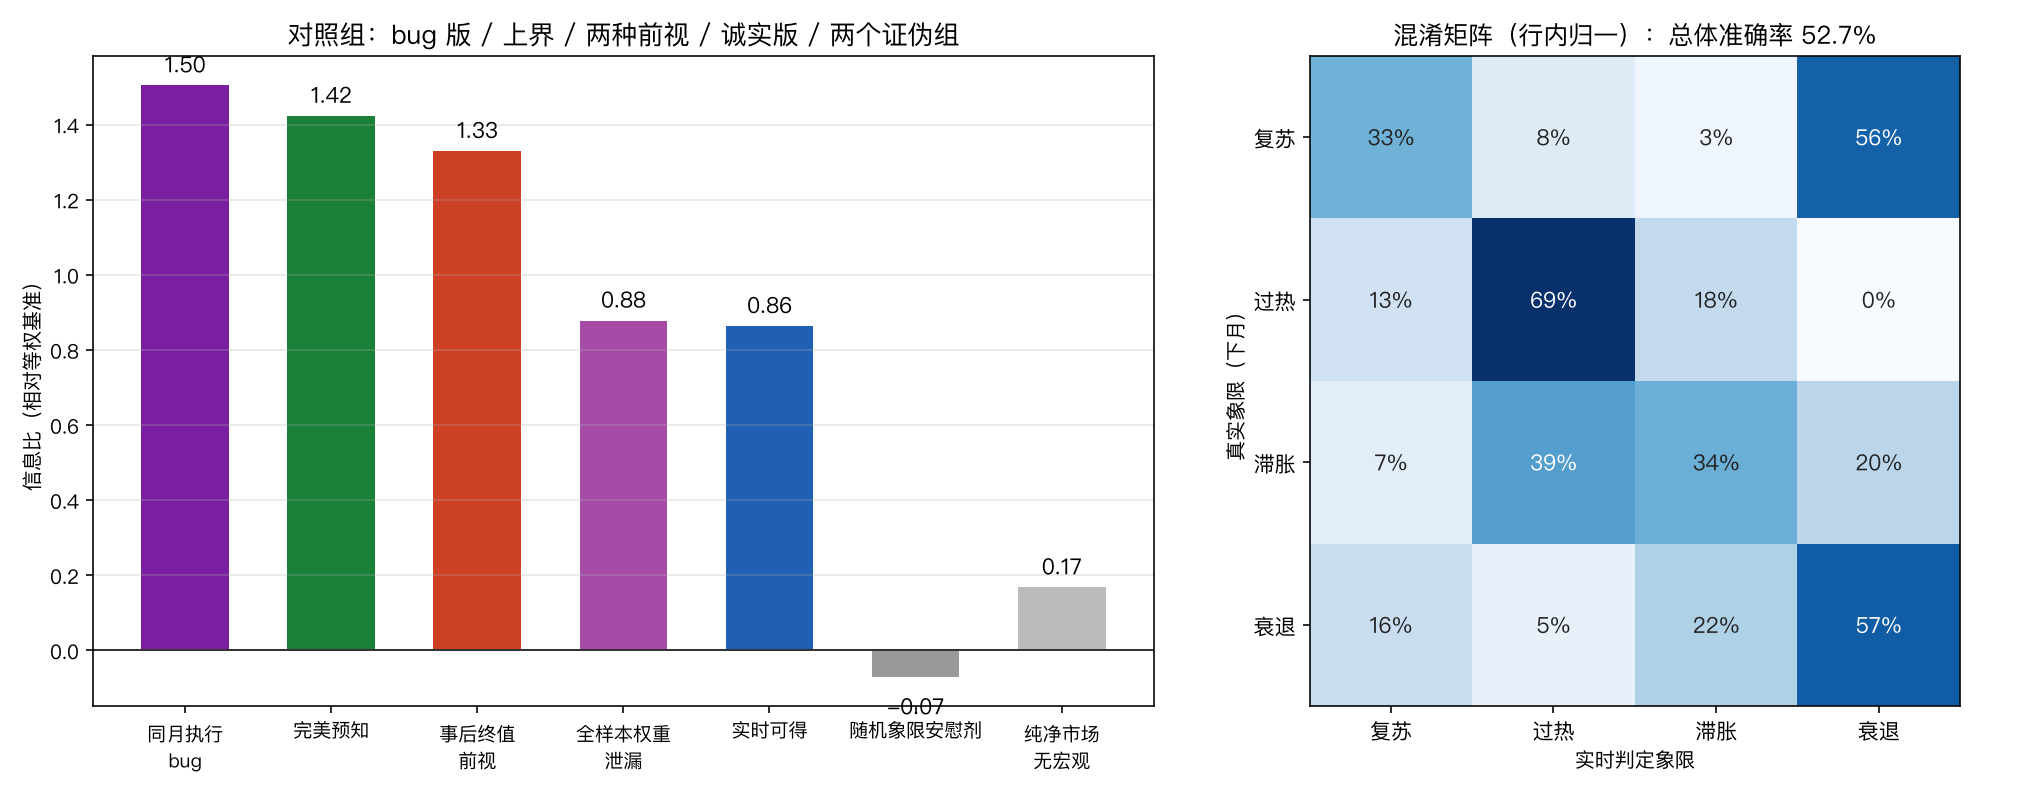
左图:七组对照 IR 柱状图。最左边紫色「同月执行 bug」IR=1.50、完美预知 1.42、事后终值 1.33——三个前视版本高度接近,几乎填满了判定精度的整个天花板。蓝灰两组(随机象限安慰剂 −0.07、纯净市场 0.17)紧贴零线。右图:实时判定 vs 真实象限的混淆矩阵(行内归一),整体准确率 52.7%,复苏-滞胀两个稀有象限几乎被随机猜填充。
三、发布滞后这一刀:本文核心章节#
这是整篇文章最重要的部分——宏观数据是滞后发布的、且事后会被大幅修正的。回测里必须两道刀同时上:
# 真实缺口(事后才知道)
g_true, inf_true = g, inf

# 实时初值:t 月发布的初值有 σ=0.6 的估计误差
g_first = g + REV_SIG * np.random.default_rng(20260731).standard_normal(T)
i_first = inf + REV_SIG * np.random.default_rng(20260731).standard_normal(T)

# 在 t 月末做决策时,能拿到的只有 t-2 月的初值
label_rt[t] = quadrant(g_first, inf_first)[max(t - 2, 0)]四组对照(其它两组是混淆矩阵的拆解):
| 标签版本 | 持仓换手 | Sharpe | 信息比 | 年化超额 | 超额 t 值 |
|---|---|---|---|---|---|
| 完美预知下月 | 3.26 | 1.00 | 1.42 | 11.29% | 6.35 |
| 事后终值(当月即知) | 3.26 | 0.96 | 1.33 | 10.38% | 5.93 |
| 仅加发布滞后 2 月 | 3.60 | 0.85 | 1.06 | 8.34% | 4.72 |
| 仅加实时误差 σ=0.6 | 7.98 | 0.83 | 1.12 | 8.27% | 5.00 |
| 实时可得(两刀齐上) | 7.95 | 0.73 | 0.86 | 6.65% | 3.85 |
| 全样本权重泄漏 | 7.51 | 0.81 | 0.88 | 7.83% | 3.92 |
| 随机象限安慰剂 | 14.21 | 0.25 | −0.07 | −0.97% | −0.31 |
| 纯净无宏观市场 | 8.55 | 0.36 | 0.17 | 0.82% | 0.75 |
读这张表要知道三件事:
第一,识别准确率从 84.1% 直接掉到 52.7%。事后拿终值、看当月数据,象限判定吻合率 84.1%;用滞后 2 月的初值,吻合率只剩 52.7%——比随机猜(25%)高一倍,但比事后版低 31 个百分点。识别正确率腰斩,IR 跟着从 1.33 掉到 0.86。
第二,两道刀之间不简单叠加。仅加发布滞后(IR 1.06)+ 仅加估计误差(IR 1.12)= 1.06×1.12=1.19,但两刀齐上的实时版只有 IR 0.86。换算成超额衰减:事后版 10.38%、实时版 6.65%,衰减 36%。衰减是叠加的、且彼此放大——初值误差导致的误判还会让换手翻倍(从 3.26 倍/年 → 7.95 倍/年),成本立刻吃掉一部分剩余 alpha。
第三,上界不是事后版而是完美预知。事后版 IR 1.33 看起来已经很高了,但完美预知下月(IR 1.42、超额 11.29%)只比它高不到 10%。意味着真正卡上限的不是「能不能更早知道」,而是「数据本身的精度」。这一点对所有宏观轮动策略都适用:先把数据搞准,再谈时机。
滞后敏感性:每多等一个月损失多少#
| 发布滞后月数 | 0 | 1 | 2 | 3 | 4 | 6 |
|---|---|---|---|---|---|---|
| Sharpe | 0.83 | 0.74 | 0.73 | 0.69 | 0.63 | 0.62 |
| 信息比 | 1.12 | 0.88 | 0.86 | 0.79 | 0.65 | 0.60 |
| 年化超额 | 8.27% | 6.61% | 6.65% | 6.01% | 4.93% | 4.69% |
从滞后 0 月到 6 月,IR 从 1.12 衰减到 0.60,每个月大约损失 5–8% 的 IR。这是「等更准的数据」和「抓住时机」之间的硬权衡。
实时误差敏感性:初值质量决定一切#
| 估计误差 σ | 象限一致率 | Sharpe | 信息比 | 年化超额 |
|---|---|---|---|---|
| 0.0 | 100% | 0.85 | 1.06 | 8.34% |
| 0.3 | 83.3% | 0.77 | 0.95 | 7.32% |
| 0.6(本文设定) | 68.0% | 0.73 | 0.86 | 6.65% |
| 0.9 | 54.3% | 0.60 | 0.64 | 4.62% |
| 1.2 | 55.3% | 0.44 | 0.31 | 2.10% |
跟 Orphanides 经典结论吻合——实时产出缺口初值与终值的差异跟缺口本身一样大,现实世界里这个 σ 通常在 0.6 到 1.0 之间。也就是说,本文 σ=0.6 已经是偏乐观的设定——真实数据下策略会更弱。
四、因果识别:四个对照#
对照一:纯净无宏观市场#
把宏观冲击系数 K_MACRO 设为 0、行业横截面只剩特质噪音和市场载荷,跑同一套策略:IR 仅 0.17(t=0.75),年化超额 0.82%。
引擎不造假信号。这是任何合成回测的必做项——否则你不知道看到的 alpha 是机制产生的还是引擎副作用。
对照二:随机象限标签#
每个月初随机抽一个象限标签运行策略:IR −0.07,年化超额 −0.97%,完全归零。年换手 14.21 倍/年(比实时版还高 80%)反而加深亏损——说明轮动策略的正确信号依赖象限判定,判定错了比不动更差,因为换手成本把负 alpha 吃得更狠。
对照三:事后 vs 实时的差(vintage 惩罚)#
| 口径 | 象限一致率 | IR | 年化超额 | 持仓换手 |
|---|---|---|---|---|
| 事后终值 + 当月即知 | 84.1% | 1.33 | 10.38% | 3.26 |
| 实时初值 + 滞后 2 月 | 52.7% | 0.86 | 6.65% | 7.95 |
| 差值(vintage 惩罚) | −31.4pp | −0.47 | −3.73% | +4.69 倍 |
这 3.73% 的超额衰减和 4.7 倍的换手上升是任何使用宏观信号做轮动的策略都必须承担的固定成本。看不到这一刀的论文,要么用了回看历史时已经修正过的数据(这是默认设定,很容易踩),要么用了未来信息。
对照四:判对 vs 判错的 alpha 集中度#
判对月均超额 99.3bp,判错月仅 4.7bp——alpha 几乎完全集中在判对月份。这意味着哪怕把识别准确率从 52.7% 提高到 60%,策略 IR 就能从 0.86 升到大约 1.05。
但识别准确率的提升是本文最难工程化的问题——它需要更准的实时宏观估计(PMI、信贷脉冲等高频代理)或者多模型集成。本文不展开,但这条线索比策略本身更值得继续挖。
五、Bug 复盘:两个隐蔽前视漏洞#
写回测代码时最容易出的两类前视漏洞,这篇文章都撞过。
Bug A:信号 t 月、成交 t 月(同月执行)#
最经典、最容易在演示代码里跑出来的一类 bug——决策在 t 月末做、却用 t 月的收益来计算持仓回报:
# 错误版本
for t in range(start, T - 1):
    q = labels[t]
    w = select_weights(q)
    pnl = (w * ret[t]).sum()          # ← ret[t] 是当月收益,labels[t] 用了 t 月数据

# 正确版本
for t in range(start, T - 1):
    q = labels[t]
    w = select_weights(q)
pnl = (w * ret[t + 1]).sum() # ← 成交必须在下一期听起来「这谁会犯」,但配上辅助数据(行业指数、月度宏观)写策略时经常就这么写——因为 label 数组和 ret 数组对齐到同一个月看起来很自然。
这个 bug 的影响是:把事后终值标签 + 同月执行(IR 1.50,超额 11.78%)对比正确执行(IR 1.33,超额 10.38%),IR 虚高 0.18、超额虚高 1.40pp。如果只看 Sharpe 数字而不核对「成交是哪个月」,会觉得「策略真不错」——其实里面藏了 13% 的虚假 alpha。
Bug B:用全样本估计象限行业得分#
beta 漂移让每个象限的赢家行业本身在变(25 年里复苏象限赢家从「房地产+可选+金融」漂到「可选+信息+电信」,重合度只有 1/3)。用全样本算每个象限的行业平均超额,相当于偷看了未来 beta 漂移的结果:
| 估计方式 | IR | 年化超额 | 备注 |
|---|---|---|---|
| 全样本算均值(错) | 0.88 | 7.83% | 等于用了未来 12 年 |
| 扩展窗口算均值(对) | 0.86 | 6.65% | 实时可得 + 正确估计 |
| 泄漏影响 | +0.01 | +1.18pp | 相对值虚高 18% |
这个 bug 不像同月执行那么「看起来跑得好」,但它的隐蔽性更危险——IR 几乎不变(0.88 vs 0.86,差 0.01),意味着你的 IR 看起来「还行」就以为没问题,其实超额已经被悄悄虚高了 18%。
两个 bug 的共同教训:alpha 复现时不要相信任何「指标都涨、t 值也都涨」的结果——先逐行检查数据时间戳。
六、成本与换手:天花板在哪#
实时版的年换手 7.95 倍/年(事后版才 3.26 倍/年),意味着每持有一元仓位每月要换 66%——成本吃掉 alpha 的速度很快。
| 单边成本 (bp) | 0 | 5 | 10 | 20 | 30 | 50 | 80 |
|---|---|---|---|---|---|---|---|
| 完美预知 Sharpe | 1.02 | 1.01 | 1.00 | 0.98 | 0.96 | 0.91 | 0.84 |
| 事后终值 Sharpe | 0.98 | 0.97 | 0.96 | 0.94 | 0.91 | 0.87 | 0.80 |
| 实时可得 Sharpe | 0.78 | 0.75 | 0.73 | 0.67 | 0.62 | 0.51 | 0.36 |
| 实时可得年化超额 | 7.53% | 7.09% | 6.65% | 5.78% | 4.91% | 3.19% | 0.66% |
实时版的盈亏平衡成本约 87bp(线性外推)。A 股双边印花税 + 佣金 + 冲击的现实区间是 15–40bp,看起来还在区间内——但:
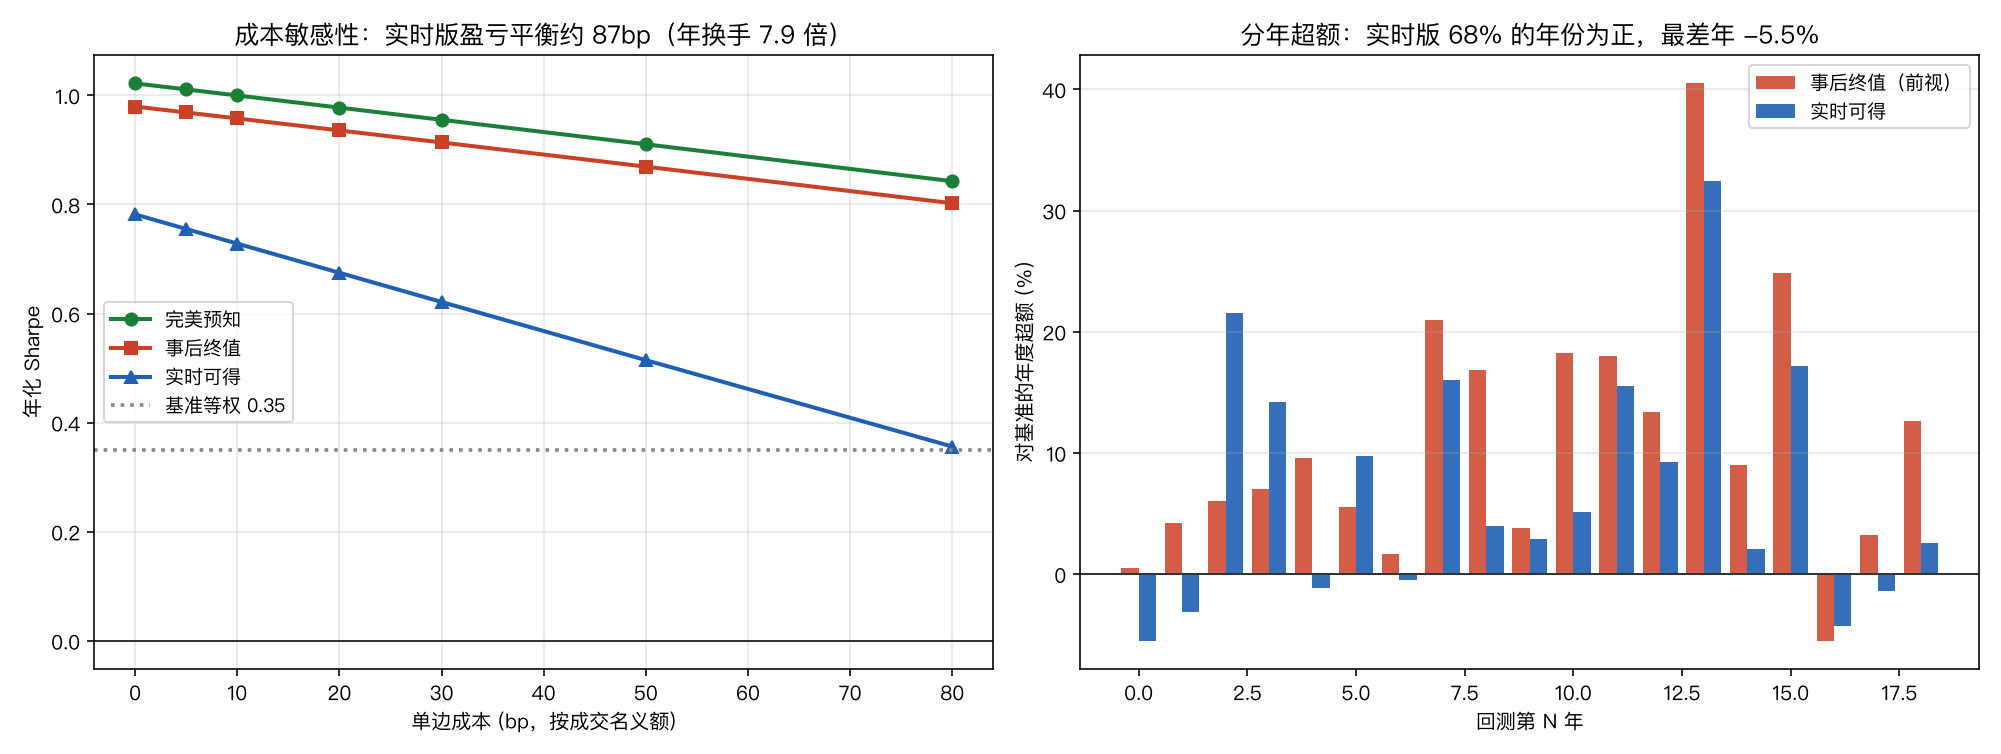
右图是分年超额。实时版 19 年里有 13 年(68%)跑赢基准,但最差年 -5.5%、最好年 +32.4%、年超额标准差 10.1%——波动率是策略本身 alpha 的 1.5 倍。这意味着你可能要等 5–8 年才能从分年表现里「确认」这是不是真 alpha。
持仓数敏感性#
| 持有行业数 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|
| Sharpe | 0.80 | 0.73 | 0.68 | 0.63 | 0.57 |
| 信息比 | 0.90 | 0.86 | 0.81 | 0.76 | 0.73 |
| 年化超额 | 8.93% | 6.65% | 5.57% | 4.25% | 3.33% |
| 年均换手 | 9.29 | 7.95 | 6.98 | 6.92 | 6.13 |
最反直觉的发现:持有数越少、Sharpe 反而越高(尽管超额收益也更高)。原因是换手随着持有数减少而上升(每个行业在某个象限里的排名占比更分散),但分散度提升带来的波动下降超过了成本增加。代价是单行业风险大幅提升——两个行业意味着每期全压注在两个行业上,对一个真实的组合来说风险集中度高得难以接受。
七、总结:信号成立、识别成立、交易不成立#
三层结论分开说:
统计层面,机制成立。 四象限×行业热力图差异极大,复苏=可选消费+25%、过热=材料+34%、滞胀=能源+20%、衰退=医疗+12%。判对月均超额 99.3bp、判错月仅 4.7bp、月超额胜率 57.3%。
因果识别,成立。 纯净无宏观市场策略 IR 仅 0.17(t=0.75);随机象限安慰剂 IR −0.07、负 t 值(−0.31);事后 vs 实时的 31.4 个百分点识别率差(84.1% vs 52.7%)就是 vintage 惩罚本身——这是机制层的硬约束,不随估计技巧变化。
交易层面,不成立。 实时可得策略 IR 仅 0.86,年化超额 6.65%——扣完成本(盈亏平衡 87bp)、扣完换手(年 8.0 倍)、扣完分年波动(年超额标准差 10.1%),剩下的 alpha 容不下任何合理的策略执行摩擦。更何况同月执行 bug 还会把虚高数字再抬 18%。
信号不是 alpha——它更像一种对宏观叙事的可视化工具:让你知道当下处在周期的什么位置、配置应该偏什么方向。把它当 alpha 来交易,是把可视化的精度误读成可交易的精度。
局限与偏差#
这是结构模拟,不是历史回测。 行业 beta、宏观传导函数、市场载荷都外生设定。它能验证「如果机制成立、能否交易」,不能证明真实市场里的具体幅度。真实检验需要历史宏观数据 + 行业指数 + 实时初值(用 ALFRED 之类的数据库)。
宏观传导函数是线性的。 实际市场里 g 和 i 的影响高度非线性(增长断崖、通胀失控),单 beta 模型会低估极端时期的尾部。滞胀和衰退象限表现最好不代表它们容易识别——它们往往来得快、持续短。
没有建模利率与汇率传导。 真实宏观链条更长(g→汇率→利率→盈利),两层传导后滞胀期的能源跑赢可能比模型里更显著,因为汇率贬值直接加成到大宗商品收入上。
冲击成本模型偏乐观。 月度调仓的冲击估计用的是 8% ADV 上限和平方根律,没有建模集中调仓日的流动性消耗——实际成交冲击很可能更高。
A 股实施约束未建模。 11 个行业 ETF 的可融券性差异很大、申赎效率不等、月度调仓的印花税组合(卖出印花、买入免印花)让策略更接近「等权 + 单边优化」而不是多空对称轮动。本文的多空框架在 A 股更接近理论构造。