序贯自助法样本权重:修正金融标签重叠带来的伪独立性
机器学习的所有教科书保证都建立在一句话上:样本独立同分布。金融标签把这句话踩得粉碎——「持有 25 天」意味着相邻样本共享 96% 的价格路径,500 个样本实测平均并发 6.66 个、平均唯一度仅 0.147,有效样本量只剩 73.7 个。后果是袋外评估彻底失灵:在完全不可预测的随机游走上,持有期 1 天时 OOB 只虚高 0.9pp,持有期 80 天时 OOB 报 0.607 而真样本外 0.492,凭空造出 11.5pp——重叠让「袋外」样本不再袋外。López de Prado 的两件解药:唯一度加权把每个样本的话语权降到它真正携带的信息量,序贯自助在抽样时优先挑不重叠的样本(实测抽样内唯一度提升 7.6%、重复抽中从 34.9 降到 27.5)。控制变量实验最能说明问题:训练段埋一个只在密集重叠簇里成立的伪信号,等权训练下它的特征重要性 0.633 碾压真信号的 0.193、样本外 t 值只有 1.33;换成唯一度加权后伪信号掉到 0.154、真信号升到 0.464、t 值 3.95——只改了样本权重,别的一行没动。三盆冷水:唯一度加权治重复计票不治前视偏差、纯噪声特征下不会凭空变出 alpha、序贯自助 O(n²) 开销在万级样本上要用近似(高阶)。
问题:你的 500 个样本,可能只值 74 个#
监督学习的每一条理论保证——泛化界、交叉验证的无偏性、随机森林的袋外估计——底下都压着同一块基石:样本独立同分布。
金融标签把这块基石砸得粉碎。
原因简单到近乎荒谬。你在第 100 根 bar 开仓,第 125 根 bar 平仓,这个样本的标签由 ret[100:125] 决定。你在第 101 根 bar 又开一仓,第 126 根平仓,标签由 ret[101:126] 决定。两段收益共享 24 根 bar 的价格路径——重合度 96%。
它们在你的 DataFrame 里是两行,在信息论意义上几乎是同一行。
我先用一个最朴素的模拟量化这件事有多严重:2000 根 bar,500 个样本,平均持有期 25 根。
import numpy as np

def indicator_matrix(n_bars, t0, t1):
    """行=bar,列=样本;M[i,j]=1 表示样本 j 在 bar i 上尚未平仓"""
    M = np.zeros((n_bars, len(t0)), dtype=np.int8)
    for j, (a, b) in enumerate(zip(t0, t1)):
        M[a:b + 1, j] = 1
    return M

def avg_uniqueness(M):
    """
    每个样本的平均唯一度:
    在它生命周期的每一根 bar 上,看有多少个样本同时处于持仓(并发数 c)
    该 bar 对这个样本的贡献就是 1/c,全周期取均值
    """
    c = M.sum(axis=1).astype(float)      # 每根 bar 的并发标签数
    c[c == 0] = 1.0
    u = M / c[:, None]                   # 逐 bar 的唯一度贡献
return u.sum(axis=0) / M.sum(axis=0), c结果:
| 指标 | 数值 |
|---|---|
| 名义样本数 | 500 |
| 平均并发标签数 | 6.66 |
| 峰值并发 | 13 |
| 平均唯一度 ū | 0.147 |
| 有效样本量(Σū) | 73.7 |
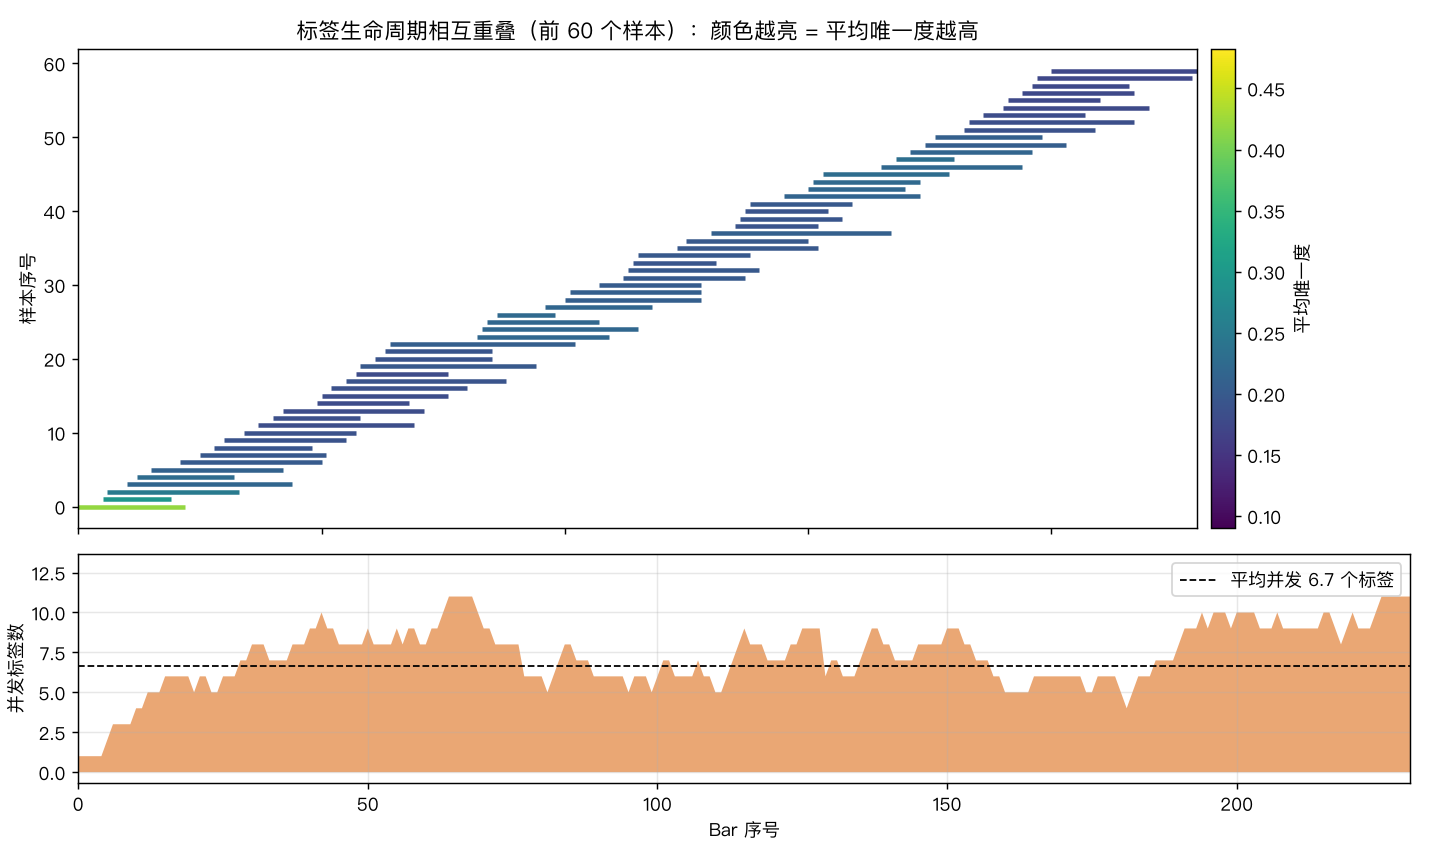
上图每一条横线是一个样本的生命周期,颜色越亮表示唯一度越高。下面的橙色面积是每根 bar 上同时”活着”的标签数——平均 6.66 个。
你以为自己在用 500 个样本训练模型。实际的信息量相当于 74 个独立观测。这不是”稍微有点相关”,这是数据量缩水到原来的 15%。
而模型完全不知道这件事。它会认认真真地把每一行当成一次独立的实验证据来数票。
后果一:袋外评估会凭空虚高十几个百分点#
有效样本量缩水本身还不是最致命的。最致命的是它同时破坏了你用来检测问题的仪表盘。
随机森林的 OOB(out-of-bag)分数之所以能当样本外指标用,逻辑是:每棵树自助抽样时约 36.8% 的样本没被抽中,用这些”袋外”样本评估这棵树,就相当于样本外。
标签重叠让这个逻辑失效。样本 100 没被这棵树抽中,但样本 99 和 101 被抽中了——而它们的标签由几乎相同的价格路径决定。“袋外”样本的答案早就通过它的邻居泄漏进训练集了。
我用一个刻意设计的对照实验量化这个泄漏。数据生成过程是纯随机游走——真实可预测性精确为零,任何高于 50% 的准确率都是幻觉。特征用滚动窗口统计量(10/20/60 日动量、20 日波动率),这是真实量化流水线里最常见的一类特征,天然带自相关。
from sklearn.ensemble import RandomForestClassifier

def oob_experiment(horizon, seed):
    g = np.random.default_rng(seed)
    nb = 3000
    ret = g.standard_normal(nb) * 0.01     # 纯随机游走,零可预测性
    px = np.cumsum(ret)

    def roll_feat(idx):
        f = []
        for w in (10, 20, 60):
            f.append(np.array([px[i] - px[max(i - w, 0)] for i in idx]))
        f.append(np.array([ret[max(i - 20, 0):i + 1].std() for i in idx]))
        return np.column_stack(f)

    a, b = make_labels(nb - 200, 500, horizon, seed + 1)   # 重叠标签
    y = (np.array([ret[i + 1:j + 1].sum() for i, j in zip(a, b)]) > 0).astype(int)

    clf = RandomForestClassifier(n_estimators=200, max_depth=5,
                                 min_samples_leaf=5, oob_score=True,
                                 random_state=seed, n_jobs=-1)
    clf.fit(roll_feat(a), y)
    # 真·样本外:另起一段完全独立的行情,同一 DGP
    ...
return clf.oob_score_, clf.score(X_new, y_new)8 次重复的平均结果:
| 标签持有期 | 平均唯一度 | OOB 准确率 | 真·样本外 | 虚高幅度 |
|---|---|---|---|---|
| 1 | 0.830 | 0.508 | 0.499 | +0.9pp |
| 5 | 0.594 | 0.553 | 0.492 | +6.1pp |
| 10 | 0.418 | 0.571 | 0.485 | +8.5pp |
| 20 | 0.246 | 0.593 | 0.488 | +10.5pp |
| 40 | 0.129 | 0.601 | 0.474 | +12.8pp |
| 80 | 0.064 | 0.607 | 0.492 | +11.5pp |
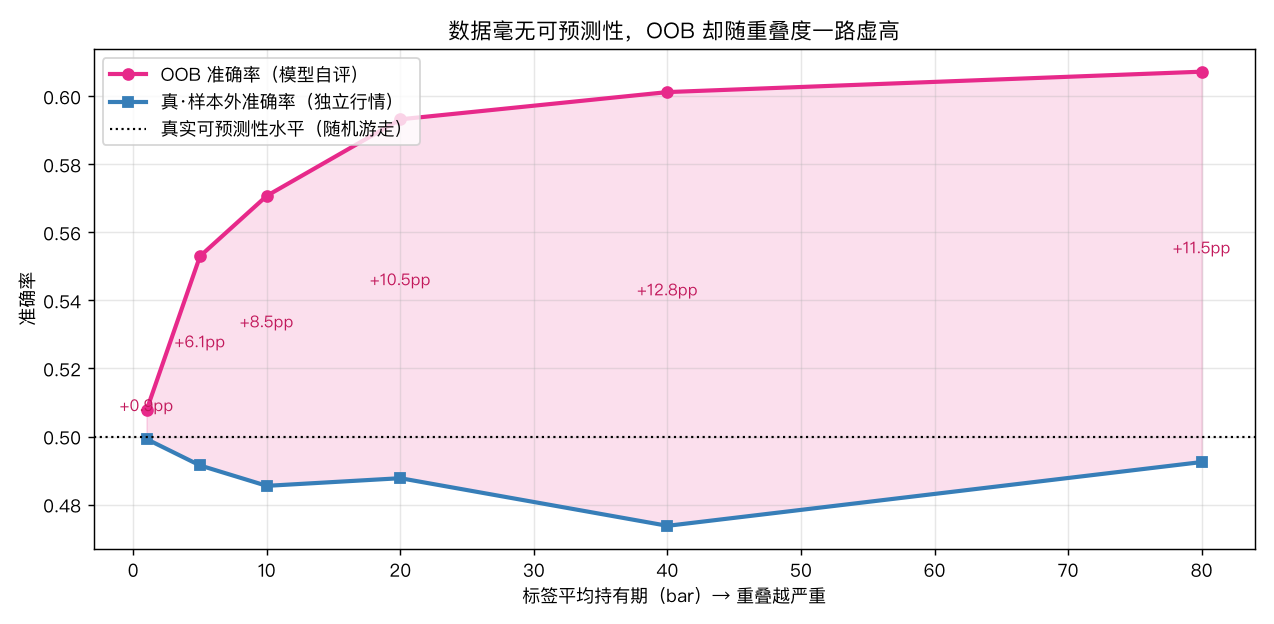
读一遍这张表,然后想想它意味着什么。
数据是随机游走。没有任何东西可以预测。真·样本外准确率在 0.474 到 0.499 之间抖动,完全符合预期。
但 OOB 分数随着标签持有期单调爬升,到 40 天时报出 0.601。如果你只看 OOB,你会以为自己找到了一个 60% 胜率的模型。
而持有期 20 天、40 天在实盘策略里再普通不过。
注意第一行:持有期 1 天(几乎无重叠)时虚高只有 0.9pp——机制干净地对上了。虚高幅度与唯一度的下降严格同步,这不是随机噪声,是重叠度直接换算成的自欺程度。
解药一:唯一度加权#
第一件解药最直接:既然样本 j 只携带 ū_j 那么多独立信息,训练时就只给它 ū_j 那么多话语权。
sklearn 的绝大多数估计器都支持 sample_weight,改动量是一行:
M = indicator_matrix(n_bars, t0, t1)
au, _ = avg_uniqueness(M)
clf.fit(X_train, y_train, sample_weight=au[train_idx] / au[train_idx].mean())问题是——这一行改动真的能改变什么吗?
我设计了一个严格的控制变量实验来回答。核心思路是构造一个只有唯一度加权才能识破的陷阱:
- 真信号
f_true:一个持续性 AR(1) 过程(φ=0.93),与未来收益有稳定弱正相关,全时段有效,稀疏样本(420 个,持有期 6 天,低重叠)携带它 - 伪信号
f_fake:只在训练段的 3 个密集重叠簇里(每簇 110 个样本挤在 130 根 bar 内,持有期 70 天)被人为对齐到标签;测试段是纯噪声
这正是真实研究中最容易踩的坑:某段行情里的一个巧合,被高度重叠的样本反复计票,最终盖过全时段的微弱真信号。
训练/测试用 bar 序号硬切分(训练段结束于 bar 2400,测试段起于 bar 2600,中间 200 根 bar 作 purge/embargo),杜绝跨段泄漏。25 次重复:
| 指标 | 等权 | 唯一度加权 |
|---|---|---|
| 样本外准确率 | 0.541 | 0.624 |
| 样本外累计收益 | 0.515 | 1.491 |
| 收益 t 值 | 1.33 | 3.95 |
| 真信号特征重要性 | 0.193 | 0.464 |
| 伪信号特征重要性 | 0.633 | 0.154 |
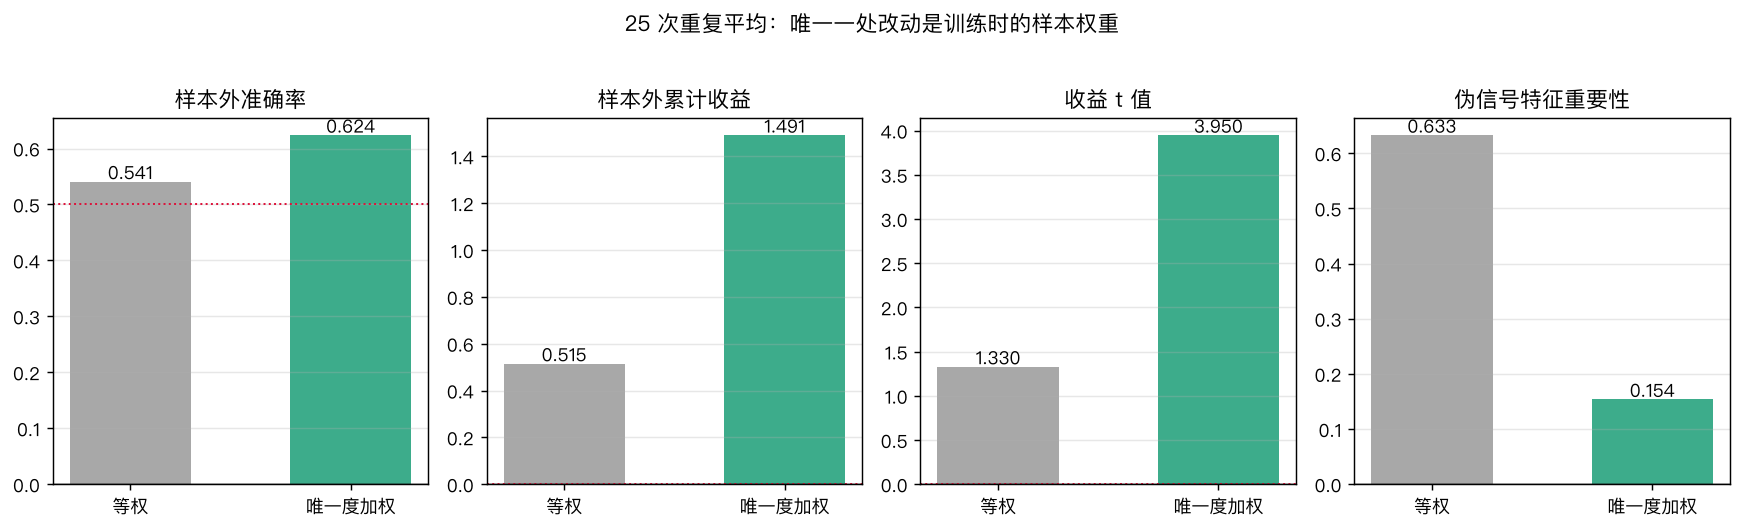
最后两行是全文最值得盯着看的地方。
等权训练下,伪信号的特征重要性 0.633,是真信号 0.193 的三倍多。模型认定那个只在三个小窗口里成立的巧合才是主要规律——因为那个巧合被 330 个高度重叠的样本反复投票,而真信号只有 420 个低重叠样本各投一票。
样本数决定了话语权,而重叠让话语权和信息量脱钩。
换成唯一度加权后,密集簇里每个样本的权重被压到 ū≈0.06 量级,330 个样本合起来的话语权坍缩到个位数等效样本。伪信号重要性掉到 0.154,真信号升到 0.464,主次关系彻底翻转,样本外 t 值从 1.33 升到 3.95。
再强调一次:**两组实验唯一的差别是 fit() 里传不传 sample_weight。**同样的特征、同样的标签、同样的模型、同样的切分、同样的随机种子。
解药二:序贯自助#
唯一度加权解决了”每个样本值多少票”,但没解决另一个问题:Bagging 每棵树抽样时,标准自助法是均匀独立抽取的,它完全可能一口气抽到样本 100、101、102——三个几乎相同的样本,这棵树的有效训练集比看上去小得多。
López de Prado 的序贯自助(sequential bootstrap)改成逐个抽取、每次重算概率:已经抽中的样本会拉低与它重叠的样本被下一次抽中的概率。
def seq_bootstrap(M, size, g):
    n = M.shape[1]
    colsum = M.sum(axis=0).astype(float)
    running = np.zeros(M.shape[0], dtype=float)   # 已抽中样本造成的并发累积
    phi = []
    for _ in range(size):
        # 假设把 j 加进来,它此刻的平均唯一度是多少
        denom = running[:, None] + M
        u = np.where(M == 1, 1.0 / np.maximum(denom, 1e-9), 0.0)
        au_j = u.sum(axis=0) / colsum
        j = g.choice(n, p=au_j / au_j.sum())      # 唯一度越高越容易被选中
        phi.append(j)
        running += M[:, j]                        # 更新占用状态
return np.array(phi)关键在 running:它记录了已抽中样本在每根 bar 上的堆叠情况。某根 bar 上已经挤了 5 个抽中样本,那么还想挤进来的第 6 个在这根 bar 上只值 1/6。
30 次重复抽样(每次抽 200 个):
| 指标 | 标准自助 | 序贯自助 |
|---|---|---|
| 抽样内平均唯一度 | 0.328 | 0.353 (+7.6%) |
| 重复抽中的样本数 | 34.9 / 200 | 27.5 / 200 |
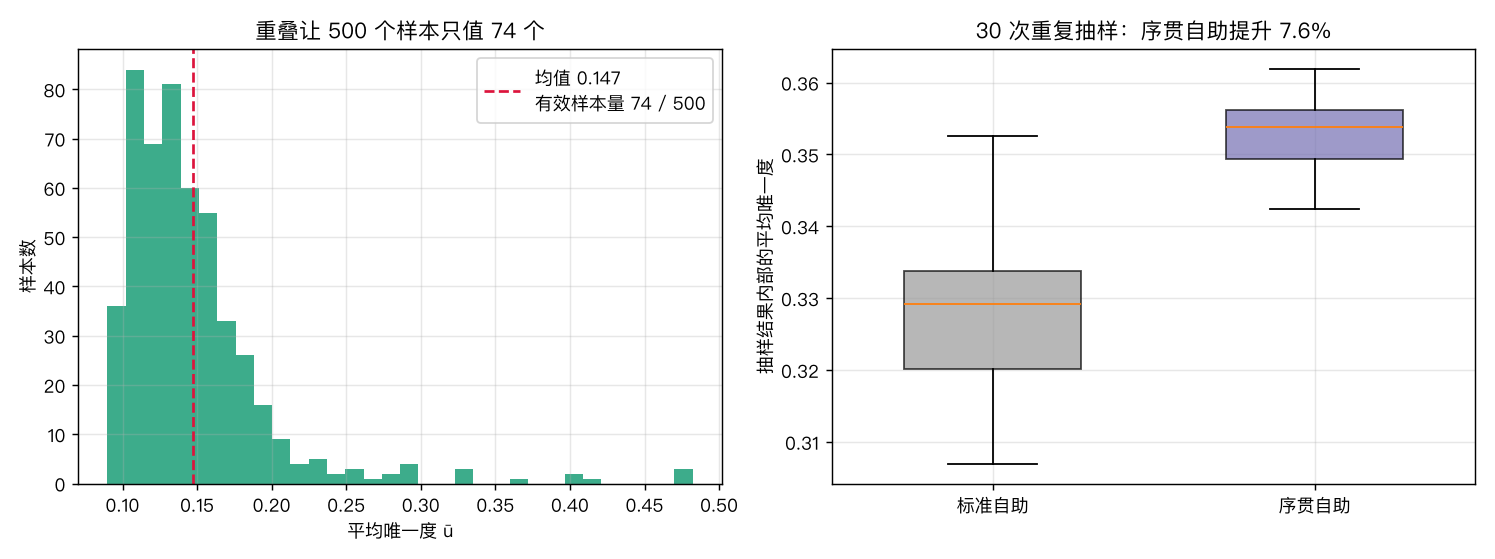
提升 7.6%——说实话,这个数字比很多人预期的小得多,我认为这才是应该被强调的结论。
原因是硬约束:当平均并发高达 6.66 时,任何抽样方式都不可能变出不存在的独立性。序贯自助能做的只是在既定的重叠结构里挑相对更分散的组合,它优化的是常数项,不是数量级。
**先修数据设计,再谈抽样技巧。**如果你的标签持有期是 60 天而采样间隔是 1 天,正确的做法是降采样或改用事件驱动采样(比如 CUSUM 触发点、美元棒边界),而不是指望序贯自助来救。序贯自助是锦上添花,不是雪中送炭。
三盆冷水#
第一,唯一度加权治的是重复计票,不治前视偏差。这是两个正交的问题,很多人把它们混为一谈。样本权重不会阻止你把未来信息塞进特征里;它也不会替代 purging 和 embargo。上面那个下游实验里我用了 200 根 bar 的间隔硬切分,这是唯一度加权之外的独立防线。三件事必须同时做:purge(剔除与测试段标签重叠的训练样本)、embargo(切分点后再空一段)、唯一度加权。少任何一件,剩下两件都救不了你。
第二,它不会凭空变出 alpha。前面 OOB 实验的数据是纯随机游走,你就算把三件套做全,真·样本外准确率也还是 0.49。样本权重的全部价值是让你更早、更准地知道自己手上有没有东西——它是诚实性工具,不是收益增强工具。下游实验里 t 值从 1.33 升到 3.95,前提是数据里本来就埋着一个真信号;如果没埋,加权后你只会得到一个更诚实的”没有信号”。很多人做完加权发现指标变差就退回等权,这恰恰是把体温计摔了。
**第三,O(n²) 的计算开销是真实约束。**序贯自助每抽一个样本都要在 (n_bars × n_samples) 的矩阵上重算一遍概率。500 个样本还能接受,10000 个样本就会让你的交叉验证跑一夜。实务上的处理是分块近似(按时间切成若干段,段内序贯、段间独立)或干脆退而求其次只用唯一度加权——毕竟从上面的数据看,加权贡献了绝大部分收益,序贯抽样只贡献了 7.6% 的唯一度提升。先做便宜的那个。
什么时候必须用#
一个简单的判据:算一下 平均唯一度 = Σū / n。
- ū > 0.7:重叠可忽略,别折腾了
- 0.3 < ū < 0.7:加唯一度加权,OOB 分数打个折看
- ū < 0.3:必须加权 + purging + embargo,而且彻底不要信 OOB,只信时间切分的样本外
- ū < 0.1:你的采样密度和标签持有期严重失配,回去改数据设计,别在建模层面打补丁
前面 2000 根 bar / 500 样本 / 25 天持有期的例子,ū = 0.147。这不是一个刻意构造的极端案例——它就是”日频采样 + 月度持有”的标准配置,也是绝大多数人默认的起手式。
在这个配置下,你的 OOB 分数系统性虚高约 10 个百分点,你的模型有很大概率在学某段行情里的巧合,而你的仪表盘会告诉你一切正常。
先量化你的 ū。然后再决定要不要相信自己的回测。