分层抽样再平衡:降低指数复制的跟踪误差
「买前 50 大市值不就等于买指数了吗?」——Top-50 覆盖 56.7% 指数权重,听起来够了,实测年化跟踪误差 10.93%。300 只成分股、5 年日频因子结构模拟给出的分解:朴素 Top-K 的误差大头不是漏掉的小票的特质波动,是行业暴露的系统性歪斜——最大行业权重偏差 10.94 个百分点,等于每天拿着一个未对冲的行业赌注。行业分层抽样只做一件事:层内配额 ∝ 层权重、层权重钉死等于指数,同样 50 只票 TE 从 10.93% 降到 7.10%;再叠加市值维度做二维分层,降到 4.66%——一只票都没多买,误差砍掉 57%。蒙特卡洛 50 次重抽特质噪音:朴素 10.94%±0.10% vs 分层 7.13%±0.05%,优势是结构性的不是运气。含成本净口径下的完整权衡也摊开了:二维分层 5 年换手 2.83 倍(朴素的 2.7 倍),年化净落后从朴素的 -507bp 收窄到 -152bp——分层多付的成本远小于它省下的误差。三盆冷水:模拟的因子结构是已知的而真实世界要先估协方差、成分股调整的换手冲击未建模、K<30 时二维分层的格子会比票还多(中阶)
一个基金经理要用 50 只股票复制一个 300 只成分股的指数。最自然的想法:买市值最大的 50 只——它们覆盖了 56.7% 的指数权重,剩下 250 只都是小票,“影响不大”。
实测:这个组合的年化跟踪误差是 10.93%。作为参照,公募指数基金的合同约束通常是年化 4% 以内,增强型产品的目标 TE 一般在 3-8%。也就是说,这个”复制”组合的跟踪误差比很多主动增强策略的主动风险还大——它根本不是在复制指数,是在做一个没人下单的主动赌注。
结论先放这:朴素 Top-K 的误差大头不是漏掉的小票,是行业暴露的系统性歪斜。 用行业分层抽样把行业权重钉死,同样 50 只票,TE 降到 7.10%;再加市值维度做二维分层,降到 4.66%——不多买一只票,误差砍掉 57%。本文用 300 只成分股、5 年日频的因子结构模拟把这条误差分解链完整跑出来。所有数字均由下文 Python 真实计算,非占位图。
一、跟踪误差的来源:一个因子分解#
跟踪误差(Tracking Error)定义为组合与基准日收益差的年化标准差。要理解它从哪来,把股票收益写成因子结构:
组合与指数的收益差就分解成三块:
- 市场暴露差:组合的加权 β 偏离 1;
- 因子暴露差:行业权重、市值暴露与指数不同 → 吃到因子波动 × 暴露差;
- 特质残差:漏掉的股票的 ε 无法分散。
关键洞察是这三块的量级完全不同。特质波动虽然单只高达 22%,但 250 只漏掉的小票的 ε 互相独立,按权重平方衰减,聚合后很小;而行业因子波动 10%,一旦行业权重偏 10 个百分点,就贡献约 1% 的年化误差——而且是系统性的,分散不掉。
模拟市场按这个结构生成:300 只股票,10 个行业(权重从 20% 到 3% 不均匀分布,模拟真实指数的金融消费占比高),市值幂律分布(Pareto 尾指数 1.4,少数巨头 + 长尾),市场因子波动 16%、行业因子 10%、市值因子 6%、特质波动 22%,5 年共 1260 个交易日。
二、朴素 Top-K 输在哪:10.94 个百分点的行业歪斜#
先看朴素方法错在哪。市值最大的 50 只票不是均匀来自 10 个行业的——幂律市值分布下,巨头扎堆在少数行业。数一下 Top-50 组合的行业权重与指数的偏差:
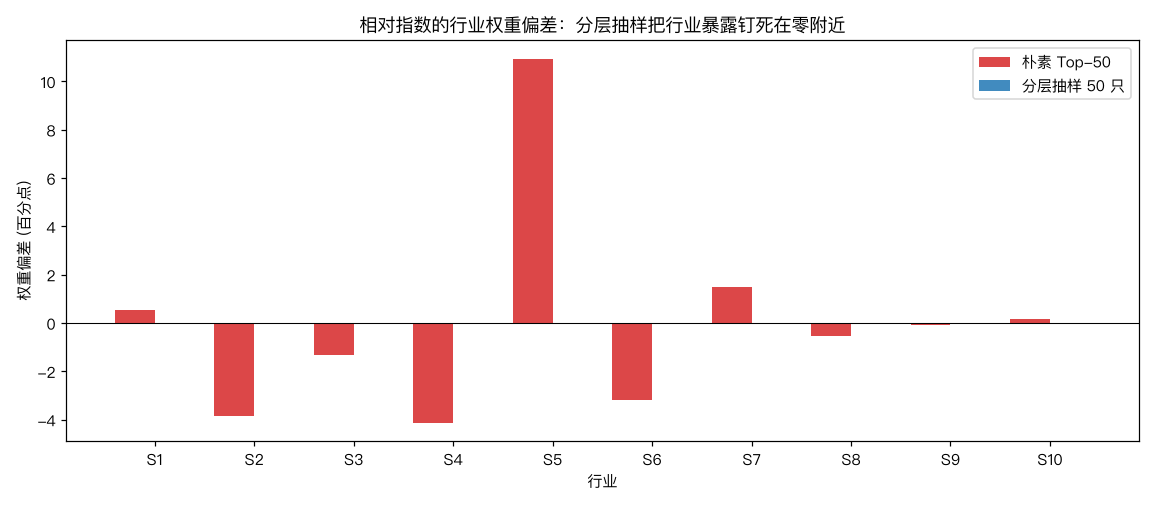
朴素 Top-50 的最大行业偏差是 10.94 个百分点——某个行业在指数里占 X%,在你的组合里占 X+10.94%。这等价于每天持有一个 10.94% 名义敞口的行业多空头寸,而行业因子年化波动 10%,仅这一项就贡献约 1.1% 的年化 TE;十个行业的偏差平方加总,再叠加市值因子暴露差(Top-K 天然重仓大票,size 暴露系统性为负),就是 10.93% 总误差的主要构成。
再强调一遍这个反直觉的点:Top-50 覆盖 56.7% 的指数权重,但权重覆盖率和跟踪误差几乎没有直接关系。 你可以覆盖 90% 的权重,只要剩下 10% 集中在同一个行业,TE 照样爆炸。误差看的是暴露差,不是覆盖率。
三、分层抽样:用约束换误差#
分层抽样(stratified sampling)的想法直白到近乎朴素:既然行业暴露差是误差大头,那就把它钉死为零。
def stratified(k):
    """行业分层:配额 ∝ 层权重,层内选最大市值,层权重校准等于指数"""
    sec_w = np.array([w_idx[sector == s].sum() for s in range(n_sectors)])
    # 每层至少 1 只,配额按最大余数法分配
    quota_f = sec_w / sec_w.sum() * k
    quota = np.maximum(np.floor(quota_f).astype(int), 1)
    while quota.sum() < k:
        i = np.argmax(quota_f - quota); quota[i] += 1
    w = np.zeros(N)
    for s in range(n_sectors):
        members = np.where(sector == s)[0]
        pick = members[np.argsort(w_idx[members])[::-1][:quota[s]]]
        # 关键一步:层内按市值分配,但层总权重 = 指数中该层权重
        w[pick] = w_idx[pick] / w_idx[pick].sum() * sec_w[s]
return w / w.sum()两个动作缺一不可:配额按层权重分(大行业多给名额),层权重校准(无论层内选了几只,层的总权重强制等于指数中该行业权重)。第二步是很多人漏掉的——只做配额不做校准,行业暴露还是会歪。
效果:同样 50 只票,行业偏差从 10.94 个百分点归零(上图蓝色柱几乎不可见),TE 从 10.93% 降到 7.10%。
剩下的 7.10% 是什么?主要是市值因子暴露(层内还是选最大市值,size 暴露仍然为负)加上层内个股的特质残差。于是自然的下一步:把市值也作为分层维度。行业 × 市值(大/小两档)共 20 个格子,每格按权重给配额、格内校准——二维分层把 TE 进一步压到 4.66%。
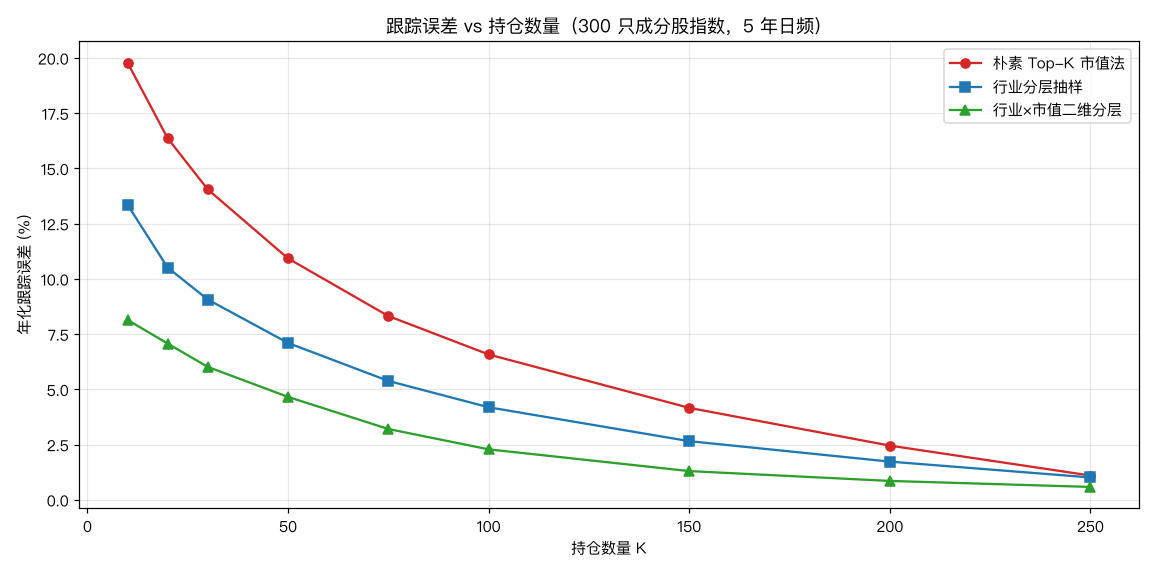
完整的 TE-K 曲线(封面图)给出三条工程规律:
- 三条曲线都近似指数衰减,但衰减常数不同:达到 4% TE,朴素法需要约 150 只,行业分层约 100 只,二维分层只要 50 只。分层的价值等价于持仓数量翻倍以上。
- K 越小分层优势越大:K=10 时朴素 19.79% vs 二维 8.14%,差距 2.4 倍;K=250 时 1.10% vs 0.58%,收敛。约束的价值在自由度稀缺时最大。
- 二维分层在 K=100 时已达 2.28%,逼近很多全复制产品含摩擦后的真实 TE——对大部分场景,100 只精选票 + 好的分层设计就是全复制的合理替代。
四、这不是运气:50 次蒙特卡洛重抽#
一次模拟的 TE 对比可能是特质噪音的运气。把因子路径固定、重抽 50 次特质噪音矩阵,看两种方法的 TE 分布:
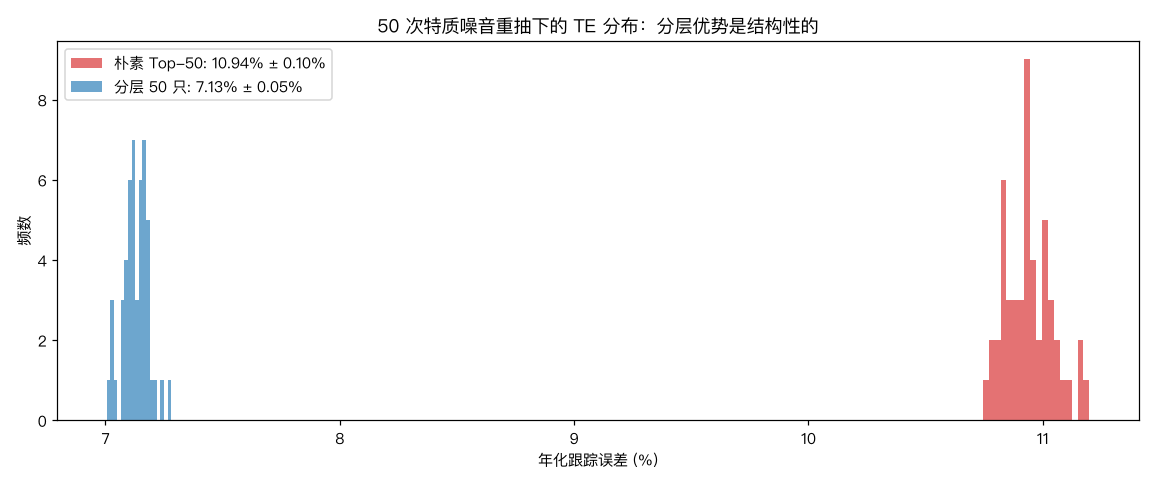
朴素 Top-50:10.94% ± 0.10%;分层 50 只:7.13% ± 0.05%。两个分布完全不重叠,且标准差小到可以忽略——3.8 个百分点的差距全部来自结构(行业暴露差被消灭),与特质噪音的具体实现无关。这正是因子分解预言的结果:系统性暴露差贡献的误差是确定性的,特质项只贡献分布的宽度。
顺带注意分层组合的 TE 标准差只有朴素的一半:钉死系统性暴露后,组合误差由分散化的特质项主导,而分散化的东西天然更稳定。分层不仅降低了误差的均值,还降低了误差的方差——对需要向持有人承诺 TE 上限的产品,第二点同样值钱。
五、含成本的完整账本:多付的换手买回了什么#
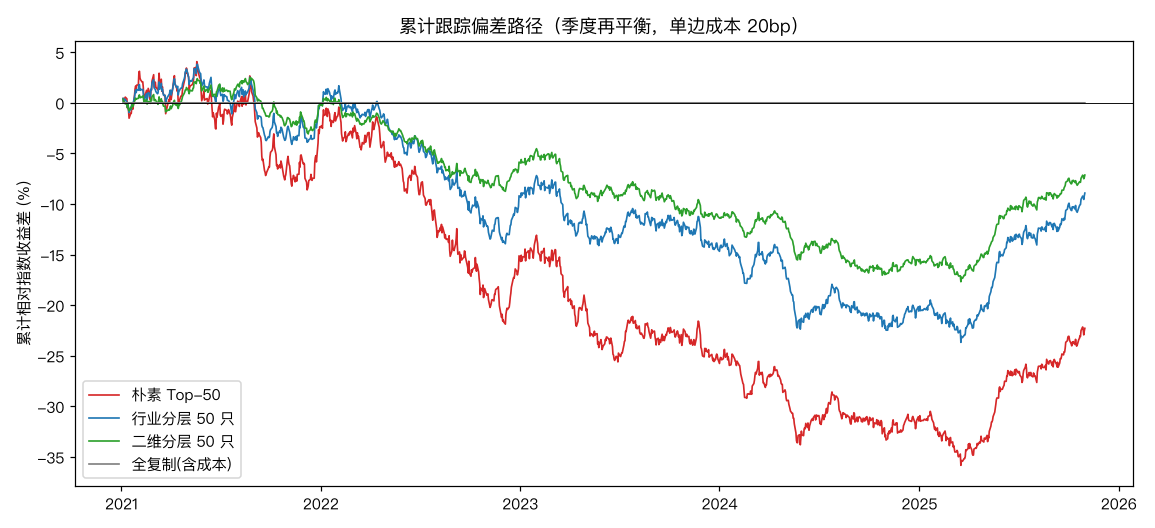
分层不是免费的。指数权重每天漂移,行业权重跟着漂移,分层组合要维持”层权重 = 指数层权重”就要定期校准。季度再平衡、单边成本 20bp,跑出含成本的净口径:
| 方法(50 只) | 净 TE | 年化净落后 | 5 年累计换手 |
|---|---|---|---|
| 朴素 Top-50 | 9.54% | -507 bp | 1.02 倍 |
| 行业分层 | 6.99% | -191 bp | 1.81 倍 |
| 二维分层 | 4.44% | -152 bp | 2.83 倍 |
三个观察:
- 分层的换手确实更高:二维分层 5 年换手 2.83 倍,是朴素法的 2.7 倍——校准层权重要持续小额调仓。但按 20bp 单边成本折算,多付的换手成本 5 年约 72bp,年均不到 15bp。
- 买回来的东西大得多:年化净落后从 -507bp 收窄到 -152bp。朴素法巨大的落后主要来自 size 暴露的系统性拖累(模拟中小票因子路径恰好为正贡献,重仓大票的 Top-50 吃了满额负暴露)——这提醒我们 TE 不只是”波动”,暴露歪了迟早会以收益差的形式兑现。
- 累计路径图里朴素法的偏差是趋势性的,不是围绕零震荡——系统性暴露差的典型形状。分层组合的路径贴着零走,偏差是可均值回归的特质噪音。看 TE 数字之外,永远看一眼累计偏差的形状:趋势形 = 暴露没对齐,震荡形 = 只剩特质噪音。
已知偏差#
三盆冷水:
- 模拟的因子结构是已知且正确的。我按行业分层,是因为我知道收益由行业因子驱动。真实世界里你要先估协方差矩阵或选对分层维度——分错维度(比如真实驱动是风格而你按行业分层)会让优势大打折扣。分层抽样的上限由”你的分层变量解释了多少截面协方差”决定。
- 成分股调整未建模。真实指数每半年调样,被调出的票要强制卖出,调入的票在生效日前后有拥挤交易冲击。这部分换手对所有方法一视同仁,但对小 K 组合的单票冲击更大。
- 小 K 时二维分层会碰到格子数下限。10 行业 × 2 市值档 = 20 格,K=10 时格子比票还多,只能合并格子或退化为一维分层——曲线左端的二维优势读数有配额取整的噪音。三维以上的分层(行业×市值×风格)在 K<100 时基本不可行,维度不是越多越好。
结果解读#
- 跟踪误差是暴露问题,不是数量问题。 权重覆盖率 56.7% 的组合可以有 10.93% 的 TE,而同样 50 只票钉死行业暴露后只有 7.10%。加票之前先对暴露——这是复制组合构建的第一优先级。
- 分层的本质是把误差预算花在刀刃上。 系统性暴露差是确定性的、分散不掉的误差,必须用约束消灭;特质残差是可分散的,用数量稀释。朴素法把两种误差混在一起用数量硬怼,效率低一个档次。
- TE 均值和 TE 方差要分开看。 蒙特卡洛显示分层组合的误差分布又窄又稳——对合同里写着 TE 上限的产品,可预测性本身就是风控资产。
- 换手成本与误差的权衡有明确答案。 年均约 15bp 的额外成本换回 355bp 的年化净落后收窄,这笔账在任何合理的成本假设下都成立。真正的约束不是成本,是分层维度的正确性。
- 实务锚点:用 50-100 只票复制沪深 300 这类指数时,行业中性是底线约束,市值(size)是第二个必须控制的维度;曲线显示 K=100 + 二维分层 ≈ 2.3% TE,已进入增强型产品的主动风险预算区间——剩下的自由度可以拿去做增强,而不是浪费在无意识的行业歪斜上。
本文全部数据来自 300 只成分股、5 年日频的因子结构蒙特卡洛模拟(市场/行业/市值三因子 + 特质噪音,市值幂律分布,行业权重非均匀),TE 稳定性经 50 次特质噪音重抽验证。模拟代码可复现(固定随机种子 7)。