CAPM 用一个数概括了风险:beta。资产对市场的敏感度,涨也 beta、跌也 beta,对称、优雅、好算。但任何一个真正管过组合的人都知道一件事——市场上涨 1% 时你跟不跟,和市场下跌 1% 时你跟不跟,根本不是一回事。有些资产在牛市里温吞吞、熊市里却带头跳水;它的 beta 看起来平平无奇,下行风险却大得吓人。
这就是「下行 beta」和「下偏矩」(Lower Partial Moments, LPM)要解决的问题。它们不满足于用一个对称的方差去丈量风险,而是只盯着收益跌破目标的那一半,把「亏损概率」「期望不足」「半方差」拆开来看。本文用 numpy 从零算一遍,回答三个问题:为什么两个 beta 相同的资产风险可能天差地别?下行 beta 怎么算?半方差和 Sortino 比率为什么比夏普更诚实?
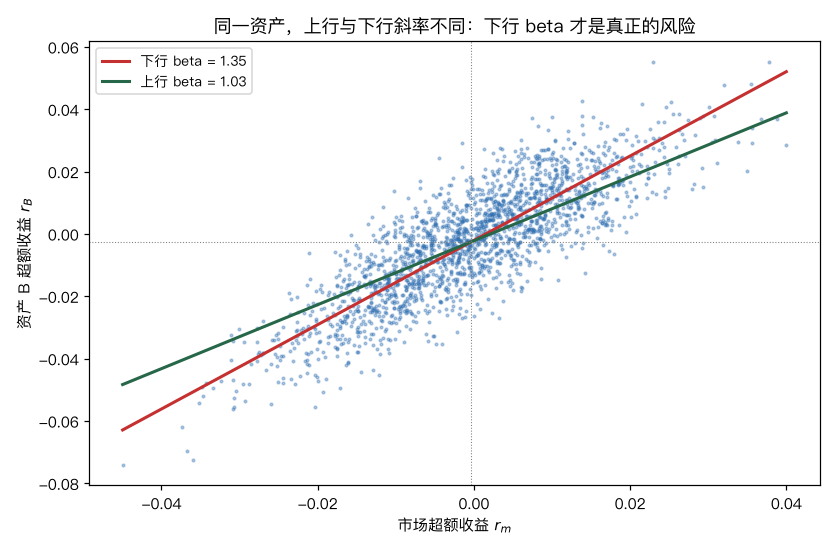
一、标准 beta 的盲区:对称假设#
标准 beta 的定义是协方差除以市场方差:
它隐含一个假设:资产对市场的反应是线性且对称的。也就是说,市场涨 1% 和跌 1%,资产都按同一个 移动。这显然是理想化——现实中,投资者对损失的厌恶(损失厌恶)远大于对收益的喜爱,很多策略(比如卖出看跌期权的组合、高杠杆结构、某些成长股)天生就是「上行钝、下行敏」。
我造了两条假数据:资产 A 是纯对称的(上行下行都是 beta=1),资产 B 则是上行 beta=1、下行 beta=1.5——牛市跟得上,熊市跌得更狠。用标准公式一算,两者的 beta 分别是 1.02 和 1.27,确实有差距,但还看不出「天壤之别」。可是换下行 beta 一看,资产 B 的下行 beta 飙到 1.35,而资产 A 只有 1.01。标准 beta 把 B 的下行风险平均摊平到了上行区间里,稀释了真实的危险信号。
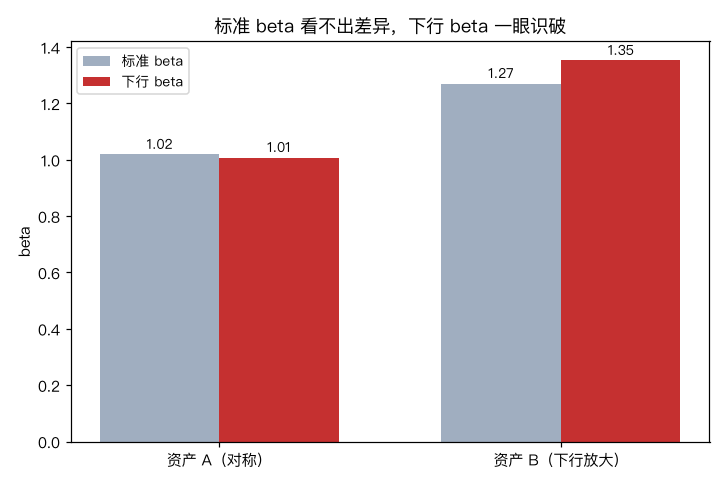
二、下行 beta 怎么算#
下行 beta 的思路很直接:只用市场下跌(低于其均值/目标)的那段样本去回归。形式上,它本质上是「下半协方差」除以「下半方差」:
其中 是目标收益(通常取无风险利率或市场均值)。代码非常短:
import numpy as np

def downside_beta(r_i, r_m, tau=None):
    if tau is None:
        tau = r_m.mean()
    neg = r_m < tau                      # 只看市场下行段
    num = np.mean((r_i[neg] - r_i.mean()) * (r_m[neg] - r_m.mean()))
    den = np.mean((r_m[neg] - r_m.mean()) ** 2)
    return num / den

# 资产 B: 上行 beta=1, 下行 beta=1.5
rB = np.where(mkt < 0, 1.5 * mkt, 1.0 * mkt) + np.random.normal(0, 0.010, n)
print(downside_beta(rB, mkt)) # ≈ 1.35注意这个「下行 beta」不是唯一的定义——有些实践者直接用市场负收益段做 OLS 回归,结果与上面的「下半协方差/下半方差」略有差异,但方向一致。关键在于:它把「市场下跌时你跟不跟」单独拎出来量化,而不是和上行段混在一起。
三、下偏矩(LPM):一个家族,三个视角#
下行 beta 只回答了「跟跌多少」,下偏矩则更完整地刻画「跌得有多惨」。LPM 的定义是:
是阶数, 是目标收益。不同的 对应完全不同的风险视角:
- :LPM₀ = 亏损概率,即 。只关心「会不会亏」,不关心亏多少。
- :LPM₁ = 期望不足(expected shortfall 的下半部分),关心「平均亏多少」。
- :LPM₂ = 半方差(semi-variance),关心「亏损的波动有多大」,对深度亏损给更高权重。
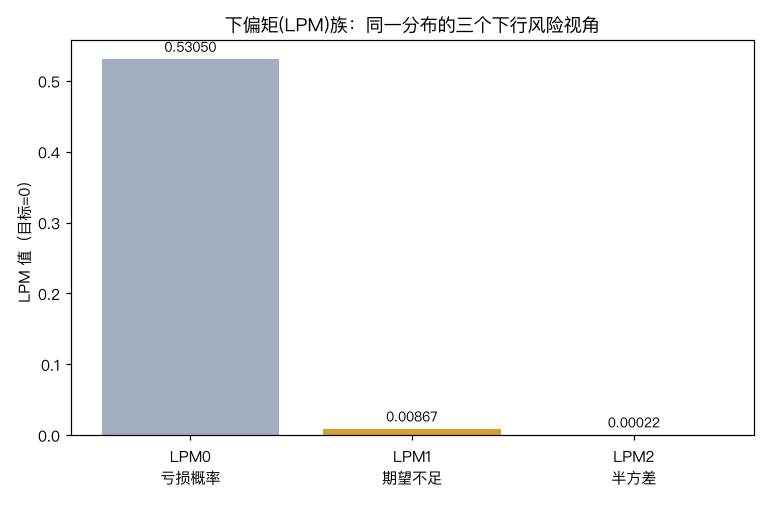
用资产 B 的数据一算, 时:LPM₀≈0.53(超过一半时间在亏)、LPM₁≈0.0087、LPM₂≈0.00022。三个数讲的是同一个故事的三层:「经常亏、平均亏 0.87%、偶尔亏得很深」。而标准方差只会给你一个笼统的总波动率,把这三种截然不同的痛感揉成一团。
四、半方差 vs 总方差:B 的下行风险被掩盖了#
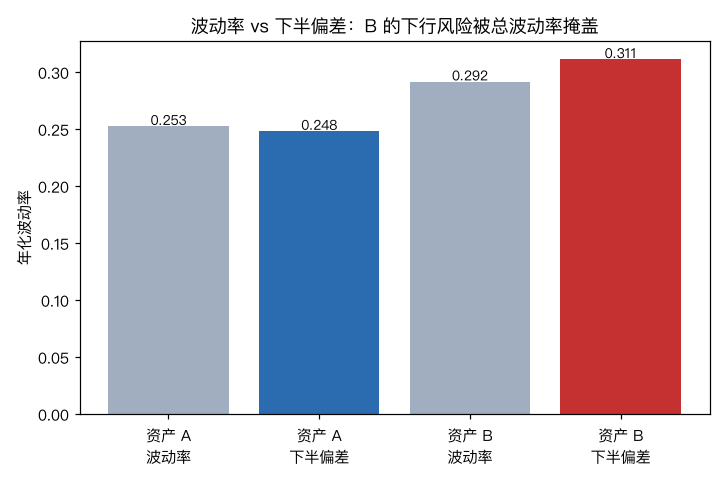
这是最反直觉、也最重要的一点。看年化数据:
| 指标 | 资产 A(对称) | 资产 B(下行放大) |
|---|---|---|
| 总波动率 | 25.3% | 29.2% |
| 下半偏差(semi-deviation) | 24.8% | 31.1% |
总波动率显示 B 只比 A 高约 4 个百分点,看起来「风险略大」。但下半偏差显示 B 的下行风险比 A 高出 6 个多百分点,且绝对值 31.1% 已经相当扎眼。换句话说,B 比 A 多出来的风险,几乎全部集中在下行方向——而总波动率因为把上行波动也算进去,把这个危险信号稀释掉了。
下半偏差(semi-deviation)就是半方差的平方根,它是 Sortino 比率的分母:
夏普比率用总波动率做分母,把「赚钱的波动」也当风险惩罚了;Sortino 只惩罚「亏钱的波动」。对于一个目标是「别亏、稳增长」的组合,Sortino 比夏普更贴合你真正在意的风险。
五、实战里怎么用#
下行 beta 和下偏矩不是学术玩具,它们能直接落进你的组合管理流程:
- 选股/选策略:在标准 beta 之外加一列「下行 beta」做二次筛选,把那些「牛市装死、熊市跳楼」的标的揪出来。很多「看起来稳健」的低波动策略,下行 beta 其实很高。
- 风险预算:用下半协方差矩阵替代协方差矩阵做风险平价,权重会天然偏向下行风险小的资产。
- 绩效归因:把总波动拆成「上行波动 + 下行波动」,分别看 alpha 的来源;如果 alpha 全靠下行波动的放大,那它本质是「借了尾部风险」,不可持续。
- 尾部对冲:LPM₁(期望不足)直接告诉你「一旦跌破目标,平均会亏多少」,这是给尾部对冲定价的天然输入。
六、结语:对称的优雅,掩盖了不对称的残酷#
CAPM 的对称假设让数学变得漂亮,但漂亮不等于正确。金融收益的下行和上行从来不是镜像关系——损失厌恶、杠杆、结构性产品、流动性挤兑,都在制造不对称。标准 beta 和总方差把这些不对称「平均」掉了,下行 beta 和下偏矩则把它们「放大」出来。
如果你做的是风险管理,而不是教科书演示,请务必在标准 beta 旁边再放一列下行 beta、在总波动率旁边再放一列下半偏差。两个 beta 相同的资产,下行 beta 可能差出一个数量级;两个波动率相同的组合,下行风险可能完全不同。 那一半被对称性掩盖的风险,恰恰是最可能要你命的那一半。