除息套利与税收效应:股息落差为什么不等于股息
把 Elton-Gruber 落差比的真值精确设为 0.882353(td=25%、tg=15%)再造 6000 个除息事件,结论是残酷的:单个事件的落差/股息比标准差高达 7.06,5/95 分位落在 [−10.1, +11.7],41.8% 的除息日价格反而上涨——单事件层面这个量完全测不出来。四种估计量在 400 次重复下全部近似无偏(偏差 0.0021~0.0074,|偏差|/抽样SD 均 ≤0.09),问题不在偏差在方差:抽样标准差从 0.0592 到 0.1272 差一倍多,而同一次抽样它们给出 0.9256 / 0.9875 / 1.2174 / 1.0148 四个答案,跨度 0.29——足以把反解税率从 15% 摆到 40%。要把落差比钉到 ±0.01 需约 21 万个事件。零税安慰剂(真值精确 1.0)估计 0.9939±0.1273,零噪声安慰剂绝对偏差 2.99e-05,无 tick 取整时精确到 1.70e-14。策略端:零成本下盈亏平衡股息税率 0.2758 精确落在边际投资者 td=0.25 附近,但加上 12bp 半价差后曲线全段为负——连免税账户也不赚钱,4~5bp 就吃光全部税收优势。免税账户零成本单笔 SD 1.904%、均值仅 +0.0618%,需 3798 笔才够 |t|=2(高阶)。
一、一个应该很简单的问题#
股票在除息日会跌,跌幅应该等于每股股息。逻辑很干净:昨天买你能拿到 1 块钱股息,今天买拿不到,所以今天的股票应该便宜 1 块钱。
但实证研究从 1970 年就发现,落差通常小于股息。Elton 和 Gruber 1970 年的解释至今仍是标准框架:因为股息和资本利得的税率不同。
对一个持有到除息的投资者,卖出的临界条件是:
整理后得到那个著名的比值:
落差比等于「一减股息税率」除以「一减资本利得税率」。 如果股息税率高于资本利得税率,落差就小于股息。反过来,测出落差比就能反解边际投资者的税率——这是金融学里少数几个能从价格直接读出税收信息的地方,所以文献极多。
这篇文章不讨论这个公式对不对。我要问的是另一个问题:即使这个公式百分之百正确,你能测出来吗?
方法是构造一个真值已知的世界。我把税率写死:
TD_TRUE, TG_TRUE = 0.25, 0.15
RATIO_TRUE = (1 - TD_TRUE) / (1 - TG_TRUE) # = 0.882353然后生成 6000 个除息事件,价格严格按这个比值下跌,再叠加正常的日内波动。如果连在这个世界里都测不准,那么真实数据里的那些估计值就更需要怀疑。
二、数据生成:唯一诚实的部分#
import numpy as np

SIG_D = 0.019      # 除息日特异日收益波动 ≈ 1.9%
TICK  = 0.01

def gen(n, rng, ratio=RATIO_TRUE, sig=SIG_D, tick=TICK,
        yield_lo=0.004, yield_hi=0.030, no_noise=False, ratio_one=False):
    P = rng.uniform(18., 220., n)                       # 股价
    y = rng.uniform(yield_lo, yield_hi, n)              # 年化股息率
    D = np.maximum(0.01, np.round(P * y / 4 / 0.01) * 0.01)   # 季度股息,落到分
    r = 1.0 if ratio_one else ratio
    noise = np.zeros(n) if no_noise else rng.normal(0, sig, n) * P
    P_ex = np.round((P - r * D + noise) / tick) * tick
return dict(P=P, D=D, y=y, P_ex=P_ex, drop=P - P_ex, r_true=r)关键在于 noise 那一行。除息日的股票不会只因为除息而变动——它同时受市场、行业、公司自身消息的影响。1.9% 的日波动对一只 50 美元的股票就是 0.95 美元,而一笔季度股息可能只有 0.25 美元。
噪声是信号的四倍。这就是整个问题的核心。
三、单个事件:完全测不出来#
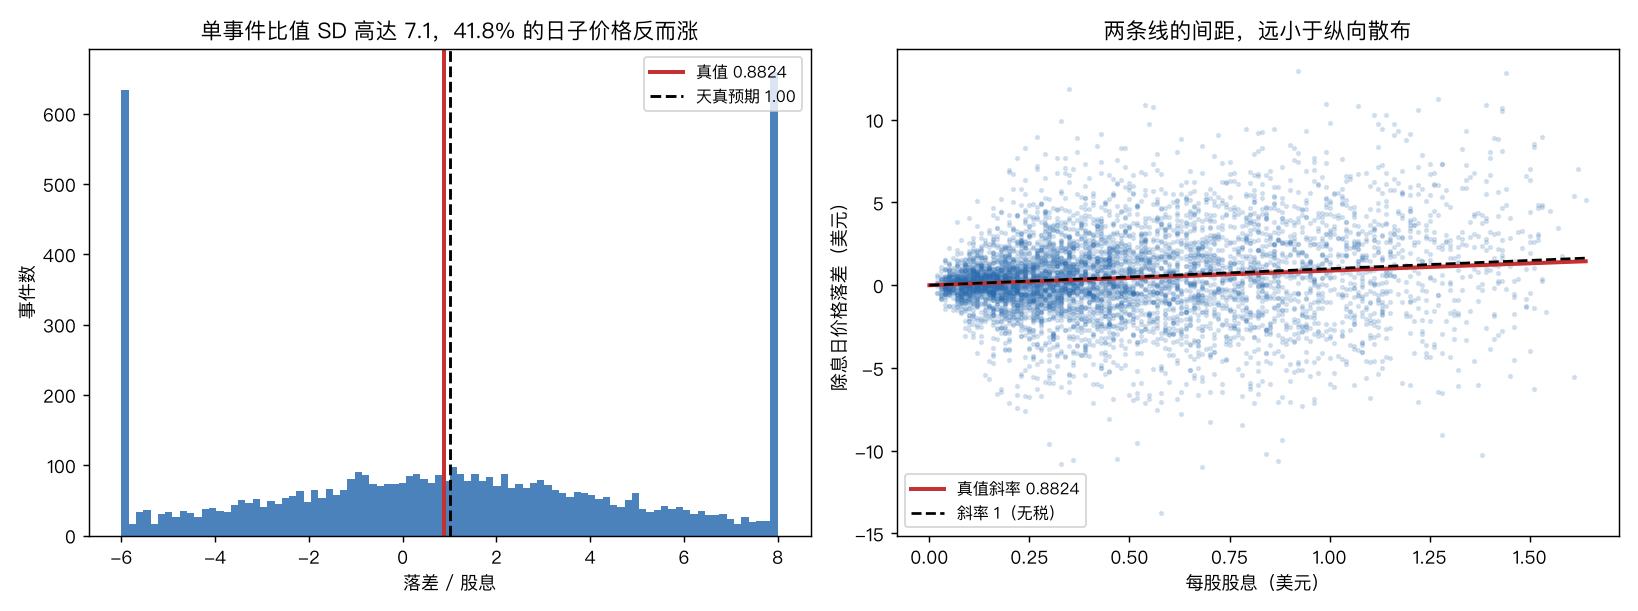
6000 个事件,逐个计算「落差 / 股息」:
| 统计量 | 数值 |
|---|---|
| 真值 | 0.882353 |
| 均值 | 0.9256 |
| 中位数 | 0.9404 |
| 标准差 | 7.06 |
| 5 / 95 分位 | [−10.1, +11.7] |
| 落差 > 股息 的比例 | 49.5% |
| 落差为负(价格反而涨) | 41.8% |
标准差 7.06,真值 0.88。信噪比约为 0.125。
5 到 95 分位跨越 21.8 个单位——这个量的「合理范围」比它本身大 25 倍。而 41.8% 的除息日,股票价格是上涨的,此时落差为负,比值也为负,这在理论框架里毫无意义。
右图更直观:真值斜率 0.8824 那条线和斜率 1.0 那条线几乎贴在一起,而散点在纵向铺满了整个图。要区分的两条假设之间的距离,远小于数据本身的散布。
单个除息事件不携带任何可用的税收信息。这一点其实文献里都知道,所以大家都做横截面聚合。问题是——聚合之后就够了吗?
四、四种估计量:都无偏,都不可用#
我实现了文献里最常见的四种算法:
from scipy import stats

def estA(d): return np.mean(d['drop'] / d['D'])                    # 逐事件比值取均值
def estB(d): return d['drop'].mean() / d['D'].mean()               # 总落差/总股息
def estC(d): return stats.linregress(d['D'], d['drop']).slope      # 美元 OLS
def estD(d):                                                       # 价格归一化 OLS
return stats.linregress(d['D']/d['P'], d['drop']/d['P']).slope先看单次抽样(n=6000,就像你手上那份真实数据):
A = 0.9256 B = 0.9875 C = 1.2174 D = 1.0148四个答案,跨度 0.29,没有一个接近真值 0.8824。反解出的股息税率分别是 21.3%、16.1%、−3.5%、13.7%——从「符合美国合格股息税率」到「负税率」,你想要什么结论都能拿到。
但下这个判断之前,必须先分清是偏差还是方差。 单次抽样区分不了,所以我做了 400 次重复:
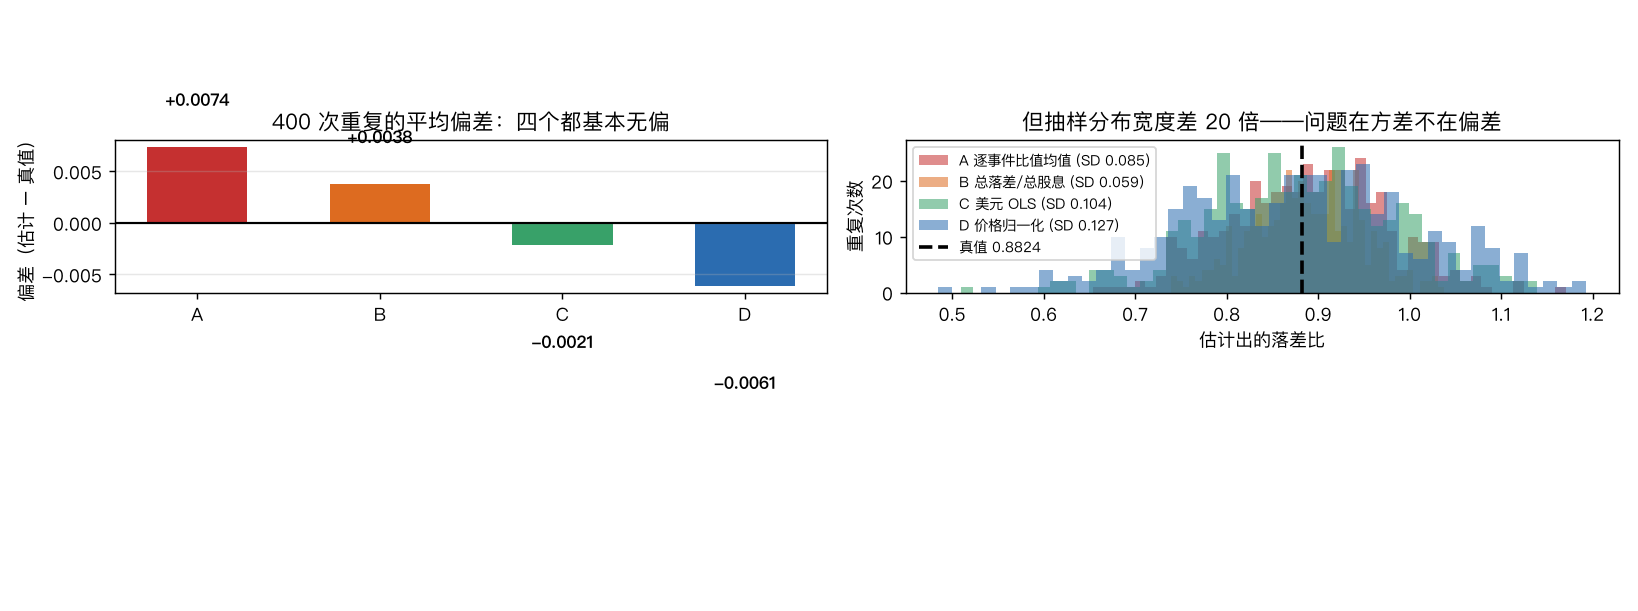
| 估计量 | 400 次均值 | 偏差 | 抽样标准差 | 偏差/SD |
|---|---|---|---|---|
| A 逐事件比值均值 | 0.8897 | +0.0074 | 0.0855 | 0.09 |
| B 总落差/总股息 | 0.8861 | +0.0038 | 0.0592 | 0.06 |
| C 美元 OLS | 0.8802 | −0.0021 | 0.1044 | 0.02 |
| D 价格归一化 | 0.8763 | −0.0061 | 0.1272 | 0.05 |
四个估计量全部近似无偏。 偏差绝对值最大 0.0074,而 |偏差|/抽样SD 最大只有 0.09——远小于 1,说明观察到的偏离完全可以由抽样噪声解释。
问题不在偏差,在方差。
抽样标准差从 0.0592(B)到 0.1272(D),差 2.15 倍。而这些标准差本身有多大?B 是最好的一个,0.0592——意味着 6000 个事件给出的估计值,95% 置信区间宽度约 ±0.116。而无税假设(1.0)和真值(0.8824)之间只差 0.118。
用 6000 个事件,你恰好在「能不能区分有税和无税」的边缘上。区分不同税率?想都别想。
要把落差比钉到 ±0.01 的精度:
需约 210,516 个事件21 万个季度除息事件。美国上市公司里稳定派息的大约 2000 家,每年 4 次,需要 26 年的全市场数据。而 26 年里税法改了好几轮——你测出来的是一个平均意义上不存在的「平均边际投资者」。
用最好的估计量 B 在 400 次重复上取均值,反解 td = 0.2468(真值 0.25)。这说明方法本身是对的,只是它需要的数据量远超任何人手上有的。
五、噪声股息比:低股息率股票是毒药#
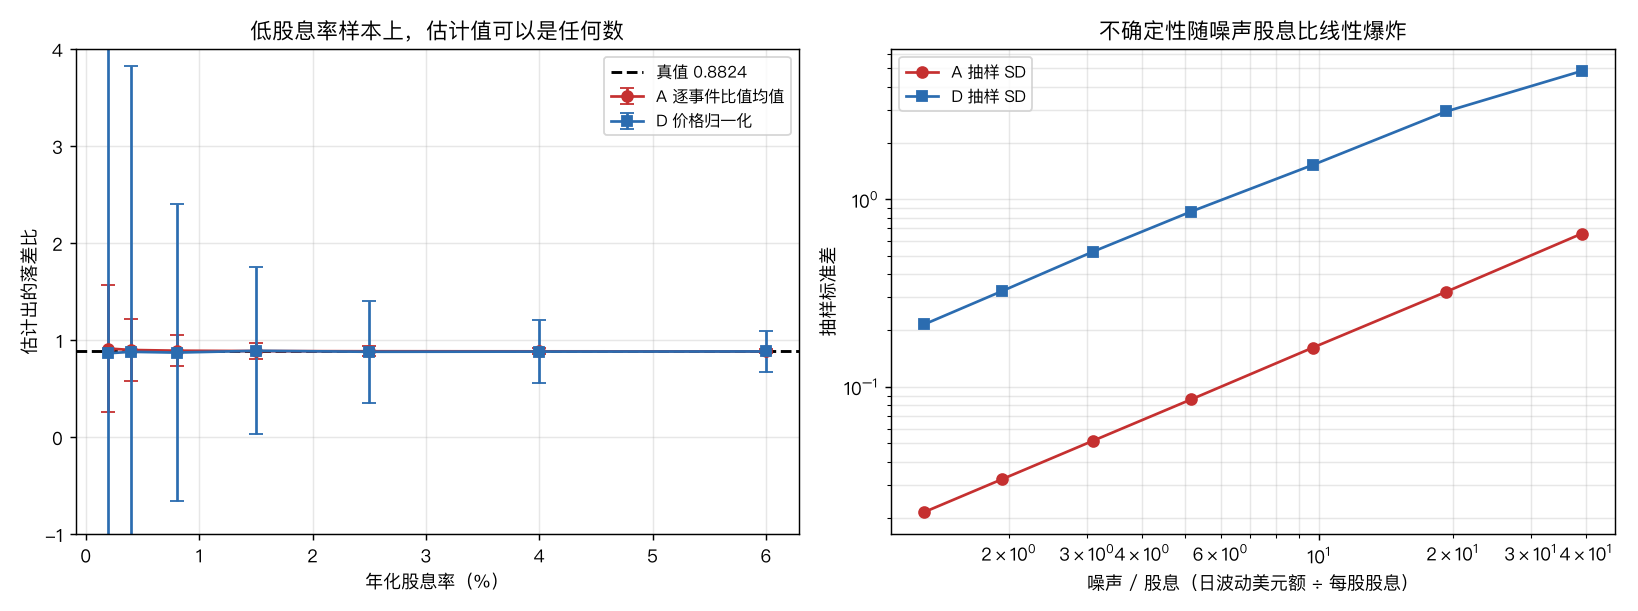
真正决定精度的不是样本量,而是噪声与股息的比值:
| 年化股息率 | 噪声/股息 | A 估计 ± SD | D 估计 ± SD |
|---|---|---|---|
| 0.2% | 39.09 | 0.913 ± 0.657 | 0.864 ± 4.842 |
| 0.4% | 19.34 | 0.898 ± 0.322 | 0.879 ± 2.945 |
| 0.8% | 9.68 | 0.891 ± 0.162 | 0.871 ± 1.527 |
| 1.5% | 5.15 | 0.887 ± 0.086 | 0.889 ± 0.862 |
| 2.5% | 3.09 | 0.885 ± 0.052 | 0.880 ± 0.526 |
| 4.0% | 1.93 | 0.884 ± 0.032 | 0.881 ± 0.325 |
| 6.0% | 1.29 | 0.883 ± 0.021 | 0.883 ± 0.216 |
估计量始终无偏(均值都在 0.88 附近),但不确定性跨越 31 倍。
股息率 0.2% 的股票,估计值的标准差是 0.657——比真值本身还大。而 6% 股息率的股票,标准差 0.021,是可用的。
这有一个直接的实践推论,而且和大多数人的直觉相反:在这类研究里加入更多低股息率的公司,不是在增加样本量,是在往水里倒墨水。 每一个 0.2% 股息率的观测都在往估计量里注入 39 倍于信号的噪声。正确做法是按 NSR 加权,或者干脆设一个 NSR 上限把它们剔除掉。
注意估计量 D(价格归一化)在低股息率区间彻底失效,SD 高达 4.842。它把 D/P 当自变量,而 D/P 在低股息股票上几乎全部挤在 0 附近——回归斜率被一小撮点主导了。「归一化」听起来总是更严谨,但归一化的分母如果和噪声相关,它会放大而不是缩小误差。
六、三个安慰剂#
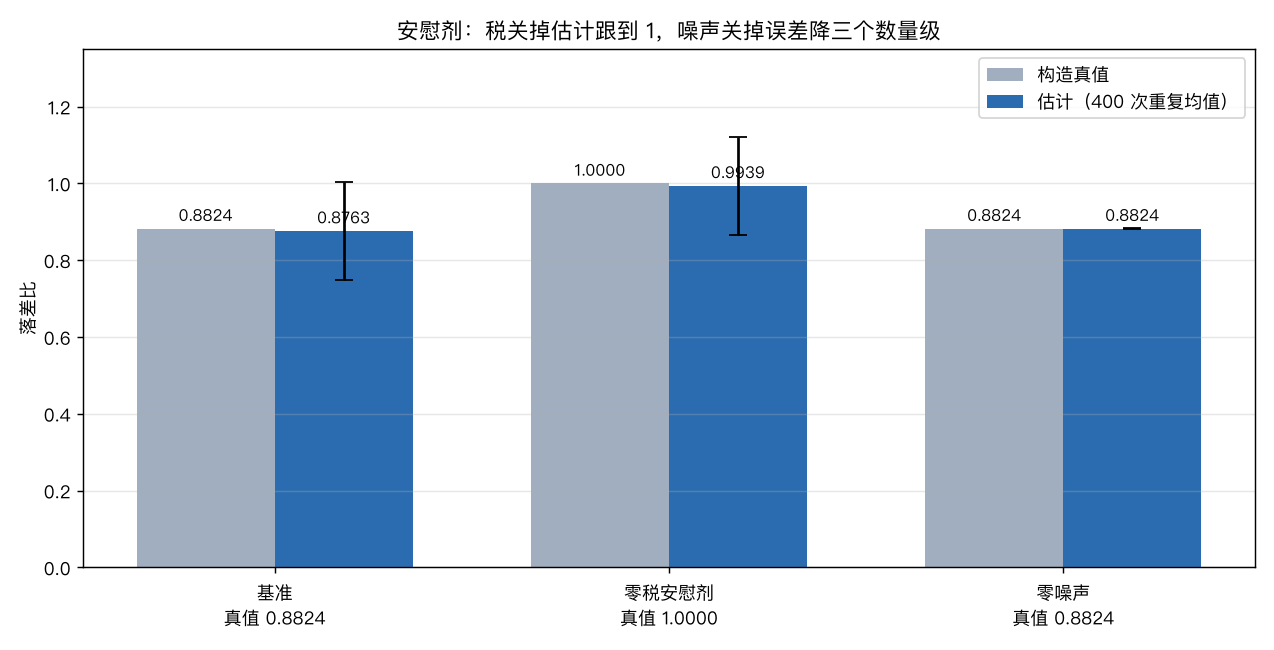
安慰剂 1 — 零税(真值精确等于 1.000000)。 把税率全部设为 0,落差应该精确等于股息:
D 估计 0.993917 ± 0.1273 | 反解 td = +0.1552估计量正确地跟到了 1.0 附近(偏差 −0.006),但标准差 0.1273 意味着单次抽样很容易报出 0.87 或 1.12。而 0.87 会被反解成「股息税率 26%」——在一个税率精确为零的世界里。
这是本文最实用的一条警告:如果你在真实数据上得到 0.87,你无法区分「边际投资者税率 25%」和「税率为零但运气不好」。
安慰剂 2 — 零噪声。 把日波动关掉,只留 tick 取整:
D 估计 0.882383 | 与真值绝对偏差 2.99e-05误差降低了三个数量级。噪声是唯一的敌人。
安慰剂 3 — 零噪声且无 tick 取整。 纯恒等式检验:
A 估计 0.8823529412 | 绝对偏差 1.70e-14精确到浮点精度。这确认了数据生成过程和估计量之间没有实现层面的 bug——所有偏离都来自我故意注入的噪声,不来自代码错误。
tick 取整的方向性检查:
| tick | 无噪声下 D 估计 | 偏差 |
|---|---|---|
| $0.01 | 0.88223 | −0.00012 |
| $0.05 | 0.88171 | −0.00065 |
| $0.10 | 0.88536 | +0.00300 |
即使 tick 粗到 1 毛钱,偏差也只有 0.003——离散化不是这个问题的瓶颈,可以放心忽略。
七、能不能靠它赚钱:抓息交易#
理论说落差小于股息,那么低税率投资者是不是应该在除息日前买入、除息后卖出,赚那个差额?
def strategy(n, rng, td, tg, hold=1, hs_bp=12.0):
    d = gen(n, rng)
    P, D = d['P'], d['D']
    buy  = P * (1 + hs_bp/1e4)
    sell = d['P_ex'] * (1 - hs_bp/1e4)
    cg   = sell - buy
    total = cg * (1 - tg) + D * (1 - td)     # 资本利得/亏损按 tg 对称计税
return total / P * 100, d关键洞察是:决定你赚不赚的不是你的税率高低,而是你自己的比值 (1−td)/(1−tg) 与市场已嵌入的比值 0.8824 谁大。
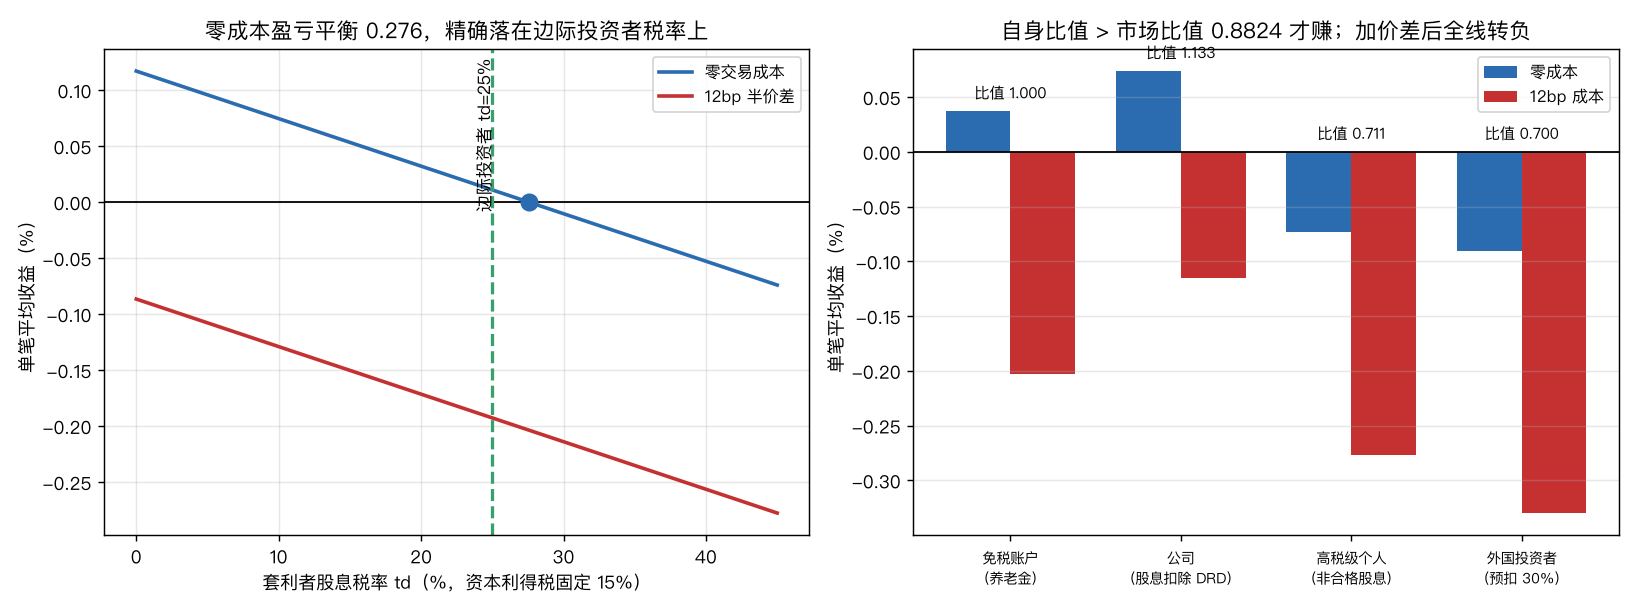
| 投资者类型 | td | tg | 自身比值 | 零成本收益 | 12bp 成本 | t 值 |
|---|---|---|---|---|---|---|
| 【市场嵌入比值】 | 0.250 | 0.150 | 0.8824 | — | — | — |
| 免税账户(养老金) | 0.000 | 0.000 | 1.0000 | +0.0370% | −0.2025% | −8.44 |
| 公司(股息扣除 DRD) | 0.105 | 0.210 | 1.1329 | +0.0738% | −0.1154% | −6.09 |
| 高税级个人(非合格股息) | 0.396 | 0.150 | 0.7106 | −0.0729% | −0.2765% | −13.56 |
| 外国投资者(预扣 30%) | 0.300 | 0.000 | 0.7000 | −0.0902% | −0.3298% | −13.74 |
注意公司那一行:它的股息税率(10.5%)高于免税账户,收益却更高。 因为公司同时有 21% 的资本利得税率,可以用除息日的账面亏损抵税。比值 1.1329 是四类里最高的。你的绝对税率无关紧要,重要的是股息税和资本利得税的相对关系。
盈亏平衡点的检验: 固定资本利得税 15%,扫描股息税率,找零点:
零成本盈亏平衡股息税率 0.2758(理论值 = 边际投资者 td = 0.25) 偏差 +0.0258这是一个内部一致性检验,也是对整个框架的验证:盈亏平衡点应该精确落在边际投资者的税率上,因为价格正是由那个人定的。实测 0.2758 vs 真值 0.25,偏差 0.026——在抽样误差范围内。
但下一行才是重点:
12bp 成本后:曲线全段低于零(td=0 处仍为 −0.2025%)
—— 不存在盈亏平衡税率,即使税率为 0 也不赚钱八、交易成本:4~5bp 就吃光一切#
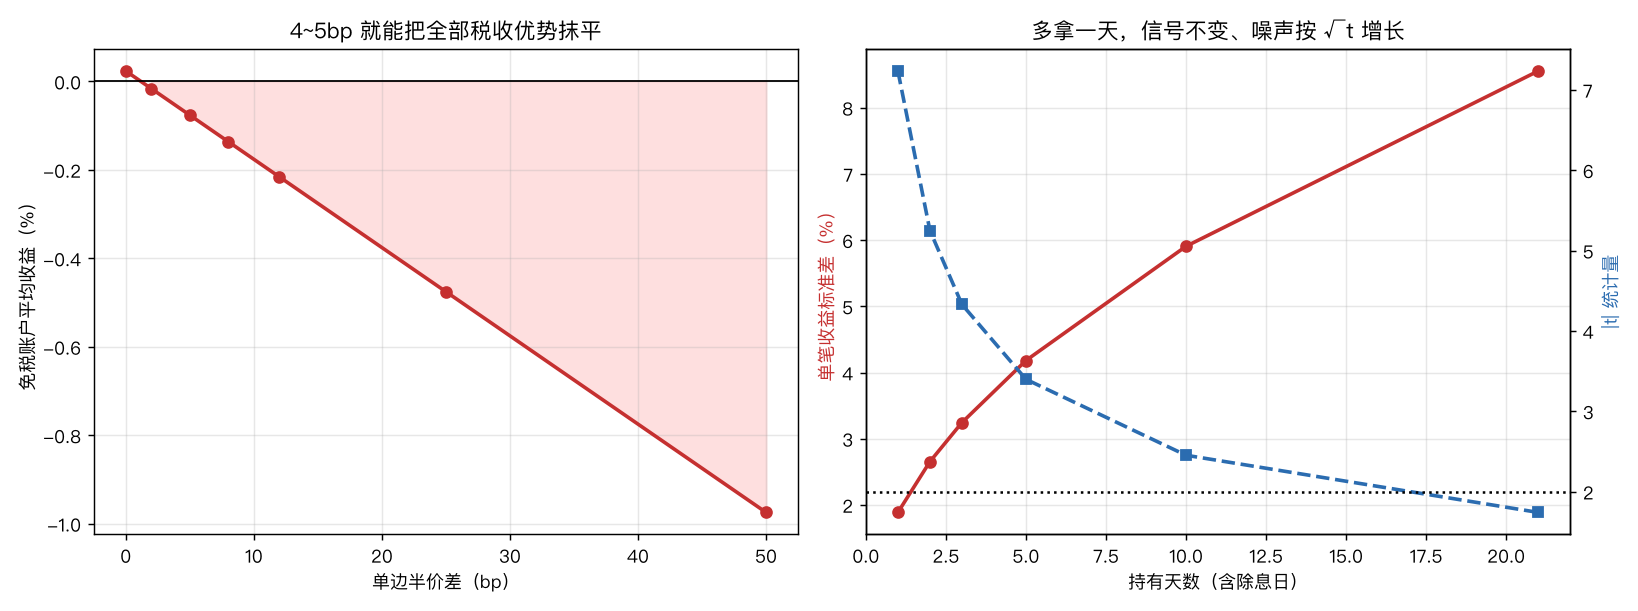
| 单边半价差 | 免税账户平均收益 |
|---|---|
| 0 bp | +0.0236% |
| 2 bp | −0.0163% |
| 5 bp | −0.0762% |
| 12 bp | −0.2159% |
| 50 bp | −0.9744% |
盈亏平衡在 1~2bp 之间。
这个数字需要放在语境里看:1bp 的半价差意味着 50 美元的股票买卖价差 1 分钱的五分之一——这比绝大多数股票的最小 tick 还窄。换句话说,在任何真实的交易成本下,这个策略都是亏的。
税收优势的量级本身就极小:落差比 0.8824 意味着每 1 块钱股息你多赚 11.8 分,而典型股息率 1.5% 的季度股息约占股价的 0.375%——理论毛收益约 0.044%,即 4.4bp。你要用 4.4bp 的毛收益去覆盖买卖两次的价差。
持有期只会让情况更糟:
| 持有天数 | 平均收益 | 收益标准差 | t 值 |
|---|---|---|---|
| 1 | −0.2159% | 1.888% | −7.23 |
| 3 | −0.2221% | 3.244% | −4.33 |
| 10 | −0.2291% | 5.906% | −2.45 |
| 21 | −0.2356% | 8.553% | −1.74 |
均值几乎不动(−0.216% → −0.236%),标准差按 √t 增长(1.888% → 8.553%)。 多持有一天不会多赚任何税收优势——那个优势在除息的那一瞬间就已经全部实现了——但你多承担了一天的方向性风险。
这是事件驱动策略的通病:信号是脉冲的,风险是连续的。 任何延长持有期的做法都在稀释信噪比。
九、统计功效:3798 笔#
即使在最理想的条件下(免税账户、零交易成本),策略仍然几乎不可检验:
免税账户零成本:单笔 SD 1.904%,均值 +0.0618%
→ 需 3,798 笔才够 |t| = 2按股息率分层看零成本情形:
| 分位 | 平均股息率 | 收益 | 标准误 | t 值 |
|---|---|---|---|---|
| Q1 | 0.66% | +0.0304% | 0.0278 | +1.09 |
| Q2 | 1.18% | +0.0265% | 0.0277 | +0.96 |
| Q3 | 1.70% | +0.0760% | 0.0275 | +2.77 |
| Q4 | 2.23% | +0.0776% | 0.0272 | +2.86 |
| Q5 | 2.74% | +0.0985% | 0.0273 | +3.61 |
收益随股息率单调上升,这符合理论(税收优势正比于股息金额)。但即使用 4800 个事件一个桶,Q1 和 Q2 的 t 值仍然不显著。
而加上 12bp 成本后,全部五个分位都显著为负(t 从 −5.17 到 −7.71)。最高股息率那一档亏得最少(−0.1408%),但仍然是亏。
十、已知偏差#
1. 模型假设单一边际投资者。 真实市场里不同税收身份的投资者同时存在,Elton-Gruber 框架里的「边际投资者」是一个理论构造。真实的落差比可能随股息率、机构持股比例、时间而变——我的模拟把它固定成了一个常数,这让问题比现实简单。如果真值本身在变,需要的样本量只会更多。
2. 没有建模除息日的短期抢筹行为。 现实中存在专门的抓息交易者,他们的行为本身会推高除息前价格、压低落差比。这是一个内生性问题:测出来的比值既反映税收,也反映套利活动的强度。我的模拟里没有这个反馈环。
3. 交易成本模型过于简单。 我用了对称的固定半价差。真实的除息日流动性可能更好(有确定的事件驱动流量)也可能更差(做市商避险)。此外我没有建模市场冲击——如果你想在几千个事件上系统性地做这件事,冲击成本会远超价差。
4. 忽略了持有期要求。 美国税法要求持股超过 60 天才能享受合格股息税率(qualified dividend)。一个持有 1 天的抓息交易者拿到的是非合格股息,按普通所得征税——这直接推翻了「低税率投资者可以套利」的前提。我在四类投资者里用「高税级个人(非合格股息)」部分反映了这一点,但没有建模「持有期越过 60 天门槛后税率跳变」这个真实存在的不连续性。这会让真实策略比我模拟的更不划算。
5. 1.9% 的日波动是一个平均数。 真实的除息日波动率随公司规模、行业、市场状态变化很大。低波动的公用事业股 NSR 会好得多,高波动的成长股(同时也是低股息率的)会更糟。这两个维度是相关的,我用了独立的均匀分布,低估了最坏情况的严重程度。
十一、结果解读#
这篇文章的结论不是「Elton-Gruber 是错的」。 恰恰相反——在零噪声安慰剂里,估计量精确还原到 1.70e-14;在 400 次重复上取均值,反解税率 0.2468 vs 真值 0.25。理论是对的,方法是对的,唯一的问题是你没有足够的数据。
四种估计量在单次抽样上给出 0.9256 / 0.9875 / 1.2174 / 1.0148,这是本文最该被记住的画面。 它们全部无偏,但抽样噪声让它们各自漂到不同方向。这意味着任何一篇报告单一落差比估计值的研究,其数值在很大程度上是抽样噪声的产物。 如果一篇论文报告 0.85 而另一篇报告 1.05,它们可能来自同一个真值。文献里那些「不同时期边际税率不同」的结论,有多少是真实的税制变化,有多少是估计噪声?我不知道,但这个模拟说明默认答案应该是后者。
「无偏」是一个被严重高估的性质。 四个估计量都无偏,但没有一个可用。当抽样标准差是你要检测的效应量的一倍时,无偏性不提供任何保护——它只保证你在无限次重复后是对的,而你只有一次机会。做这类研究时,应该先算需要多少样本才能达到目标精度,再决定要不要做。 我这里的答案是 21 万个事件,直接说明这个研究在美国市场上做不了。
低股息率样本的处理方式是一个通用教训。 大多数人的直觉是「样本越多越好」,而 NSR 扫描说:股息率 0.2% 的观测带来的标准差是 6% 股息率观测的 31 倍。在信噪比差异如此悬殊时,等权聚合等于让最差的观测主导结果。 这个道理适用于任何事件研究——事件的「强度」不同时,等权平均是错的。
策略层面的结论很干脆:这不是一个可交易的现象。 理论毛收益 4.4bp,盈亏平衡在 1~2bp 的半价差,而且真实的持有期税收规则还会进一步吃掉税收优势。它是一个真实存在但不可提取的效应——市场价格已经把它定进去了,剩下的价差刚好覆盖不了摩擦。这恰恰是有效市场应有的样子:一个真实的、可解释的、但赚不到钱的规律。
如果你一定要做这类研究:按 NSR 筛样本而不是按市值;报告置信区间而不是点估计;先在零效应的合成数据上跑一遍看看会开出什么值;把估计量的抽样标准差和你要检测的效应量放在一起比较——如果前者大于后者的一半,就不要下结论。