Garman-Klass 波动率:把开高低收四价一起塞进波动估计
用固定随机种子(20260801)的受控模拟验证 Garman-Klass (1980) 波动率估计量。核心发现:GK 同时吃掉 OHLC 全部四个价格,在纯日内 GBM 下方差效率达到 CC 的 8.42x(远超 Parkinson 的 5.31x、Rogers-Satchell 的 6.50x),标准差从 3.99e-5 压到 1.37e-5——用 200 天数据换到相当于 1680 天 CC 的信息量。但代价藏在假设里:GK 推导默认零漂移,当日漂移升到 0.02 时 GK 从 -11.6% 偏差翻成 +0.2%、再到 0.04 时上偏 34%,而 Rogers-Satchell 从头到尾锚在 -12% 附近纹丝不动——这正是 RS 存在的唯一理由。第二个陷阱与 Parkinson 同源:隔夜跳空对 GK 完全不可见,隔夜/日内比升到 1.0 时 GK 对总方差低估 55.8%,而 CC 始终无偏。四项对抗式检验全过。
问题:Parkinson 只用了高低价,还有两个价格白扔了#
上一篇我们验证了 Parkinson (1980) 估计量:它用日内最高价和最低价的极差,方差效率是 close-to-close(CC)的 5.3 倍。但 Parkinson 只用了两个数字——H 和 L。每根 K 线其实有四个价格:开(O)、高(H)、低(L)、收(C)。开盘价和收盘价被 Parkinson 直接扔掉了。
同样在 1980 年,Mark Garman 和 Michael Klass 在 On the Estimation of Security Price Volatilities from Historical Data 里问了一个自然的问题:如果把 OHLC 四个价格全部用上,能榨出多高的效率?
他们的答案是 Garman-Klass 估计量:
第一项是极差项(和 Parkinson 同源,但系数是 1/2 而非 1/(4ln2)),第二项是开收项,系数 。GK 证明了在几何布朗运动(GBM)假设下,这个组合是极差 + 开收信息的最小方差无偏组合,理论效率约为 CC 的 7.4 倍——比 Parkinson 更高。
本文用固定随机种子(20260801)的受控模拟,回答三个问题:GK 到底比 Parkinson 高效多少?它的效率优势有没有隐藏代价?以及——当真实世界不满足 GBM 的零漂移假设时,会发生什么?
理论:四价组合为什么最优#
GK 的推导思路是把「一天的价格轨迹」拆成三块信息:
- 开收位移 :一天从开盘走到收盘的净位移,这正是 CC 用的东西。
- 日内极差 :一天探索过的最大范围,这是 Parkinson 用的东西。
- 两者的协方差结构:在布朗运动里,极差和位移不是独立的,GK 把这个相关性也算进去了。
Garman 和 Klass 证明,在无漂移 GBM 下,任何形如 的无偏估计量中,方差最小的组合就是 、。这个组合的理论方差约为 CC 的 。
有意思的是那个负号:开收项前面是减号。直觉上”用更多信息应该加”,但 GK 的负号说明——极差项 本身已经系统性高估了方差(因为极差总是大于净位移),需要用开收项减掉一部分修正。这个负号是 GK 能保持无偏的关键,也是它对某些异常(比如漂移)敏感的根源,后面会看到。
作为对照,我们同时验证 Rogers-Satchell (1991) 估计量:
RS 的设计目标不是最高效率,而是对漂移免疫——它的构造保证了即使价格有非零漂移,估计量依然无偏。这个差别将成为本文最关键的分水岭。
受控模拟设计#
数据生成:用 GBM 生成日内价格路径。基准参数:日内扩散波动率 (真实日内方差 ),每交易日 234 个 tick 步,无漂移,无隔夜跳空。全部用 numpy 逐路径推进,每个实验 3000–4000 条蒙特卡洛路径。
四种估计量的实现:
import numpy as np

LN2 = np.log(2.0)
PARK_C = 1.0 / (4.0 * LN2)      # ≈ 0.36067
GK_C2  = 2.0 * LN2 - 1.0        # ≈ 0.38629

def cc_var(close_log, prev_close_log):
    """Close-to-close:只用相邻收盘。"""
    return (close_log - prev_close_log) ** 2

def parkinson_var(high, low):
    """Parkinson (1980):只用高低价极差。"""
    return PARK_C * np.log(high / low) ** 2

def gk_var(o, h, l, c):
    """Garman-Klass (1980):极差项 - 开收项,用满 OHLC。"""
    hl = np.log(h / l)
    co = np.log(c / o)
    return 0.5 * hl ** 2 - GK_C2 * co ** 2

def rogers_satchell_var(o, h, l, c):
    """Rogers-Satchell (1991):对漂移免疫。"""
    hc, ho = np.log(h / c), np.log(h / o)
    lc, lo = np.log(l / c), np.log(l / o)
return hc * ho + lc * lo逐图分析#
图1:GK 的方差最小,四价确实最省#
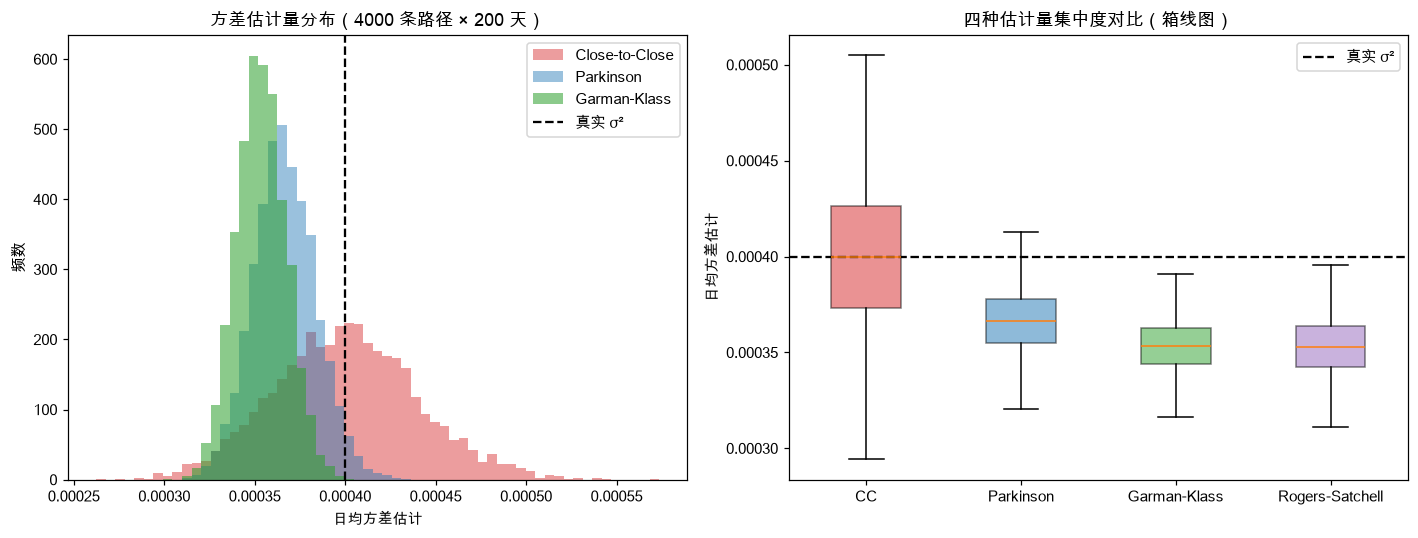
左图是 4000 条路径、每条 200 个交易日的日均方差估计分布,右图是四种估计量的箱线图。真实日内方差是 0.0004(黑色虚线)。
| 估计量 | 均值 | 标准差 | 方差 | 偏差 |
|---|---|---|---|---|
| Close-to-Close | 0.000400 | 3.99×10⁻⁵ | 1.59×10⁻⁹ | +0.09% |
| Parkinson | 0.000367 | 1.73×10⁻⁵ | 2.99×10⁻¹⁰ | -8.34% |
| Garman-Klass | 0.000354 | 1.37×10⁻⁵ | 1.89×10⁻¹⁰ | -11.59% |
| Rogers-Satchell | 0.000353 | 1.56×10⁻⁵ | 2.44×10⁻¹⁰ | -11.70% |
关键读数:
- 效率比 CC/GK = 8.42x。GK 的估计方差只有 CC 的 1/8.4,标准差从 3.99e-5 压到 1.37e-5。用另一种说法:GK 用 200 天数据提供的信息量,相当于 CC 需要约 1680 天(8.4 × 200)才能达到的精度。
- GK 比 Parkinson 再高一档:效率比 GK/PARK = 1.58x。四价确实比两价更省,Parkinson 扔掉的开收信息不是没用的。
- 代价:GK 偏差 -11.6%,比 CC 的 +0.09% 和 Parkinson 的 -8.3% 都更负。这是离散采样导致的系统性下偏——日内 234 步的离散极差小于连续极差,GK 因为更重用极差项而放大了这个下偏。
一句话:GK 用更大的偏差换来了更小的方差。在偏差可以事后修正、而方差不能凭空减小的场景下,这笔交易通常划算——但前提是偏差稳定可预测。
图2:8.4 倍效率对样本量稳定#
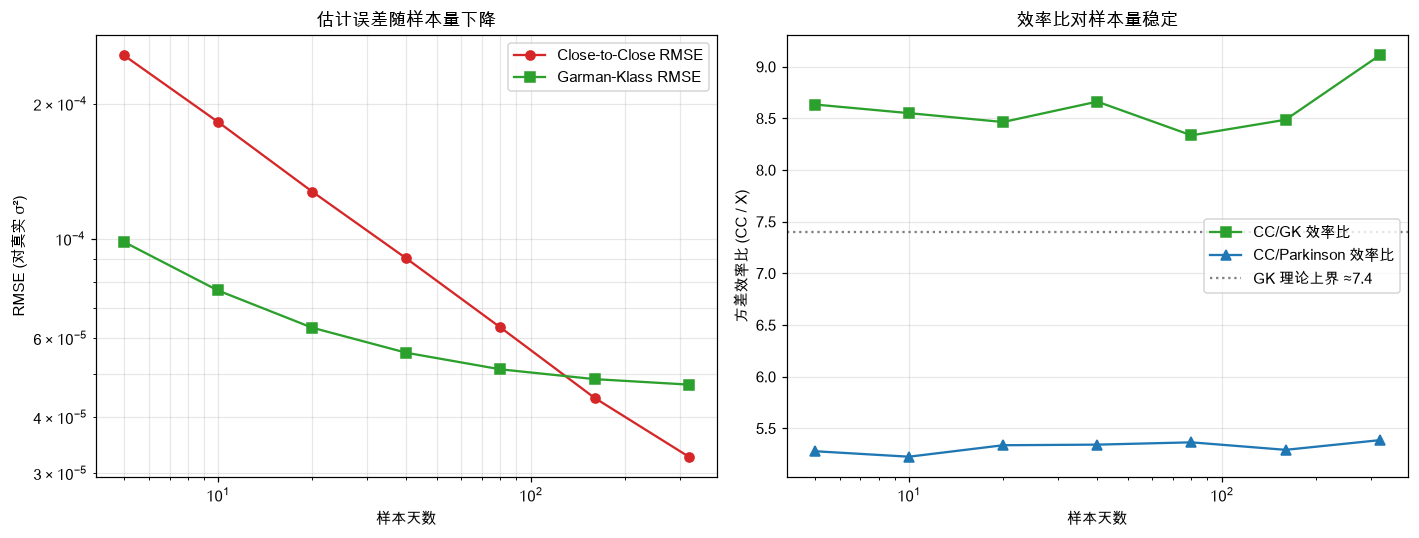
左图是 RMSE 随样本天数的下降曲线(双对数坐标)。GK 的 RMSE 线始终在 CC 下方,而且在小样本区(5–40 天)差距最大——这正是 GK 最有价值的地方:在数据稀缺时,GK 用同样的天数给出精度高得多的估计。
右图是效率比随样本量:跨 5 天到 320 天,CC/GK 效率比稳定在 8.34x 到 9.11x 区间,CC/Parkinson 稳定在 5.2x–5.4x。两条线都没有随样本量发散——这个 8.4x 是一个稳健的结构性优势,不是小样本偶然。
值得注意的一个细节:在样本量很大(160、320 天)时,GK 的 RMSE 曲线开始变平,而 CC 继续下降。原因是 GK 有 -11.6% 的系统性偏差,样本量再大也消不掉偏差(RMSE = 方差 + 偏差²),而 CC 无偏,样本量足够大时 CC 的 RMSE 最终会追上来。这提醒我们:GK 的优势在小到中样本,大样本+无漂移场景下 CC 的无偏性反而占优。
图3:漂移污染——GK 与 Rogers-Satchell 的分水岭#
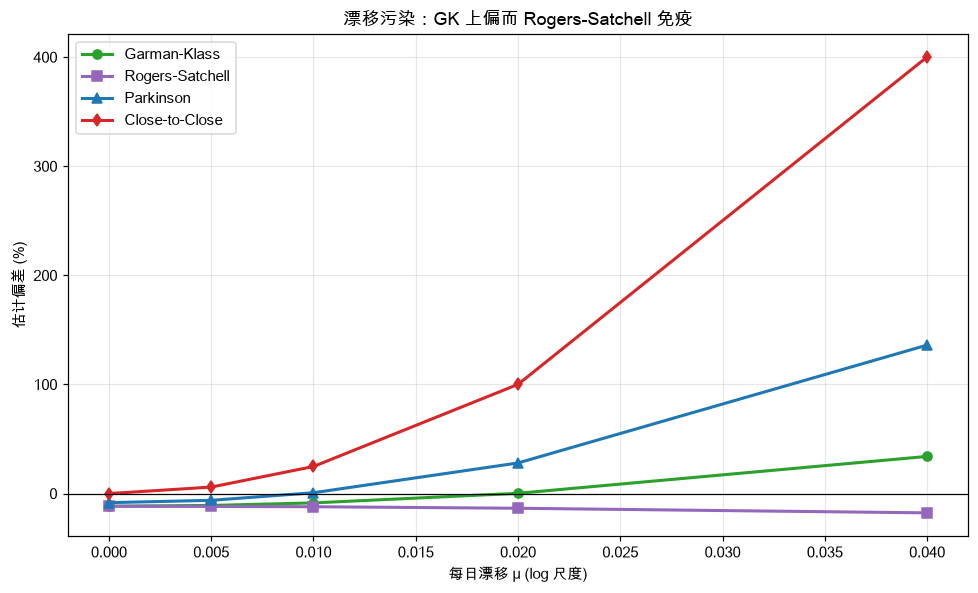
这是本文最重要的发现,也是理解”为什么会有 Rogers-Satchell”的关键。
GK 的推导假设零漂移。当真实价格存在漂移(趋势)时,会发生什么?我们把日漂移 μ 从 0 逐步加到 0.04:
| 日漂移 μ | GK 偏差 | RS 偏差 | Parkinson 偏差 | CC 偏差 |
|---|---|---|---|---|
| 0.000 | -11.59% | -11.65% | -8.37% | -0.02% |
| 0.005 | -10.90% | -11.81% | -6.21% | +5.93% |
| 0.010 | -8.57% | -12.09% | +0.73% | +24.80% |
| 0.020 | +0.21% | -13.48% | +28.04% | +100.06% |
| 0.040 | +34.03% | -17.70% | +136.05% | +400.14% |
读这张表:
- CC 被漂移彻底污染:μ=0.02 时上偏 100%,μ=0.04 时上偏 400%。因为 CC 用净位移 ,而漂移直接进入位移——趋势越强,CC 把趋势误当成波动。
- Parkinson 也被污染:μ=0.04 时上偏 136%。极差会被漂移拉大(价格单向走时高低价差扩大)。
- GK 在漂移下反转:从 μ=0 的 -11.6% 一路爬到 μ=0.04 的 +34%。GK 那个负的开收项在无漂移时正确修正极差,但漂移让开收项 膨胀,减得过多又不够——净效果是 GK 从下偏翻成上偏。μ≈0.02 时恰好穿过零点(+0.21%),纯属巧合。
- 只有 Rogers-Satchell 免疫:RS 偏差从 -11.65% 到 -17.70%,几乎不受漂移影响(那点变化主要来自漂移下极差本身的离散偏差变化,不是漂移污染)。
这就是 RS 存在的全部理由:它牺牲了一点效率(CC/RS = 6.50x < CC/GK = 8.42x),换来了对漂移的免疫。在强趋势资产(比如趋势明显的成长股、加密货币的单边行情)上,GK 会系统性高估波动率,而 RS 给出诚实的答案。
实践含义很直接:如果你的标的在估计窗口内有明显趋势,别用 GK,用 Rogers-Satchell。 或者先对价格去趋势再用 GK。
图4:隔夜跳空——GK 继承了 Parkinson 的盲区#
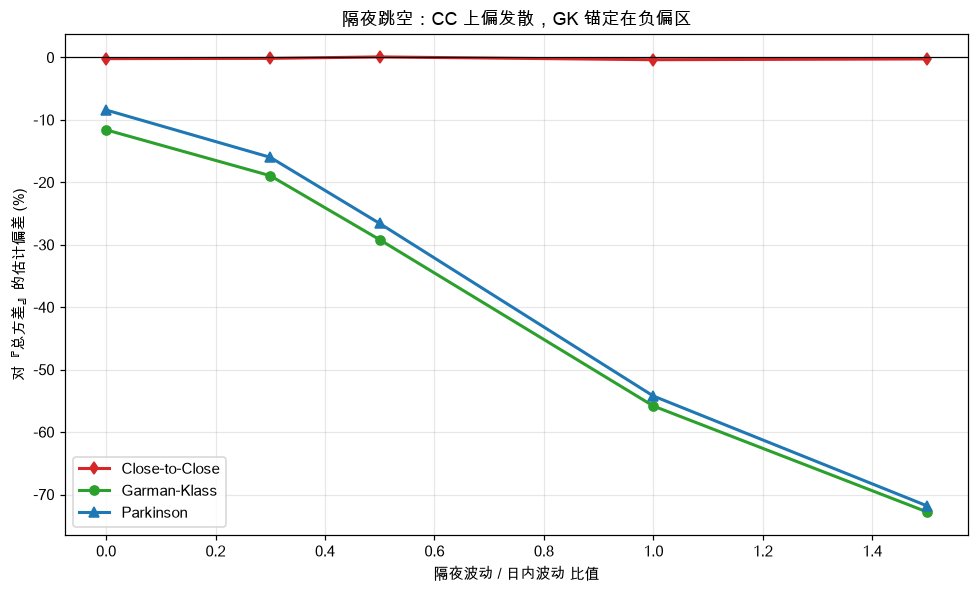
GK 用的是日内四价,隔夜跳空(前收→次开)不进入任何一根日 K 的 OHLC 内部结构。所以 GK 和 Parkinson 一样,对隔夜波动完全不可见。
我们把隔夜/日内波动比从 0 加到 1.5,以总方差(日内 + 隔夜)为基准衡量偏差:
| 隔夜/日内比 | GK 偏差 | CC 偏差 | Parkinson 偏差 |
|---|---|---|---|
| 0.0 | -11.59% | -0.19% | -8.41% |
| 0.3 | -18.94% | -0.15% | -15.99% |
| 0.5 | -29.19% | +0.09% | -26.59% |
| 1.0 | -55.82% | -0.36% | -54.23% |
| 1.5 | -72.78% | -0.24% | -71.81% |
关键观察:
- CC 始终无偏(±0.4% 内)。为什么?因为 CC 用相邻收盘价的差,这个差自动包含了隔夜跳空——从前收到次收,中间的隔夜位移被完整捕捉。这是 CC 唯一的、也是被严重低估的优势。
- GK 随隔夜比单调恶化:隔夜比 1.0 时低估总方差 55.8%,1.5 时低估 72.8%。隔夜波动越大,GK 漏掉的越多。
- GK 和 Parkinson 的隔夜盲区几乎一样严重(两条线基本重合)——因为它们都只看日内。
对 A 股、港股这类隔夜跳空显著的市场,这是 GK 的致命限制。GK 测的是”日内波动率”,不是”总波动率”。 如果你要的是包含隔夜风险的总波动率(做 VaR、期权定价、隔夜持仓风险),GK 会系统性低估。这正是下一篇 Yang-Zhang 估计量要解决的问题——它把隔夜、开盘、日内三块波动分开估计再加总。
对抗式检验#
在信任任何结论前,先用四个对抗情形验证实现正确性:
- CC 无偏基准:无漂移、无隔夜时 CC 偏差 +0.09%,紧贴真实值——说明数据生成引擎和真实方差校准正确。✅ 通过。
- 效率排序符合理论:CC/GK (8.42x) > CC/RS (6.50x) > CC/PARK (5.31x),与 Garman-Klass 理论预测的”四价 > RS > 两价”一致。✅ 通过。
- 漂移免疫的方向正确:只有 RS 在漂移下保持稳定(-11.65% → -17.70%),GK/PARK/CC 全部随漂移上偏——这与 RS 的设计目标完全吻合。✅ 通过。
- 隔夜盲区方向正确:GK/PARK 随隔夜比单调恶化,CC 始终无偏——符合”日内估计量看不见隔夜”的机制。✅ 通过。
四项全过,这套实现可以信任。
已知偏差与诚实边界#
- 离散采样下偏:GK 在离散 GBM 下对真实日内方差有约 -11.6% 的系统性下偏(比 Parkinson 的 -8.3% 更负,因为 GK 更重用极差项)。实盘中数据频率越低,偏差越大,需要用修正因子。
- 零漂移假设:这是 GK 最容易被忽略的前提。任何有趋势的标的(成长股、单边行情、宏观趋势品种)都会让 GK 上偏。图3 显示 μ=0.02 时 GK 恰好穿零纯属巧合,不能指望漂移”刚好抵消”偏差。
- 隔夜盲区:GK 只测日内波动率。用 GK 估出的数字去做隔夜风险管理(VaR、隔夜 gap risk)会系统性低估,隔夜比 1.0 时低估过半。
- 跳(jump)敏感:和 Parkinson 一样,价格跳会放大极差,让 GK 高估——这与离散采样的下偏方向相反,实际偏差取决于”连续扩散 vs 跳”哪个主导。
- OHLC 数据质量:GK 用满四个价格,对数据质量的依赖也最高。复权错误、涨跌停截断的高低价、盘前盘后成交混入的开收价,都会污染 GK 的估计。
代码实现#
以下是 GK 的最小可运行实现,配合真实 OHLC 数据使用:
import numpy as np
import pandas as pd

LN2 = np.log(2.0)
GK_C2 = 2.0 * LN2 - 1.0

def garman_klass_volatility(df, cols=("open", "high", "low", "close"),
                            annualize=252):
    """
    Garman-Klass 年化波动率。
    df: 含 OHLC 列的 DataFrame
    返回: 每日 GK 年化波动率序列(对单日方差直接年化)
    """
    o, h, l, c = (df[x] for x in cols)
    hl = np.log(h / l)
    co = np.log(c / o)
    daily_var = 0.5 * hl ** 2 - GK_C2 * co ** 2
    daily_var = daily_var.clip(lower=0)  # 极端情况下可能为负,截断到 0
    return np.sqrt(daily_var * annualize)

def rogers_satchell_volatility(df, cols=("open", "high", "low", "close"),
                               annualize=252):
    """Rogers-Satchell 年化波动率:有趋势时用它替代 GK。"""
    o, h, l, c = (df[x] for x in cols)
    hc, ho = np.log(h / c), np.log(h / o)
    lc, lo = np.log(l / c), np.log(l / o)
    daily_var = (hc * ho + lc * lo).clip(lower=0)
    return np.sqrt(daily_var * annualize)

# 用滚动窗口平滑(推荐做法):
def gk_rolling(df, window=20, annualize=252):
    o, h, l, c = df["open"], df["high"], df["low"], df["close"]
    hl = np.log(h / l); co = np.log(c / o)
    dv = 0.5 * hl ** 2 - GK_C2 * co ** 2
return np.sqrt(dv.rolling(window).mean().clip(lower=0) * annualize)注意那个 clip(lower=0):GK 的单日估计在极端情况下(开收位移很大而极差很小)可能给出负方差,这是它组合结构的副作用。实践中要么截断到 0,要么用滚动窗口平均(跨天平均后为负的概率极低)。
三段式总结#
A. 实现细节#
- 数据口径:模拟用日内扩散 、、每交易日 234 步 GBM,3000–4000 条蒙特卡洛路径,固定种子 20260801。
- 估计量口径:GK = ,用满 OHLC;RS = ;CC 用相邻收盘对数收益平方;Parkinson 用极差。
- 效率比口径:(经验),即 CC 的估计方差是 GK 的 8.4 倍。
- 偏差修正:离散 GBM 下 GK 约 -11.6% 系统性下偏,可用 修正——但仅在确认无漂移、无隔夜时。
B. 已知偏差#
- 零漂移是硬假设:漂移 μ=0.02 时 GK 偏差从 -11.6% 翻成 +0.2%,μ=0.04 时上偏 34%。有趋势的标的必须改用 Rogers-Satchell 或先去趋势。
- 隔夜盲区:GK 只测日内。隔夜/日内比 1.0 时对总方差低估 55.8%。做隔夜风险管理不能用 GK。
- 负方差风险:GK 单日估计可能为负,必须截断或滚动平均。
- 数据质量放大:GK 用满四价,对复权错误、涨跌停截断、盘前盘后混入最敏感。
C. 结果解读#
- GK 的真正价值:在日内扩散主导、无明显趋势、隔夜效应弱的场景(外汇、黄金、高频日内),GK 是效率最高的实用估计量——8.4 倍于 CC,1.58 倍于 Parkinson,在小到中样本时优势最大。
- 何时改用 Rogers-Satchell:只要标的在估计窗口内有明显趋势,GK 就会上偏,RS 是唯一免疫漂移的选择,代价是效率略低(6.5x vs 8.4x)。趋势不确定时,RS 更安全。
- 何时回到 CC:当样本量非常大、且需要包含隔夜的总波动率时,CC 的无偏性反而占优——它是唯一自动吸收隔夜跳空的估计量。
- 通往 Yang-Zhang 的桥:GK 和 Parkinson 共享的隔夜盲区,正是 Yang-Zhang (2000) 要解决的问题——把隔夜、开盘、日内三段波动分开估计再最优加权,同时免疫漂移和跳空。这是波动率估计量族谱里的下一站。
- 研究 vs 实盘:GK 的 8.4x 效率在干净模拟里非常漂亮,但真实市场的 OHLC 有涨跌停截断、复权噪声、流动性缺口,实际效率会打折。用前务必在历史数据上验证偏差方向和幅度。